
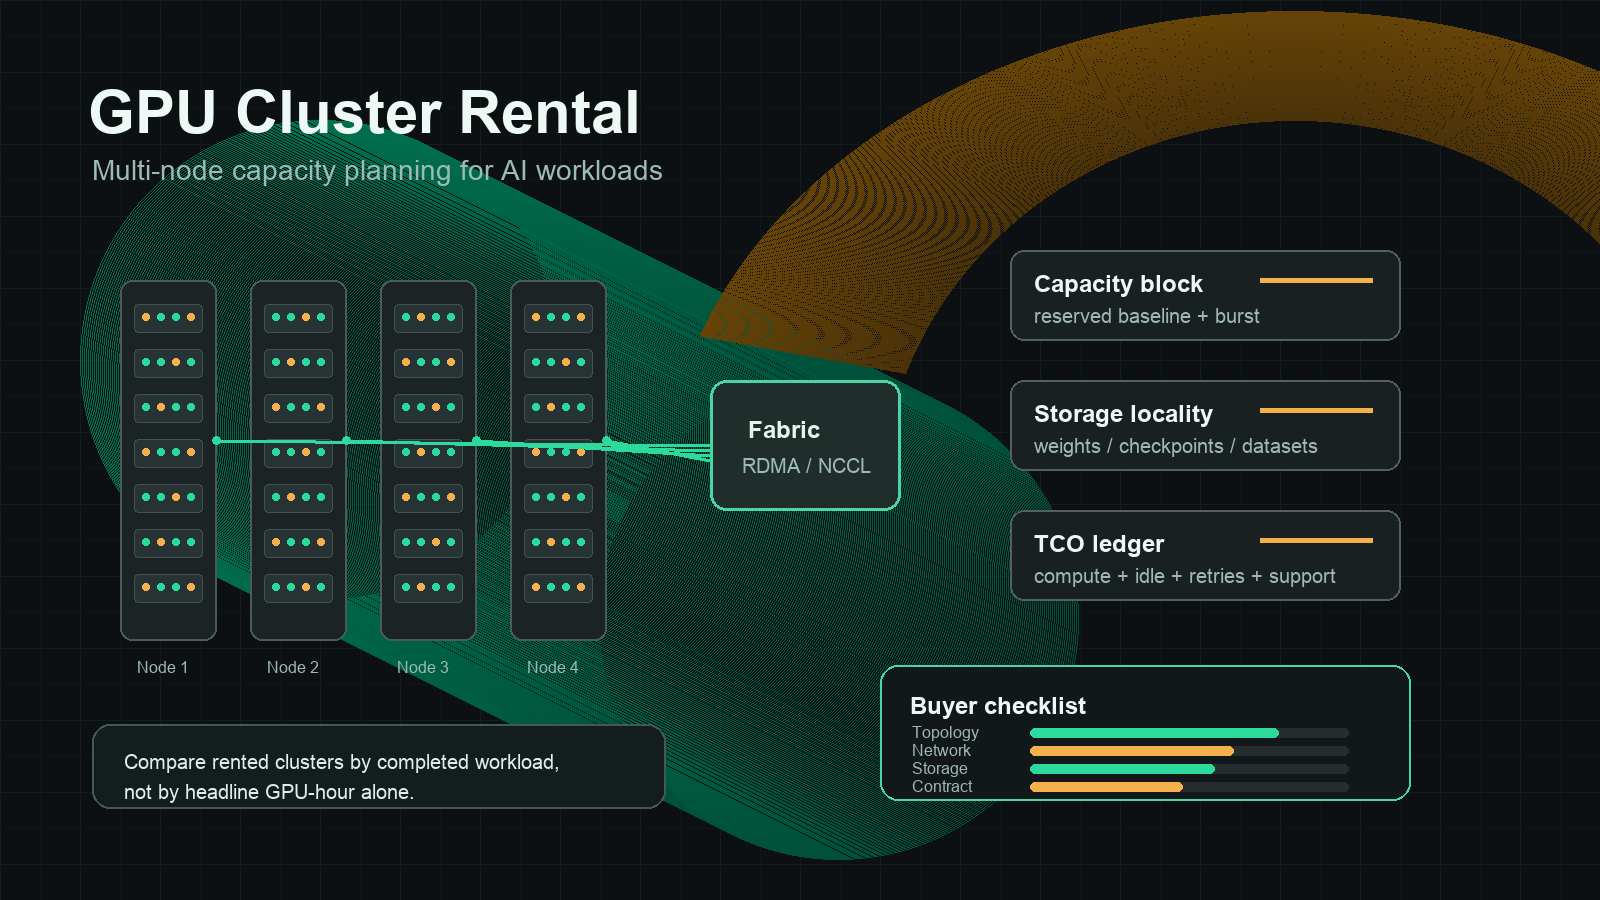
Sewa GPU Cluster: Panduan Pembeli untuk Kapasitas AI Multi-Node
Sewa GPU cluster menjadi menarik ketika satu GPU, satu node, atau satu akun penyedia tidak lagi cukup. Mungkin sebuah proses training membutuhkan delapan hingga enam puluh empat GPU yang terhubung dengan jaringan berlatensi rendah. Mungkin lalu lintas inferensi memiliki baseline yang stabil dan lonjakan tajam pada minggu peluncuran. Mungkin pengadaan menginginkan kapasitas H100, H200, B200, atau L40S yang terjamin tanpa membeli perangkat keras, merekrut tim pusat data, dan menunggu waktu tunggu rantai pasok.
Bagian yang sulit adalah bahwa sebuah "GPU cluster" bukanlah satu produk tunggal. Sebuah penawaran dapat berarti reservasi hyperscaler, alokasi cloud GPU spesialis, cluster bare-metal, armada marketplace, setup Kubernetes terkelola, atau blok kapasitas privat. Tarif GPU per jam hanyalah item pertama dalam daftar biaya.
Panduan ini memberi tim AI enterprise cara praktis untuk mengevaluasi opsi gpu cluster rental, membandingkan gpu cluster rental cloud providers, dan memutuskan kapan harus menyewa, mereservasi, membeli, atau menggunakan API model sebagai gantinya.
Jawaban singkat
Gunakan sewa GPU cluster ketika workload Anda memiliki setidaknya satu dari kebutuhan berikut:
| Kebutuhan | Mengapa ini mengarah ke cluster |
|---|---|
| Training multi-GPU | Model, ukuran batch, atau metode fine-tuning memerlukan memori atau throughput yang lebih besar daripada yang dapat disediakan satu node. |
| Inferensi multi-node | Anda memerlukan kapasitas baseline yang tinggi, isolasi tenant, atau waktu antre yang dapat diprediksi untuk trafik produksi. |
| Pemakaian stabil | Kelas GPU yang sama akan tetap sibuk cukup lama untuk membenarkan kapasitas terreservasi atau dedicated. |
| Job sensitif jaringan | Distributed training, sharded serving, atau workload embedding/index besar memerlukan penempatan dan perilaku fabric yang diketahui. |
| Kontrol pengadaan | Keuangan membutuhkan anggaran yang terikat, ketentuan dukungan, region, cakupan kepatuhan, dan tanggal perpanjangan. |
Jangan memilih gpu cluster rental hanya karena GPU besar terlihat lebih murah per jam. Pilihlah ketika beban kerja yang selesai justru lebih murah atau lebih aman setelah Anda memasukkan jaringan, penyimpanan, utilisasi, risiko restart, dukungan, operasional, dan ketentuan kontrak.
biaya cluster nyata per output yang bermanfaat =
  (compute + storage + network + idle time + retries + support + engineering overhead)
  / training runs yang diterima, token inferensi, job, gambar, atau permintaan pelanggan
Apa yang termasuk sewa GPU cluster?
Sewa GPU cluster dapat menggambarkan beberapa pola pembelian. Pisahkan hal-hal ini selama evaluasi.
| Model sewa | Cocok untuk | Risiko utama |
|---|---|---|
| Server multi-GPU satu node | Training awal, fine-tuning, job batch, eksperimen satu tim | Mudah menjadi tidak cukup besar; asumsi jaringan tidak dapat dipindahkan ke run multi-node. |
| Cluster on-demand multi-node | Proyek singkat, jendela benchmark, kapasitas lonjakan | Ketersediaan dapat berubah حسب region dan keluarga GPU. |
| Cluster terreservasi atau dedicated | Inferensi produksi, kalender training terencana, jendela peluncuran | Risiko utilisasi jika permintaan berubah atau kelas GPU yang lebih baru menggeser ekonominya. |
| Armada GPU marketplace | Eksperimen, job batch fleksibel, kapasitas oportunistik berbiaya lebih rendah | Keandalan host, perpindahan data, interupsi, dan dukungan dapat bervariasi. |
| Cluster Kubernetes atau Slurm terkelola | Tim platform yang membutuhkan penjadwalan dan governance yang dapat diulang | Anda tetap bertanggung jawab atas packaging workload, observability, kontrol biaya, dan respons insiden. |
| API model atau inferensi serverless | Tim yang membutuhkan output, bukan kontrol hardware | Kontrol lebih sedikit atas bobot, kernel, penempatan, dan stack serving tingkat rendah. |
Inilah sebabnya kueri "gpu cluster rental or cloud gpu cluster" biasanya memiliki pemisahan niat beli. Sebagian tim membutuhkan kapasitas fisik yang dapat mereka jadwalkan. Yang lain membutuhkan output AI yang andal dan tidak seharusnya mengoperasikan GPU secara langsung.
Mulailah dari workload, bukan providernya
Sebelum membandingkan gpu cluster rental cloud providers, tulis ringkasan kapasitas satu halaman. Penawaran provider hanya bermakna jika setiap vendor melihat bentuk workload yang sama.
| Bidang singkat | Yang harus ditulis |
|---|---|
| Jenis beban kerja | Pretraining, fine-tuning, retrieval embedding, batch inference, online inference, pembuatan gambar/video, simulasi, atau notebook riset. |
| Model dan framework | Keluarga model, jumlah parameter, presisi, kuantisasi, PyTorch/JAX, vLLM, SGLang, TensorRT-LLM, Ray, Kubernetes, Slurm, atau scheduler lainnya. |
| Target GPU | H100 SXM, H100 PCIe, H200, B200, A100, L40S, RTX 4090, RTX PRO 6000, atau rentang pengganti yang dapat diterima. |
| Bentuk cluster | GPU per node, jumlah node, memori per GPU, rasio CPU/RAM, NVMe lokal, dan apakah job memerlukan satu placement group. |
| Kebutuhan jaringan | NVLink/NVSwitch intra-node, InfiniBand atau RoCE lintas node, target bandwidth all-reduce, dan jitter yang dapat diterima. |
| Jalur penyimpanan | Ukuran dataset, ukuran checkpoint, cache bobot model, lokasi object storage, scratch lokal, kebijakan snapshot, dan periode retensi. |
| Target utilisasi | Utilisasi baseline yang diharapkan, jam burst, toleransi idle, jendela pemeliharaan, dan waktu antrean yang diharapkan. |
| Kebijakan keandalan | Frekuensi checkpoint, budget retry, risiko eviction yang ditoleransi, SLA dukungan, dan jalur eskalasi insiden. |
| Data dan kepatuhan | Persyaratan wilayah, residensi data, privasi, audit, ekspor, dan isolasi pelanggan. |
| Batas kontrak | Durasi kontrak, minimum spend, jaminan kapasitas, jalur upgrade, cakupan dukungan, dan ketentuan penghentian. |
Jika Anda tidak bisa mengisi tabel ini, jangan memesan cluster dulu. Sewa kapasitas on-demand jangka pendek terlebih dahulu, benchmark beban kerja, lalu ubah hasil benchmark menjadi brief pengadaan.
Kategori penyedia untuk dibandingkan
Ada tiga kategori penyedia yang berguna untuk sewa gpu cluster.
| Kategori | Contoh untuk dievaluasi | Hal yang cenderung mereka lakukan dengan baik | Hal yang perlu diverifikasi |
|---|---|---|---|
| Cloud hyperscale | AWS, Google Cloud, Microsoft Azure | Identitas, region, kepatuhan, produk jaringan, dukungan, kontrol penagihan yang matang | Ketersediaan GPU, kuota, mekanisme reservasi, total tagihan cloud, biaya transfer data, dan kompleksitas operasional. |
| Cloud GPU spesialis | Lambda, CoreWeave, Crusoe, Runpod Enterprise, cloud AI regional | Pembicaraan pengadaan GPU lebih cepat, dukungan native AI, harga GPU lebih sederhana, ketentuan cluster khusus | Fabric jaringan, storage, observability, kontrol enterprise, SLA dukungan, dan ketentuan perpanjangan/upgrade. |
| Marketplace dan fleet fleksibel | Vast.ai, kapasitas bergaya komunitas Runpod, kapasitas GPU yang diperantarai | Biaya masuk lebih rendah dan eksperimen cepat | Keandalan host, risiko interupsi, perpindahan data, kedalaman dukungan, kepatuhan, dan apakah lalu lintas produksi sesuai. |
Gunakan halaman sumber resmi sebagai titik cek terkini, bukan sebagai kartu tarif permanen. Untuk artikel ini, klaim-klaimnya diperiksa pada 12 Oktober 2026.
| Sumber | Mengapa ini penting dalam review pembeli |
|---|---|
| AWS EC2 P5 instances dan EC2 Capacity Blocks | Periksa bentuk instance cluster H100, bahasa EFA/networking, mekanisme reservasi, kuota, dan ketersediaan region. |
| Google Cloud accelerator-optimized machines dan GPU pricing | Periksa keluarga mesin A3/A4, struktur harga GPU, storage, diskon committed use, dan catatan region. |
| Azure ND H100 v5 series | Periksa bentuk cluster H100 Azure, framing InfiniBand, ukuran VM, dan ketersediaan regional. |
| Lambda GPU Cloud | Periksa tarif GPU cloud yang dipublikasikan, tipe instance, ketentuan reserved cloud, dan catatan ketersediaan. |
| Runpod pricing dan Runpod docs | Bedakan pod, serverless, kapasitas secure/community, storage, dan asumsi volume jaringan. |
| Vast.ai pricing dan Vast.ai docs | Pandang setiap listing sebagai penawaran marketplace dengan host, reliabilitas, storage, lokasi, dan profil interupsi tersendiri. |
| NVIDIA NCCL tests | Gunakan benchmark distributed training yang praktis, bukan menerima bahasa umum "high-speed network" begitu saja. |
| NVIDIA GPU Operator dan Slurm GRES | Konfirmasi apakah tim Anda atau penyedia yang mengelola penjadwalan GPU, driver, telemetry, dan kebijakan alokasi. |
Pemeriksaan multi-node yang penting
Sewa GPU tunggal sebagian besar adalah keputusan tentang harga, memori, image, dan ketersediaan. Sewa gpu cluster multi-node menambahkan risiko topologi dan operasional.
1. Topologi GPU
Minta bentuk node yang tepat dan apakah cluster bersifat homogen.
- Model GPU dan ukuran memori.
- PCIe versus SXM bila relevan.
- GPU per node.
- Topologi NVLink atau NVSwitch intra-node.
- Model CPU, RAM, dan NVMe lokal per node.
- Kebijakan alokasi MIG, vGPU, atau full-GPU.
- Apakah semua node berada dalam satu domain penempatan.
Jangan terima "8x H100" sebagai spesifikasi lengkap. Server 8x H100 SXM, server 8x H100 PCIe, dan delapan node H100 terpisah dapat berperilaku sangat berbeda.
2. Fabric jaringan
Untuk pelatihan terdistribusi, jaringan dapat menentukan apakah cluster tersebut berguna. Minta:
- Detail InfiniBand, RoCE, EFA, GPUDirect, atau fabric lainnya.
- Jumlah NIC dan kecepatan per node.
- Rasio oversubscription.
- Jaminan penempatan untuk node yang dikutip.
- Apakah penyedia telah menjalankan pengujian all-reduce NCCL pada pool yang persis sama.
- Kebijakan pemeliharaan dan isolasi kegagalan.
Masukkan validasi jaringan ke dalam uji penerimaan:
uji penerimaan cluster:
  jalankan nccl-tests all_reduce di setiap node yang disewa
  bandingkan bandwidth dan latensi dengan penawaran penyedia
  ulangi setelah image container, driver, dan framework diinstal
  simpan log dengan tanggal, ID node, model GPU, dan region
Jika penyedia tidak dapat mendukung benchmark terdistribusi dasar sebelum penandatanganan kontrak, anggap itu sebagai sinyal risiko.
3. Penyimpanan dan jalur data
Tim GPU sering meremehkan penyimpanan karena penawaran GPU terlihat besar dan baris penyimpanan tampak biasa saja. Untuk cluster multi-node, penyimpanan menentukan waktu startup, waktu checkpoint, dan pemulihan saat terjadi kegagalan.
Minta:
- NVMe lokal per node.
- Opsi filesystem bersama.
- Region object storage dan jalur egress.
- Waktu staging dataset.
- Strategi cache bobot model.
- Throughput tulis/baca checkpoint.
- Harga snapshot dan backup.
- Kebijakan pembersihan setelah sewa berakhir.
Lalu jalankan tes nyata: ambil container produksi, stage dataset, muat bobot, tulis checkpoint, pulihkan dari checkpoint, dan ukur waktu yang dapat ditagih.
4. Scheduler dan model akses
Kesepakatan GPU terbaik masih bisa gagal jika tim Anda tidak dapat menjadwalkan job dengan andal. Tentukan siapa yang bertanggung jawab atas:
- Pengaturan Kubernetes atau Slurm.
- Manajemen versi driver dan CUDA.
- Container registry dan pemindaian image.
- Akses pengguna, kebijakan SSH, secrets, dan audit log.
- Kuota per tim atau proyek.
- Shutdown saat idle.
- Tag biaya dan ekspor penggunaan.
- Eskalasikan insiden.
Cluster yang dikelola penyedia dapat mengurangi waktu setup, tetapi Anda tetap memerlukan runbook yang jelas untuk image yang buruk, job yang gagal, sengketa kuota, dan perubahan kapasitas mendesak.
Lembar kerja harga sewa GPU cluster cloud
Untuk setiap penyedia, normalisasikan penawaran ke dalam lembar kerja yang sama.
| Item baris | Pertanyaan yang harus diajukan | Mengapa ini mengubah TCO |
|---|---|---|
| Komputasi GPU | Apa unit yang dapat ditagih: detik, menit, jam, bulan, atau blok kapasitas? | Job singkat dan waktu idle sensitif terhadap granularitas penagihan. |
| Komitmen minimum | Apakah ada jangka waktu, pengeluaran minimum, atau reservasi yang tidak dapat dibatalkan? | Tarif yang terlihat murah bisa menjadi mahal jika utilisasi turun. |
| Penyimpanan | Tingkat penyimpanan mana yang disertakan, dan mana yang ditagih terpisah? | Dataset, checkpoint, bobot model, dan snapshot dapat tetap ada setelah job selesai. |
| Jaringan | Apakah egress lintas region, public egress, private link, atau dedicated fabric ditagih terpisah? | Dataset besar dan media yang dihasilkan dapat memindahkan data lebih banyak dari yang diharapkan. |
| Dukungan | Apa waktu respons, jalur eskalasi, dan bantuan engineering yang disertakan? | Insiden cluster mahal selama jendela pelatihan. |
| Keandalan | Apa yang terjadi jika satu node gagal selama job multi-node? | Waktu restart dan antrean harus masuk dalam model biaya. |
| Jalur upgrade | Bisakah Anda beralih dari kapasitas kelas H100 ke H200/B200 selama masa kontrak? | Generasi GPU menggeser performa per dolar. |
| Observabilitas | Apakah Anda mendapatkan utilisasi per node, log job, ekspor penagihan, dan kode alasan kegagalan? | Tanpa data penggunaan, keuangan tidak dapat menjelaskan tagihan. |
| Keamanan | Apakah isolasi tenant, audit log, secrets, dan syarat penghapusan data terdokumentasi? | Pembeli enterprise memerlukan bukti, bukan jaminan lisan. |
Gunakan formula ini di spreadsheet:
TCO cluster bulanan =
  komputasi yang dikomitmenkan
  + komputasi burst
  + penyimpanan persisten
  + snapshot
  + egress jaringan
  + dukungan
  + pemborosan idle
  + pemborosan retry
  + overhead engineering
Lalu hitung unit yang berguna:
biaya per unit berguna =
  TCO cluster bulanan / unit beban kerja yang diterima
Unit yang berguna harus cocok dengan hasil bisnis: fine-tune yang selesai, token pelatihan yang diproses, batch gambar yang diterima, token inferensi, permintaan pelanggan, atau eksperimen yang dikirim.
Sewa, reservasi, atau beli pada 2026
Kata kunci "gpu cluster rental or cloud or buy 2026" mengarah ke pertanyaan pengadaan yang sebenarnya. Gunakan tabel keputusan di bawah ini sebelum membuat komitmen besar.
| Opsi | Lebih disukai saat | Hindari saat |
|---|---|---|
| Sewa sesuai permintaan | Beban kerja baru, jadwal tidak pasti, atau benchmark masih berubah. | Anda sudah memiliki utilisasi baseline yang stabil dan kebutuhan ketersediaan yang mendesak. |
| Cadangkan atau dedikasikan kapasitas | Utilisasi dapat diprediksi, tanggal peluncuran penting, dan kelas GPU yang sama akan sibuk selama berbulan-bulan. | Arsitektur model, engine serving, atau target GPU kemungkinan akan berubah segera. |
| Beli atau colocation | Anda memiliki utilisasi sangat tinggi, kebutuhan hardware yang stabil, keahlian pusat data, dan persetujuan modal. | Anda membutuhkan scale-up cepat, fleksibilitas generasi GPU, dukungan terkelola, atau region global. |
| Gunakan API model | Anda lebih membutuhkan output model daripada kontrol hardware, dan overhead operasional akan jauh lebih besar daripada penghematan GPU. | Anda membutuhkan bobot kustom, kontrol kernel tingkat rendah, stack serving privat, atau penempatan hardware tetap. |
Bagi banyak tim produk AI, jalur praktisnya bertahap:
- Sewa GPU sesuai permintaan untuk benchmark.
- Pindahkan pekerjaan yang stabil ke sewa cluster GPU yang dicadangkan atau didedikasikan.
- Simpan traffic lonjakan dan eksperimen pada kapasitas yang fleksibel.
- Gunakan API model untuk beban kerja yang kontrol infrastrukturnya tidak meningkatkan produk.
- Tinjau ulang opsi beli atau colocation hanya setelah utilisasi dan bentuk beban kerja stabil.
Sewa cluster GPU di India
Frasa "gpu cluster rental in india" tidak boleh diperlakukan sebagai artikel terpisah kecuali pembeli memiliki kebutuhan sourcing, residensi data, atau latensi yang spesifik untuk India. Gunakan lembar kerja yang sama, lalu tambahkan pemeriksaan regional:
- Apakah cluster secara fisik berada di India, region Asia terdekat, atau hanya dijual ke perusahaan berbasis India?
- Di mana data pelatihan, checkpoint, dan log akan disimpan?
- Apa persyaratan transfer lintas batas, pajak, invoice, dan jam dukungan?
- Apakah dukungan lokal dibutuhkan selama jam kerja India?
- Apakah latensi penting untuk inferensi, atau ini beban kerja pelatihan offline?
- Apakah ada kendala impor, pengadaan, atau kepatuhan jika membeli hardware alih-alih menyewa?
Untuk pelatihan offline, region terdekat mungkin dapat diterima jika transfer data dan kepatuhan jelas. Untuk inferensi yang sensitif terhadap latensi atau data yang diatur, region dan ketentuan kontrak dapat lebih penting daripada tarif GPU yang tercantum.
Tanda bahaya dalam penawaran sewa cluster GPU
Tunda transaksi jika Anda melihat salah satu dari hal berikut:
- Penawaran menyebut "H100 cluster" tetapi tidak menyebut PCIe/SXM, bentuk node, memori, atau jaringan.
- Penyedia tidak dapat menjelaskan penanganan kegagalan untuk satu node yang bermasalah dalam pekerjaan terdistribusi.
- Penyimpanan dan egress tidak tercantum dalam penawaran.
- Ketentuan dukungan tidak jelas selama jendela pelatihan Anda yang paling mahal.
- "Dedicated" digunakan tanpa menjelaskan isolasi tenant, penempatan, dan risiko noisy neighbor.
- Penawaran memberikan tarif bulanan rendah tetapi tidak ada ketentuan utilisasi atau pembatalan.
- Tidak ada jendela benchmark sebelum komitmen.
- Penyedia menolak membagikan field ekspor penagihan atau data penggunaan.
- Anda tidak dapat memverifikasi versi driver/CUDA/framework sebelum beban kerja pertama.
- Deck penjualan menyebut kepatuhan, tetapi kontrak tidak mendefinisikan penanganan dan penghapusan data.
Apa yang perlu dibenchmark sebelum menandatangani
Jalankan serangkaian uji penerimaan kecil sebelum Anda memesan atau menskalakan cluster GPU sewaan.
| Uji | Kondisi lulus |
|---|---|
| Pull dan startup container | Image produksi dimulai dengan cepat dan konsisten di setiap node. |
| Kesehatan GPU | Semua GPU melaporkan model, memori, driver, dan kompatibilitas CUDA yang diharapkan. |
| NCCL all-reduce | Bandwidth dan latensi lintas node sesuai dengan kelas cluster yang dinyatakan penyedia. |
| Staging storage | Dataset dan bobot model dapat distage dalam jendela penyiapan yang direncanakan. |
| Checkpoint write/read | Checkpoint selesai tanpa membuat waktu GPU menganggur terlalu lama. |
| Uji kegagalan | Matikan satu worker dan pastikan perilaku restart, checkpoint, dan penagihan. |
| Shutdown saat idle | Node yang tidak terpakai berhenti atau memicu peringatan sebelum pemborosan menumpuk. |
| Ekspor penagihan | Penggunaan dapat diatribusikan berdasarkan tim, beban kerja, lingkungan, dan job. |
| Tinjauan keamanan | Akses, secret, log, penghapusan data, dan catatan audit sesuai kebijakan. |
Simpan output benchmark beserta tanggal, penyedia, region, model GPU, versi image, versi framework, dan ID node. Ini mengubah pemilihan vendor dari perdebatan daftar tarif menjadi tinjauan engineering yang dapat direproduksi.
Di mana Flatkey cocok
Flatkey bukan pengganti untuk setiap cluster GPU sewaan. Jika Anda membutuhkan bobot kustom, kernel privat, pelatihan multi-node, atau kontrol hardware langsung, Anda tetap membutuhkan kapasitas GPU.
Flatkey relevan ketika pertanyaannya adalah apakah Anda perlu mengoperasikan GPU sama sekali untuk beban kerja tertentu. Flatkey memberi tim satu kunci, satu saldo, dan satu invoice di lebih dari 300 model resmi dan lebih dari 1.000 alat pay-per-call, dengan visibilitas penggunaan di tingkat request. Itu membuatnya berguna sebagai jalur perbandingan untuk:
- Beban kerja prototipe sebelum Anda berkomitmen ke sebuah cluster.
- Lalu lintas agen dan aplikasi yang dapat berjalan di API model resmi.
- Tinjauan keuangan yang perlu membandingkan biaya GPU self-hosted dengan biaya API model.
- Tim yang menginginkan buku besar bersama untuk penggunaan AI sebelum memutuskan apa yang layak mendapatkan hardware khusus.
Jika sebuah workload tidak memerlukan kontrol perangkat keras, bandingkan sewa gpu cluster dengan jalur API berdasarkan biaya per hasil yang diterima, bukan berdasarkan jam GPU mentah. Panduan terkait tentang harga sewa GPU, perbandingan harga model AI, cara membandingkan harga model AI, harga AI gateway, manajemen pengeluaran AI API, dan manajemen kuota AI API adalah pemeriksaan lanjutan yang tepat.
Daftar periksa pembeli
Gunakan daftar periksa ini sebelum menyetujui sewa gpu cluster:
- Tentukan workload dan unit keluaran yang berguna.
- Benchmark kapasitas on-demand sebelum melakukan reservasi.
- Tentukan model GPU, memori, bentuk node, penyimpanan lokal, dan fabric jaringan.
- Wajibkan benchmark terdistribusi untuk pelatihan multi-node.
- Masukkan penyimpanan, egress, dukungan, waktu idle, dan pemborosan retry ke dalam TCO.
- Konfirmasi wilayah, kepatuhan, penghapusan data, dan persyaratan audit.
- Tanyakan bagaimana satu node yang gagal memengaruhi job yang sedang berjalan.
- Wajibkan ekspor penggunaan dan penagihan berdasarkan tim, lingkungan, dan job.
- Pisahkan kapasitas reserved dasar dari kapasitas burst.
- Bandingkan ulang dengan API model ketika kontrol perangkat keras tidak diperlukan.
Keputusan sewa gpu cluster terbaik adalah yang menyelesaikan workload dengan andal dengan kejutan operasional paling sedikit. Jam GPU termurah hanya berguna jika cluster, penyimpanan, jaringan, dan kontraknya memungkinkan tim Anda mengubah jam tersebut menjadi pekerjaan yang diterima.
Pertanyaan yang diajukan pembeli
Apa itu sewa gpu cluster?
Sewa GPU cluster adalah praktik menyewa beberapa GPU, sering kali di satu atau lebih node yang terhubung, untuk pelatihan AI, inferensi, pemrosesan batch, atau riset. Ini bisa bersifat on-demand, reserved, dedicated, berbasis marketplace, atau dikelola oleh penyedia cloud.
Apakah sewa gpu cluster lebih murah daripada membeli GPU?
Tergantung pada utilisasi, lama kontrak, keahlian operasional, pembiayaan, daya, akses datacenter, dukungan, dan seberapa sering kelas GPU target Anda berubah. Menyewa biasanya lebih unggul untuk ketidakpastian dan kecepatan. Membeli hanya bisa menang ketika utilisasi dan kebutuhan perangkat keras cukup stabil untuk menyerap biaya modal dan operasional.
Apa yang harus saya tanyakan kepada penyedia cloud sewa gpu cluster?
Tanyakan model GPU, bentuk node, fabric jaringan, penyimpanan, region, kuota, SLA dukungan, asumsi utilisasi, ekspor penagihan, ketentuan penghapusan data, akses benchmark, dan apa yang terjadi ketika satu node gagal selama job terdistribusi.
Apakah saya memerlukan InfiniBand atau RoCE untuk cluster GPU sewaan?
Anda memerlukan jaringan cluster berkinerja tinggi ketika job banyak berkomunikasi lintas node, terutama pelatihan terdistribusi dan serving yang di-shard. Anda mungkin tidak memerlukannya untuk inferensi batch yang sangat paralel atau job independen. Lakukan benchmark dengan workload Anda sendiri sebelum membayar fabric premium.
Bagaimana saya sebaiknya membandingkan sewa gpu cluster di India?
Gunakan worksheet sewa yang sama, lalu tambahkan pertanyaan spesifik India tentang region, residensi data, pajak, persyaratan invoice, jam dukungan, latensi, dan transfer data lintas batas. Jangan bandingkan hanya tarif GPU per jam.


