
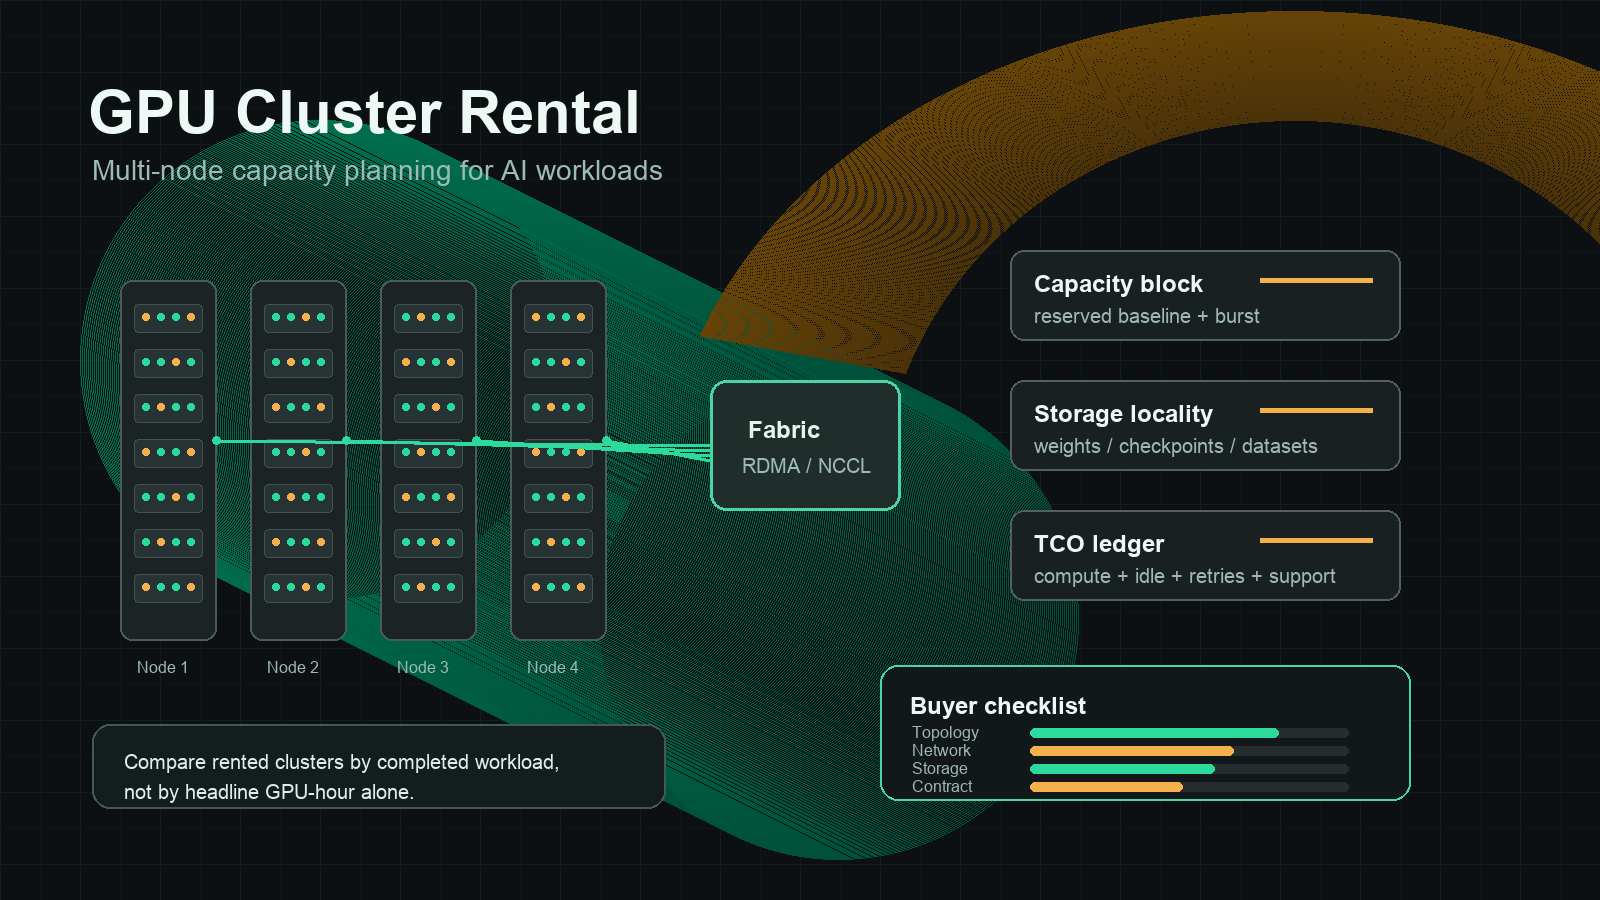
Alquiler de clústeres GPU: guía para compradores sobre capacidad de IA multinodo
El alquiler de clústeres GPU se vuelve atractivo cuando una GPU, un nodo o una cuenta de proveedor ya no son suficientes. Tal vez una ejecución de entrenamiento necesite de ocho a sesenta y cuatro GPU conectadas con redes de baja latencia. Tal vez el tráfico de inferencia tenga una base estable y un pico brusco durante la semana de lanzamiento. Tal vez compras quiera capacidad garantizada de H100, H200, B200 o L40S sin comprar hardware, contratar a un equipo de centro de datos y esperar los plazos de la cadena de suministro.
La parte difícil es que un "clúster GPU" no es un producto único. Una cotización puede significar una reserva de hyperscaler, una asignación de nube GPU especializada, un clúster bare metal, una flota de marketplace, una configuración de Kubernetes gestionada o un bloque de capacidad privada. La tarifa por hora de la GPU es solo la primera partida.
Esta guía ofrece a los equipos empresariales de IA una forma práctica de evaluar opciones de alquiler de clúster GPU, comparar proveedores de nube para alquiler de clúster GPU y decidir cuándo alquilar, reservar, comprar o usar en su lugar una API de modelo.
La respuesta rápida
Use el alquiler de clúster GPU cuando su carga de trabajo tenga al menos una de estas necesidades:
| Necesidad | Por qué apunta a un clúster |
|---|---|
| Entrenamiento multinodo | El modelo, el tamaño de lote o el método de ajuste fino necesitan más memoria o rendimiento del que puede proporcionar un nodo. |
| Inferencia multinodo | Necesita una capacidad base alta, aislamiento entre inquilinos o un tiempo de cola predecible para el tráfico de producción. |
| Utilización estable | La misma clase de GPU estará lo bastante ocupada como para justificar capacidad reservada o dedicada. |
| Trabajos sensibles a la red | El entrenamiento distribuido, el servicio fragmentado o las cargas de trabajo grandes de embeddings/índices necesitan una colocación conocida y un comportamiento de fabric definido. |
| Control de compras | Finanzas necesita un presupuesto comprometido, términos de soporte, región, alcance de cumplimiento y fecha de renovación. |
No elija el alquiler de clúster GPU solo porque una GPU grande parezca más barata por hora. Elíjalo cuando la carga de trabajo completada sea más barata o segura después de incluir red, almacenamiento, utilización, riesgo de reinicio, soporte, operaciones y condiciones contractuales.
costo real del clúster por resultado útil =
  (cómputo + almacenamiento + red + tiempo ocioso + reintentos + soporte + sobrecarga de ingeniería)
  / ejecuciones de entrenamiento aceptadas, tokens de inferencia, trabajos, imágenes o solicitudes de clientes
¿Qué cuenta como alquiler de clúster GPU?
El alquiler de clúster GPU puede describir varios movimientos de compra. Manténgalos separados durante la evaluación.
| Modelo de alquiler | Mejor encaje | Riesgo principal |
|---|---|---|
| Servidor multinodo de una sola GPU | Entrenamiento temprano, ajuste fino, trabajos por lotes, experimentos de un solo equipo | Es fácil quedarse corto; los supuestos de red no se transfieren a ejecuciones multinodo. |
| Clúster multinodo bajo demanda | Proyectos cortos, ventanas de benchmarking, capacidad de pico | La disponibilidad puede cambiar según la región y la familia de GPU. |
| Clúster reservado o dedicado | Inferencia en producción, calendario de entrenamiento planificado, ventanas de lanzamiento | Riesgo de utilización si la demanda cambia o una clase de GPU más nueva modifica la economía. |
| Flota de GPU de marketplace | Experimentos, trabajos por lotes flexibles, capacidad oportunista de menor costo | La fiabilidad del host, el movimiento de datos, las interrupciones y el soporte pueden variar. |
| Clúster gestionado de Kubernetes o Slurm | Equipos de plataforma que necesitan programación y gobernanza repetibles | Usted sigue siendo responsable del empaquetado de cargas de trabajo, la observabilidad, el control de costos y la respuesta a incidentes. |
| API de modelo o inferencia serverless | Equipos que necesitan resultados, no control del hardware | Menos control sobre pesos, kernels, colocación y la pila de servicio de bajo nivel. |
Por eso la consulta "alquiler de clúster GPU o clúster GPU en la nube" suele tener una división de intención de compra. Algunos equipos necesitan capacidad física que puedan programar. Otros necesitan resultados de IA fiables y no deberían operar GPUs directamente.
Empiece con la carga de trabajo, no con el proveedor
Antes de comparar proveedores de nube para alquiler de clúster GPU, redacte un resumen de capacidad de una página. La cotización de un proveedor solo es significativa si cada vendedor ve la misma forma de carga de trabajo.
| Campo breve | Qué escribir |
|---|---|
| Tipo de carga de trabajo | Preentrenamiento, ajuste fino, generación de embeddings para recuperación, inferencia por lotes, inferencia en línea, generación de imágenes/vídeo, simulación o cuadernos de investigación. |
| Modelo y framework | Familia de modelos, número de parámetros, precisión, cuantización, PyTorch/JAX, vLLM, SGLang, TensorRT-LLM, Ray, Kubernetes, Slurm u otro programador. |
| GPU objetivo | H100 SXM, H100 PCIe, H200, B200, A100, L40S, RTX 4090, RTX PRO 6000 o un rango de sustitutos aceptables. |
| Forma del clúster | GPUs por nodo, número de nodos, memoria por GPU, relación CPU/RAM, NVMe local y si los trabajos necesitan un grupo de colocación. |
| Necesidad de red | NVLink/NVSwitch dentro del nodo, InfiniBand o RoCE entre nodos, ancho de banda objetivo de all-reduce y jitter aceptable. |
| Ruta de almacenamiento | Tamaño del conjunto de datos, tamaño de los checkpoints, caché de pesos del modelo, ubicación del almacenamiento de objetos, scratch local, política de snapshots y período de retención. |
| Objetivo de utilización | Utilización de referencia esperada, horas de ráfaga, tolerancia a la inactividad, ventanas de mantenimiento y tiempo de cola esperado. |
| Política de fiabilidad | Frecuencia de checkpoints, presupuesto de reintentos, riesgo de expulsión tolerado, SLA de soporte y ruta de escalado de incidentes. |
| Datos y cumplimiento | Región, residencia de datos, privacidad, auditoría, exportación y requisitos de aislamiento del cliente. |
| Límite contractual | Duración del contrato, gasto mínimo, garantía de capacidad, ruta de actualización, alcance del soporte y términos de terminación. |
Si no puedes completar esta tabla, todavía no reserves un clúster. Primero alquila capacidad breve bajo demanda, evalúa la carga de trabajo y convierte el benchmark en un informe de compra.
Categorías de proveedores para comparar
Hay tres categorías de proveedores útiles para el alquiler de clústeres gpu.
| Categoría | Ejemplos a evaluar | En qué suelen destacar | Qué verificar |
|---|---|---|---|
| Nubes hyperscale | AWS, Google Cloud, Microsoft Azure | Identidad madura, regiones, cumplimiento, productos de red, soporte, controles de facturación | Disponibilidad de GPU, cuota, mecánica de reservas, factura total de la nube, coste de transferencia de datos y complejidad operativa. |
| Nubes especializadas en GPU | Lambda, CoreWeave, Crusoe, Runpod Enterprise, nubes de IA regionales | Conversaciones de adquisición de GPU más rápidas, soporte nativo para IA, precios de GPU más simples, términos de clúster dedicado | Red, almacenamiento, observabilidad, controles empresariales, SLA de soporte y términos de renovación/actualización. |
| Mercados y flotas flexibles | Vast.ai, capacidad al estilo comunidad de Runpod, capacidad de GPU intermediada | Menor coste de entrada y experimentos rápidos | Fiabilidad del host, riesgo de interrupción, movimiento de datos, profundidad del soporte, cumplimiento y si el tráfico de producción es apropiado. |
Usa las páginas oficiales de origen como puntos de control actuales, no como listas de tarifas permanentes. Para este artículo, las afirmaciones se verificaron el 12 de octubre de 2026.
| Fuente | Por qué importa en una revisión de compra |
|---|---|
| Instancias AWS EC2 P5 y EC2 Capacity Blocks | Comprueba la forma de la instancia del clúster H100, el lenguaje de EFA/redes, la mecánica de reservas, la cuota y la disponibilidad por región. |
| Máquinas optimizadas para aceleradores de Google Cloud y Precios de GPU | Comprueba las familias de máquinas A3/A4, la estructura de precios de GPU, el almacenamiento, los descuentos por uso comprometido y las notas de región. |
| Serie Azure ND H100 v5 | Comprueba la forma del clúster H100 de Azure, el marco de InfiniBand, el dimensionamiento de VM y la disponibilidad regional. |
| Lambda GPU Cloud | Comprueba las tarifas publicadas de la nube GPU, los tipos de instancia, los términos de nube reservada y las notas de disponibilidad. |
| Precios de Runpod y Documentación de Runpod | Separa pods, serverless, capacidad segura/de la comunidad, almacenamiento y supuestos sobre volumen de red. |
| Precios de Vast.ai y Documentación de Vast.ai | Trata cada listado como una oferta de marketplace con su propio host, fiabilidad, almacenamiento, ubicación y perfil de interrupción. |
| Pruebas NCCL de NVIDIA | Usa benchmarks prácticos de entrenamiento distribuido en lugar de aceptar un lenguaje genérico de "red de alta velocidad". |
| NVIDIA GPU Operator y Slurm GRES | Confirma si tu equipo o el proveedor posee la programación de GPU, los controladores, la telemetría y la política de asignación. |
Las comprobaciones multinodo que importan
El alquiler de una sola GPU es sobre todo una decisión de precio, memoria, imagen y disponibilidad. El alquiler de un clúster gpu multinodo añade topología y riesgo operativo.
1. Topología de GPU
Pide la forma exacta del nodo y si el clúster es homogéneo.
- Modelo de GPU y tamaño de memoria.
- PCIe frente a SXM cuando sea relevante.
- GPUs por nodo.
- Topología NVLink o NVSwitch intra-nodo.
- Modelo de CPU, RAM y NVMe local por nodo.
- Política de asignación MIG, vGPU o GPU completa.
- Si todos los nodos están en un solo dominio de colocación.
No aceptes "8x H100" como una especificación completa. Un servidor 8x H100 SXM, un servidor 8x H100 PCIe y ocho nodos H100 separados pueden comportarse de forma muy diferente.
2. Tejido de red
Para entrenamiento distribuido, la red puede decidir si el clúster es útil. Pide:
- Detalles de InfiniBand, RoCE, EFA, GPUDirect u otro tejido.
- Número y velocidad de NIC por nodo.
- Relación de sobreasignación.
- Garantía de colocación para los nodos cotizados.
- Si el proveedor ha ejecutado pruebas NCCL all-reduce en ese pool exacto.
- Política de mantenimiento y aislamiento de fallos.
Incluye la validación de red en la prueba de aceptación:
prueba de aceptación del clúster:
  ejecutar nccl-tests all_reduce en cada nodo alquilado
  comparar ancho de banda y latencia con la cotización del proveedor
  repetir después de instalar la imagen del contenedor, el controlador y el framework
  guardar registros con fecha, IDs de nodo, modelo de GPU y región
Si el proveedor no puede soportar un benchmark distribuido básico antes de firmar el contrato, considera eso una señal de riesgo.
3. Almacenamiento y ruta de datos
Los equipos de GPU a menudo subestiman el almacenamiento porque la cotización de GPU parece grande y la línea de almacenamiento parece ordinaria. Para clústeres multinodo, el almacenamiento decide el tiempo de inicio, el tiempo de checkpoint y la recuperación ante fallos.
Pide:
- NVMe local por nodo.
- Opciones de sistema de archivos compartido.
- Región de almacenamiento de objetos y ruta de egreso.
- Tiempo de preparación del conjunto de datos.
- Estrategia de caché de pesos del modelo.
- Rendimiento de escritura/lectura de checkpoints.
- Precios de snapshots y copias de seguridad.
- Política de limpieza después de que termine el alquiler.
Luego ejecuta una prueba real: descarga el contenedor de producción, prepara el conjunto de datos, carga los pesos, escribe un checkpoint, restaura desde el checkpoint y mide el tiempo facturable.
4. Programador y modelo de acceso
La mejor oferta de GPU todavía puede fallar si tu equipo no puede programar trabajos de forma fiable. Decide quién es responsable de:
- Configuración de Kubernetes o Slurm.
- Gestión de versiones de controladores y CUDA.
- Registro de contenedores y escaneo de imágenes.
- Acceso de usuarios, política SSH, secretos y registros de auditoría.
- Cuotas por equipo o proyecto.
- Apagado en inactividad.
- Etiquetas de coste y exportaciones de uso.
- Escalado de incidentes.
Un clúster gestionado por el proveedor puede reducir el tiempo de configuración, pero aun así necesitas un runbook claro para imágenes defectuosas, trabajos fallidos, disputas de cuota y cambios urgentes de capacidad.
Hoja de trabajo de precios en la nube para alquiler de clúster GPU
Para cada proveedor, normaliza la cotización en la misma hoja de trabajo.
| Concepto | Pregunta para hacer | Por qué cambia el TCO |
|---|---|---|
| Cómputo de GPU | ¿Cuál es la unidad facturable: segundo, minuto, hora, mes o bloque de capacidad? | Los trabajos cortos y el tiempo ocioso son sensibles a la granularidad de facturación. |
| Compromiso mínimo | ¿Hay un plazo, un gasto mínimo o una reserva no cancelable? | Una tarifa cotizada baja puede ser cara si la utilización cae. |
| Almacenamiento | ¿Qué niveles de almacenamiento están incluidos y cuáles se facturan por separado? | Los conjuntos de datos, checkpoints, pesos del modelo y snapshots pueden persistir después de que terminen los trabajos. |
| Red | ¿Se factura por separado el tráfico entre regiones, la salida pública, el enlace privado o el tejido dedicado? | Los conjuntos de datos grandes y los medios generados pueden mover más datos de lo esperado. |
| Soporte | ¿Cuál es el tiempo de respuesta, la ruta de escalado y la ayuda de ingeniería incluida? | Los incidentes del clúster son costosos durante las ventanas de entrenamiento. |
| Fiabilidad | ¿Qué pasa si falla un nodo durante un trabajo multinodo? | El tiempo de reinicio y cola debe incluirse en el modelo de costes. |
| Ruta de actualización | ¿Puedes pasar de capacidad H100 a H200/B200 durante el plazo? | Las generaciones de GPU cambian el rendimiento por dólar. |
| Observabilidad | ¿Obtienes utilización por nodo, registros de trabajos, exportaciones de facturación y códigos de motivo de fallo? | Sin datos de uso, finanzas no puede explicar la factura. |
| Seguridad | ¿Están documentados el aislamiento de inquilinos, los registros de auditoría, los secretos y los términos de eliminación de datos? | Los compradores empresariales necesitan pruebas, no garantías verbales. |
Usa esta fórmula en la hoja de cálculo:
TCO mensual del clúster =
  cómputo comprometido
  + cómputo en ráfaga
  + almacenamiento persistente
  + snapshots
  + egreso de red
  + soporte
  + desperdicio por inactividad
  + desperdicio por reintentos
  + sobrecarga de ingeniería
Luego calcula la unidad útil:
coste por unidad útil =
  TCO mensual del clúster / unidades de carga de trabajo aceptadas
La unidad útil debe coincidir con el resultado de negocio: fine-tunes completados, tokens de entrenamiento procesados, lotes de imágenes aceptados, tokens de inferencia, solicitudes de clientes o experimentos entregados.
Alquilar, reservar o comprar en 2026
La palabra clave "gpu cluster rental or cloud or buy 2026" llega a la verdadera pregunta de adquisición. Usa la tabla de decisiones a continuación antes de un compromiso grande.
| Opción | Prefiérala cuando | Evítela cuando |
|---|---|---|
| Alquilar bajo demanda | La carga de trabajo es nueva, el calendario es incierto o los benchmarks aún están cambiando. | Ya dispone de una utilización base estable y de requisitos urgentes de disponibilidad. |
| Reservar o dedicar capacidad | La utilización es predecible, las fechas de lanzamiento importan y la misma clase de GPU estará ocupada durante meses. | Es probable que la arquitectura del modelo, el motor de serving o el objetivo de GPU cambien pronto. |
| Comprar o colocalizar | Tiene una utilización muy alta, necesidades de hardware estables, experiencia en centros de datos y aprobación de capital. | Necesita escalado rápido, flexibilidad de generación de GPU, soporte gestionado o regiones globales. |
| Usar APIs de modelos | Necesita resultados del modelo más que control del hardware, y la sobrecarga operativa dominaría el ahorro de GPU. | Necesita pesos personalizados, control de kernel de bajo nivel, una pila privada de serving o ubicación fija del hardware. |
Para muchos equipos de producto de IA, el camino práctico es por etapas:
- Alquilar GPU bajo demanda para los benchmarks.
- Trasladar los trabajos estables a un alquiler de clúster GPU reservado o dedicado.
- Mantener el tráfico intermitente y de experimentación en capacidad flexible.
- Usar APIs de modelos para cargas de trabajo en las que el control de infraestructura no mejora el producto.
- Reevaluar la compra o la colocalización solo después de que la utilización y la forma de la carga de trabajo se estabilicen.
Alquiler de clúster GPU en India
La frase "gpu cluster rental in india" no debe tratarse como un artículo aparte salvo que el comprador tenga requisitos específicos de India en cuanto a aprovisionamiento, residencia de datos o latencia. Use la misma hoja de trabajo y luego añada comprobaciones regionales:
- ¿El clúster está físicamente en India, en regiones cercanas de Asia o solo se vende a empresas con sede en India?
- ¿Dónde residirán los datos de entrenamiento, los checkpoints y los registros?
- ¿Cuáles son los requisitos de transferencia transfronteriza, impuestos, facturación y horario de soporte?
- ¿Se necesita soporte local durante el horario laboral de India?
- ¿Importa la latencia para la inferencia o se trata de una carga de trabajo de entrenamiento sin conexión?
- ¿Existen restricciones de importación, compras o cumplimiento normativo si se compra hardware en lugar de alquilarlo?
Para el entrenamiento sin conexión, una región cercana puede ser aceptable si la transferencia de datos y el cumplimiento normativo están claros. Para la inferencia sensible a la latencia o los datos regulados, la región y las condiciones contractuales pueden importar más que la tarifa principal de la GPU.
Señales de alerta en las cotizaciones de alquiler de clúster GPU
Ponga en pausa el acuerdo si ve alguna de estas:
- La cotización dice "clúster H100" pero no PCIe/SXM, forma del nodo, memoria o red.
- El proveedor no puede describir cómo maneja el fallo de un nodo defectuoso en un trabajo distribuido.
- El almacenamiento y el egreso faltan en la cotización.
- Las condiciones de soporte son imprecisas durante su ventana de entrenamiento más costosa.
- Se usa "dedicado" sin aclarar el aislamiento de inquilinos, la colocación y el riesgo de vecino ruidoso.
- La cotización da una tarifa mensual baja pero no incluye términos de utilización o cancelación.
- No hay una ventana de benchmark antes del compromiso.
- El proveedor se niega a compartir campos de exportación de facturación o datos de uso.
- No puede verificar las versiones de driver/CUDA/framework antes de la primera carga de trabajo.
- La presentación comercial menciona cumplimiento normativo, pero el contrato no define el tratamiento y la eliminación de datos.
Qué benchmark realizar antes de firmar
Ejecute un pequeño conjunto de aceptación antes de reservar o ampliar un clúster GPU alquilado.
| Prueba | Condición de aprobación |
|---|---|
| Extracción e inicio del contenedor | La imagen de producción arranca rápido y de forma reproducible en cada nodo. |
| Salud de la GPU | Todas las GPU informan del modelo, la memoria, el driver y la compatibilidad con CUDA esperados. |
| NCCL all-reduce | El ancho de banda y la latencia entre nodos coinciden con la clase de clúster declarada por el proveedor. |
| Etapa de almacenamiento | El conjunto de datos y los pesos del modelo pueden prepararse dentro de la ventana de configuración planificada. |
| Lectura/escritura de checkpoints | Los checkpoints se completan sin dejar el tiempo de GPU inactivo durante demasiado tiempo. |
| Simulación de fallo | Mate a un trabajador y confirme el comportamiento de reinicio, checkpoint y facturación. |
| Apagado por inactividad | Los nodos no utilizados se detienen o alertan antes de que el desperdicio se acumule. |
| Exportación de facturación | El uso puede atribuirse por equipo, carga de trabajo, entorno y tarea. |
| Revisión de seguridad | El acceso, los secretos, los registros, la eliminación de datos y los registros de auditoría coinciden con la política. |
Guarde la salida del benchmark con la fecha, el proveedor, la región, el modelo de GPU, la versión de la imagen, la versión del framework y los IDs de nodo. Esto convierte la selección del proveedor, de un debate sobre tarifas, en una revisión de ingeniería reproducible.
Dónde encaja Flatkey
Flatkey no sustituye a todos los clústeres GPU alquilados. Si necesita pesos personalizados, kernels privados, entrenamiento multinodo o control directo del hardware, sigue necesitando capacidad GPU.
Flatkey es relevante cuando la pregunta es si necesita operar GPU en absoluto para una carga de trabajo determinada. Flatkey ofrece a los equipos una sola clave, un solo saldo y una sola factura en más de 300 modelos oficiales y más de 1.000 herramientas de pago por llamada, con visibilidad de uso a nivel de solicitud. Eso lo hace útil como vía de comparación para:
- Cargas de trabajo de prototipado antes de comprometerse con un clúster.
- Tráfico de agentes y aplicaciones que puede ejecutarse sobre APIs oficiales de modelos.
- Revisiones financieras que necesitan comparar el coste de GPU autoalojada con el coste de API de modelos.
- Equipos que quieren un libro mayor compartido para el uso de IA antes de decidir qué merece hardware dedicado.
Si una carga de trabajo no requiere control de hardware, compare el alquiler de clústeres GPU frente a una ruta de API en coste por resultado aceptado, no frente a horas brutas de GPU. Las guías relacionadas sobre precios de alquiler de GPU, comparación de precios de modelos de IA, cómo comparar precios de modelos de IA, precios de gateways de IA, gestión del gasto en API de IA y gestión de cuotas de API de IA son las siguientes comprobaciones adecuadas.
Lista de comprobación para compradores
Use esta lista de comprobación antes de aprobar el alquiler de clústeres GPU:
- Defina la carga de trabajo y la unidad de salida útil.
- Compare la capacidad bajo demanda antes de reservar.
- Especifique el modelo de GPU, la memoria, la forma del nodo, el almacenamiento local y la red.
- Exija una prueba de rendimiento distribuida para entrenamiento multinodo.
- Incluya almacenamiento, egreso, soporte, tiempo ocioso y desperdicio por reintentos en el TCO.
- Confirme los requisitos de región, cumplimiento, eliminación de datos y auditoría.
- Pregunte cómo afecta un nodo fallido a un trabajo en ejecución.
- Exija exportaciones de uso y facturación por equipo, entorno y trabajo.
- Separe la capacidad reservada base de la capacidad de ráfaga.
- Vuelva a comparar con APIs de modelos cuando no sea necesario controlar el hardware.
La mejor decisión de alquiler de clústeres GPU es la que completa la carga de trabajo de forma fiable con la menor sorpresa operativa. La hora de GPU más barata solo es útil si el clúster, el almacenamiento, la red y el contrato permiten que su equipo convierta esa hora en trabajo aceptado.
Preguntas frecuentes
¿Qué es el alquiler de clústeres GPU?
El alquiler de clústeres GPU es la práctica de alquilar varias GPU, a menudo en uno o más nodos conectados, para entrenamiento de IA, inferencia, procesamiento por lotes o investigación. Puede ser bajo demanda, reservado, dedicado, basado en marketplace o gestionado por un proveedor de nube.
¿Es el alquiler de clústeres GPU más barato que comprar GPU?
Depende de la utilización, la duración del contrato, la experiencia operativa, la financiación, la energía, el acceso al centro de datos, el soporte y la frecuencia con la que cambia su clase objetivo de GPU. Por lo general, alquilar gana en incertidumbre y velocidad. Comprar solo puede ganar cuando la utilización y las necesidades de hardware son lo suficientemente estables como para absorber los costes de capital y operación.
¿Qué debo preguntar a los proveedores cloud de alquiler de clústeres GPU?
Pida el modelo de GPU, la forma del nodo, la red, el almacenamiento, la región, la cuota, el SLA de soporte, las suposiciones de utilización, las exportaciones de facturación, las condiciones de eliminación de datos, el acceso a benchmarks y qué ocurre cuando falla un nodo durante un trabajo distribuido.
¿Necesito InfiniBand o RoCE para un clúster GPU alquilado?
Necesita redes de clúster de alto rendimiento cuando los trabajos se comunican intensamente entre nodos, especialmente en entrenamiento distribuido y serving fragmentado. Es posible que no lo necesite para inferencia por lotes embarrassingly parallel o trabajos independientes. Pruebe con su propia carga de trabajo antes de pagar por una red premium.
¿Cómo debo comparar el alquiler de clústeres GPU en India?
Use la misma hoja de cálculo de alquiler y luego añada preguntas específicas de India sobre región, residencia de datos, impuestos, requisitos de factura, horario de soporte, latencia y transferencia transfronteriza de datos. No compare solo la tarifa por hora de la GPU.


