
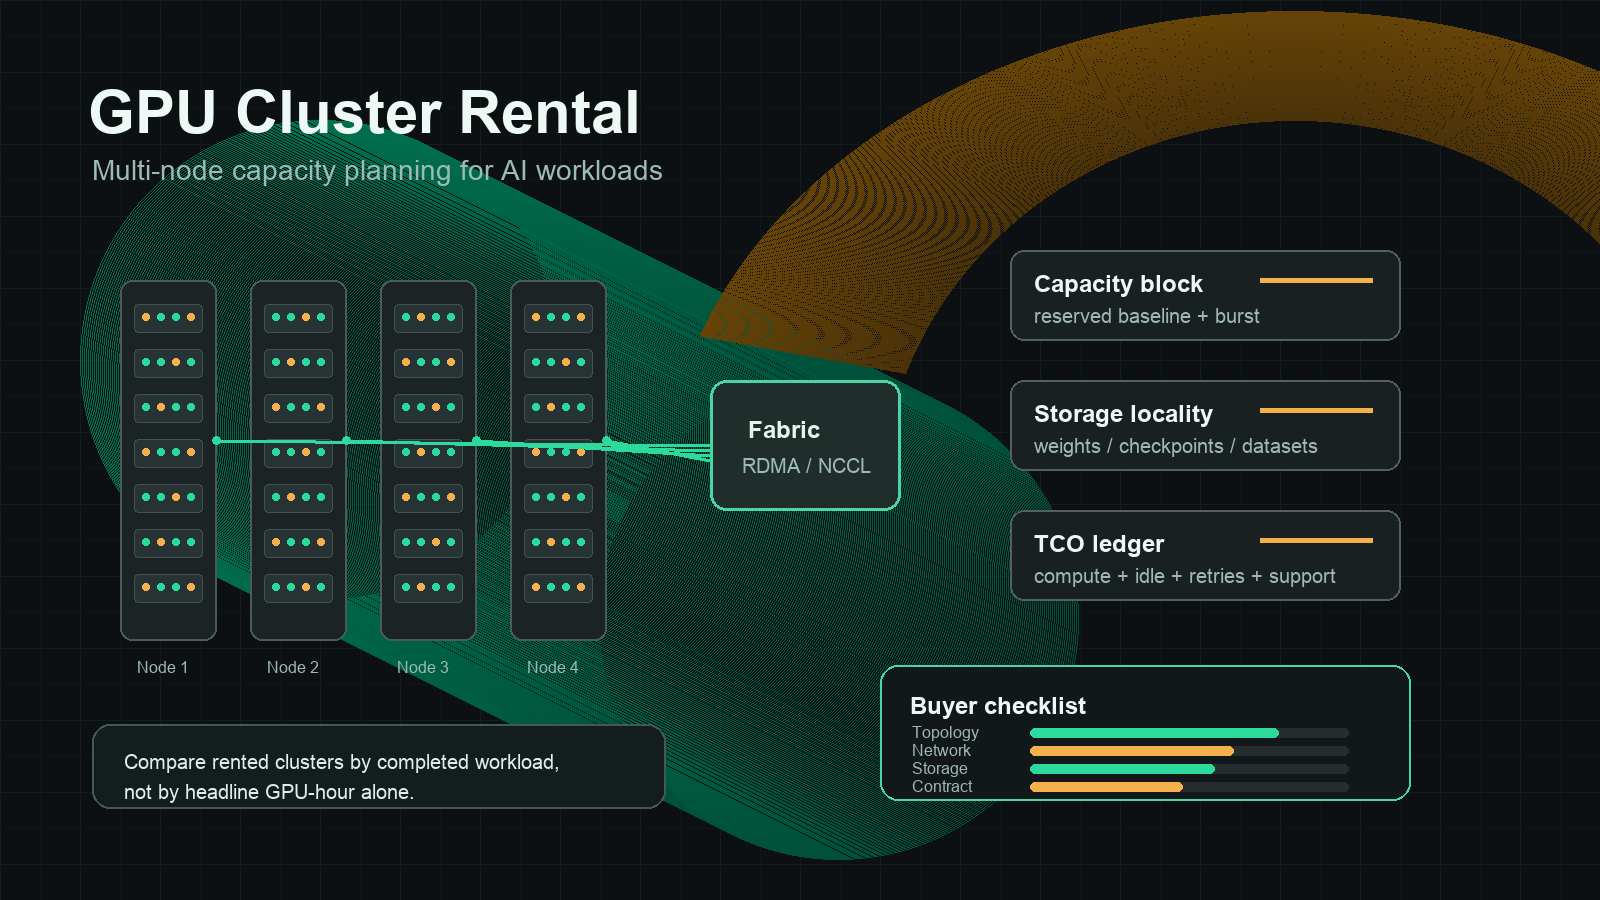
Аренда GPU-кластера: руководство для покупателей по многосерверной AI-мощности
Аренда GPU-кластера становится привлекательной, когда одного GPU, одного узла или одной учетной записи у провайдера уже недостаточно. Возможно, для обучения требуется от восьми до шестидесяти четырех GPU, соединенных сетью с низкой задержкой. Возможно, у inference-трафика есть стабильная базовая нагрузка и резкий всплеск в неделю запуска. Возможно, закупки хотят гарантированную мощность H100, H200, B200 или L40S без покупки оборудования, найма команды дата-центра и ожидания из-за сроков поставок.
Сложность в том, что «GPU-кластер» — это не один продукт. Коммерческое предложение может означать резерв у гиперскейлера, выделение в специализированном GPU-облаке, bare-metal-кластер, флот на маркетплейсе, управляемую конфигурацию Kubernetes или блок выделенной мощности. Почасовая ставка за GPU — это только первая строка затрат.
Это руководство дает командам enterprise AI практический способ оценивать варианты аренды GPU-кластера, сравнивать провайдеров облачной аренды GPU-кластера и решать, когда арендовать, резервировать, покупать или вместо этого использовать API модели.
Краткий ответ
Используйте аренду GPU-кластера, если вашей нагрузке нужен хотя бы один из следующих вариантов:
| Потребность | Почему это указывает на кластер |
|---|---|
| Многогпу-обучение | Модели, размер батча или метод fine-tuning требуют больше памяти или пропускной способности, чем может дать один узел. |
| Многосерверный inference | Вам нужна высокая базовая мощность, изоляция арендаторов или предсказуемое время ожидания очереди для production-трафика. |
| Стабильная загрузка | Один и тот же класс GPU будет достаточно загружен, чтобы оправдать резервированную или выделенную мощность. |
| Задачи, чувствительные к сети | Распределенное обучение, шардинговый serving или крупные workloads для embeddings/index требуют предсказуемого размещения и поведения fabric. |
| Контроль закупок | Финансам нужен фиксированный бюджет, условия поддержки, регион, объем соответствия требованиям и дата продления. |
Не выбирайте аренду GPU-кластера только потому, что крупный GPU выглядит дешевле в пересчете на час. Выбирайте ее тогда, когда итоговая нагрузка обходится дешевле или безопаснее, если учесть сеть, хранилище, утилизацию, риск перезапуска, поддержку, операции и условия контракта.
реальная стоимость кластера на единицу полезного результата =
  (вычисления + хранилище + сеть + простой + повторные попытки + поддержка + инженерные накладные расходы)
  / принятые training runs, inference tokens, jobs, images или customer requests
Что считается арендой GPU-кластера?
Аренда GPU-кластера может описывать несколько моделей закупки. При оценке держите их раздельно.
| Модель аренды | Лучший сценарий | Основной риск |
|---|---|---|
| Одноузловой сервер с несколькими GPU | Раннее обучение, fine-tuning, пакетные задания, эксперименты одной команды | Легко вырасти сверх возможностей; сетевые допущения не переносятся на многосерверные запуски. |
| Многосерверный кластер по запросу | Короткие проекты, окна для бенчмарков, burst-мощность | Доступность может меняться в зависимости от региона и семейства GPU. |
| Резервированный или выделенный кластер | Production inference, запланированный календарь обучения, окна запуска | Риск недоиспользования, если спрос изменится или более новый класс GPU изменит экономику. |
| Флот GPU на маркетплейсе | Эксперименты, гибкие пакетные задания, более дешевая доступная мощность | Надежность хоста, перемещение данных, прерывания и поддержка могут различаться. |
| Управляемый кластер Kubernetes или Slurm | Платформенные команды, которым нужны повторяемое планирование и governance | Вы по-прежнему отвечаете за упаковку workload, наблюдаемость, контроль затрат и реагирование на инциденты. |
| API модели или serverless inference | Команды, которым нужны результаты, а не контроль над оборудованием | Меньше контроля над весами, ядрами, размещением и низкоуровневым стеком serving. |
Поэтому запрос «gpu cluster rental or cloud gpu cluster» обычно имеет разделение по намерению покупки. Одним командам нужна физическая мощность, которую можно планировать. Другим нужны надежные AI-результаты, и им не следует напрямую управлять GPU.
Начинайте с workload, а не с провайдера
Прежде чем сравнивать провайдеров облачной аренды GPU-кластера, подготовьте одностраничное описание мощности. Коммерческое предложение имеет смысл только тогда, когда каждый вендор видит одинаковую форму workload.
| Краткое поле | Что указать |
|---|---|
| Тип нагрузки | Предобучение, дообучение, retrieval embedding, пакетный инференс, онлайн-инференс, генерация изображений/видео, симуляция или исследовательские ноутбуки. |
| Модель и фреймворк | Семейство моделей, число параметров, точность, квантизация, PyTorch/JAX, vLLM, SGLang, TensorRT-LLM, Ray, Kubernetes, Slurm или другой планировщик. |
| Целевая GPU | H100 SXM, H100 PCIe, H200, B200, A100, L40S, RTX 4090, RTX PRO 6000 или диапазон допустимых замен. |
| Форма кластера | GPU на узел, число узлов, память на GPU, соотношение CPU/RAM, локальный NVMe и нужен ли заданиям один placement group. |
| Требования к сети | Внутриузловой NVLink/NVSwitch, межузловой InfiniBand или RoCE, целевая пропускная способность all-reduce и допустимый jitter. |
| Путь хранения | Размер датасета, размер checkpoint, кэш весов модели, расположение object storage, локальный scratch, политика snapshot и период хранения. |
| Цель по утилизации | Ожидаемая базовая утилизация, часы пикового спроса, допустимый простой, окна обслуживания и ожидаемое время в очереди. |
| Политика надежности | Частота checkpoint, бюджет повторных попыток, допустимый риск eviction, SLA поддержки и путь эскалации инцидентов. |
| Данные и соответствие требованиям | Регион, требования к размещению данных, конфиденциальность, аудит, экспорт и изоляция клиентов. |
| Границы контракта | Срок, минимальные расходы, гарантия мощности, путь апгрейда, объем поддержки и условия расторжения. |
Если вы не можете заполнить эту таблицу, пока не резервируйте кластер. Сначала арендуйте краткосрочную on-demand мощность, проведите бенчмарк нагрузки и превратите результаты бенчмарка в закупочное ТЗ.
Категории провайдеров для сравнения
Для аренды gpu-кластера полезно рассматривать три категории провайдеров.
| Категория | Примеры для оценки | В чем они обычно сильны | Что проверить |
|---|---|---|---|
| Гиперскейл-облака | AWS, Google Cloud, Microsoft Azure | Зрелые identity, регионы, соответствие требованиям, сетевые продукты, поддержка, контроль биллинга | Доступность GPU, квоты, механика резервирования, итоговый облачный счет, стоимость передачи данных и операционная сложность. |
| Специализированные GPU-облака | Lambda, CoreWeave, Crusoe, Runpod Enterprise, региональные AI-облака | Более быстрые переговоры о закупке GPU, AI-native поддержка, более простое ценообразование GPU, условия выделенного кластера | Сетевую fabric, хранилище, observability, корпоративные controls, SLA поддержки и условия продления/апгрейда. |
| Маркетплейсы и гибкие пулы | Vast.ai, емкость в стиле community у Runpod, брокерская GPU-мощность | Более низкий порог входа и быстрые эксперименты | Надежность хоста, риск прерывания, перемещение данных, глубину поддержки, соответствие требованиям и подходит ли это для production traffic. |
Используйте официальные страницы источников как текущие ориентиры, а не как постоянные прайс-листы. Для этой статьи утверждения были проверены 12 октября 2026 года.
| Источник | Почему это важно при оценке для покупателя |
|---|---|
| AWS EC2 P5 instances и EC2 Capacity Blocks | Проверьте форму H100-кластера, формулировки про EFA/networking, механику резервирования, квоты и доступность в регионах. |
| Google Cloud accelerator-optimized machines и GPU pricing | Проверьте семейства машин A3/A4, структуру цен на GPU, хранилище, скидки за committed use и примечания по регионам. |
| Azure ND H100 v5 series | Проверьте форму H100-кластера в Azure, описание InfiniBand, размеры VM и доступность по регионам. |
| Lambda GPU Cloud | Проверьте опубликованные тарифы GPU cloud, типы инстансов, условия reserved cloud и примечания о доступности. |
| Runpod pricing и Runpod docs | Разделяйте предположения о pods, serverless, secure/community capacity, storage и объеме сети. |
| Vast.ai pricing и Vast.ai docs | Рассматривайте каждое объявление как предложение на маркетплейсе со своим хостом, надежностью, хранилищем, локацией и профилем прерываний. |
| NVIDIA NCCL tests | Используйте практические бенчмарки распределенного обучения вместо принятия общих формулировок вроде "high-speed network". |
| NVIDIA GPU Operator и Slurm GRES | Подтвердите, ваша команда или провайдер отвечает за планирование GPU, драйверы, телеметрию и политику выделения. |
Проверки для многосерверной конфигурации, которые действительно важны
Аренда одной GPU — это в основном решение о цене, памяти, образе и доступности. Аренда многосерверного gpu-кластера добавляет риски топологии и эксплуатации.
1. Топология GPU
Попросите точную форму узла и выясните, является ли кластер однородным.
- Модель GPU и объем памяти.
- PCIe или SXM, где это уместно.
- Количество GPU на узел.
- Топология NVLink или NVSwitch внутри узла.
- Модель CPU, RAM и локальный NVMe на узел.
- Политика выделения MIG, vGPU или полной GPU.
- Находятся ли все узлы в одной зоне размещения.
Не принимайте «8x H100» как полную спецификацию. Сервер 8x H100 SXM, сервер 8x H100 PCIe и восемь отдельных узлов H100 могут вести себя очень по-разному.
2. Сетевая фабрика
Для распределенного обучения сеть может решить, будет ли кластер полезен. Запросите:
- Подробности об InfiniBand, RoCE, EFA, GPUDirect или другой фабрике.
- Количество NIC и скорость на узел.
- Коэффициент оверсабскрипции.
- Гарантию размещения для предложенных узлов.
- Проводил ли провайдер тесты NCCL all-reduce на этом конкретном пуле.
- Политику обслуживания и изоляции отказов.
Включите проверку сети в приемочное тестирование:
cluster acceptance test:
  run nccl-tests all_reduce across every rented node
  compare bandwidth and latency to provider quote
  repeat after container image, driver, and framework install
  save logs with date, node IDs, GPU model, and region
Если провайдер не может поддержать базовый распределенный бенчмарк до подписания контракта, считайте это сигналом риска.
3. Хранилище и путь данных
Команды, работающие с GPU, часто недооценивают хранилище, потому что цена на GPU выглядит большой, а строка по хранилищу — обычной. Для многосерверных кластеров именно хранилище определяет время запуска, время контрольных точек и восстановление после сбоев.
Запросите:
- Локальный NVMe на узел.
- Варианты общего файлового хранилища.
- Регион объектного хранилища и путь egress.
- Время подготовки датасета.
- Стратегию кэширования весов модели.
- Пропускную способность записи/чтения контрольных точек.
- Цены на снимки и резервное копирование.
- Политику очистки после окончания аренды.
Затем проведите реальный тест: скачайте production-контейнер, подготовьте датасет, загрузите веса, запишите контрольную точку, восстановитесь из контрольной точки и измерьте тарифицируемое время.
4. Планировщик и модель доступа
Даже лучшая сделка по GPU может провалиться, если ваша команда не может надежно запускать задания. Определите, кто отвечает за:
- Настройку Kubernetes или Slurm.
- Управление версиями драйвера и CUDA.
- Реестр контейнеров и сканирование образов.
- Доступ пользователей, политику SSH, секреты и журналы аудита.
- Квоты по командам или проектам.
- Автоматическое отключение при простое.
- Теги затрат и экспорт использования.
- Эскалацию инцидентов.
Управляемый провайдером кластер может сократить время настройки, но вам все равно нужен четкий runbook для плохих образов, неудачных заданий, споров по квотам и срочных изменений емкости.
Таблица расчета облачной стоимости аренды GPU-кластера
Для каждого провайдера приведите предложение к единой таблице.
| Статья | Вопрос, который нужно задать | Почему это меняет TCO |
|---|---|---|
| GPU-вычисления | Какова тарифицируемая единица: секунда, минута, час, месяц или блок емкости? | Короткие задания и простой чувствительны к детализации тарификации. |
| Минимальное обязательство | Есть ли срок, минимальные расходы или невозвратная резервировка? | Дешевая ставка в предложении может оказаться дорогой, если загрузка падает. |
| Хранилище | Какие уровни хранения включены, а какие тарифицируются отдельно? | Датасеты, контрольные точки, веса модели и снимки могут сохраняться после завершения заданий. |
| Сеть | Межрегиональный трафик, публичный egress, private link или выделенная фабрика тарифицируются отдельно? | Большие датасеты и сгенерированные медиа могут передавать больше данных, чем ожидается. |
| Поддержка | Каково время ответа, путь эскалации и включенная инженерная помощь? | Инциденты кластера дорого обходятся во время окон обучения. |
| Надежность | Что происходит, если один узел выходит из строя во время многосерверного задания? | Перезапуск и время в очереди нужно учитывать в модели затрат. |
| Путь апгрейда | Можно ли в течение срока перейти с емкости класса H100 на H200/B200? | Поколения GPU меняют производительность на доллар. |
| Наблюдаемость | Получаете ли вы загрузку по узлам, журналы заданий, экспорт биллинга и коды причин сбоев? | Без данных об использовании финансовый отдел не сможет объяснить счет. |
| Безопасность | Документированы ли изоляция арендаторов, журналы аудита, секреты и условия удаления данных? | Корпоративным покупателям нужны доказательства, а не устные заверения. |
Используйте эту формулу в таблице:
monthly cluster TCO =
  committed compute
  + burst compute
  + persistent storage
  + snapshots
  + network egress
  + support
  + idle waste
  + retry waste
  + engineering overhead
Затем рассчитайте полезную единицу:
cost per useful unit =
  monthly cluster TCO / accepted workload units
Полезная единица должна соответствовать бизнес-результату: завершенные fine-tune, обработанные токены обучения, принятые пакеты изображений, токены инференса, запросы клиентов или отправленные эксперименты.
Арендовать, резервировать или покупать в 2026 году
Ключевая фраза «gpu cluster rental or cloud or buy 2026» подводит к реальному вопросу закупки. Используйте таблицу решений ниже перед крупным обязательством.
| Опция | Предпочтительна, когда | Избегать, когда |
|---|---|---|
| Аренда по требованию | Нагрузка новая, график неопределён, или бенчмарки всё ещё меняются. | У вас уже есть стабильный базовый уровень загрузки и срочные требования к доступности. |
| Резервирование или выделение мощности | Загрузка предсказуема, важны даты запуска, и один и тот же класс GPU будет занят месяцами. | Архитектура модели, движок обслуживания или целевой GPU, вероятно, скоро изменятся. |
| Покупка или колокация | У вас очень высокая загрузка, стабильные требования к оборудованию, опыт работы с дата-центром и одобрение капитальных затрат. | Вам нужно быстрое масштабирование, гибкость поколения GPU, управляемая поддержка или глобальные регионы. |
| Использование API моделей | Вам важнее результаты модели, чем контроль над оборудованием, а накладные расходы на операции будут превышать экономию на GPU. | Вам нужны пользовательские веса, низкоуровневый контроль ядер, приватный стек обслуживания или фиксированное размещение оборудования. |
Для многих команд, создающих AI-продукты, практичный путь выглядит поэтапно:
- Арендуйте GPU по требованию для бенчмарков.
- Перенесите стабильные задачи на резервированную или выделенную аренду GPU-кластера.
- Оставляйте всплесковую и экспериментальную нагрузку на гибкой мощности.
- Используйте API моделей для задач, где контроль инфраструктуры не улучшает продукт.
- Переоценивайте покупку или колокацию только после того, как загрузка и характер нагрузки стабилизируются.
Аренда GPU-кластера в Индии
Фразу "gpu cluster rental in india" не следует рассматривать как отдельную статью, если у покупателя нет требований, специфичных для Индии, к источнику поставки, локализации данных или задержке. Используйте ту же таблицу, а затем добавьте региональные проверки:
- Находится ли кластер физически в Индии, в соседних регионах Азии или продаётся только компаниям, зарегистрированным в Индии?
- Где будут храниться обучающие данные, чекпойнты и журналы?
- Какие требования к трансграничной передаче, налогам, счетам и времени поддержки?
- Нужна ли локальная поддержка в рабочие часы Индии?
- Имеет ли значение задержка для инференса, или это офлайн-задача обучения?
- Есть ли ограничения на импорт, закупки или соответствие требованиям, если покупать оборудование вместо аренды?
Для офлайн-обучения соседний регион может быть приемлемым, если передача данных и соответствие требованиям организованы корректно. Для инференса, чувствительного к задержке, или для регулируемых данных регион и условия контракта могут иметь большее значение, чем заявленная ставка за GPU.
Красные флаги в коммерческих предложениях по аренде GPU-кластера
Приостановите сделку, если видите что-либо из этого:
- В предложении указано "H100 cluster", но не указаны PCIe/SXM, форма узла, память или сеть.
- Поставщик не может описать, как будет обрабатываться сбой одного плохого узла в распределённой задаче.
- Хранилище и egress отсутствуют в коммерческом предложении.
- Условия поддержки расплывчаты в период вашего самого дорогого окна обучения.
- Слово "выделенный" используется без уточнения изоляции арендаторов, размещения и риска «шумного соседа».
- В предложении указана низкая ежемесячная ставка, но нет условий по использованию или отмене.
- Нет окна для бенчмарка до обязательства.
- Поставщик отказывается делиться полями экспорта биллинга или данными об использовании.
- Вы не можете проверить версии драйвера/CUDA/фреймворка до первой рабочей нагрузки.
- В коммерческой презентации упоминается соответствие требованиям, но в контракте не определены обработка и удаление данных.
Что протестировать перед подписанием
Запустите небольшой набор приемочных тестов, прежде чем резервировать или масштабировать арендованный GPU-кластер.
| Тест | Условие прохождения |
|---|---|
| Загрузка контейнера и запуск | Продакшен-образ быстро и воспроизводимо запускается на каждом узле. |
| Состояние GPU | Все GPU сообщают ожидаемую модель, память, драйвер и совместимость с CUDA. |
| NCCL all-reduce | Межузловая пропускная способность и задержка соответствуют заявленному поставщиком классу кластера. |
| Стадирование хранилища | Набор данных и веса модели можно подготовить в пределах запланированного окна настройки. |
| Запись/чтение чекпойнта | Чекпойнты завершаются без слишком длительного простоя GPU. |
| Проверка отказа | Остановите одного worker и подтвердите поведение перезапуска, чекпойнта и биллинга. |
| Отключение простоя | Неиспользуемые узлы останавливаются или подают сигнал до того, как потери накопятся. |
| Экспорт биллинга | Использование можно атрибутировать по команде, нагрузке, окружению и задаче. |
| Проверка безопасности | Доступ, секреты, журналы, удаление данных и аудиторские записи соответствуют политике. |
Сохраняйте результаты бенчмарка с датой, поставщиком, регионом, моделью GPU, версией образа, версией фреймворка и идентификаторами узлов. Это превращает выбор поставщика из спора о прайс-листе в воспроизводимую инженерную проверку.
Где уместен Flatkey
Flatkey не заменяет каждый арендованный GPU-кластер. Если вам нужны пользовательские веса, приватные ядра, многосерверное обучение или прямой контроль над оборудованием, вам всё равно нужна GPU-мощность.
Flatkey важен, когда вопрос в том, нужно ли вообще эксплуатировать GPU для конкретной задачи. Flatkey даёт командам один ключ, один баланс и один счёт на более чем 300 официальных моделей и более 1 000 инструментов с оплатой за вызов, с видимостью использования на уровне запросов. Это делает его полезным как альтернативный путь для:
- Прототипных задач до того, как вы возьмёте кластер.
- Трафика агентов и приложений, который может работать на официальных API моделей.
- Финансовых проверок, где нужно сравнить стоимость собственного GPU-хостинга со стоимостью API моделей.
- Команд, которым нужен общий реестр использования AI до решения о том, что заслуживает выделенного оборудования.
Если рабочая нагрузка не требует управления оборудованием, сравнивайте gpu cluster rental с вариантом через API по стоимости на принятый результат, а не по «сырым» часам GPU. В связанных руководствах о ценах на аренду GPU, сравнении цен на AI-модели, о том, как сравнивать цены на AI-модели, ценах AI gateway, управлении расходами на AI API и управлении квотами AI API стоит посмотреть в первую очередь.
Чек-лист покупателя
Используйте этот чек-лист перед утверждением gpu cluster rental:
- Определите рабочую нагрузку и полезную единицу результата.
- Протестируйте on-demand мощность до резервирования.
- Укажите модель GPU, объем памяти, конфигурацию узла, локальное хранилище и сетевую фабрику.
- Требуйте распределенный бенчмарк для многоузлового обучения.
- Включайте хранилище, исходящий трафик, поддержку, простои и потери на повторные попытки в TCO.
- Подтвердите регион, соответствие требованиям, удаление данных и требования к аудиту.
- Спросите, как отказ одного узла влияет на выполняющееся задание.
- Требуйте выгрузки данных по использованию и биллингу по команде, среде и задаче.
- Разделяйте базовую зарезервированную мощность и мощность для всплесков нагрузки.
- Снова сравнивайте с model APIs, когда управление оборудованием не требуется.
Лучшее решение по gpu cluster rental — это то, которое надежно завершает рабочую нагрузку с минимумом операционных сюрпризов. Самый дешевый час GPU полезен только тогда, когда кластер, хранилище, сеть и контракт позволяют вашей команде превратить этот час в принятый результат.
Вопросы, которые задают покупатели
Что такое gpu cluster rental?
GPU cluster rental — это практика аренды нескольких GPU, часто на одном или нескольких соединенных узлах, для AI-обучения, инференса, пакетной обработки или исследований. Это может быть on-demand, резервируемая, выделенная, рыночная модель или управление через облачного провайдера.
GPU cluster rental дешевле, чем покупка GPU?
Это зависит от загрузки, срока, компетенций по эксплуатации, финансирования, энергопотребления, доступа к дата-центру, поддержки и того, как часто меняется нужный вам класс GPU. Аренда обычно выигрывает там, где важны неопределенность и скорость. Покупка может быть выгоднее только тогда, когда загрузка и требования к оборудованию достаточно стабильны, чтобы оправдать капитальные и операционные затраты.
Что нужно спрашивать у cloud-провайдеров gpu cluster rental?
Спрашивайте о модели GPU, конфигурации узла, сетевой фабрике, хранилище, регионе, квоте, SLA поддержки, предположениях по загрузке, выгрузках биллинга, условиях удаления данных, доступе к бенчмаркам и о том, что происходит, если один узел выходит из строя во время распределенной задачи.
Нужны ли мне InfiniBand или RoCE для арендованного GPU-кластера?
Вам нужна высокопроизводительная сетевая инфраструктура кластера, когда задания активно обмениваются данными между узлами, особенно при распределенном обучении и шардинговом обслуживании. Для массово параллельного batch inference или независимых задач она может быть не нужна. Протестируйте на собственной рабочей нагрузке, прежде чем платить за премиальную фабрику.
Как сравнивать gpu cluster rental в Индии?
Используйте ту же таблицу для аренды, затем добавьте специфичные для Индии вопросы о регионе, локализации данных, налогах, требованиях к счетам, часах поддержки, задержке и трансграничной передаче данных. Не сравнивайте только почасовую ставку GPU.


