
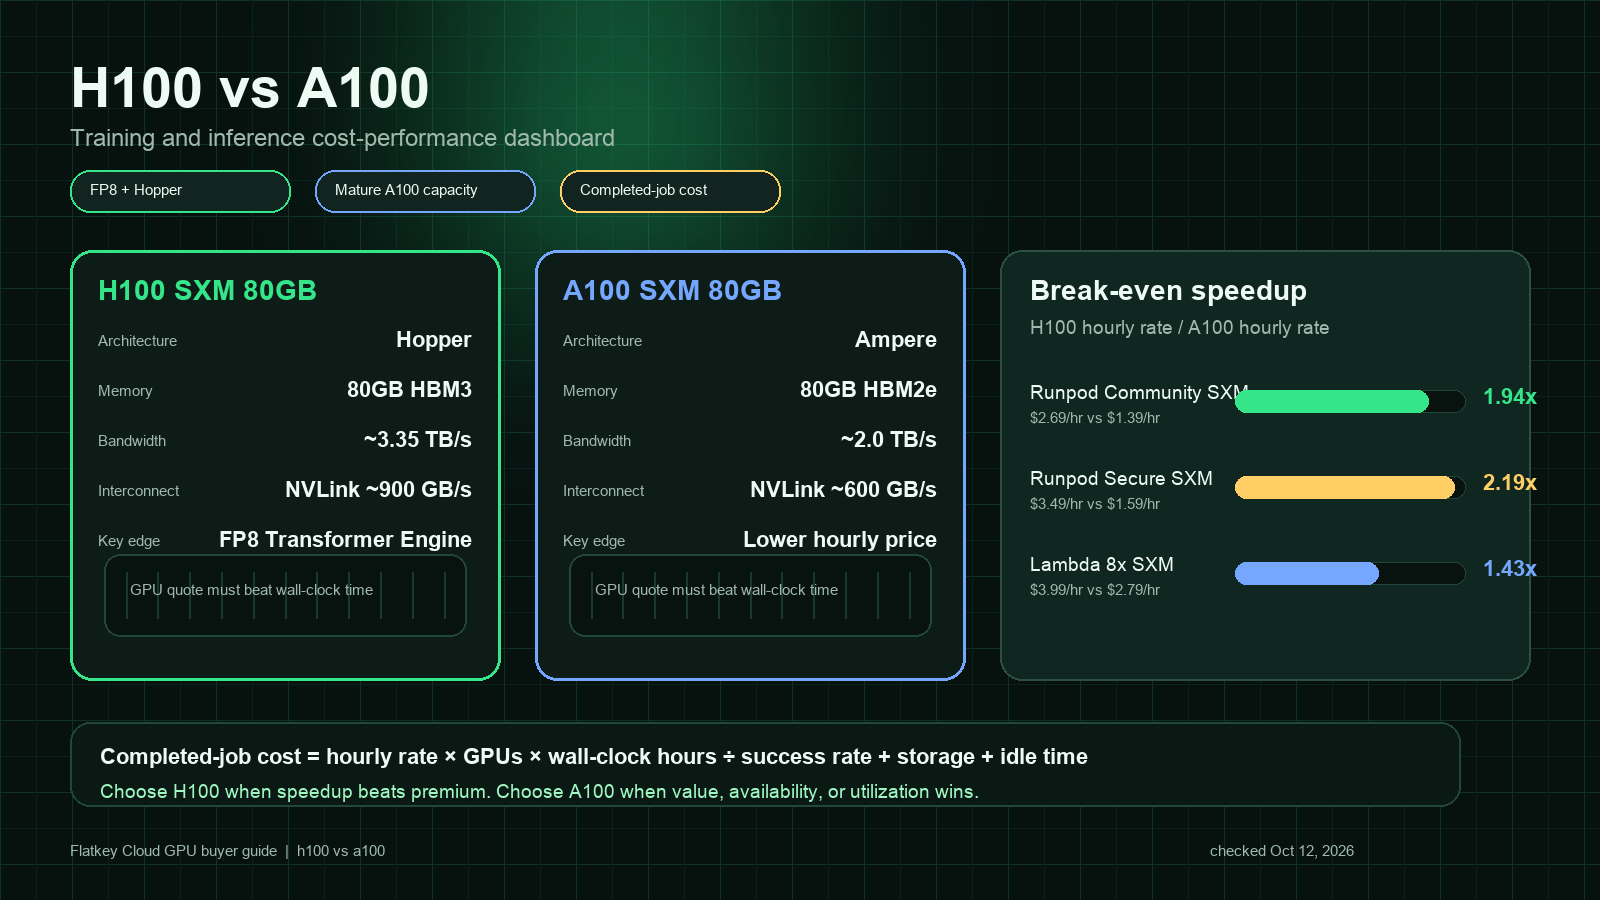
Die kurze Antwort auf H100 vs A100 ist einfach: Wählen Sie H100, wenn die Workload Hopper-Funktionen wie FP8 Transformer Engine, höhere Speicherbandbreite, schnelleres NVLink der vierten Generation und neuere Inferenz-Kernels ausnutzen kann. Wählen Sie A100, wenn der Job speicherstabil ist, der Durchsatz von FP16/BF16 bereits ausreicht, Verfügbarkeit wichtiger ist als Spitzenleistung oder das stündliche A100-Angebot deutlich niedriger ist.
Deshalb lautet die richtige Frage nicht: „Welche GPU ist schneller?“ H100 ist der neuere und schnellere Beschleuniger. Die Käuferfrage lautet: beendet H100 Ihren Trainings- oder Inferenz-Job deutlich schneller genug, um den Preisaufschlag gegenüber A100 zu schlagen?
Dieser Leitfaden vergleicht NVIDIA H100 vs A100 für KI-Training, LLM-Inferenz, Fine-Tuning, Batch-Jobs und die Beschaffung von Cloud-GPUs. Preise ändern sich jede Woche, daher sollten Sie die öffentlichen Preiszeilen unten als Angebotsbeispiele behandeln, die am 12. Oktober 2026 geprüft wurden, und dann dieselbe Berechnung mit Ihrer Shortlist an Anbietern erneut durchführen.
H100 vs A100 Performance: Schnell-Entscheidungstabelle
| Workload | In der Regel wählen | Warum |
|---|---|---|
| Frontier-LLM-Training oder großes verteiltes Pretraining | H100 SXM | FP8 Transformer Engine, höhere Speicherbandbreite, schnelleres NVLink und mehr Spielraum für Skalierung über mehrere GPUs. |
| Fine-Tuning von 7B- bis 70B-Modellen | Kommt darauf an | H100 gewinnt, wenn die Zeit bis zum Trainingsergebnis zählt; A100 gewinnt, wenn der Lauf nicht durch den Durchsatz begrenzt ist oder das Budget feststeht. |
| LLM-Inferenz mit geringer Latenzempfindlichkeit | H100 | Besserer Transformer-Inferenzpfad, höhere Bandbreite und neuere Optimierung des Serving-Stacks. |
| Batch-Inferenz mit lockerem SLA | A100 | Der niedrigere Stundenpreis kann gewinnen, wenn die Auslastung hoch ist und die Warteschlangenzeit akzeptabel ist. |
| Multi-Tenant-Notebooks, Demos und kleine Jobs | A100 | Reife Verfügbarkeit, niedrigere Kosten und MIG-Unterstützung machen A100 zur praktischen Standardwahl. |
| Speichergebundene Workloads, die in 80 GB passen | Beide testen | H100 hat deutlich höhere Bandbreite, aber A100 80 GB kann dennoch günstiger pro abgeschlossenem Job sein. |
| Legacy-CUDA-Workloads, die bereits für Ampere optimiert sind | Zuerst A100 | Niedrigeres Migrationsrisiko, außer H100-Benchmarking weist einen spürbaren Gewinn nach. |
Für die meisten Teams, die h100 vs a100 performance vergleichen, beginnen Sie mit einer Zwei-Zeilen-Regel:
- Wenn der Job teuer ist, weil er zu lange läuft, benchmarken Sie zuerst H100.
- Wenn der Job teuer ist, weil die GPU untätig ist, fehlschlägt oder auf Daten wartet, verbessern Sie die Auslastung, bevor Sie für H100 zahlen.
Zentrale Spezifikationsunterschiede
Der wichtigste Unterschied zwischen NVIDIA A100 vs H100 ist die Architektur-Generation. A100 basiert auf NVIDIA Ampere. H100 basiert auf NVIDIA Hopper und ergänzt den Transformer Engine, FP8-Tensor-Beschleunigung, ein neueres NVLink sowie höhere SXM-Leistungsgrenzen. NVIDIA positioniert H100 für große KI-, HPC- und Billionen-Parameter-Workloads, während A100 weiterhin ein breit eingesetzter Rechenzentrums-Beschleuniger für Training, Inferenz, Analytik und HPC ist. Quellen: NVIDIA H100 Produktseite, NVIDIA A100 Produktseite und NVIDIA Data Center GPU Line Card.
| Bereich | NVIDIA H100 SXM 80 GB | NVIDIA A100 SXM 80 GB | Auswirkung für Käufer |
|---|---|---|---|
| Architektur | Hopper | Ampere | H100 ist die neuere, für KI optimierte Generation. |
| Speicher | 80 GB HBM3 | 80 GB HBM2e | Gleiche Kernkapazität bei gängigen 80-GB-Modellen, aber H100 hat schnelleren Speicher. |
| Speicherbandbreite | Bis zu etwa 3,35 TB/s | Bis zu etwa 2,0 TB/s | H100 bietet mehr Spielraum für speichergebundenes Training und Inferenz. |
| Tensorgenauigkeit | FP8-, FP16-, BF16-, TF32-, FP64-Tensor-Pfade | FP16-, BF16-, TF32-, FP64-Tensor-Pfade | FP8 kann den Transformer-Durchsatz deutlich verbessern, wenn die Genauigkeit erhalten bleibt. |
| NVLink-Generation | NVLink der vierten Generation, bis zu 900 GB/s GPU-zu-GPU-Bandbreite auf SXM | NVLink der dritten Generation, bis zu 600 GB/s GPU-zu-GPU-Bandbreite auf SXM | H100 ist stärker für Multi-GPU-Training und große Modellparallelität. |
| MIG | Unterstützt | Unterstützt | Beide können GPUs für die Nutzung durch mehrere Mandanten aufteilen. |
| Typisches SXM-Leistungsbudget | Höher | Niedriger | H100 benötigt möglicherweise mehr Strom und Kühlung, kann aber schneller fertig werden. |
Diese Zahlen erklären, warum sich ein Vergleich h100 gpu vs a100 je nach Workload verändert. Ein Modell, das FP8 und neuere Kernels nutzen kann, kann sehen, dass H100 deutlich davonzieht. Ein kleinerer Job, der durch CPU-Vorverarbeitung, Speicher oder Netzwerk begrenzt ist, kann einen viel geringeren Zugewinn zeigen.
Kosten-Leistungs-Formel
Verwenden Sie die Kosten des abgeschlossenen Jobs statt des Stundenpreises:
completed_job_cost =
  GPU_hourly_rate
  x number_of_GPUs
  x wall_clock_hours
  / success_rate
  + storage
  + network
  + idle_time
  + orchestration_overhead
Dann vergleichen Sie:
H100 must be at least this much faster to break even =
  H100_hourly_rate / A100_hourly_rate
Wenn H100 1,8-mal so viel kostet wie A100, muss es denselben akzeptierten Job mehr als 1,8-mal schneller abschließen, um bei den reinen GPU-Mietkosten zu gewinnen. Wenn es 1,4-mal so viel kostet, ist die Schwelle für den Break-even niedriger. Deshalb sollte die Auswahl von Cloud-GPUs immer die exakte SKU und das konkrete Angebot verwenden: H100 SXM, H100 PCIe, H100 NVL, A100 SXM 80 GB und A100 PCIe 40 GB sind nicht austauschbar.
Für einen umfassenderen Überblick über versteckte Kosten siehe Flatkeys Leitfaden zu GPU-Mietpreisen.
Beispiele für GPU-Preise in Public Clouds, geprüft am 12. Oktober 2026
Die folgende Tabelle ist kein universeller Preisindex. Sie ist eine Momentaufnahme öffentlicher Beispiele, die zeigen, wie groß die Preisspanne sein kann.
| Anbieterseite | H100-Beispiel | A100-Beispiel | Was es zeigt |
|---|---|---|---|
| Runpod-Preise | H100 SXM: Community Cloud 2,69 $/Std., Secure Cloud 3,49 $/Std.; H100 PCIe: Community Cloud 1,99 $/Std., Secure Cloud 2,89 $/Std. | A100 SXM: Community Cloud 1,39 $/Std., Secure Cloud 1,59 $/Std.; A100 PCIe: Community Cloud 1,19 $/Std., Secure Cloud 1,59 $/Std. | Marktplatz- und sichere Umgebungen können unterschiedliche Break-even-Punkte haben. |
| Lambda-Preise | 8x H100 SXM Cluster-Zeile: 3,99 $/GPU/Std.; einzelne H100 SXM-Zeile: 4,29 $/GPU/Std.; einzelne H100 PCIe-Zeile: 3,29 $/GPU/Std. | 8x A100 SXM 80 GB Zeile: 2,79 $/GPU/Std.; einzelne A100 SXM 40 GB Zeile: 1,99 $/GPU/Std. | Clustergröße, Speichergröße und Node-Konfiguration sind ebenso wichtig wie der GPU-Name. |
| Massed Compute Preise | Seite listet On-Demand-GPU-Tarife und Konfigurationen | Seite listet On-Demand-GPU-Tarife und Konfigurationen | Prüfen Sie vor dem Vergleich immer Menge, Speicher, Storage und Instanzdetails. |
Anhand dieser Beispiele sollte ein Käufer, der a100 vs h100 performance vergleicht, keinen festen Aufpreis annehmen. In einem Angebot kann die H100 PCIe nah genug an der A100 liegen, dass sich die H100 leicht rechtfertigen lässt. In einem anderen kann die A100 günstig genug sein, dass ein langsamerer Lauf dennoch gewinnt.
Trainingsvergleich
Für das Training ist die H100 in der Regel die erste GPU, die man testen sollte, wenn:
- Sie Transformer-Modelle trainieren und FP8 Mixed Precision sicher nutzen können.
- Der Job groß genug ist, dass Kernel-Geschwindigkeit und Interconnect-Geschwindigkeit den Setup-Overhead dominieren.
- Sie Multi-Node- oder Multi-GPU-Model-Parallelismus einsetzen.
- Sie eine harte Deadline haben, bei der eine kürzere Laufzeit mehr wert ist als der stündliche Aufpreis.
- Ihr Team GPUs mit vorbereiteten Daten, stabilen Checkpoints und automatisierten Wiederholungen hoch auslasten kann.
Die A100 kann weiterhin der bessere Trainingskauf sein, wenn:
- Das Modell sauber in 80 GB passt und nicht stark von FP8 profitiert.
- Sie Fine-Tuning statt Pretraining durchführen.
- Sie viele Experimente ausführen, bei denen die Warteschlangentiefe wichtiger ist als der schnellste einzelne Lauf.
- Ihr Code, Ihre Treiber, der CUDA-Stack und das Monitoring auf der A100 bereits stabil sind.
- Sie reservierte Kapazität kaufen und der A100-Rabatt stark ist.
Die wichtige Beschaffungsregel ist, Kosten pro akzeptiertem Trainingslauf zu vergleichen, nicht nur Tokens pro Sekunde. Ein schneller H100-Lauf, der spät wegen Checkpoint-, Daten- oder Distributed-Training-Instabilität fehlschlägt, kann teurer sein als ein langsamerer A100-Lauf, der zuverlässig abgeschlossen wird.
Inferenzvergleich
Für Inferenz gewinnt die H100 oft, wenn der Serving-Pfad für moderne LLM-Kernels optimiert ist:
- Anfragen mit langem Kontext belasten Speicherbandbreite und KV-Cache-Bewegungen.
- Serving mit hoher Parallelität profitiert von neuerer Kernel-Optimierung.
- Die Latenz-SLOs sind so eng, dass eine niedrigere p95- oder p99-Latenz geschäftlichen Wert hat.
- Das Modell nutzt FP8- oder Quantisierungs-Pfade, die Ihr Serving-Stack validiert.
- Sie können genug Anfragen bündeln, um die GPU auszulasten.
Die A100 gewinnt oft, wenn:
- Batch-Jobs über Nacht laufen können.
- Das Anfragevolumen stark schwankt und teure H100s ansonsten im Leerlauf lassen würde.
- Das Modell klein genug ist, dass eine günstigere GPU-Klasse der eigentliche Gewinner ist.
- Sie stabile interne Tools statt umsatzkritischen Traffics bereitstellen.
- Sie Overflow an eine verwaltete Modell-API weiterleiten können, statt ungenutzte dedizierte Kapazität vorzuhalten.
Beim LLM-Serving hängt h100 vs a100 performance außerdem von der Softwareebene ab: vLLM, TensorRT-LLM, SGLang, NVIDIA NIM, Quantisierungsformat, Batching-Strategie, KV-Cache-Einstellungen und Prompt-Längenverteilung. Kaufen Sie die H100 nicht nur auf Basis eines generischen Benchmarks. Spielen Sie Ihre eigene Prompt-Mischung nach.
Ein praktischer Benchmark-Plan
Führen Sie denselben Benchmark auf jeder infrage kommenden SKU aus. Halten Sie die Akzeptanzkriterien konstant.
| Schritt | Was gemessen wird | Warum es wichtig ist |
|---|---|---|
| 1. Workload festlegen | Modell, Sequenzlänge, Batchgröße, Präzision, Datensatz, Wiederholungsrichtlinie | Verhindert einen Scheinvergleich von Äpfeln mit Äpfeln. |
| 2. Durchsatz messen | Training Tokens/Sek., Samples/Sek. oder Inferenz-Tokens/Sek. | Zeigt die rohe Geschwindigkeit. |
| 3. Latenz messen | p50, p95, p99, Time-to-First-Token, Decoding-Geschwindigkeit | Erfasst die für Nutzer sichtbare Leistung. |
| 4. Auslastung verfolgen | GPU-Auslastung, Speicherbandbreite, CPU-Wartezeit, Speicher-Wartezeit, Netzwerk-Wartezeit | Zeigt, ob die GPU-Wahl tatsächlich der Engpass ist. |
| 5. Fehler verfolgen | Job-Neustarts, OOMs, Kernel-Fehler, Spot-Unterbrechungen | Verwandelt günstige Stundensätze in echte Abschlusskosten. |
| 6. Akzeptierte Kosten berechnen | Kosten pro abgeschlossenem Lauf, akzeptierter Ausgabe oder einer Million bereitgestellter Tokens | Das ist die Kennzahl, die die Beschaffung vergleichen sollte. |
Minimales Inferenz-Replay:
100 kurze Prompts
100 mittlere Prompts
100 Prompts mit langem Kontext
gleiches Modell
gleiche Präzision
gleiche Server-Version
gleiche maximale Tokenzahl
gleiche Concurrent-Staffelung
gleiche Qualitätsprüfungen
Minimale Trainings-Wiederholung:
gleicher Checkpoint
selber Dataset-Shard
selber globaler Batch-Size-Zielwert
gleiche Optimizer-Einstellungen
gleiche Präzisionsrichtlinie
gleiches Checkpoint-Intervall
gleiche Methode zur Fehlerwiederherstellung
Wie viel schneller muss H100 sein?
Nehmen Sie Ihr Angebot und berechnen Sie dann den Break-even-Speedup.
| Beispielangebot | H100-Preis | A100-Preis | H100-Preisaufschlag | Break-even-Interpretation |
|---|---|---|---|---|
| Runpod Community H100 SXM vs A100 SXM | $2.69/hr | $1.39/hr | 1.94x | H100 muss mehr als 1.94x schneller fertig werden, bevor versteckte Kosten den GPU-Mietpreisvorteil aufwiegen. |
| Runpod Secure H100 SXM vs A100 SXM | $3.49/hr | $1.59/hr | 2.19x | H100 braucht einen großen Speedup oder einen starken Latenz-/Geschäftsgrund. |
| Lambda 8x H100 SXM vs 8x A100 SXM 80 GB | $3.99/GPU/hr | $2.79/GPU/hr | 1.43x | H100 kann schon mit einem deutlich kleineren Speedup gewinnen. |
| Lambda einzelne H100 PCIe vs einzelne A100 SXM 40 GB | $3.29/hr | $1.99/hr | 1.65x | Der Vergleich mischt SKUs; Speicher- und Interconnect-Unterschiede müssen berücksichtigt werden. |
Hier gehen viele a100 vs h100 performance-Vergleiche schief. Ein Benchmark mit der Aussage „H100 ist 2x schneller“ reicht nicht aus. Sie müssen wissen, ob Ihr H100-Angebot 1.4x, 1.9x oder 2.2x so teuer ist wie das A100-Angebot und ob der Job bei dieser Geschwindigkeit tatsächlich erfolgreich abgeschlossen wird.
Beschaffungs-Checkliste
Bevor Sie sich für H100 oder A100 entscheiden, fragen Sie Anbieter nach:
- Exakter GPU-SKU: SXM, PCIe, NVL, Speichergröße und MIG-Richtlinie.
- Node-Formfaktor: GPU-Anzahl, CPU, RAM, lokales NVMe, Netzwerk und Interconnect.
- Netzwerk-Fabric für Cluster: NVLink/NVSwitch innerhalb des Nodes, InfiniBand oder Ethernet zwischen Nodes, Oversubscription-Richtlinie.
- Speicherpreis und Leistung: lokale SSD, persistentes Volume, Objektspeicher, Snapshot und Wiederherstellungszeit.
- Egress- und Bandbreitenrichtlinie.
- Abrechnungseinheit: pro Sekunde, pro Minute oder pro Stunde.
- Unterbrechungsrichtlinie für Spot- oder Marketplace-Kapazität.
- Region und Compliance-Anforderungen.
- Support-SLA und Austauschprozess.
- Reservierungsbedingungen und Stornierungsregeln.
Für verteiltes Training kann die Node-Form entscheidend sein. Acht H100s hinter starkem NVSwitch und einem guten Fabric sind nicht vergleichbar mit acht isolierten GPUs, die über einen schwachen Netzwerkpfad verbunden sind.
Wann sich H100 den Aufpreis wert ist
H100 ist in der Regel den Aufpreis wert, wenn mindestens zwei der folgenden Punkte zutreffen:
- Die Workload ist transformer-lastig und mit FP8 oder Hopper-optimierten Kerneln validiert.
- Die Trainingszeit blockiert Releases, Kundenlieferungen oder Forschungsiterationen.
- Die p95- oder p99-Latenz bei Inferenz beeinflusst Umsatz oder Nutzerbindung.
- Der Job nutzt Multi-GPU-Kommunikation stark.
- Der Anbieter bietet einen moderaten H100-Aufpreis gegenüber A100.
- Ihr Team kann die Auslastung hoch halten.
H100 ist schwerer zu rechtfertigen, wenn:
- Die GPU über große Teile der Stunde untätig ist.
- Datenladen, CPU-Vorverarbeitung oder Netzwerk-I/O der Engpass sind.
- Ihr Serving-Stack nicht getuned ist.
- Das Modell klein genug für L40S, RTX PRO oder eine verwaltete API ist.
- A100-Kapazität stark rabattiert ist.
Wann A100 immer noch die pragmatische Wahl ist
A100 bleibt für viele KI-Teams ein praktischer Standard, weil es ausgereift, weit verfügbar und weiterhin stark für Training und Inferenz ist. Es ist besonders nützlich, wenn Sie planbare Kapazität brauchen für:
- Fine-Tuning-Jobs.
- Embedding-Generierung.
- Batch-Inferenz.
- Interne KI-Tools.
- Research-Notebooks.
- Multi-Tenant-Umgebungen mit MIG.
- Legacy-CUDA-Workloads, die bereits auf Ampere validiert wurden.
Wenn ein A100-Lauf halb so viel kostet und nur 20% langsamer fertig wird, gewinnt A100. Wenn er 30% weniger kostet, aber 2x so lange dauert, gewinnt wahrscheinlich H100. Die Rechnung ändert sich erneut, wenn A100-Kapazität leichter zu reservieren ist oder wenn die Wartezeit auf H100 das Projekt verzögert.
Wo Flatkey passt
GPU-Miete ist nicht immer der günstigste Weg, KI zu betreiben. Für manche Workloads ist eine verwaltete Modell-API günstiger, weil Sie pro erfolgreicher Anfrage zahlen statt eine GPU zu belegen. Für andere Workloads ist dedizierte GPU-Kapazität besser, weil Sie ein konstantes Volumen, benutzerdefinierte Modelle, strenge Latenzanforderungen oder Anforderungen an die Datenkontrolle haben.
Flatkey hilft Teams, diese Wege aus Anwendungssicht zu vergleichen: ein API-Schlüssel, ein Guthaben, ein Nutzungsprotokoll und Modell-Routing über offizielle Modell-Endpunkte. Nutzen Sie GPU-Miete, wenn die Workload dedizierte Kapazität benötigt. Nutzen Sie einen Modell-API-Pfad, wenn die Workload spiky ist, betrieblich einfacher oder pro akzeptierter Aufgabe günstiger ist.
H100 vs. A100 FAQ
Ist H100 schneller als A100?
Ja. H100 ist die neuere GPU der Hopper-Generation und hat deutliche Vorteile bei transformerorientierten Workloads, Speicherbandbreite, FP8-Unterstützung und dem neueren Interconnect. Die eigentliche Frage ist, ob sie schnell genug ist, um den H100-Preisaufschlag für Ihre Workload auszugleichen.
Ist A100 immer noch gut für LLM-Inferenz?
Ja. A100 ist immer noch eine leistungsfähige Inferenz-GPU, insbesondere für Batch-Serving, interne Tools, Embeddings und Workloads mit moderaten Latenzanforderungen. H100 ist stärker für High-Throughput- und latenzsensitive Transformer-Serving-Setups, wenn der Software-Stack getuned ist.
Sollte ich H100 SXM mit A100 PCIe vergleichen?
Nur wenn das die tatsächlichen Angebote sind, die Sie kaufen können. Für den technischen Vergleich sollten Formfaktor und Speicher so nah wie möglich beieinander liegen: H100 SXM vs. A100 SXM, H100 PCIe vs. A100 PCIe, 80 GB vs. 80 GB, wo verfügbar.
Macht FP8 die H100 automatisch besser?
Nein. FP8 hilft nur, wenn das Modell und der Software-Stack es ohne inakzeptablen Qualitätsverlust nutzen können. Überprüfen Sie Ausgabequalität, Konvergenz und Stabilität, bevor Sie von FP8-Einsparungen ausgehen.
Was ist besser für Fine-Tuning?
Für kleine und mittlere Fine-Tuning-Jobs kann die A100 kosteneffizienter sein. Für größere Jobs, enge Deadlines oder Trainings-Stacks, die von der Bandbreite und den FP8-Pfaden der H100 profitieren, kann die H100 die bessere Wahl sein.
Was ist die beste Kennzahl für H100 vs. A100?
Verwenden Sie die Kosten pro akzeptiertem Ergebnis: abgeschlossener Trainingslauf, akzeptierter Modell-Checkpoint, eine Million bereitgestellte Tokens, erfolgreicher Batch oder eine Antwort, die die Latenzanforderungen erfüllt. Der reine Stundenpreis ist unvollständig.
Fazit
Bei h100 vs a100 ist die H100 die Wahl für maximale Leistung und die A100 oft die Wahl für das bessere Preis-Leistungs-Verhältnis. Die H100 gewinnt, wenn Hopper-Features die Durchlaufzeit so stark verkürzen, dass sie den höheren Stundenpreis übertreffen. Die A100 gewinnt, wenn die Workload stabil ist, die Auslastung nicht perfekt ist, der Preisunterschied groß ist oder Latenz keine Einschränkung darstellt.
Bevor Sie eine der beiden GPUs reservieren, benchmarken Sie Ihr eigenes Modell, spielen Sie Ihren eigenen Traffic erneut ab und berechnen Sie die Kosten pro abgeschlossenem Job. Das ist der einzige H100-vs.-A100-Vergleich, der einer Beschaffungsprüfung standhält.


