
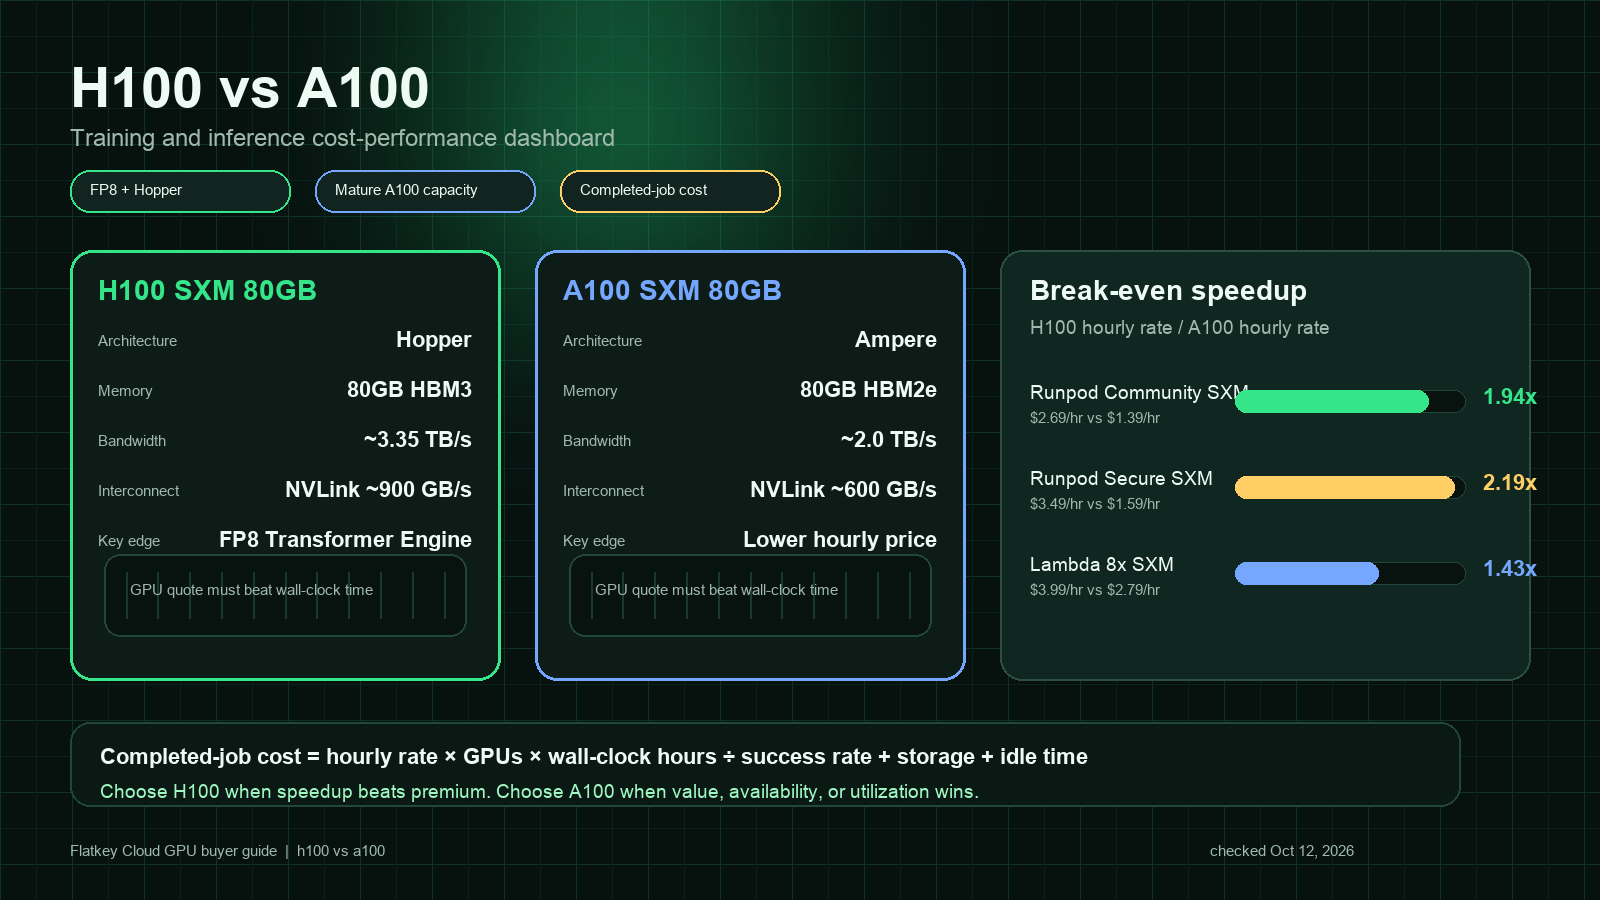
H100 と A100 の短い答えは明快です。Hopper の機能、たとえば FP8 Transformer Engine、より高いメモリ帯域幅、より高速な第4世代 NVLink、そして新しい推論カーネルを活用できるワークロードなら H100 を選びます。ジョブがメモリ安定型で、FP16/BF16 のスループットで十分、可用性がピーク速度より重要、または A100 の時間単価が大幅に低いなら A100 を選びます。
だからこそ、正しい問いは「どちらの GPU が速いか?」ではありません。H100 のほうが新しく、より高速なアクセラレータです。購入者が問うべきは、H100 はトレーニングまたは推論ジョブを十分に速く終え、A100 の価格プレミアムを上回れるか? です。
このガイドでは、AI トレーニング、LLM 推論、ファインチューニング、バッチジョブ、クラウド GPU 調達における NVIDIA H100 と A100 を比較します。価格は毎週変動するため、以下の公開価格の行は 2026 年 10 月 12 日に確認した見積もり例として扱い、同じ計算を自社の候補プロバイダーに対して再度実行してください。
H100 vs A100 の性能:簡易意思決定表
| ワークロード | 通常選ぶもの | 理由 |
|---|---|---|
| フロンティア LLM トレーニングまたは大規模分散事前学習 | H100 SXM | FP8 Transformer Engine、より高いメモリ帯域幅、より高速な NVLink、そしてより高いマルチ GPU スケーリング余地。 |
| 7B から 70B モデルのファインチューニング | 場合による | 学習時間が重要なら H100 が勝ちます。スループットがボトルネックでない、または予算が固定なら A100 が勝ちます。 |
| レイテンシ重視の LLM 推論 | H100 | より優れた transformer 推論パス、より高い帯域幅、そして新しいサービングスタック最適化。 |
| SLA に余裕のあるバッチ推論 | A100 | 利用率が高く、キュー待ち時間が許容できるなら、より低い時間単価が勝つことがあります。 |
| マルチテナントのノートブック、デモ、小規模ジョブ | A100 | 成熟した可用性、低コスト、MIG 対応により、A100 は実用的なデフォルトです。 |
| 80 GB に収まるメモリ帯域幅ボトルネックのワークロード | 両方をテスト | H100 ははるかに高い帯域幅を持ちますが、A100 80 GB でも完了ジョブあたりでは依然として安価な場合があります。 |
| Ampere 向けにすでに最適化されたレガシー CUDA ワークロード | まず A100 | H100 のベンチマークで大きな改善が証明されない限り、移行リスクは低いです。 |
ほとんどのチームが h100 vs a100 performance を比較する際は、2 行のルールから始めてください。
- ジョブが長すぎて高くつくなら、まず H100 をベンチマークします。
- ジョブが高くつく理由が、GPU が遊んでいる、失敗する、またはデータ待ちであることなら、H100 に料金を払う前に利用率を改善します。
主要スペックの違い
NVIDIA A100 vs H100 の最も重要な違いはアーキテクチャ世代です。A100 は NVIDIA Ampere ベースです。H100 は NVIDIA Hopper ベースで、Transformer Engine、FP8 tensor アクセラレーション、新しい NVLink、より高い SXM 電力上限を追加しています。NVIDIA は H100 を大規模 AI、HPC、1 兆パラメータ規模のワークロード向けに位置付けている一方、A100 はトレーニング、推論、分析、HPC に広く展開されるデータセンター向けアクセラレータとして引き続き利用されています。出典:NVIDIA H100 製品ページ、NVIDIA A100 製品ページ、および NVIDIA データセンター GPU ラインカード。
| 領域 | NVIDIA H100 SXM 80 GB | NVIDIA A100 SXM 80 GB | 購入者への示唆 |
|---|---|---|---|
| アーキテクチャ | Hopper | Ampere | H100 はより新しい AI 最適化世代です。 |
| メモリ | 80 GB HBM3 | 80 GB HBM2e | 一般的な 80 GB 製品では見かけ上の容量は同じですが、H100 のほうがメモリ速度は速いです。 |
| メモリ帯域幅 | 最大約 3.35 TB/s | 最大約 2.0 TB/s | H100 にはメモリ帯域幅依存のトレーニングと推論でより大きな余地があります。 |
| Tensor 精度 | FP8、FP16、BF16、TF32、FP64 tensor パス | FP16、BF16、TF32、FP64 tensor パス | 精度が維持されるなら、FP8 は transformer のスループットを大きく改善できます。 |
| NVLink 世代 | 第4世代 NVLink、SXM で GPU 間最大 900 GB/s | 第3世代 NVLink、SXM で GPU 間最大 600 GB/s | H100 はマルチ GPU トレーニングと大規模モデル並列化に強いです。 |
| MIG | 対応 | 対応 | どちらもマルチテナント利用のために GPU を分割できます。 |
| 典型的な SXM の消費電力範囲 | 高い | 低い | H100 はより多くの電力と冷却を必要とする場合がありますが、より速く完了できます。 |
これらの数値が、h100 gpu vs a100 の比較がワークロードによって変わる理由を説明します。FP8 と新しいカーネルを使えるモデルでは、H100 が大きく先行することがあります。CPU 前処理、ストレージ、またはネットワークがボトルネックの小規模ジョブでは、得られる改善はずっと小さくなる可能性があります。
コストパフォーマンスの式
時間単価ではなく、完了ジョブのコストを使ってください:
completed_job_cost =
  GPU_hourly_rate
  x number_of_GPUs
  x wall_clock_hours
  / success_rate
  + storage
  + network
  + idle_time
  + orchestration_overhead
次に比較します:
H100 must be at least this much faster to break even =
  H100_hourly_rate / A100_hourly_rate
もし H100 が A100 の 1.8 倍のコストなら、GPU レンタルの単純な比較で勝つには、同じ承認済みジョブを 1.8 倍以上速く終える必要があります。1.4 倍なら、損益分岐点のハードルは低くなります。だからこそ、クラウド GPU の選定では、正確な SKU と見積もりを常に使うべきです。H100 SXM、H100 PCIe、H100 NVL、A100 SXM 80 GB、A100 PCIe 40 GB は互換ではありません。
隠れたコストについてより広範なワークシートを知りたい場合は、Flatkey の GPU レンタル価格 ガイドをご覧ください。
2026年10月12日に確認したパブリッククラウド GPU 価格の例
以下の表は万能な価格指数ではありません。どれだけ価格差が大きくなり得るかを示す、公開例のスナップショットです。
| プロバイダーページ | H100 の例 | A100 の例 | 示していること |
|---|---|---|---|
| Runpod の料金 | H100 SXM: Community Cloud $2.69/hr, Secure Cloud $3.49/hr; H100 PCIe: Community Cloud $1.99/hr, Secure Cloud $2.89/hr | A100 SXM: Community Cloud $1.39/hr, Secure Cloud $1.59/hr; A100 PCIe: Community Cloud $1.19/hr, Secure Cloud $1.59/hr | マーケットプレイス環境とセキュア環境では、損益分岐点が異なる場合があります。 |
| Lambda の料金 | 8x H100 SXM クラスター行: $3.99/GPU/hr; 単体 H100 SXM 行: $4.29/GPU/hr; 単体 H100 PCIe 行: $3.29/GPU/hr | 8x A100 SXM 80 GB 行: $2.79/GPU/hr; 単体 A100 SXM 40 GB 行: $1.99/GPU/hr | GPU 名だけでなく、クラスターサイズ、メモリサイズ、ノード構成も重要です。 |
| Massed Compute の料金 | ページにはオンデマンド GPU レートと構成が掲載されています | ページにはオンデマンド GPU レートと構成が掲載されています | 比較する前に、数量、メモリ、ストレージ、インスタンスの詳細を必ず確認してください。 |
これらの例から、a100 vs h100 performance を比較する購入者は、固定されたプレミアムがあると考えるべきではありません。ある見積もりでは H100 PCIe は A100 に十分近く、H100 を正当化しやすいかもしれません。別の見積もりでは、A100 が十分に安く、少し遅い実行でも勝つことがあります。
トレーニング比較
トレーニング用途では、次のような場合に H100 が最初に試すべき GPU になることが多いです。
- Transformer モデルを訓練しており、FP8 の混合精度を安全に使える場合。
- ジョブが十分に大きく、カーネル速度と相互接続速度がセットアップのオーバーヘッドを上回る場合。
- マルチノードまたはマルチ GPU のモデル並列を使う場合。
- 短い実行時間の方が時間あたりのプレミアムより価値が高い、厳しい締め切りがある場合。
- 整備されたデータ、安定したチェックポイント、自動再試行によって GPU を高稼働率に保てる場合。
一方で、次のような場合は A100 の方がトレーニング購入として優れていることがあります。
- モデルが 80 GB にきれいに収まり、FP8 の恩恵が大きくない場合。
- 事前学習ではなくファインチューニングを行う場合。
- 最速の単一実行よりもキューの深さが重要な、多数の実験を回す場合。
- コード、ドライバ、CUDA スタック、監視がすでに A100 で安定している場合。
- 予約容量を購入し、A100 の割引率が大きい場合。
重要な調達の習慣は、単に tokens per second だけでなく、完了したトレーニング実行あたりのコストを比較することです。チェックポイント、データ、分散トレーニングの不安定さが原因で後半に失敗する高速な H100 実行は、確実に完了する遅い A100 実行より高くつくことがあります。
推論比較
推論では、H100 はサービング経路が最新の LLM カーネル向けに最適化されている場合に、しばしば有利です。
- 長いコンテキストのリクエストは、メモリ帯域幅と KV キャッシュ移動に負荷をかけます。
- 高並列サービングは、新しいカーネル最適化の恩恵を受けます。
- レイテンシ SLO が厳しく、p95 または p99 レイテンシの低さにビジネス価値がある場合。
- モデルが FP8 または量子化の経路を使用し、そのサービングスタックで検証されている場合。
- GPU を十分に稼働させるだけのリクエストをバッチ処理できる場合。
一方で、次のような場合は A100 が有利なことが多いです。
- バッチジョブを夜間に実行できる場合。
- リクエスト量がスパイクし、コストの高い H100 が遊休状態になってしまう場合。
- モデルが十分に小さく、より安価な GPU ティアの方が本当の勝者になる場合。
- 収益に直結するトラフィックではなく、安定した社内ツールを提供している場合。
- 遊休の専有容量を抱える代わりに、オーバーフローをマネージドモデル API にルーティングできる場合。
LLM サービングでは、h100 vs a100 performance はソフトウェア層にも左右されます。vLLM、TensorRT-LLM、SGLang、NVIDIA NIM、量子化フォーマット、バッチ戦略、KV キャッシュ設定、プロンプト長の分布です。一般的なベンチマークだけで H100 を買わないでください。自分のプロンプト構成で再現してください。
実践的なベンチマーク計画
各候補 SKU で同じベンチマークを実行します。合否基準は固定してください。
| ステップ | 測定するもの | 重要な理由 |
|---|---|---|
| 1. ワークロードを固定 | モデル、シーケンス長、バッチサイズ、精度、データセット、再試行ポリシー | 見せかけの apples-to-apples 比較を防ぎます。 |
| 2. スループットを測定 | トレーニング tokens/sec、samples/sec、または推論 tokens/sec | 純粋な速度を示します。 |
| 3. レイテンシを測定 | p50、p95、p99、time-to-first-token、decode speed | ユーザーに見える性能を捉えます。 |
| 4. 利用率を追跡 | GPU 利用率、メモリ帯域幅、CPU 待ち、ストレージ待ち、ネットワーク待ち | GPU 選定が本当のボトルネックかどうかを明らかにします。 |
| 5. 失敗を追跡 | ジョブの再起動、OOM、カーネルエラー、スポット中断 | 安価な時間単価を実際の完了コストに変換します。 |
| 6. 受理コストを算出 | 完了した実行あたりのコスト、受理された出力、または 100 万トークン提供あたりのコスト | 調達が比較すべき数値はこれです。 |
推論の最低限の再現条件:
100 の短いプロンプト
100 の中程度のプロンプト
100 の長文コンテキストのプロンプト
同じモデル
同じ精度
同じサーバーバージョン
同じ最大トークン数
同じ同時実行段階
同じ品質チェック
最小限のトレーニング再現条件:
same checkpoint
same dataset shard
same global batch size target
same optimizer settings
same precision policy
same checkpoint interval
same failure recovery method
H100はどれほど速ければよいのか?
見積もりを使って、損益分岐点となる高速化率を計算します。
| 見積もり例 | H100価格 | A100価格 | H100の価格プレミアム | 損益分岐点の解釈 |
|---|---|---|---|---|
| Runpod Community H100 SXM vs A100 SXM | $2.69/hr | $1.39/hr | 1.94x | GPUレンタルで勝つには、隠れたコストを考慮する前にH100が1.94倍以上速く終了する必要があります。 |
| Runpod Secure H100 SXM vs A100 SXM | $3.49/hr | $1.59/hr | 2.19x | H100には大きな高速化、または強いレイテンシー上の理由や事業上の理由が必要です。 |
| Lambda 8x H100 SXM vs 8x A100 SXM 80 GB | $3.99/GPU/hr | $2.79/GPU/hr | 1.43x | H100ははるかに小さな高速化でも勝てます。 |
| Lambda single H100 PCIe vs single A100 SXM 40 GB | $3.29/hr | $1.99/hr | 1.65x | 比較対象のSKUが混在しています。メモリと相互接続の違いを考慮する必要があります。 |
ここで多くのa100 vs h100 performance比較は誤ります。「H100は2倍速い」とするベンチマークだけでは不十分です。あなたのH100見積もりがA100見積もりの1.4倍なのか、1.9倍なのか、2.2倍なのか、そしてその速度で実際にジョブが正常に完了するのかを知る必要があります。
調達チェックリスト
H100かA100かを選ぶ前に、ベンダーに次を確認してください:
- 正確なGPU SKU: SXM、PCIe、NVL、メモリ容量、MIGポリシー。
- ノード構成: GPU数、CPU、RAM、ローカルNVMe、ネットワーク、相互接続。
- クラスタ向けネットワークファブリック: ノード内のNVLink/NVSwitch、ノード間のInfiniBandまたはEthernet、オーバーサブスクリプションポリシー。
- ストレージの価格と性能: ローカルSSD、永続ボリューム、オブジェクトストレージ、スナップショット、復元時間。
- エグレスと帯域幅のポリシー。
- 課金単位: 秒単位、分単位、または時間単位。
- スポットまたはマーケットプレイス容量の中断ポリシー。
- リージョンとコンプライアンス制約。
- サポートSLAと交換プロセス。
- 予約条件とキャンセル規定。
分散トレーニングでは、ノード構成が結果を左右することがあります。強力なNVSwitchと良好なファブリックの背後にある8基のH100は、弱いネットワーク経路で接続された8基の独立GPUとは比較できません。
H100がプレミアムに見合う場合
次のうち少なくとも2つが当てはまるなら、H100に追加料金を払う価値があることが多いです:
- ワークロードがTransformer中心で、FP8またはHopper最適化カーネルで検証されている。
- トレーニング時間がリリース、顧客納品、または研究反復を妨げる。
- 推論のp95またはp99レイテンシーが売上やユーザー維持に影響する。
- ジョブがマルチGPU通信を多用する。
- ベンダーがA100に対して中程度のH100プレミアムを提示している。
- チームが高い稼働率を維持できる。
H100の正当化が難しいのは次のような場合です:
- GPUが1時間のうち大部分でアイドル状態である。
- データ読み込み、CPU前処理、またはネットワークI/Oがボトルネックである。
- サービングスタックが最適化されていない。
- モデルが小さく、L40S、RTX PRO、またはマネージドAPIで十分である。
- A100の容量が大幅に値引きされている。
A100が依然として実務的な選択である場合
A100は成熟しており、広く利用可能で、トレーニングと推論の両方で依然として強力なため、多くのAIチームにとって実用的なデフォルトです。特に次の用途で、予測可能な容量が必要な場合に有用です:
- ファインチューニングジョブ。
- 埋め込み生成。
- バッチ推論。
- 社内AIツール。
- 研究用ノートブック。
- MIGを使うマルチテナント環境。
- Ampereで既に検証済みのレガシーCUDAワークロード。
A100の実行コストが半分で、完了までに20%しか余計にかからないなら、A100が勝ちます。30%安いが2倍時間がかかるなら、おそらくH100が勝ちます。A100容量の予約が容易かどうか、またはH100の待ち時間がプロジェクトを遅らせるかどうかでも、判断は変わります。
Flatkeyの位置づけ
GPUレンタルは、必ずしもAIを実行する最安の方法ではありません。一部のワークロードでは、GPUを保持するのではなく成功したリクエストごとに課金されるマネージドモデルAPIの方が安くなります。別のワークロードでは、安定した処理量、独自モデル、厳しいレイテンシー要件、またはデータ管理要件があるため、専用GPU容量の方が適しています。
Flatkeyは、アプリケーション側からこれらの選択肢を比較するのを支援します。1つのAPIキー、1つの残高、1つの使用台帳、そして公式モデルエンドポイント全体でのモデルルーティングです。ワークロードに専用容量が必要ならGPUレンタルを使います。ワークロードが断続的で、運用がより सरलで、または受理済みタスクあたりのコストが低いなら、モデルAPIルートを使います。
H100 vs A100 FAQ
H100はA100より速いですか?
はい。H100は新しいHopper世代のGPUで、Transformer中心のワークロード、メモリ帯域幅、FP8サポート、新しい相互接続において大きな利点があります。実際の判断ポイントは、あなたのワークロードに対してH100の価格プレミアムを上回るほど十分に速いかどうかです。
A100はまだLLM推論に適していますか?
はい。A100は依然として十分に使える推論向けGPUで、特にバッチ配信、社内ツール、埋め込み、レイテンシー要件が中程度のワークロードに向いています。ソフトウェアスタックが最適化されている場合、H100は高スループットかつレイテンシーに敏感なTransformerサービングでより強力です。
H100 SXMとA100 PCIeを比較すべきですか?
ただし、それらが実際に購入できる価格である場合に限ります。技術比較では、フォームファクターとメモリをできるだけ近づけて比較してください。入手可能であれば、H100 SXM 対 A100 SXM、H100 PCIe 対 A100 PCIe、80 GB 対 80 GB で比較します。
FP8でH100は自動的に優位になりますか?
いいえ。FP8が役立つのは、モデルとソフトウェアスタックが、許容できない品質低下なしにそれを利用できる場合だけです。FP8による節約を前提にする前に、出力品質、収束、安定性を検証してください。
ファインチューニングにはどちらが適していますか?
小規模から中規模のファインチューニングジョブでは、A100のほうが費用対効果が高い場合があります。より大規模なジョブ、厳しい期限、あるいはH100の帯域幅とFP8経路の恩恵を受ける学習スタックでは、H100が有利になることがあります。
H100とA100を比較する際の最適な指標は何ですか?
受け入れ可能な結果あたりのコストを使ってください。たとえば、完了した学習 रन、承認されたモデルチェックポイント、提供済み100万トークン、成功したバッチ、またはレイテンシ要件を満たした応答です。時間単価だけでは不十分です。
結論
h100 vs a100 では、H100は性能重視の選択肢であり、A100は多くの場合コスト重視の選択肢です。Hopperの機能によって処理時間が十分に短縮され、時間単価のプレミアムを上回れるならH100が勝ちます。ワークロードが安定している、稼働率が完璧でない、価格差が大きい、またはレイテンシが制約ではない場合はA100が勝ちます。
どちらのGPUを確保する前にも、自分のモデルでベンチマークを行い、自分のトラフィックを再現し、完了ジョブあたりのコストを算出してください。これこそが、調達レビューに耐えうる唯一のH100対A100比較です。


