
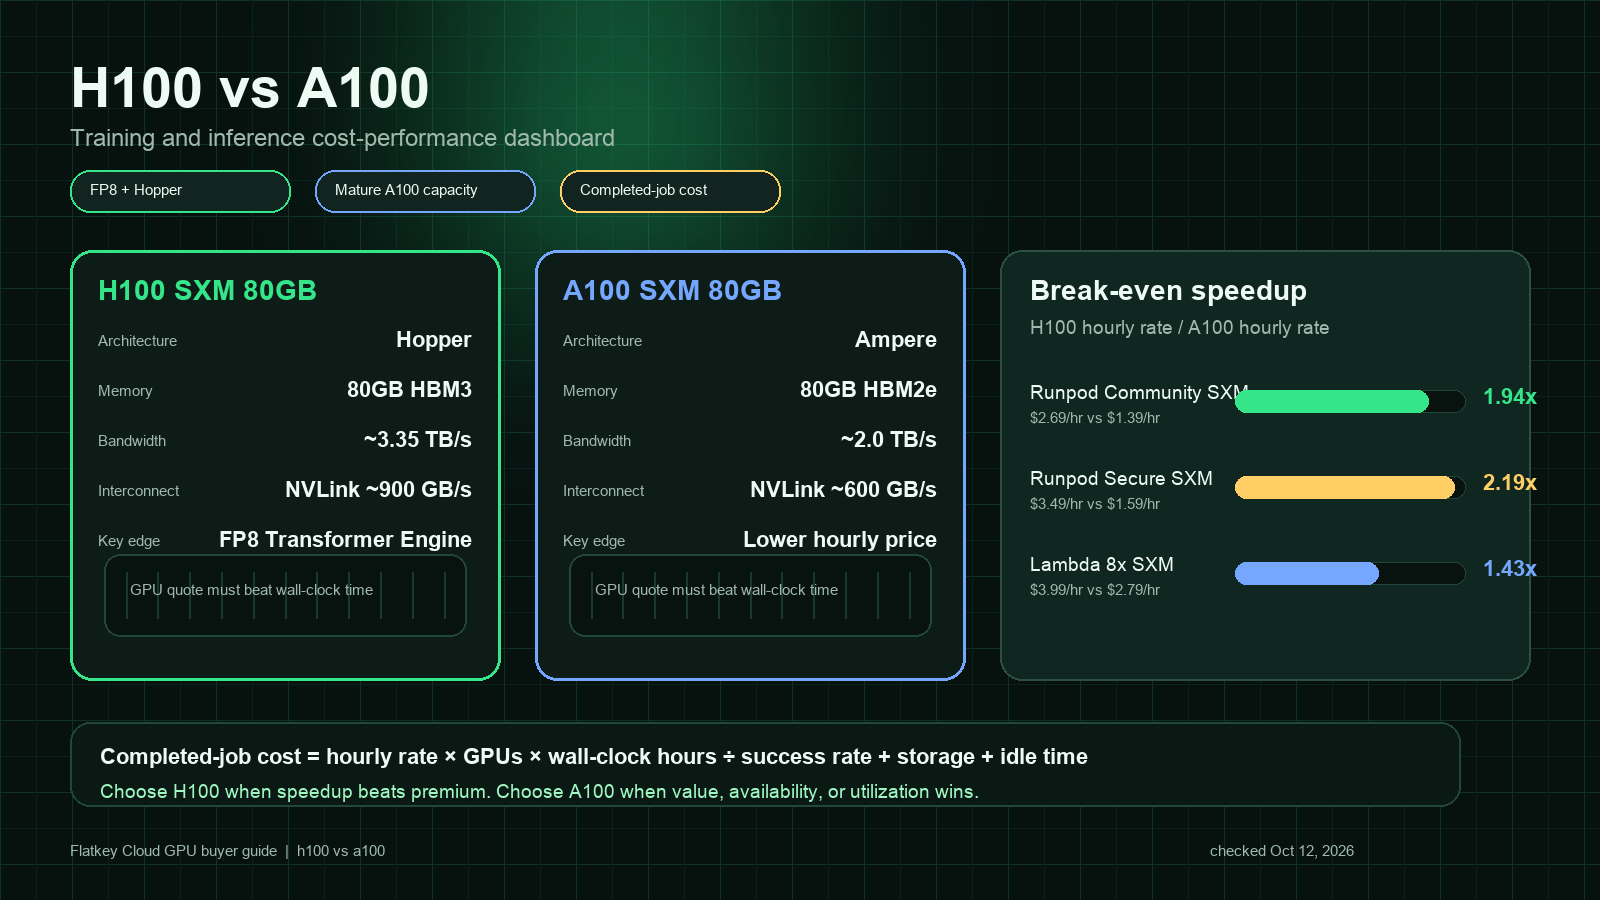
La réponse courte pour H100 vs A100 est simple : choisissez H100 lorsque la charge de travail peut exploiter les fonctionnalités Hopper telles que le Transformer Engine FP8, une bande passante mémoire plus élevée, un NVLink de quatrième génération plus rapide et des noyaux d’inférence plus récents. Choisissez A100 lorsque le travail est stable en mémoire, que le débit FP16/BF16 est déjà suffisant, que la disponibilité compte davantage que la vitesse de pointe, ou que le tarif horaire de l’A100 est nettement inférieur.
C’est pourquoi la bonne question n’est pas « Quel GPU est le plus rapide ? » Le H100 est l’accélérateur le plus récent et le plus rapide. La question de l’acheteur est : le H100 termine-t-il votre travail d’entraînement ou d’inférence suffisamment plus vite pour compenser la prime de prix de l’A100 ?
Ce guide compare NVIDIA H100 vs A100 pour l’entraînement IA, l’inférence de LLM, le fine-tuning, les traitements par lots et l’approvisionnement en GPU cloud. Les prix évoluent chaque semaine, donc considérez les lignes de prix publiques ci-dessous comme des exemples de devis vérifiés le 12 octobre 2026, puis refaites le même calcul avec votre sélection de fournisseurs.
Performances H100 vs A100 : tableau de décision rapide
| Charge de travail | Choix habituel | Pourquoi |
|---|---|---|
| Entraînement de LLM de pointe ou pré-entraînement distribué à grande échelle | H100 SXM | Transformer Engine FP8, bande passante mémoire plus élevée, NVLink plus rapide et meilleure marge de montée en charge multi-GPU. |
| Fine-tuning de modèles 7B à 70B | Ça dépend | Le H100 l’emporte lorsque le temps d’entraînement compte ; l’A100 l’emporte lorsque l’exécution n’est pas limitée par le débit ou que le budget est fixe. |
| Inférence LLM sensible à la latence | H100 | Meilleur chemin d’inférence pour les transformers, bande passante plus élevée et optimisation plus récente de la pile de service. |
| Inférence par lots avec SLA assoupli | A100 | Un prix horaire plus bas peut l’emporter si l’utilisation est élevée et que le temps d’attente dans la file est acceptable. |
| Notebooks multi-locataires, démonstrations et petits travaux | A100 | Disponibilité mature, coût plus faible et prise en charge MIG font de l’A100 un choix par défaut pratique. |
| Charges de travail limitées par la mémoire qui tiennent dans 80 Go | Tester les deux | Le H100 a une bande passante bien plus élevée, mais l’A100 80 Go peut encore être moins cher par tâche terminée. |
| Charges CUDA héritées déjà réglées pour Ampere | A100 en premier | Risque de migration plus faible, sauf si des tests de benchmark H100 prouvent un gain significatif. |
Pour la plupart des équipes qui comparent les performances H100 vs A100, commencez par une règle en deux lignes :
- Si le travail est coûteux parce qu’il dure trop longtemps, benchmarkez d’abord le H100.
- Si le travail est coûteux parce que le GPU reste inactif, échoue ou attend les données, améliorez l’utilisation avant de payer pour un H100.
Différences fondamentales de spécifications
La différence la plus importante entre NVIDIA A100 vs H100 est la génération architecturale. L’A100 est basé sur NVIDIA Ampere. Le H100 est basé sur NVIDIA Hopper et ajoute le Transformer Engine, l’accélération tensorielle FP8, un NVLink plus récent et des limites de puissance SXM plus élevées. NVIDIA positionne le H100 pour l’IA à grande échelle, le HPC et les charges de travail à mille milliards de paramètres, tandis que l’A100 reste un accélérateur de centre de données largement déployé pour l’entraînement, l’inférence, l’analytique et le HPC. Sources : page produit NVIDIA H100, page produit NVIDIA A100 et fiche produit GPU de centre de données NVIDIA.
| Domaine | NVIDIA H100 SXM 80 Go | NVIDIA A100 SXM 80 Go | Implication pour l’acheteur |
|---|---|---|---|
| Architecture | Hopper | Ampere | Le H100 est la génération plus récente optimisée pour l’IA. |
| Mémoire | 80 Go HBM3 | 80 Go HBM2e | Même capacité annoncée pour les modèles courants de 80 Go, mais le H100 a une mémoire plus rapide. |
| Bande passante mémoire | Jusqu’à environ 3,35 To/s | Jusqu’à environ 2,0 To/s | Le H100 dispose de plus de marge pour l’entraînement et l’inférence limités par la mémoire. |
| Précision tensorielle | Chemins tensoriels FP8, FP16, BF16, TF32, FP64 | Chemins tensoriels FP16, BF16, TF32, FP64 | Le FP8 peut améliorer sensiblement le débit des transformers lorsque la précision reste suffisante. |
| Génération NVLink | NVLink de quatrième génération, jusqu’à 900 Go/s de bande passante GPU-à-GPU sur SXM | NVLink de troisième génération, jusqu’à 600 Go/s de bande passante GPU-à-GPU sur SXM | Le H100 est plus solide pour l’entraînement multi-GPU et le parallélisme des grands modèles. |
| MIG | Pris en charge | Pris en charge | Les deux peuvent partitionner les GPU pour une utilisation multi-locataire. |
| Enveloppe de puissance SXM typique | Plus élevée | Plus faible | Le H100 peut nécessiter davantage d’alimentation et de refroidissement, mais peut terminer plus vite. |
Ces chiffres expliquent pourquoi une comparaison h100 gpu vs a100 varie selon la charge de travail. Un modèle qui peut utiliser le FP8 et les noyaux plus récents peut voir le H100 prendre une large avance. Un travail plus petit, limité par le prétraitement CPU, le stockage ou le réseau, peut montrer un gain beaucoup plus faible.
Formule coût-performance
Utilisez le coût du travail terminé plutôt que le prix horaire :
completed_job_cost =
  GPU_hourly_rate
  x number_of_GPUs
  x wall_clock_hours
  / success_rate
  + storage
  + network
  + idle_time
  + orchestration_overhead
Comparez ensuite :
H100 must be at least this much faster to break even =
  H100_hourly_rate / A100_hourly_rate
Si le H100 coûte 1,8 fois plus cher que l’A100, il doit terminer le même travail accepté plus de 1,8 fois plus vite pour gagner sur le simple coût de location du GPU. S’il coûte 1,4 fois plus cher, le seuil de rentabilité est plus bas. C’est pourquoi la sélection d’un GPU cloud doit toujours utiliser le SKU et le devis exacts : H100 SXM, H100 PCIe, H100 NVL, A100 SXM 80 Go et A100 PCIe 40 Go ne sont pas interchangeables.
Pour une feuille de calcul plus large sur les coûts cachés, consultez le guide de Flatkey sur les prix de location des GPU.
Exemples de prix de GPU dans le cloud public vérifiés le 12 octobre 2026
Le tableau ci-dessous n’est pas un indice de prix universel. Il s’agit d’un instantané d’exemples publics qui montre à quel point l’écart peut être important.
| Page du fournisseur | Exemple H100 | Exemple A100 | Ce que cela montre |
|---|---|---|---|
| Tarifs Runpod | H100 SXM : Community Cloud 2,69 $/h, Secure Cloud 3,49 $/h ; H100 PCIe : Community Cloud 1,99 $/h, Secure Cloud 2,89 $/h | A100 SXM : Community Cloud 1,39 $/h, Secure Cloud 1,59 $/h ; A100 PCIe : Community Cloud 1,19 $/h, Secure Cloud 1,59 $/h | Les environnements de place de marché et sécurisés peuvent avoir des points d’équilibre différents. |
| Tarifs Lambda | Ligne de cluster 8x H100 SXM : 3,99 $/GPU/h ; ligne unique H100 SXM : 4,29 $/GPU/h ; ligne unique H100 PCIe : 3,29 $/GPU/h | Ligne 8x A100 SXM 80 Go : 2,79 $/GPU/h ; ligne unique A100 SXM 40 Go : 1,99 $/GPU/h | La taille du cluster, la taille de la mémoire et la configuration du nœud comptent autant que le nom du GPU. |
| Tarifs Massed Compute | La page répertorie les tarifs GPU à la demande et les configurations | La page répertorie les tarifs GPU à la demande et les configurations | Inspectez toujours la quantité, la mémoire, le stockage et les détails de l’instance avant de comparer. |
D’après ces exemples, un acheteur comparant les performances a100 vs h100 ne doit pas supposer une prime fixe. Dans un devis, la H100 PCIe peut être assez proche de l’A100 pour que la H100 soit facile à justifier. Dans un autre, l’A100 peut être assez bon marché pour qu’une exécution plus lente l’emporte tout de même.
Comparaison pour l’entraînement
Pour l’entraînement, la H100 est généralement le premier GPU à tester lorsque :
- Vous entraînez des modèles transformers et pouvez utiliser en toute sécurité la précision mixte FP8.
- Le travail est suffisamment important pour que la vitesse des kernels et la vitesse d’interconnexion dominent les surcoûts de configuration.
- Vous utilisez le parallélisme de modèle multi-nœuds ou multi-GPU.
- Vous avez une échéance stricte où un temps d’exécution plus court vaut plus que la prime horaire.
- Votre équipe peut maintenir les GPU à un niveau d’utilisation élevé grâce à des données préparées, des points de contrôle stables et des nouvelles tentatives automatisées.
L’A100 peut néanmoins être le meilleur achat pour l’entraînement lorsque :
- Le modèle tient proprement dans 80 Go et ne profite pas beaucoup du FP8.
- Vous affinez un modèle plutôt que de le préentraîner.
- Vous exécutez de nombreuses expériences où la profondeur de file d’attente compte plus que l’exécution la plus rapide.
- Votre code, vos pilotes, votre pile CUDA et votre supervision sont déjà stables sur A100.
- Vous achetez de la capacité réservée et la remise sur l’A100 est importante.
L’habitude d’approvisionnement la plus importante consiste à comparer le coût par exécution d’entraînement acceptée, et pas seulement les tokens par seconde. Une exécution rapide sur H100 qui échoue tardivement à cause d’un problème de checkpoint, de données ou de stabilité de l’entraînement distribué peut coûter plus cher qu’une exécution plus lente sur A100 qui se termine de manière fiable.
Comparaison pour l’inférence
Pour l’inférence, la H100 l’emporte souvent lorsque le chemin de diffusion est optimisé pour les kernels modernes des LLM :
- Les requêtes à long contexte sollicitent la bande passante mémoire et le déplacement du KV-cache.
- Le service à forte concurrence bénéficie d’une optimisation plus récente des kernels.
- Les SLO de latence sont suffisamment stricts pour qu’une latence p95 ou p99 plus faible ait une valeur métier.
- Le modèle utilise FP8 ou des chemins de quantification validés par votre pile de diffusion.
- Vous pouvez regrouper suffisamment de requêtes pour maintenir le GPU occupé.
L’A100 l’emporte souvent lorsque :
- Les tâches par lot peuvent s’exécuter la nuit.
- Le volume de requêtes est irrégulier et laisserait des H100 coûteux inactifs.
- Le modèle est assez petit pour qu’un niveau de GPU moins cher soit le vrai gagnant.
- Vous diffusez des outils internes stables plutôt qu’un trafic critique pour le chiffre d’affaires.
- Vous pouvez rediriger le surplus vers une API de modèle gérée au lieu de conserver une capacité dédiée inutilisée.
Pour le service des LLM, les performances h100 vs a100 dépendent aussi de la couche logicielle : vLLM, TensorRT-LLM, SGLang, NVIDIA NIM, format de quantification, politique de batch, paramètres de KV-cache et distribution de la longueur des prompts. N’achetez pas une H100 sur la base d’un simple benchmark générique. Rejouez votre propre mélange de prompts.
Un plan de benchmark pratique
Exécutez le même benchmark sur chaque SKU candidat. Conservez des critères d’acceptation fixes.
| Étape | Ce qu’il faut mesurer | Pourquoi c’est important |
|---|---|---|
| 1. Verrouiller la charge de travail | Modèle, longueur de séquence, taille de batch, précision, jeu de données, politique de nouvelle tentative | Empêche une fausse comparaison entre éléments similaires. |
| 2. Mesurer le débit | Tokens/s d’entraînement, échantillons/s ou tokens/s d’inférence | Montre la vitesse brute. |
| 3. Mesurer la latence | p50, p95, p99, temps jusqu’au premier token, vitesse de décodage | Capture les performances visibles par l’utilisateur. |
| 4. Suivre l’utilisation | Utilisation GPU, bande passante mémoire, attente CPU, attente stockage, attente réseau | Révèle si le choix du GPU est le vrai goulot d’étranglement. |
| 5. Suivre les échecs | Redémarrages de tâches, OOM, erreurs de kernel, interruptions spot | Convertit les tarifs horaires bas en coût réel des exécutions terminées. |
| 6. Calculer le coût accepté | Coût par exécution terminée, sortie acceptée ou million de tokens servis | C’est le chiffre que l’approvisionnement doit comparer. |
Relecture minimale pour l’inférence :
100 invites courtes
100 invites moyennes
100 invites à long contexte
même modèle
même précision
même version du serveur
mêmes tokens max
même échelle de concurrence
mêmes contrôles de qualité
Reproduction minimale de l’entraînement :
same checkpoint
same dataset shard
same global batch size target
same optimizer settings
same precision policy
same checkpoint interval
same failure recovery method
De combien H100 doit-il être plus rapide ?
Utilisez votre devis, puis calculez le gain de vitesse au seuil de rentabilité.
| Exemple de devis | Prix H100 | Prix A100 | Prime de prix H100 | Interprétation du seuil de rentabilité |
|---|---|---|---|---|
| Runpod Community H100 SXM vs A100 SXM | $2.69/hr | $1.39/hr | 1.94x | H100 doit terminer plus de 1,94x plus vite avant les coûts cachés pour l’emporter sur le loyer GPU. |
| Runpod Secure H100 SXM vs A100 SXM | $3.49/hr | $1.59/hr | 2.19x | H100 nécessite un gain de vitesse important ou une forte raison liée à la latence/au business. |
| Lambda 8x H100 SXM vs 8x A100 SXM 80 GB | $3.99/GPU/hr | $2.79/GPU/hr | 1.43x | H100 peut l’emporter avec un gain de vitesse bien plus faible. |
| Lambda single H100 PCIe vs single A100 SXM 40 GB | $3.29/hr | $1.99/hr | 1.65x | La comparaison mélange des SKU ; les différences de mémoire et d’interconnexion doivent être prises en compte. |
C’est ici que de nombreuses comparaisons de performance a100 vs h100 se trompent. Un benchmark qui dit « H100 est 2x plus rapide » ne suffit pas. Vous devez savoir si votre devis H100 est 1,4x, 1,9x ou 2,2x celui de l’A100, et si la tâche se termine réellement avec succès à cette vitesse.
Liste de contrôle des achats
Avant de choisir H100 ou A100, demandez aux fournisseurs :
- SKU GPU exact : SXM, PCIe, NVL, taille de mémoire et politique MIG.
- Configuration du nœud : nombre de GPU, CPU, RAM, NVMe local, réseau et interconnexion.
- Infrastructure réseau pour les clusters : NVLink/NVSwitch à l’intérieur du nœud, InfiniBand ou Ethernet entre les nœuds, politique de surbooking.
- Prix et performances du stockage : SSD local, volume persistant, stockage objet, instantané et temps de restauration.
- Politique de sortie de données et de bande passante.
- Unité de facturation : par seconde, par minute ou par heure.
- Politique d’interruption pour les capacités spot ou marketplace.
- Contraintes de région et de conformité.
- SLA de support et processus de remplacement.
- Conditions de réservation et règles d’annulation.
Pour l’entraînement distribué, la configuration du nœud peut décider du résultat. Huit H100 derrière un NVSwitch robuste et une bonne infrastructure réseau ne sont pas comparables à huit GPU isolés connectés via un chemin réseau faible.
Quand H100 vaut la prime
H100 vaut généralement la peine d’être payé lorsque au moins deux des conditions suivantes sont vraies :
- La charge de travail est fortement orientée transformers et validée avec FP8 ou des kernels optimisés pour Hopper.
- Le temps d’entraînement bloque les releases, la livraison client ou l’itération de recherche.
- La latence p95 ou p99 de l’inférence affecte le chiffre d’affaires ou la rétention des utilisateurs.
- La tâche utilise fortement la communication multi-GPU.
- Le fournisseur propose une prime H100 modérée par rapport à l’A100.
- Votre équipe peut maintenir une utilisation élevée.
H100 est plus difficile à justifier lorsque :
- Le GPU est inactif pendant une grande partie de l’heure.
- Le chargement des données, le prétraitement CPU ou l’E/S réseau constituent le goulot d’étranglement.
- Votre pile de service n’est pas optimisée.
- Le modèle est suffisamment petit pour L40S, RTX PRO ou une API gérée.
- La capacité A100 est fortement remisée.
Quand A100 reste le choix pragmatique
A100 reste un choix par défaut pratique pour de nombreuses équipes IA, car il est mature, largement disponible et toujours performant pour l’entraînement et l’inférence. Il est particulièrement utile lorsque vous avez besoin d’une capacité prévisible pour :
- Les travaux de fine-tuning.
- La génération d’embeddings.
- L’inférence par lots.
- Les outils IA internes.
- Les notebooks de recherche.
- Les environnements multi-tenant utilisant MIG.
- Les charges CUDA héritées déjà validées sur Ampere.
Si une exécution sur A100 coûte deux fois moins cher et se termine seulement 20 % plus lentement, A100 l’emporte. Si elle coûte 30 % de moins mais prend 2x plus de temps, H100 l’emporte probablement. Le calcul change à nouveau si la capacité A100 est plus facile à réserver ou si le temps d’attente H100 retarde le projet.
Où Flatkey s’insère
La location de GPU n’est pas toujours la manière la moins chère de faire tourner l’IA. Pour certaines charges de travail, une API de modèle gérée est moins coûteuse parce que vous payez par requête réussie au lieu de monopoliser un GPU. Pour d’autres charges, une capacité GPU dédiée est préférable parce que vous avez un volume stable, des modèles personnalisés, des besoins de latence stricts ou des exigences de contrôle des données.
Flatkey aide les équipes à comparer ces voies côté application : une clé API, un solde, un registre d’utilisation, et un routage de modèles entre les points de terminaison officiels. Utilisez la location de GPU lorsque la charge de travail nécessite une capacité dédiée. Utilisez une route API de modèle lorsque la charge de travail est intermittente, plus simple opérationnellement ou moins chère par tâche acceptée.
FAQ H100 vs A100
H100 est-il plus rapide qu’A100 ?
Oui. H100 est le GPU plus récent de génération Hopper et présente des avantages majeurs pour les charges de travail orientées transformers, la bande passante mémoire, la prise en charge FP8 et une interconnexion plus récente. La vraie décision est de savoir s’il est suffisamment plus rapide pour compenser la prime de prix H100 pour votre charge de travail.
A100 reste-t-il bon pour l’inférence LLM ?
Oui. A100 reste un GPU d’inférence capable, en particulier pour le service par lots, les outils internes, les embeddings et les charges de travail où les exigences de latence sont modérées. H100 est plus performant pour le service de transformers à haut débit et sensible à la latence lorsque la pile logicielle est optimisée.
Dois-je comparer H100 SXM à A100 PCIe ?
Seulement si ce sont bien les tarifs auxquels vous pouvez réellement acheter. Pour une comparaison technique, gardez au plus près le format et la mémoire : H100 SXM vs A100 SXM, H100 PCIe vs A100 PCIe, 80 Go vs 80 Go lorsque c’est disponible.
Le FP8 rend-il automatiquement le H100 meilleur ?
Non. Le FP8 n’aide que lorsque le modèle et la pile logicielle peuvent l’utiliser sans perte de qualité inacceptable. Validez la qualité des sorties, la convergence et la stabilité avant de supposer des gains liés au FP8.
Lequel est le meilleur pour le fine-tuning ?
Pour les tâches de fine-tuning de petite et moyenne taille, l’A100 peut être plus rentable. Pour les tâches plus volumineuses, les délais serrés, ou les stacks d’entraînement qui tirent parti de la bande passante du H100 et des chemins FP8, le H100 peut l’emporter.
Quelle est la meilleure métrique pour H100 vs A100 ?
Utilisez le coût par résultat accepté : entraînement terminé, checkpoint de modèle accepté, million de tokens servis, lot réussi ou réponse conforme à la latence cible. Le prix horaire seul est incomplet.
En bref
Pour h100 vs a100, le H100 est le choix performance et l’A100 est souvent le choix valeur. Le H100 l’emporte lorsque les fonctionnalités Hopper réduisent suffisamment le temps d’exécution pour compenser la prime horaire. L’A100 l’emporte lorsque la charge de travail est stable, que l’utilisation n’est pas optimale, que l’écart de prix est important ou que la latence n’est pas la contrainte.
Avant de réserver l’un ou l’autre GPU, testez votre propre modèle, rejouez votre propre trafic et calculez le coût par tâche terminée. C’est la seule comparaison H100 vs A100 qui résiste à l’examen des achats.


