
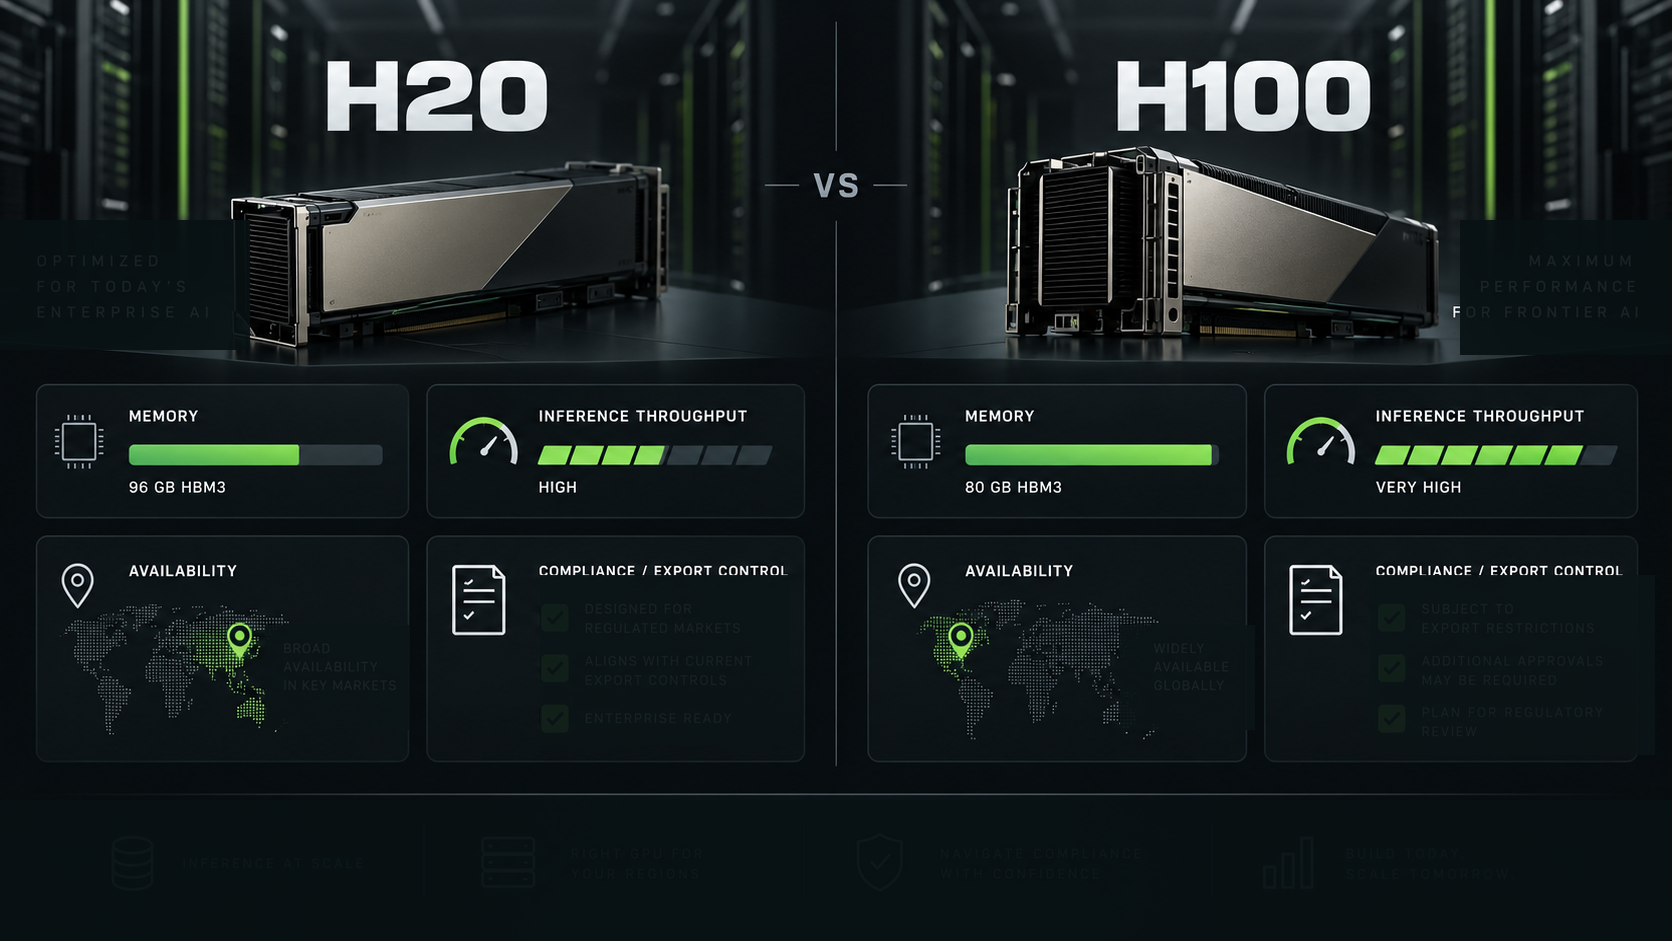
Wenn Sie H20 vs H100 vergleichen, lautet die Kurzversion: H100 ist die stärkere Standardwahl, wenn Sie es legal beschaffen, zuverlässig beziehen und gut auslasten können. H20 wird erst dann attraktiv, wenn Exportkontrollbeschränkungen, Verfügbarkeit auf dem China-Markt oder lokale Beschaffungsregeln H100 unpraktikabel machen.
Damit ist NVIDIA H20 vs H100 weniger ein normaler Vergleich von Spezifikationstabellen als vielmehr eine compliance-bewusste Kapazitätsentscheidung. H100 ist die bekanntere Hopper-GPU für Training und Inferenz. H20 ist ein eingeschränkter Weg innerhalb der Hopper-Familie, den Käufer bewerten, wenn der Beschaffungskontext von Exportgenehmigungen, PRC-Marktregeln und herstellerspezifischer SKU-Verfügbarkeit geprägt ist.
Für Enterprise-AI-Teams lautet die sinnvolle Frage h20 vs h100 nicht „welche GPU ist schneller?“. Sie lautet: welcher Weg kann akzeptierte Inferenz-Ergebnisse mit dem geringsten Gesamtrisiko liefern, wenn Speicherausstattung, Warteschlangenzeit, Compliance-Freigabe und Verfügbarkeit berücksichtigt werden?
H20 vs H100: Kurze Antwort
Wählen Sie H100, wenn:
- Sie H100-Kapazität in der Einsatzregion ohne Exportkontrollblockaden beschaffen oder mieten können.
- Ihre Workload eine ausgereifte Hopper-Basis für Training, Fine-Tuning oder Inferenz mit hohem Durchsatz benötigt.
- Sie eine starke Software-Reife, breite Cloud-Unterstützung und verlässliche Benchmark-Referenzen brauchen.
- Ihr Modell keinen China-spezifischen GPU-Beschaffungsweg erfordert.
Wählen Sie H20 nur, wenn:
- Der Einsatz in einen eingeschränkten Markt oder an einen Kundenstandort passen muss, an dem H100 nicht verfügbar oder schwer zu lizenzieren ist.
- Der Anbieter die genaue H20-SKU, Speichergröße, Interconnect, Treiber-Image und kommerzielle Konditionen nachweisen kann.
- Compliance-, Kundenstandort-, Wiederverkaufs- und Endverwendungsprüfungen bereits Teil des Beschaffungsprozesses sind.
- Sie eine reale Inferenz-Workload benchmarken und sich nicht auf Peak-Spezifikationstabellen von Drittanbietern verlassen.
Für die meisten Teams wird H20 vs H100 durch Verfügbarkeit und Compliance entschieden, noch bevor die rohe Inferenzleistung ins Spiel kommt. Wenn beide unter akzeptablen rechtlichen und kommerziellen Bedingungen verfügbar sind, ist H100 die sicherere Standardwahl.
NVIDIA H20 vs H100: Spezifikationen, die wichtig sind
Der schwierige Teil eines Vergleichs von NVIDIA H20 vs H100 specs ist, dass H100 eine öffentliche Produktseite hat, während die öffentlichen Daten zu H20 stärker fragmentiert sind. Auf der öffentlichen H100-Seite führt NVIDIA die H100 Tensor Core GPU als Hopper-Rechenzentrums-GPU mit HBM-Speicheroptionen und veröffentlichten Peak-AI-/HPC-Werten auf. In der Dokumentation von NVIDIA AI Enterprise werden H20-Varianten öffentlich in der Hopper-vGPU-Support-Matrix aufgeführt, einschließlich H20-SXM5-Profilen mit 96GB- und 141GB-Framebuffer-Einträgen.
Betrachten Sie diese Tabelle als Beschaffungs-Checkliste, nicht als endgültiges Angebotsblatt.
| Bereich der Spezifikation | H100 | H20 |
|---|---|---|
| Öffentliche Positionierung | Hauptstrom-Hopper-Rechenzentrums-GPU für KI, HPC, Training und Inferenz | Hopper-Familien-Rechenzentrums-GPU-Weg, der in eingeschränkten Beschaffungskontexten bewertet wird |
| Öffentliche NVIDIA-Produktseite | Ja, H100 hat eine eigene Produktseite | Keine gleichwertige breite öffentliche H20-Produktseite, die für endgültige Käuferspezifikationen verwendet wird |
| Öffentliches Speicher-Signal | H100 SXM wird häufig mit etwa 80GB HBM3 bewertet; H100 NVL erscheint in LLM-Serving-Kontexten mit größerem Speicher | Die vGPU-Dokumente von NVIDIA AI Enterprise listen H20-SXM5-Profile mit 96GB und 141GB Framebuffer auf |
| Inferenz-Fazit | Stärkere Standardwahl für Rohleistung, Ökosystemunterstützung, Training und allgemeine Inferenz | Nur mit exakten SKU-Benchmarks bewerten; Speicherkapazität kann attraktiv sein, aber Compliance und Verfügbarkeit dominieren |
| Beschaffungsrisiko | Verfügbarkeit und Cloud-Preis variieren, aber das Produkt wird breit unterstützt | Exportlizenzierung, PRC-Marktregeln und anbieterspezifische Lieferfähigkeit können bestimmen, ob ein Angebot nutzbar ist |
Die richtige Art, nvidia h20 vs h100 specs zu lesen, besteht darin, drei Ebenen zu trennen:
- Bestätigte öffentliche NVIDIA-Fakten, wie die H100-Produktdokumentation und die H20-Support-Einträge von NVIDIA AI Enterprise.
- Anbieter-Angebotsfakten, wie exakter H20-Speicher, Interconnect, Treiber, Node-Formfaktor, Region und Garantie.
- Ihre Workload-Fakten, wie Tokens pro Sekunde, Zeit bis zum ersten Token, Warteschlangenverzögerung, Fehlerrate und Kosten pro akzeptierter Ausgabe.
Fassen Sie diese Ebenen nicht zu einem einzigen synthetischen „Gewinner“-Score zusammen.
NVIDIA H20 vs H100 Leistung: Was sich bei der Inferenz ändert
Für nvidia h20 vs h100 performance sollten Sie die Inferenz in zwei Phasen benchmarken: Prefill und Decode.
Prefill reagiert empfindlich auf Prompt-Länge, Batch-Strategie, Attention-Implementierung und Speicherbandbreite. Decode reagiert empfindlich auf Parallelität, KV-Cache-Druck, Scheduler-Verhalten und die Effizienz des Serving-Stacks. Ein Beschaffungsteam, das nur nach Peak-Tensor-Core-Zahlen fragt, übersieht die eigentlichen Kostentreiber.
Verwenden Sie H100 als Baseline, wenn:
- Sie Modelle von 7B bis 70B mit ausgereiftem vLLM, TensorRT-LLM, SGLang oder verwalteten Kubernetes-Images bereitstellen.
- Sie einen sauberen Vergleich mit bestehender H100-, H200- oder B200-Cloud-Kapazität benötigen.
- Sie Benchmark-Arbeiten aus breiteren H100-Flotten wiederverwenden möchten.
- Training oder Fine-Tuning weiterhin Teil des Workload-Mixes bleibt.
Verwenden Sie H20 erst nach einem Live-Test, wenn:
- H100 für die Zielumgebung nicht gekauft, importiert, bereitgestellt oder genehmigt werden kann.
- Der H20-Node genug Speicher für das Modell und die Kontextlänge hat, ohne erzwungene Qualitätseinbußen.
- Der Anbieter stabile Treiber, Container-Images und Unterstützung für Ihr Serving-Framework nachweisen kann.
- Die Compliance-Prüfung Endnutzer, Endverwendung, Region und Transferpfad akzeptiert.
In der Praxis ist H20 vs H100 selten ein fairer Labor-Benchmark. Meist ist es „H100 in einer uneingeschränkten Region“ versus „H20 oder eine andere lokale Option in einer eingeschränkten Beschaffungsumgebung“. Deshalb muss der Benchmark neben Tokens pro Sekunde auch die rechtliche Verfügbarkeit und die Wartezeit in der Warteschlange einbeziehen.
Speicher: wenn H20 interessant wirken kann
Beim Speicher ist H20 der Bereich, der sorgfältig geprüft werden sollte. Die NVIDIA AI Enterprise-Dokumentation führt H20 SXM5 vGPU-Profile mit 96GB- und 141GB-Framebuffer-Einträgen auf. Diese öffentlichen Einträge sind nützlich, weil sie zeigen, dass man bei H20-Gesprächen nicht von einer einzigen festen Speichergröße ausgehen sollte.
Für LLM-Inferenz beeinflusst der Speicher:
- Ob das Modell ohne aggressives Quantisieren passt.
- Wie viel KV-Cache pro Replikat vorgehalten werden kann.
- Ob längerer Kontext oder höhere Parallelität praktikabel ist.
- Ob für einen Workload Tensor-Parallelismus über mehrere GPUs hinweg nötig ist.
- Wie oft produktive Prompts Out-of-Memory-Wiederholungen auslösen.
Das bedeutet, dass eine H20-Konfiguration mit größerem Speicherbetrieblich manchmal interessant sein kann, selbst wenn H100 der stärkere Allzweckbeschleuniger ist. Aber ein größerer Speicherwert macht H20 nicht automatisch schneller oder günstiger. Der Knoten muss trotzdem Inferenz-Benchmarks, Verfügbarkeitsprüfungen, Compliance-Prüfungen und TCO-Modellierung bestehen.
Wenn der Workload speichergebunden ist und H100 verfügbar ist, vergleichen Sie H100 auch mit H200. Die breitere H200 vs H100-Entscheidung ist oft ein saubererer Speicher-Upgrade-Pfad, als sich auf einen H20-Beschaffungsweg zu verlassen, der auf Exportbeschränkungen basiert.
Verfügbarkeit und Compliance sind Anforderungen erster Ordnung
Für NVIDIA H20 vs H100 ist Compliance keine Fußnote. Die jüngste öffentliche SEC-Einreichung von NVIDIA beschreibt eine Reihe von Exportkontrollbeschränkungen, die A100-, H100-, H20-, H200-, B200-, GB200-Klasse-Produkte und verwandte Systeme betreffen. Dort wird ausgeführt, dass H100-Produkte von früheren China-bezogenen Beschränkungen betroffen waren, dass H20-Exporte nach China und in D:5-Länder ab April 2025 einer Genehmigungspflicht unterlagen und dass spätere Lizenzen nicht zu uneingeschränkten H20-Verkäufen führten, da auch Beschränkungen auf Seiten der VR China den Verkauf beeinflussten.
Für Käufer ergeben sich daraus drei praktische Regeln:
- Behandeln Sie die Verfügbarkeit von H20 nicht als normale Lagerfrage.
- Nehmen Sie nicht an, dass eine Lizenz, ein Angebot oder ein Marketplace-Eintrag für Ihren Endkunden ausreicht.
- Modellieren Sie H20-Kapazität nicht ohne Ausweichroute.
Stellen Sie Anbietern vor der Annahme eines H20-Angebots diese Fragen:
- Welches genaue H20-SKU wird angeboten?
- Welches Land, welche Region, welches Rechenzentrum und welche juristische Person werden die GPUs hosten?
- Unterliegen Käufer, Endnutzer, Workload, Muttergesellschaft oder Kundenstandort einer Exportkontrollprüfung?
- Sind Wiederverkauf, Übertragung, Fernzugriff oder Cloud-Service-Beschränkungen relevant?
- Ist die GPU jetzt verfügbar, reserviert, Lizenz ausstehend, Import ausstehend oder von einer zukünftigen Zuteilung abhängig?
- Was passiert, wenn sich vor der Bereitstellung eine Lizenz, ein Zollsatz, eine Prüfung oder eine staatliche Regel ändert?
- Kann derselbe Workload auf H100, H200, L40S, lokalen Alternativen oder einer Modell-API laufen, wenn H20 verzögert ist?
Diese Checkliste ist wichtiger als ein weiterer synthetischer nvidia h20 vs h100 performance comparison.
H20 vs H100 vs H200
Viele Teams suchen nach h20 vs h100 vs h200, weil die eigentliche Entscheidung nicht binär ist. Verwenden Sie diese einfachere Einordnung:
| GPU-Pfad | Beste Standardnutzung | Wichtigste Käuferfrage |
|---|---|---|
| H100 | Reife Hopper-Basis für Training, Fine-Tuning und Inferenz | Können wir genug Kapazität zu einem Preis und in einer Region beziehen, die wir nutzen können? |
| H200 | Speicherintensive Inferenz, längerer Kontext, größere Batches, speichergebundenes HPC | Reduziert der größere HBM3e-Speicher die GPU-Anzahl, das Sharding oder Wiederholungen genug, um den Aufpreis zu rechtfertigen? |
| H20 | Eingeschränkte Beschaffungskontexte, in denen H100/H200 nicht ohne Weiteres verfügbar sind | Kann dieses konkrete H20-Deployment Compliance, Verfügbarkeit und Workload-Benchmarks bestehen? |
Wenn das Team nur Modellausgaben benötigt, fügen Sie einen vierten Pfad hinzu: eine verwaltete Modell-API. Hardware-Eigentum ist gerechtfertigt, wenn Sie private Gewichte, benutzerdefinierte Kernel, feste dedizierte Kapazität oder niedrige Serving-Kontrolle benötigen. Wenn nicht, kann eine Modell-API-Basislinie die GPU-Miete nach Einbeziehung von Leerlaufzeit, Warteschlangenverwaltung, Treiberaufwand und fehlgeschlagenen Jobs übertreffen.
Flatkey ist für diese Basislinie nützlich: ein Schlüssel, ein Guthaben, OpenAI-kompatibles Routing, Nutzungstransparenz und Zugriff auf viele offizielle Modell-APIs, ohne GPU-Server zu betreiben. Es ersetzt H20 oder H100 nicht für Teams, die die Hardware-Schicht besitzen müssen, gibt der Beschaffung aber einen realistischen Vergleich „brauchen wir überhaupt GPUs?“.
Verwandte Planungsleitfäden:
- GPU-Mietpreise erklärt
- Versteckte Kosten von GPU-Clouds
- TCO eines GPU-Clusters
- GPU-Cloud vs. Modell-API
- Beste GPU für LLM-Inferenz
- GPU-Cloud-Vergleich 2026
Benchmark-Checkliste für H20 vs H100 Inferenz
Führen Sie denselben Workload auf exakt der Deployment-Form aus, die Sie kaufen möchten. Für h20 vs h100-Inferenz verwenden Sie produktionsnahe Prompts und messen Sie die akzeptierte Ausgabe.
| Metrik | Warum sie wichtig ist |
|---|---|
| Zeit bis zum ersten Token | Erfasst benutzerseitig sichtbare Latenz und Prefill-Verhalten |
| Inter-Token-Latenz | Zeigt die Decode-Geschwindigkeit unter realer Parallelität |
| Tokens pro Sekunde pro GPU | Nützlich, aber unvollständig ohne Auslastung und Akzeptanzrate |
| Maximale stabile Parallelität | Zeigt den Druck auf KV-Cache und Scheduler |
| Zugewiesener und reservierter Speicher | Zeigt, ob das Modell mit Produktions-Prompts tatsächlich hineinpasst |
| Warteschlangenverzögerung | Verwandelt knappe Kapazität in echte Nutzerlatenz |
| OOM- und Retry-Rate | Übersetzt Speichergrenzen in Kosten- und Zuverlässigkeitsauswirkungen |
| Kosten pro akzeptierter Ausgabe | Normalisiert GPU-Stunden, Auslastung, Fehler und Engineering-Zeit |
| Zeit bis zur Compliance-Freigabe | Kritisch für H20 und jede Bereitstellung in eingeschränkten Regionen |
| Fallback-Pfad | Schützt Starttermine, wenn sich Versorgung oder Lizenzierung ändern |
Die wichtige Beschaffungsmetrik ist nicht "H20 vs H100 Spitzenleistung." Entscheidend sind die Kosten der abgeschlossenen Workloads nach Einbeziehung von Verfügbarkeit, fehlgeschlagenen Versuchen, Warteschlangenbildung, Compliance-Prüfung und Betrieb.
Beschaffungsentscheidungsmatrix
Verwenden Sie diese Matrix im Einkaufsgespräch.
| Wenn das zutrifft | Bevorzugen | Warum |
|---|---|---|
| H100 ist legal verfügbar, Kapazität ist real und der Preis ist akzeptabel | H100 | Es ist die sauberere Hopper-Basis mit breiter Unterstützung |
| Die Workload ist speichergebunden und H200 ist verfügbar | H200 gegen H100 testen | Das Speicher-Upgrade kann direkter sein als der Einsatz von H20 |
| Die Bereitstellung muss einen eingeschränkten Markt bedienen, in dem H100/H200 blockiert sind | H20 plus Fallback testen | Der Compliance-Pfad kann die Hardwarewahl bestimmen |
| Das Modell ist klein oder mittelgroß und der Traffic ist spiky | Model API oder serverless GPU | Idle dedizierte GPU-Kapazität vermeiden |
| Das Team braucht Custom-Kernels, private Gewichte und dauerhafte Auslastung | Direkte GPU-Kapazität | Hardware-Kontrolle kann den operativen Aufwand rechtfertigen |
| Versorgung, Lizenzierung oder geopolitische Regeln können sich vor dem Launch ändern | Zwei Pfade offen halten | Keinen Produktfahrplan an eine einzelne eingeschränkte SKU binden |
Häufige Fehler bei der Planung von NVIDIA H20 vs H100
Der erste Fehler besteht darin, H20 als "einfach nur einen langsameren H100" zu behandeln. Der eigentliche Unterschied liegt im Beschaffungskontext. Wenn Ihre rechtlichen, Compliance- und Verfügbarkeitsrestriktionen H20 nicht erfordern, ist die H100-Basis in der Regel einfacher.
Der zweite Fehler besteht darin, öffentliche nvidia h20 vs h100 specs zu kopieren, ohne die exakte SKU zu prüfen. H20-Referenzen können je nach Speichergröße und Bereitstellungsform variieren. Ihr Angebot sollte GPU, Speicher, Interconnect, Node-Design, Treiber-Image, Servicebedingungen und Region angeben.
Der dritte Fehler besteht darin, H200 zu ignorieren. Wenn das Problem H100-Speicherdruck ist, kann H200 der natürlichere Vergleich sein. Verwenden Sie H20, wenn der Beschaffungskontext den Weg erzwingt, nicht nur weil eine Speichergzahl attraktiv aussieht.
Der vierte Fehler besteht darin, die Model-API-Basis zu vergessen. Wenn die Workload nur zuverlässige Modellausgaben benötigt, nicht direkte GPU-Kontrolle, kann der einfachere Weg eine API mit Nutzungsverfolgung, Fallback und Pay-per-Call-Ökonomie sein.
Endempfehlung
Für H20 vs H100 wählen Sie H100, wenn es für Ihre Bereitstellung verfügbar und konform ist. Es bleibt die sicherere Hopper-Basis für die meisten Trainings-, Fine-Tuning- und Inferenzaufgaben.
Wählen Sie H20 nur, wenn die Beschaffungsumgebung es erforderlich macht und die konkrete H20-Bereitstellung drei Tests besteht: Das Modell passt hinein, der Inferenz-Benchmark funktioniert unter produktionsnaher Last und die Compliance kann Endnutzer, Region und Transferpfad freigeben.
Vergleichen Sie dann beide mit H200 und einer Model-API-Basis. Der gewinnende Pfad ist derjenige, der zuverlässig akzeptierte Ausgaben produziert, nicht der mit der interessantesten Spezifikationstabelle.
FAQ
Ist H20 besser als H100 für Inferenz?
Meistens nein. H100 ist die stärkere Standardwahl, wenn es verfügbar und konform ist. H20 kann relevant sein, wenn H100 durch Beschaffung, Exportkontrolle oder regionale Verfügbarkeitsbeschränkungen blockiert ist. Benchmarken Sie die exakte H20-SKU, bevor Sie annehmen, dass sie ein guter Inferenz-Ersatz ist.
Was ist der Hauptunterschied zwischen NVIDIA H20 und H100?
Der Hauptunterschied ist der Beschaffungskontext. H100 ist eine breit unterstützte Hopper-Rechenzentrums-GPU. H20 wird in eingeschränkten Beschaffungskontexten bewertet, in denen Exportlizenzen, PRC-Marktregeln, die genaue SKU-Verfügbarkeit und die Compliance-Prüfung bestimmen können, ob die Kapazität nutzbar ist.
Wie sollte ich NVIDIA H20 vs H100 specs vergleichen?
Vergleichen Sie exakte SKU, Speicher, Interconnect, Node-Form, Treiber-Image, Region, Garantie und Compliance-Status. Verlassen Sie sich nicht nur auf Spezifikationstabellen von Drittanbietern. Validieren Sie für die Produktion mit echten Prompts, Ziel-Parallelität und Kosten pro akzeptierter Ausgabe.
Sollte ich H20 vs H100 vs H200 vergleichen?
Ja. Wenn die Workload speichergebunden ist und H200 verfügbar ist, kann H200 ein saubereres Upgrade gegenüber H100 sein. H20 ist relevanter, wenn Compliance oder regionale Beschaffung H100/H200 blockieren.
Wann sollte ich eine Model API statt H20 oder H100 verwenden?
Verwenden Sie eine Model API, wenn Sie keine Custom-Kernels, privaten Gewichte oder feste dedizierte Kapazität benötigen. Für spiky Produkt-Traffic kann eine Model API GPU-Leerlaufkosten und Betriebsaufwand senken und gleichzeitig Nutzungstransparenz und Routing-Flexibilität erhalten.


