
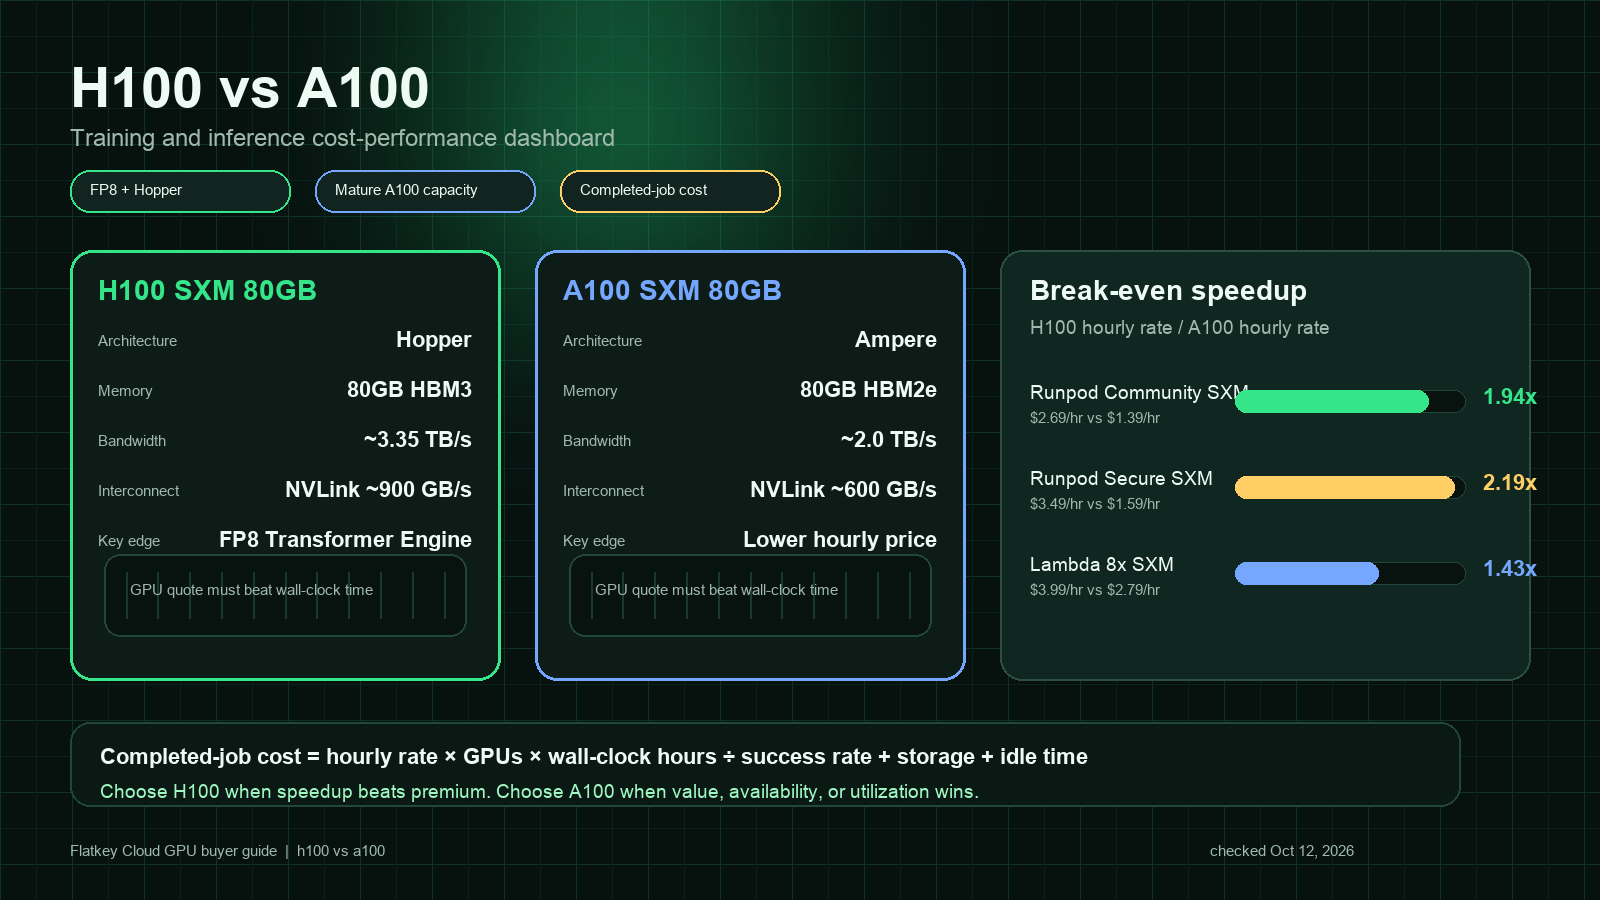
Краткий ответ для H100 vs A100 прост: выбирайте H100, когда рабочая нагрузка может использовать возможности Hopper, такие как Transformer Engine с FP8, более высокая пропускная способность памяти, более быстрый NVLink четвёртого поколения и новые ядра инференса. Выбирайте A100, когда задача стабильна по потреблению памяти, пропускной способности FP16/BF16 уже достаточно, доступность важнее пиковой скорости или почасовая цена A100 значительно ниже.
Именно поэтому правильный вопрос не «Какая GPU быстрее?». H100 — более новый и быстрый ускоритель. Вопрос для покупателя такой: завершит ли H100 вашу задачу обучения или инференса достаточно быстрее, чтобы оправдать ценовую надбавку по сравнению с A100?
Это руководство сравнивает NVIDIA H100 и A100 для обучения ИИ, инференса LLM, fine-tuning, пакетных задач и закупки облачных GPU. Цены меняются каждую неделю, поэтому воспринимайте приведённые ниже публичные строки цен как примеры котировок, проверенные 12 октября 2026 года, а затем повторите тот же расчёт для вашего шорт-листа провайдеров.
Производительность H100 vs A100: краткая таблица принятия решения
| Нагрузка | Обычно выбирают | Почему |
|---|---|---|
| Обучение frontier-LLM или крупное распределённое pretraining | H100 SXM | Transformer Engine с FP8, более высокая пропускная способность памяти, более быстрый NVLink и больший запас для масштабирования на несколько GPU. |
| Fine-tuning моделей от 7B до 70B | Зависит | H100 выигрывает, когда важна скорость обучения; A100 выигрывает, когда запуск не ограничен пропускной способностью или бюджет фиксирован. |
| LLM-инференс с низкой задержкой | H100 | Лучший путь инференса трансформеров, более высокая пропускная способность и более новая оптимизация стека обслуживания. |
| Пакетный инференс с менее жёстким SLA | A100 | Более низкая почасовая цена может выиграть, если загрузка высокая и ожидание в очереди приемлемо. |
| Многопользовательские ноутбуки, демо и небольшие задачи | A100 | Зрелая доступность, более низкая стоимость и поддержка MIG делают A100 практичным вариантом по умолчанию. |
| Память-ограниченные нагрузки, помещающиеся в 80 GB | Проверить оба | У H100 значительно выше пропускная способность, но A100 80 GB всё ещё может оказаться дешевле по стоимости завершённой задачи. |
| Наследуемые CUDA-нагрузки, уже оптимизированные под Ampere | Сначала A100 | Ниже риск миграции, если только бенчмаркинг H100 не докажет существенный выигрыш. |
Для большинства команд, сравнивающих h100 vs a100 performance, начните с двухстрочного правила:
- Если задача дорогая потому, что выполняется слишком долго, сначала протестируйте H100.
- Если задача дорогая потому, что GPU простаивает, не выполняется или ждёт данные, сначала повысьте утилизацию, прежде чем платить за H100.
Ключевые различия в характеристиках
Самое важное отличие NVIDIA A100 vs H100 — архитектурное поколение. A100 основан на NVIDIA Ampere. H100 основан на NVIDIA Hopper и добавляет Transformer Engine, ускорение FP8 tensor, более новый NVLink и более высокие лимиты мощности SXM. NVIDIA позиционирует H100 для крупных AI-, HPC- и триллион-параметровых нагрузок, тогда как A100 остаётся широко используемым дата-центровым ускорителем для обучения, инференса, аналитики и HPC. Источники: страница продукта NVIDIA H100, страница продукта NVIDIA A100 и карта линейки дата-центровых GPU NVIDIA.
| Область | NVIDIA H100 SXM 80 GB | NVIDIA A100 SXM 80 GB | Значение для покупателя |
|---|---|---|---|
| Архитектура | Hopper | Ampere | H100 — более новое поколение, оптимизированное для ИИ. |
| Память | 80 GB HBM3 | 80 GB HBM2e | Одинаковая заявленная ёмкость у распространённых 80 GB-моделей, но у H100 память быстрее. |
| Пропускная способность памяти | До примерно 3,35 TB/s | До примерно 2,0 TB/s | У H100 больше запас для обучающих и inference-нагрузок, ограниченных памятью. |
| Точность tensor | FP8, FP16, BF16, TF32, FP64 tensor paths | FP16, BF16, TF32, FP64 tensor paths | FP8 может заметно повысить пропускную способность трансформеров, если точность сохраняется. |
| Поколение NVLink | NVLink четвёртого поколения, до 900 GB/s пропускной способности GPU-to-GPU на SXM | NVLink третьего поколения, до 600 GB/s пропускной способности GPU-to-GPU на SXM | H100 сильнее подходит для multi-GPU обучения и крупномасштабного model parallelism. |
| MIG | Поддерживается | Поддерживается | Обе GPU можно делить на части для многопользовательской утилизации. |
| Типичный энергетический бюджет SXM | Выше | Ниже | H100 может требовать больше питания и охлаждения, но завершать работу быстрее. |
Эти числа объясняют, почему сравнение h100 gpu vs a100 меняется в зависимости от нагрузки. Модель, которая может использовать FP8 и новые ядра, может значительно опередить H100. Небольшая задача, ограниченная препроцессингом на CPU, хранилищем или сетью, может показать гораздо меньший выигрыш.
Формула соотношения цены и производительности
Используйте стоимость завершённой задачи вместо почасовой цены:
completed_job_cost =
  GPU_hourly_rate
  x number_of_GPUs
  x wall_clock_hours
  / success_rate
  + storage
  + network
  + idle_time
  + orchestration_overhead
Затем сравните:
H100 must be at least this much faster to break even =
  H100_hourly_rate / A100_hourly_rate
Если H100 стоит в 1,8 раза дороже, чем A100, то для выигрыша по чистой стоимости аренды GPU он должен завершать ту же принятую задачу более чем в 1,8 раза быстрее. Если он стоит в 1,4 раза дороже, порог окупаемости ниже. Именно поэтому при выборе облачных GPU всегда нужно использовать точную SKU и котировку: H100 SXM, H100 PCIe, H100 NVL, A100 SXM 80 GB и A100 PCIe 40 GB не взаимозаменяемы.
Для более широкой таблицы скрытых затрат см. руководство Flatkey по ценам аренды GPU.
Примеры цен на GPU в публичном облаке, проверенные 12 октября 2026 года
Таблица ниже — не универсальный ценовой индекс. Это снимок публичных примеров, показывающий, насколько широким может быть разброс.
| Страница провайдера | Пример для H100 | Пример для A100 | Что это показывает |
|---|---|---|---|
| Цены Runpod | H100 SXM: Community Cloud $2.69/час, Secure Cloud $3.49/час; H100 PCIe: Community Cloud $1.99/час, Secure Cloud $2.89/час | A100 SXM: Community Cloud $1.39/час, Secure Cloud $1.59/час; A100 PCIe: Community Cloud $1.19/час, Secure Cloud $1.59/час | Маркетплейс и защищённые среды могут иметь разные точки безубыточности. |
| Цены Lambda | Строка кластера 8x H100 SXM: $3.99/GPU/час; строка одиночного H100 SXM: $4.29/GPU/час; строка одиночного H100 PCIe: $3.29/GPU/час | Строка 8x A100 SXM 80 GB: $2.79/GPU/час; строка одиночного A100 SXM 40 GB: $1.99/GPU/час | Размер кластера, объём памяти и конфигурация узла важны не меньше, чем название GPU. |
| Цены Massed Compute | На странице указаны почасовые ставки GPU и конфигурации по модели on-demand | На странице указаны почасовые ставки GPU и конфигурации по модели on-demand | Перед сравнением всегда проверяйте количество, память, хранилище и детали инстанса. |
Из этих примеров покупатель, сравнивающий производительность a100 vs h100, не должен исходить из одной фиксированной надбавки. В одном случае H100 PCIe может быть достаточно близок по цене к A100, чтобы H100 было легко обосновать. В другом A100 может быть настолько дешёвым, что более медленный запуск всё равно окажется выгоднее.
Сравнение для обучения
Для обучения H100 обычно становится первым GPU, который стоит протестировать, когда:
- Вы обучаете трансформерные модели и можете безопасно использовать смешанную точность FP8.
- Задача достаточно большая, чтобы скорость ядер и скорость интерконнекта доминировали над накладными расходами на запуск.
- Вы используете многонодовый или многогранный model parallelism.
- У вас жёсткий дедлайн, и более короткое время выполнения важнее почасовой надбавки.
- Ваша команда может поддерживать высокую загрузку GPU благодаря подготовленным данным, стабильным checkpoint'ам и автоматическим повторам.
A100 всё ещё может быть лучшей покупкой для обучения, когда:
- Модель помещается в 80 GB без проблем и почти не выигрывает от FP8.
- Вы занимаетесь fine-tuning, а не pretraining.
- Вы запускаете много экспериментов, где глубина очереди важнее, чем самый быстрый одиночный прогон.
- Ваш код, драйверы, стек CUDA и мониторинг уже стабильно работают на A100.
- Вы покупаете зарезервированную мощность, а скидка на A100 очень велика.
Важная привычка при закупках — сравнивать стоимость одного принятого обучающего прогона, а не только токены в секунду. Быстрый прогон на H100, который поздно завершается с ошибкой из-за checkpoint, данных или нестабильности распределённого обучения, может оказаться дороже, чем более медленный, но надёжно завершившийся прогон на A100.
Сравнение для инференса
Для инференса H100 часто выигрывает, когда путь обслуживания оптимизирован под современные ядра LLM:
- Запросы с длинным контекстом создают нагрузку на пропускную способность памяти и перемещение KV-cache.
- Обслуживание с высокой конкуррентностью выигрывает от новой оптимизации ядер.
- Требования к latency SLO настолько жёсткие, что более низкая задержка p95 или p99 имеет бизнес-ценность.
- Модель использует FP8 или пути квантования, которые проверены вашим стеком обслуживания.
- Вы можете объединять достаточно запросов в batch, чтобы GPU был загружен.
A100 часто выигрывает, когда:
- Пакетные задания могут выполняться ночью.
- Объём запросов скачкообразный и оставил бы дорогие H100 бездействующими.
- Модель достаточно мала, чтобы более дешёвый класс GPU был реальным победителем.
- Вы обслуживаете стабильные внутренние инструменты, а не трафик, критичный для выручки.
- Вы можете направлять избыточную нагрузку в управляемый API модели вместо того, чтобы держать простаивающие выделенные ресурсы.
Для обслуживания LLM производительность h100 vs a100 также зависит от программного слоя: vLLM, TensorRT-LLM, SGLang, NVIDIA NIM, формата квантования, политики batching, настроек KV-cache и распределения длины промптов. Не покупайте H100, опираясь только на общий бенчмарк. Повторите свой собственный набор промптов.
Практический план бенчмаркинга
Запустите один и тот же бенчмарк на каждой кандидатной SKU. Зафиксируйте критерии приёмки.
| Шаг | Что измерять | Почему это важно |
|---|---|---|
| 1. Зафиксировать нагрузку | Модель, длина последовательности, размер batch, точность, датасет, политика повторных попыток | Предотвращает фальшивое сравнение «яблоки с яблоками». |
| 2. Измерить пропускную способность | Токены/сек для обучения, samples/сек или токены/сек для инференса | Показывает сырую скорость. |
| 3. Измерить задержку | p50, p95, p99, time-to-first-token, скорость декодирования | Отражает видимую для пользователя производительность. |
| 4. Отслеживать утилизацию | Загрузка GPU, пропускная способность памяти, ожидание CPU, ожидание хранилища, ожидание сети | Показывает, является ли выбор GPU реальным узким местом. |
| 5. Отслеживать сбои | Перезапуски задач, OOM, ошибки ядер, прерывания spot-инстансов | Преобразует дешёвые почасовые ставки в реальную стоимость завершённых задач. |
| 6. Рассчитать принятую стоимость | Стоимость одного завершённого прогона, принятого результата или миллиона обслуженных токенов | Это число, которое закупки должны сравнивать. |
Минимальное воспроизведение для инференса:
100 коротких промптов
100 средних промптов
100 промптов с длинным контекстом
одна и та же модель
одна и та же точность
одна и та же версия сервера
одинаковый max tokens
одинаковая лестница concurrency
одинаковые проверки качества
Минимальный повтор обучения:
тот же checkpoint
тот же shard датасета
та же целевая глобальная размерность batch
те же настройки оптимизатора
та же политика точности
тот же интервал сохранения checkpoint
тот же метод восстановления после сбоя
Насколько быстрее должен быть H100?
Возьмите своё предложение и затем вычислите точку безубыточности по ускорению.
| Пример предложения | Цена H100 | Цена A100 | Премия за H100 | Интерпретация точки безубыточности |
|---|---|---|---|---|
| Runpod Community H100 SXM vs A100 SXM | $2.69/ч | $1.39/ч | 1.94x | H100 должен завершать работу более чем в 1.94 раза быстрее, прежде чем скрытые издержки позволят выиграть по аренде GPU. |
| Runpod Secure H100 SXM vs A100 SXM | $3.49/ч | $1.59/ч | 2.19x | H100 нужен большой прирост скорости или веская причина, связанная с задержкой/бизнесом. |
| Lambda 8x H100 SXM vs 8x A100 SXM 80 GB | $3.99/GPU/ч | $2.79/GPU/ч | 1.43x | H100 может выиграть при значительно меньшем ускорении. |
| Lambda single H100 PCIe vs single A100 SXM 40 GB | $3.29/ч | $1.99/ч | 1.65x | Сравнение смешивает SKU; необходимо учитывать различия в памяти и межсоединении. |
Именно здесь многие сравнения a100 vs h100 performance идут не так. Бенчмарк, который говорит «H100 в 2 раза быстрее», — этого недостаточно. Вам нужно знать, в 1.4, 1.9 или 2.2 раза ли ваше предложение по H100 дороже предложения по A100, и действительно ли задача завершается успешно на такой скорости.
Чек-лист закупки
Перед выбором H100 или A100 запросите у поставщиков:
- Точный GPU SKU: SXM, PCIe, NVL, объём памяти и политика MIG.
- Конфигурацию узла: число GPU, CPU, RAM, локальный NVMe, сеть и межсоединение.
- Сетевую фабрику для кластеров: NVLink/NVSwitch внутри узла, InfiniBand или Ethernet между узлами, политику oversubscription.
- Цена и производительность хранилища: локальный SSD, persistent volume, object storage, время snapshot и restore.
- Политику egress и пропускной способности.
- Единицу биллинга: за секунду, за минуту или за час.
- Политику прерывания для spot или marketplace capacity.
- Регион и ограничения по соответствию требованиям.
- Поддержку SLA и процесс замены.
- Условия резервации и правила отмены.
Для распределённого обучения конфигурация узла может решить исход. Восемь H100 за мощным NVSwitch и хорошей фабрикой не сопоставимы с восемью изолированными GPU, подключёнными через слабый сетевой путь.
Когда H100 оправдывает премию
H100 обычно стоит переплаты, когда верны как минимум два из следующих пунктов:
- Нагрузка сильно ориентирована на трансформеры и подтверждена для FP8 или оптимизированных под Hopper kernel.
- Время обучения блокирует релизы, поставку клиентам или итерации исследований.
- Задержка p95 или p99 в инференсе влияет на выручку или удержание пользователей.
- Задача сильно использует межGPU-взаимодействие.
- Провайдер предлагает умеренную премию за H100 по сравнению с A100.
- Ваша команда может поддерживать высокую загрузку.
H100 сложнее обосновать, когда:
- GPU простаивает значительную часть часа.
- Узким местом является загрузка данных, CPU preprocessing или сетевой I/O.
- Ваш serving stack не настроен.
- Модель достаточно мала для L40S, RTX PRO или управляемого API.
- Мощность A100 сильно дисконтирована.
Когда A100 всё ещё остаётся прагматичным выбором
A100 остаётся практичным вариантом по умолчанию для многих AI-команд, потому что это зрелое решение, широко доступное и всё ещё сильное для обучения и инференса. Оно особенно полезно, когда вам нужна предсказуемая мощность для:
- задач fine-tuning.
- генерации embeddings.
- batch inference.
- внутренних AI-инструментов.
- research notebooks.
- мультиарендных сред с MIG.
- устаревших CUDA-нагрузок, уже проверенных на Ampere.
Если запуск на A100 стоит вдвое дешевле и завершается лишь на 20% медленнее, выигрывает A100. Если он стоит на 30% дешевле, но занимает в 2 раза больше времени, вероятно, выигрывает H100. Математика снова меняется, если мощность A100 проще зарезервировать или если время ожидания H100 задерживает проект.
Где здесь подходит Flatkey
Аренда GPU — не всегда самый дешёвый способ запускать AI. Для некоторых нагрузок managed model API дешевле, потому что вы платите за успешный запрос, а не держите GPU. Для других нагрузок выделенная GPU-мощность лучше, потому что у вас стабильный объём, кастомные модели, строгие требования к задержке или требования к контролю данных.
Flatkey помогает командам сравнивать эти пути со стороны приложения: один API key, один баланс, один журнал учёта использования и маршрутизация моделей через официальные model endpoints. Используйте аренду GPU, когда нагрузке нужна выделенная мощность. Используйте маршрут через model API, когда нагрузка приходит всплесками, проще в эксплуатации или дешевле на принятую задачу.
FAQ по H100 vs A100
H100 быстрее A100?
Да. H100 — это более новый GPU поколения Hopper и имеет серьёзные преимущества в нагрузках, ориентированных на трансформеры, пропускной способности памяти, поддержке FP8 и более новом interconnect. Реальный вопрос в том, достаточно ли он быстрее, чтобы компенсировать премию за H100 в вашей задаче.
A100 всё ещё хорош для инференса LLM?
Да. A100 всё ещё является способной GPU для инференса, особенно для batch serving, внутренних инструментов, embeddings и нагрузок, где требования к задержке умеренные. H100 сильнее для высокопропускного и чувствительного к задержке transformer serving, когда software stack настроен.
Стоит ли сравнивать H100 SXM с A100 PCIe?
Только если это реальные цены, по которым вы можете купить. Для технического сравнения по возможности сопоставляйте форм-фактор и объем памяти: H100 SXM vs A100 SXM, H100 PCIe vs A100 PCIe, 80 GB vs 80 GB там, где это доступно.
Делает ли FP8 H100 автоматически лучше?
Нет. FP8 помогает только тогда, когда модель и программный стек могут использовать его без недопустимой потери качества. Прежде чем рассчитывать на экономию за счет FP8, проверьте качество вывода, сходимость и стабильность.
Что лучше для дообучения?
Для небольших и средних задач дообучения A100 может быть более выгодным по стоимости. Для более крупных задач, жестких сроков или стеков обучения, которым полезны пропускная способность и FP8-пути H100, может выиграть H100.
Какой показатель лучше всего использовать для сравнения H100 vs A100?
Используйте стоимость за принятый результат: завершенный запуск обучения, принятый контрольный чекпойнт модели, миллион обслуженных токенов, успешно выполненный batch или ответ с подходящей задержкой. Только почасовая цена не дает полной картины.
Итог
Для h100 vs a100 H100 — это выбор в пользу производительности, а A100 часто — выбор в пользу цены и ценности. H100 выигрывает, когда возможности Hopper сокращают общее время выполнения настолько, что компенсируют более высокую почасовую ставку. A100 выигрывает, когда нагрузка стабильна, утилизация неидеальна, разрыв в цене велик или задержка не является ограничением.
Прежде чем резервировать любой из GPU, проведите бенчмарк на своей модели, прогоните свой трафик и рассчитайте стоимость завершенной задачи. Это единственное сравнение H100 vs A100, которое выдержит проверку закупками.


