
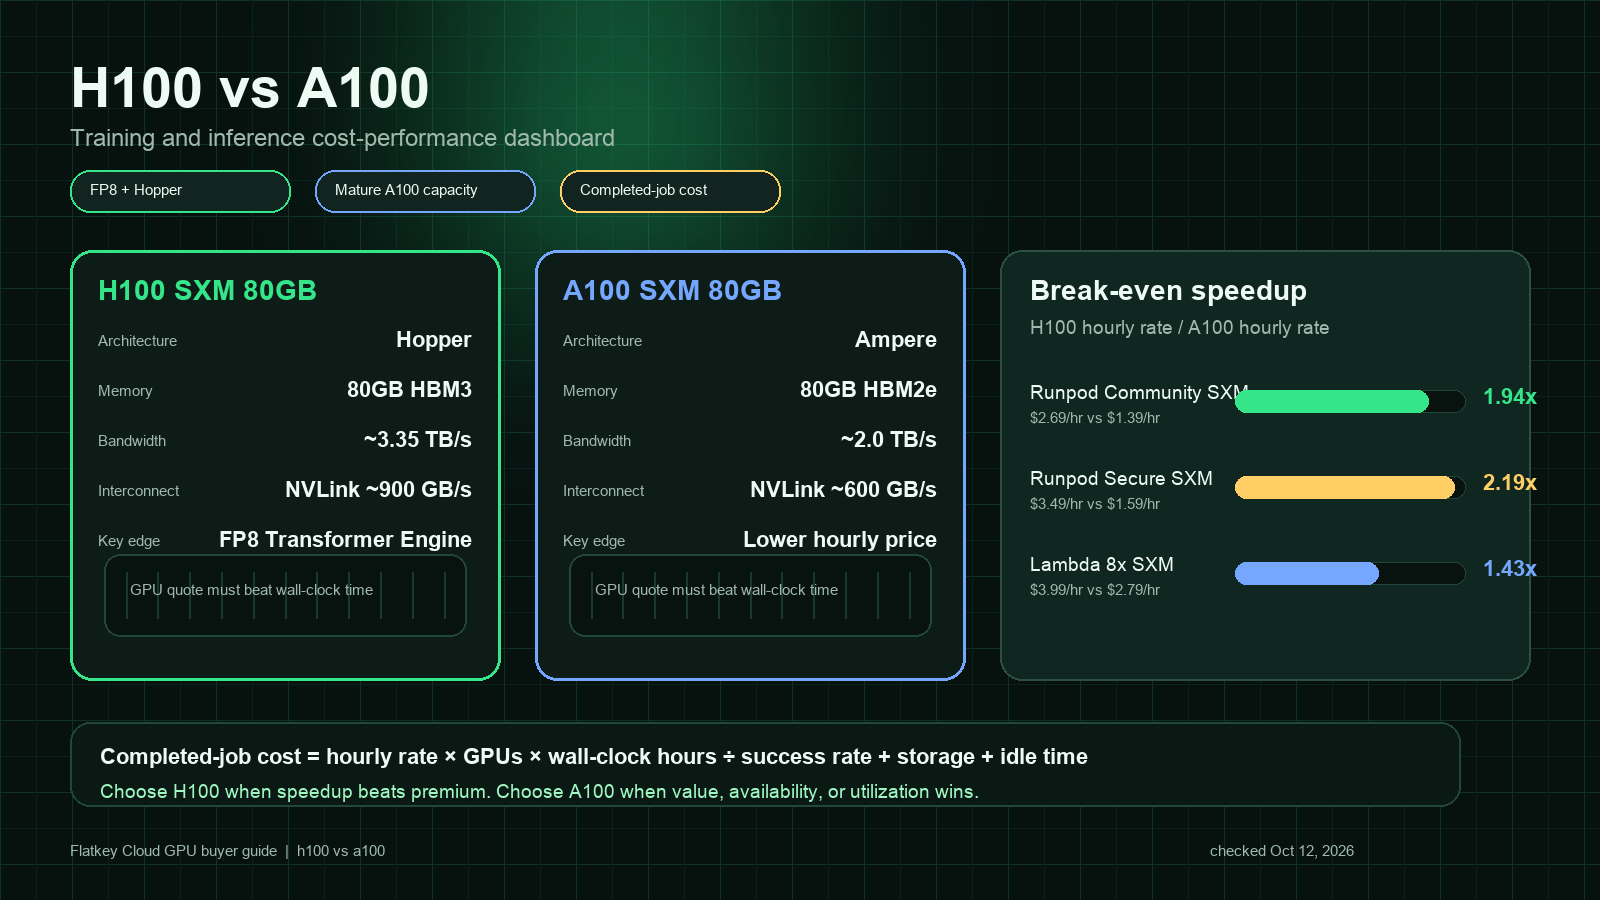
La respuesta corta para H100 vs A100 es sencilla: elige H100 cuando la carga de trabajo pueda aprovechar características de Hopper como FP8 Transformer Engine, mayor ancho de banda de memoria, NVLink de cuarta generación más rápido y kernels de inferencia más recientes. Elige A100 cuando el trabajo sea estable en memoria, el rendimiento FP16/BF16 ya sea suficiente, la disponibilidad importe más que la velocidad máxima, o la cotización por hora de la A100 sea mucho menor.
Por eso la pregunta correcta no es "¿Qué GPU es más rápida?" La H100 es el acelerador más nuevo y más rápido. La pregunta para el comprador es: ¿la H100 termina tu trabajo de entrenamiento o inferencia lo bastante más rápido como para compensar la prima de precio de la A100?
Esta guía compara NVIDIA H100 vs A100 para entrenamiento de IA, inferencia de LLM, fine-tuning, trabajos por lotes y adquisición de GPU en la nube. Los precios cambian cada semana, así que toma las filas de precios públicos de abajo como ejemplos de cotización verificados el 12 de octubre de 2026, y luego repite el mismo cálculo con tu lista corta de proveedores.
Rendimiento de H100 vs A100: tabla rápida de decisión
| Carga de trabajo | Normalmente elegir | Por qué |
|---|---|---|
| Entrenamiento de LLM de frontera o preentrenamiento distribuido a gran escala | H100 SXM | FP8 Transformer Engine, mayor ancho de banda de memoria, NVLink más rápido y mejor margen de escalado multi-GPU. |
| Fine-tuning de modelos de 7B a 70B | Depende | H100 gana cuando importa el tiempo de entrenamiento; A100 gana cuando la ejecución no está limitada por throughput o el presupuesto es fijo. |
| Inferencia de LLM sensible a la latencia | H100 | Mejor ruta de inferencia para transformers, mayor ancho de banda y optimización más reciente del stack de servicio. |
| Inferencia por lotes con SLA relajado | A100 | Un precio por hora más bajo puede ganar si la utilización es alta y el tiempo en cola es aceptable. |
| Notebooks multiusuario, demos y trabajos pequeños | A100 | Disponibilidad madura, menor coste y compatibilidad MIG hacen de A100 un valor predeterminado práctico. |
| Cargas de trabajo limitadas por memoria que caben en 80 GB | Probar ambas | La H100 tiene mucho más ancho de banda, pero la A100 de 80 GB aún puede ser más barata por trabajo completado. |
| Cargas CUDA heredadas ya ajustadas para Ampere | Primero A100 | Menor riesgo de migración a menos que el benchmarking de H100 demuestre una ganancia significativa. |
Para la mayoría de los equipos que comparan h100 vs a100 performance, empieza con una regla de dos líneas:
- Si el trabajo es caro porque tarda demasiado, prueba primero H100.
- Si el trabajo es caro porque la GPU está inactiva, falla o espera datos, corrige la utilización antes de pagar por H100.
Diferencias clave de especificaciones
La diferencia más importante entre NVIDIA A100 vs H100 es la generación arquitectónica. A100 se basa en NVIDIA Ampere. H100 se basa en NVIDIA Hopper y añade Transformer Engine, aceleración tensorial FP8, NVLink más reciente y límites de potencia SXM más altos. NVIDIA posiciona H100 para cargas de trabajo de IA a gran escala, HPC y billones de parámetros, mientras que A100 sigue siendo un acelerador de centro de datos ampliamente desplegado para entrenamiento, inferencia, analítica y HPC. Fuentes: Página de producto NVIDIA H100, Página de producto NVIDIA A100 y tarjeta de línea de GPU de centro de datos de NVIDIA.
| Área | NVIDIA H100 SXM 80 GB | NVIDIA A100 SXM 80 GB | Implicación para el comprador |
|---|---|---|---|
| Arquitectura | Hopper | Ampere | H100 es la generación más nueva optimizada para IA. |
| Memoria | 80 GB HBM3 | 80 GB HBM2e | La capacidad principal es la misma en los modelos comunes de 80 GB, pero H100 tiene memoria más rápida. |
| Ancho de banda de memoria | Hasta unos 3,35 TB/s | Hasta unos 2,0 TB/s | H100 tiene más margen para entrenamiento e inferencia limitados por memoria. |
| Precisión tensorial | Rutas tensoriales FP8, FP16, BF16, TF32, FP64 | Rutas tensoriales FP16, BF16, TF32, FP64 | FP8 puede mejorar de forma material el throughput de transformers cuando la precisión se mantiene. |
| Generación de NVLink | NVLink de cuarta generación, hasta 900 GB/s de ancho de banda GPU a GPU en SXM | NVLink de tercera generación, hasta 600 GB/s de ancho de banda GPU a GPU en SXM | H100 es más fuerte para entrenamiento multi-GPU y paralelismo de modelos grandes. |
| MIG | Compatible | Compatible | Ambas pueden particionar GPUs para utilización multiusuario. |
| Envolvente de potencia SXM típica | Más alta | Más baja | H100 puede requerir más energía y refrigeración, pero puede terminar más rápido. |
Estos números explican por qué una comparación h100 gpu vs a100 cambia según la carga de trabajo. Un modelo que puede usar FP8 y kernels más recientes puede ver a H100 despegar claramente. Un trabajo más pequeño limitado por el preprocesamiento de CPU, el almacenamiento o la red puede mostrar una ganancia mucho menor.
Fórmula de coste-rendimiento
Usa el coste del trabajo completado en lugar del precio por hora:
completed_job_cost =
  GPU_hourly_rate
  x number_of_GPUs
  x wall_clock_hours
  / success_rate
  + storage
  + network
  + idle_time
  + orchestration_overhead
Luego compara:
H100 must be at least this much faster to break even =
  H100_hourly_rate / A100_hourly_rate
Si H100 cuesta 1,8x más que A100, necesita terminar el mismo trabajo aceptado más de 1,8x más rápido para ganar en coste bruto de alquiler de GPU. Si cuesta 1,4x más, la barrera de equilibrio es menor. Por eso la selección de GPU en la nube siempre debe usar el SKU y la cotización exactos: H100 SXM, H100 PCIe, H100 NVL, A100 SXM 80 GB y A100 PCIe 40 GB no son intercambiables.
Para una hoja de cálculo más amplia sobre costos ocultos, consulta la guía de Flatkey sobre precios de alquiler de GPU.
Ejemplos de precios de GPU en la nube pública verificados el 12 de octubre de 2026
La tabla a continuación no es un índice universal de precios. Es una instantánea de ejemplos públicos que muestran cuán amplia puede ser la variación.
| Página del proveedor | Ejemplo de H100 | Ejemplo de A100 | Lo que muestra |
|---|---|---|---|
| Precios de Runpod | H100 SXM: Community Cloud $2.69/h, Secure Cloud $3.49/h; H100 PCIe: Community Cloud $1.99/h, Secure Cloud $2.89/h | A100 SXM: Community Cloud $1.39/h, Secure Cloud $1.59/h; A100 PCIe: Community Cloud $1.19/h, Secure Cloud $1.59/h | Los entornos de marketplace y seguros pueden tener diferentes puntos de equilibrio. |
| Precios de Lambda | Fila de clúster 8x H100 SXM: $3.99/GPU/h; fila de una sola H100 SXM: $4.29/GPU/h; fila de una sola H100 PCIe: $3.29/GPU/h | Fila 8x A100 SXM 80 GB: $2.79/GPU/h; fila de una sola A100 SXM 40 GB: $1.99/GPU/h | El tamaño del clúster, el tamaño de la memoria y la configuración del nodo importan tanto como el nombre de la GPU. |
| Precios de Massed Compute | La página enumera tarifas y configuraciones de GPU bajo demanda | La página enumera tarifas y configuraciones de GPU bajo demanda | Revisa siempre la cantidad, la memoria, el almacenamiento y los detalles de la instancia antes de comparar. |
A partir de estos ejemplos, un comprador que compare rendimiento de a100 vs h100 no debería asumir una prima fija. En una cotización, H100 PCIe puede estar lo bastante cerca de A100 como para que H100 se justifique fácilmente. En otra, A100 puede ser lo bastante barata como para que una ejecución más lenta siga ganando.
Comparación de entrenamiento
Para entrenamiento, H100 suele ser la primera GPU que conviene probar cuando:
- Entrenas modelos transformer y puedes usar de forma segura precisión mixta FP8.
- El trabajo es lo bastante grande como para que la velocidad del kernel y la velocidad de interconexión dominen el overhead de configuración.
- Usas paralelismo de modelos multinodo o multigpu.
- Tienes una fecha límite estricta en la que un menor tiempo total de ejecución vale más que la prima por hora.
- Tu equipo puede mantener una alta utilización de las GPU con datos preparados, checkpoints estables y reintentos automatizados.
A100 todavía puede ser la mejor compra para entrenamiento cuando:
- El modelo cabe limpiamente en 80 GB y no se beneficia mucho de FP8.
- Haces fine-tuning en lugar de pretraining.
- Ejecutas muchos experimentos en los que la profundidad de la cola importa más que la ejecución individual más rápida.
- Tu código, drivers, stack CUDA y monitoreo ya son estables en A100.
- Estás comprando capacidad reservada y el descuento de A100 es grande.
El hábito importante de adquisición es comparar costo por ejecución de entrenamiento aceptada, no solo tokens por segundo. Una ejecución rápida en H100 que falla al final por checkpoint, datos o inestabilidad del entrenamiento distribuido puede ser más cara que una ejecución más lenta en A100 que se completa de forma confiable.
Comparación de inferencia
Para inferencia, H100 suele ganar cuando la ruta de serving está optimizada para kernels modernos de LLM:
- Las solicitudes de contexto largo exigen el ancho de banda de memoria y el movimiento de KV-cache.
- El serving de alta concurrencia se beneficia de una optimización de kernel más nueva.
- Los SLO de latencia son lo bastante estrictos como para que una menor latencia p95 o p99 tenga valor para el negocio.
- El modelo usa FP8 o rutas de cuantización que tu stack de serving valida.
- Puedes agrupar suficientes solicitudes para mantener ocupada la GPU.
A100 suele ganar cuando:
- Los trabajos por lotes pueden ejecutarse durante la noche.
- El volumen de solicitudes es irregular y dejaría inactivas costosas H100.
- El modelo es lo bastante pequeño como para que una GPU más barata sea la verdadera ganadora.
- Sirves herramientas internas estables en lugar de tráfico crítico para los ingresos.
- Puedes desviar el desbordamiento a una API de modelo gestionada en lugar de mantener capacidad dedicada inactiva.
Para el serving de LLM, el rendimiento de h100 vs a100 también depende de la capa de software: vLLM, TensorRT-LLM, SGLang, NVIDIA NIM, formato de cuantización, política de batching, ajustes de KV-cache y distribución de la longitud de los prompts. No compres H100 basándote solo en un benchmark genérico. Reproduce tu propia mezcla de prompts.
Un plan práctico de benchmarking
Ejecuta el mismo benchmark en cada SKU candidato. Mantén fijos los criterios de aceptación.
| Paso | Qué medir | Por qué importa |
|---|---|---|
| 1. Bloquear la carga de trabajo | Modelo, longitud de secuencia, tamaño de lote, precisión, conjunto de datos, política de reintentos | Evita una comparación falsa de manzanas con manzanas. |
| 2. Medir el rendimiento | Tokens/seg de entrenamiento, muestras/seg o tokens/seg de inferencia | Muestra la velocidad bruta. |
| 3. Medir la latencia | p50, p95, p99, tiempo hasta el primer token, velocidad de decodificación | Captura el rendimiento visible para el usuario. |
| 4. Seguir la utilización | Utilización de GPU, ancho de banda de memoria, espera de CPU, espera de almacenamiento, espera de red | Revela si la elección de GPU es realmente el cuello de botella. |
| 5. Seguir los fallos | Reinicios de trabajos, OOM, errores de kernel, interrupciones spot | Convierte tarifas por hora baratas en un costo real completado. |
| 6. Calcular el costo aceptado | Costo por ejecución completada, salida aceptada o millón de tokens servidos | Este es el número que compras debería comparar. |
Reproducción mínima de inferencia:
100 prompts cortos
100 prompts medios
100 prompts de contexto largo
mismo modelo
misma precisión
misma versión del servidor
mismos tokens máximos
misma escalera de concurrencia
mismas verificaciones de calidad
Reproducción mínima del entrenamiento:
mismo checkpoint
misma partición del conjunto de datos
mismo objetivo de tamaño global de lote
misma configuración del optimizador
misma política de precisión
mismo intervalo de checkpoint
mismo método de recuperación ante fallos
¿Qué tan más rápido debe ser H100?
Usa tu cotización y luego calcula el speedup de punto de equilibrio.
| Ejemplo de cotización | Precio de H100 | Precio de A100 | Prima de precio de H100 | Interpretación del punto de equilibrio |
|---|---|---|---|---|
| Runpod Community H100 SXM vs A100 SXM | $2.69/hr | $1.39/hr | 1.94x | H100 debe terminar más de 1.94x más rápido, antes de los costos ocultos, para ganar en alquiler de GPU. |
| Runpod Secure H100 SXM vs A100 SXM | $3.49/hr | $1.59/hr | 2.19x | H100 necesita un gran speedup o una fuerte razón de latencia/negocio. |
| Lambda 8x H100 SXM vs 8x A100 SXM 80 GB | $3.99/GPU/hr | $2.79/GPU/hr | 1.43x | H100 puede ganar con un speedup mucho menor. |
| Lambda single H100 PCIe vs single A100 SXM 40 GB | $3.29/hr | $1.99/hr | 1.65x | La comparación mezcla SKU; deben considerarse las diferencias de memoria e interconexión. |
Aquí es donde muchas comparaciones de rendimiento a100 vs h100 salen mal. Un benchmark que dice "H100 es 2x más rápido" no es suficiente. Necesitas saber si tu cotización de H100 es 1.4x, 1.9x o 2.2x la cotización de A100, y si el trabajo realmente se completa con éxito a esa velocidad.
Lista de verificación de compras
Antes de elegir H100 o A100, pide a los proveedores:
- SKU exacta de GPU: SXM, PCIe, NVL, tamaño de memoria y política de MIG.
- Forma del nodo: cantidad de GPU, CPU, RAM, NVMe local, red e interconexión.
- Fabric de red para clústeres: NVLink/NVSwitch dentro del nodo, InfiniBand o Ethernet entre nodos, política de sobreasignación.
- Precio y rendimiento del almacenamiento: SSD local, volumen persistente, almacenamiento de objetos, instantánea y tiempo de restauración.
- Política de salida de datos y ancho de banda.
- Unidad de facturación: por segundo, por minuto o por hora.
- Política de interrupción para capacidad spot o de marketplace.
- Restricciones de región y cumplimiento.
- SLA de soporte y proceso de reemplazo.
- Términos de reserva y reglas de cancelación.
Para entrenamiento distribuido, la forma del nodo puede decidir el resultado. Ocho H100 detrás de un NVSwitch sólido y un buen fabric no son comparables con ocho GPU aisladas conectadas a través de una ruta de red débil.
Cuándo H100 vale la prima
H100 suele valer la pena cuando al menos dos de estas condiciones son verdaderas:
- La carga de trabajo es intensiva en transformers y está validada con FP8 o kernels optimizados para Hopper.
- El tiempo de entrenamiento bloquea lanzamientos, entrega al cliente o iteración de investigación.
- La latencia p95 o p99 en inferencia afecta los ingresos o la retención de usuarios.
- El trabajo usa intensamente la comunicación entre múltiples GPU.
- El proveedor ofrece una prima moderada de H100 sobre A100.
- Tu equipo puede mantener una utilización alta.
Es más difícil justificar H100 cuando:
- La GPU está ociosa durante grandes partes de la hora.
- La carga de datos, el preprocesamiento en CPU o la E/S de red son el cuello de botella.
- Tu stack de serving no está optimizado.
- El modelo es lo suficientemente pequeño para L40S, RTX PRO o una API gestionada.
- La capacidad A100 tiene descuentos profundos.
Cuándo A100 sigue siendo la opción pragmática
A100 sigue siendo un valor predeterminado práctico para muchos equipos de IA porque es maduro, está ampliamente disponible y sigue siendo sólido para entrenamiento e inferencia. Es especialmente útil cuando necesitas capacidad predecible para:
- Trabajos de ajuste fino.
- Generación de embeddings.
- Inferencia por lotes.
- Herramientas internas de IA.
- Cuadernos de investigación.
- Entornos multi-tenant usando MIG.
- Cargas de trabajo CUDA heredadas ya validadas en Ampere.
Si una ejecución en A100 cuesta la mitad y termina solo un 20% más lenta, A100 gana. Si cuesta 30% menos pero tarda 2x más, probablemente H100 gana. La matemática cambia de nuevo si la capacidad A100 es más fácil de reservar o si el tiempo de espera de H100 retrasa el proyecto.
Dónde encaja Flatkey
El alquiler de GPU no siempre es la forma más barata de ejecutar IA. Para algunas cargas de trabajo, una API de modelo gestionada es más barata porque pagas por cada solicitud exitosa en lugar de retener una GPU. Para otras cargas de trabajo, la capacidad dedicada de GPU es mejor porque tienes volumen constante, modelos personalizados, necesidades estrictas de latencia o requisitos de control de datos.
Flatkey ayuda a los equipos a comparar esas rutas desde el lado de la aplicación: una clave de API, un saldo, un libro mayor de uso y enrutamiento de modelos a través de endpoints oficiales de modelos. Usa alquiler de GPU cuando la carga de trabajo necesite capacidad dedicada. Usa una ruta de API de modelo cuando la carga de trabajo sea intermitente, operacionalmente más simple o más barata por tarea aceptada.
Preguntas frecuentes sobre H100 vs A100
¿Es H100 más rápido que A100?
Sí. H100 es la GPU más nueva de la generación Hopper y tiene ventajas importantes en cargas de trabajo orientadas a transformers, ancho de banda de memoria, compatibilidad con FP8 e interconexión más reciente. La decisión real es si es lo bastante más rápido como para compensar la prima de precio de H100 para tu carga de trabajo.
¿Sigue siendo A100 buena para inferencia de LLM?
Sí. A100 sigue siendo una GPU de inferencia capaz, especialmente para serving por lotes, herramientas internas, embeddings y cargas de trabajo donde los requisitos de latencia son moderados. H100 es más fuerte para serving de transformers de alto rendimiento y sensible a la latencia cuando el stack de software está optimizado.
¿Debería comparar H100 SXM con A100 PCIe?
Solo si esas son las cotizaciones reales que puedes comprar. Para la comparación técnica, mantén el factor de forma y la memoria lo más parecidos posible: H100 SXM vs A100 SXM, H100 PCIe vs A100 PCIe, 80 GB vs 80 GB donde esté disponible.
¿FP8 hace que H100 sea automáticamente mejor?
No. FP8 ayuda solo cuando el modelo y la pila de software pueden usarlo sin una pérdida de calidad inaceptable. Valida la calidad de salida, la convergencia y la estabilidad antes de asumir ahorros con FP8.
¿Cuál es mejor para fine-tuning?
Para trabajos pequeños y medianos de fine-tuning, A100 puede ser más rentable. Para trabajos más grandes, plazos ajustados o pilas de entrenamiento que se benefician del ancho de banda y las rutas FP8 de H100, H100 puede ganar.
¿Cuál es la mejor métrica para H100 vs A100?
Usa el costo por resultado aceptado: ejecución de entrenamiento completada, checkpoint del modelo aceptado, un millón de tokens servidos, lote exitoso o respuesta que cumpla con la latencia. El precio por hora por sí solo es incompleto.
En resumen
Para h100 vs a100, H100 es la opción de rendimiento y A100 suele ser la opción de valor. H100 gana cuando las funciones de Hopper reducen el tiempo de reloj de pared lo suficiente como para superar la prima por hora. A100 gana cuando la carga de trabajo es estable, la utilización es imperfecta, la diferencia de precio es amplia o la latencia no es la restricción.
Antes de reservar cualquiera de las dos GPU, prueba tu propio modelo, reproduce tu propio tráfico y calcula el costo del trabajo completado. Esa es la única comparación entre H100 y A100 que resiste una revisión de compras.


