
NVIDIA L40S vs H100 für AI-Inferenz: Durchsatz pro Dollar
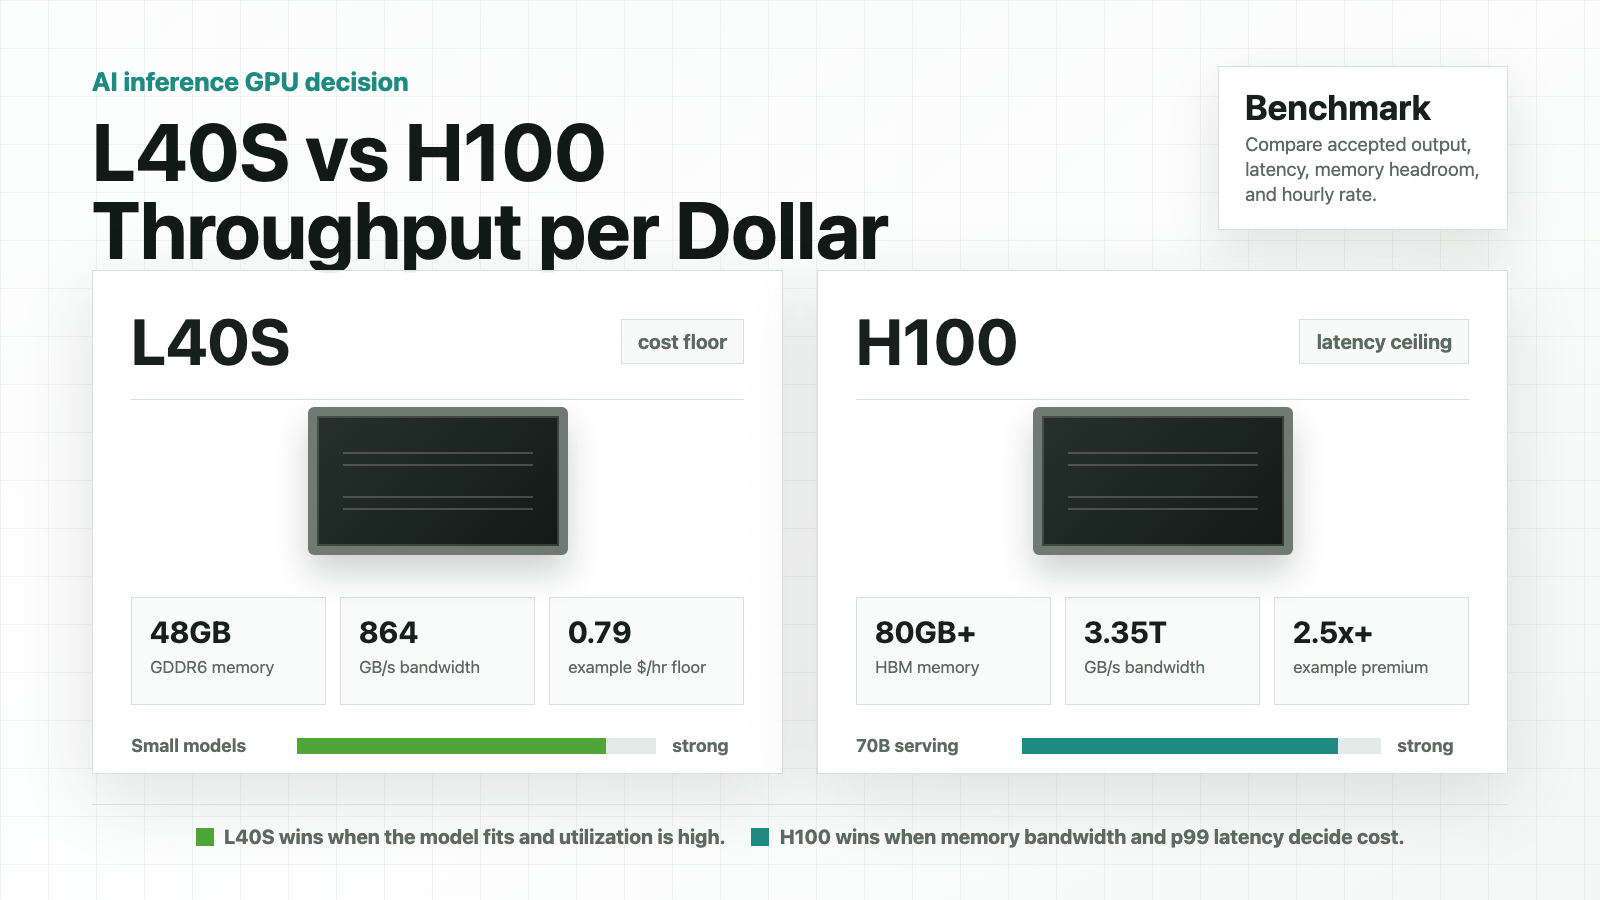
Die kurze Antwort für L40S vs H100 lautet nicht: „H100 ist schneller, also kaufe H100.“ H100 ist der stärkere AI-Beschleuniger. L40S ist oft die bessere Kandidatin für Durchsatz pro Dollar, wenn das Modell in 48 GB passt, die Latenzanforderungen moderat sind und das Anbieterangebot deutlich niedriger ist.
Für AI-Inferenz-Teams ist die nützliche Frage:
Liefern H100 pro Stunde genügend akzeptierte Ausgaben, um seinen Preisaufschlag gegenüber L40S für genau dieses Modell, diese Prompt-Mischung, diesen Serving-Stack und dieses SLA auszugleichen?
Dieser NVIDIA L40S vs H100-Vergleich konzentriert sich auf die Inferenzökonomie: Speicherpassung, Prefill, Decode, Batching, Latenz, Auslastung und Cloud-GPU-Preise. Preise ändern sich häufig, daher sollten Sie die öffentlichen Preiszeilen unten als Beispiele betrachten, die am 12. Oktober 2026 geprüft wurden, und dann dasselbe Arbeitsblatt mit Ihren aktuellen Anbieterangeboten erneut durchrechnen.
L40S vs H100: schnelle Entscheidungstabelle
| Inferenz-Workload | Meistens starten mit | Warum |
|---|---|---|
| 7B- bis 13B-Chat, interne Copilots, leichtgewichtiges RAG | L40S | Geringere Stundenkosten können H100 schlagen, wenn die Latenz akzeptabel ist und das Modell mit KV-Cache-Spielraum passt. |
| Modelle der 30B-Klasse mit moderatem Kontext | Beide benchmarken | L40S kann beim Preis gewinnen; H100 kann gewinnen, wenn Tail-Latenz oder Speicherbandbreite dominiert. |
| Serving der 70B-Klasse mit strikter Latenz | H100, H100 NVL, H200 oder Multi-GPU | H100 hat deutlich höhere HBM-Bandbreite, größeren Speicher auf gängigen SXM/NVL-Konfigurationen, NVLink-Optionen und stärkeren Support für Production-Serving. |
| Batch-Inferenz mit gelockertem SLA | Zuerst L40S | Queue-freundliche Workloads können günstigere Kapazität nutzen, wenn die Auslastung hoch bleibt. |
| RAG mit langem Kontext | Zuerst H100 | Prefill- und KV-Cache-Druck belohnen in der Regel HBM-Bandbreite und mehr Speicher. |
| Multi-Tenant-Infrastruktur | H100, wenn MIG wichtig ist | NVIDIA führt MIG-Unterstützung für H100 auf; NVIDIA führt keine MIG-Unterstützung für L40S auf. |
| Multimodale Workloads mit Rendering, Bild/Video oder Grafik | L40S kann attraktiv sein | L40S wird von NVIDIA als universelle GPU für KI, Grafik, Rendering und Medienbeschleunigung positioniert. |
| LLM-API mit hoher Parallelität und Kundenkontakt | Zuerst H100 | Tail-Latenz, Batching-Spielraum und Softwareoptimierung rechtfertigen oft den Aufpreis. |
Die praktische Regel: Wählen Sie L40S, wenn die Kostenuntergrenze zählt und die Workload sauber passt. Wählen Sie H100, wenn Latenz, Bandbreite, Parallelität, Sharding-Einfacheit oder Multi-GPU-Topologie Umsatz oder Zuverlässigkeit beeinflusst.
Zentrale Spezifikationsunterschiede
NVIDIA positioniert L40S als Ada-Lovelace-Rechenzentrum-GPU für generative KI, LLM-Inferenz und Training, 3D-Grafik, Rendering und Video. NVIDIA führt L40S mit 48 GB GDDR6 ECC-Speicher, 864 GB/s Speicherbandbreite, PCIe Gen4 x16, 350W maximaler Leistung, Tensor Cores der vierten Generation, FP8-Unterstützung, ohne MIG und ohne NVLink-Unterstützung auf. NVIDIA positioniert H100 als Hopper-Rechenzentrum-GPU für KI im großen Maßstab und HPC, mit dedizierter Transformer Engine, NVLink der vierten Generation, MIG und HBM-Speicher. In den Produktspezifikationen von NVIDIA ist H100 SXM mit 80 GB Speicher, 3,35 TB/s Bandbreite, bis zu 7 MIG-Instanzen, 900 GB/s NVLink und bis zu 700W konfigurierbarer TDP aufgeführt; H100 NVL ist mit 94 GB pro GPU, 3,9 TB/s Bandbreite und 600 GB/s NVLink aufgeführt. Quellen: NVIDIA L40S und NVIDIA H100.
| Bereich | NVIDIA L40S | NVIDIA H100 SXM / H100 NVL | Käuferimplikation |
|---|---|---|---|
| Architektur | Ada Lovelace | Hopper | H100 ist die Flaggschiff-Generation für KI/HPC-Beschleuniger; L40S ist eine universelle Rechenzentrum-GPU. |
| Speicher | 48 GB GDDR6 ECC | 80 GB HBM auf H100 SXM; 94 GB HBM auf H100 NVL | H100 bietet mehr Spielraum für größere Modelle, längeren Kontext und höhere Parallelität. |
| Speicherbandbreite | 864 GB/s | 3,35 TB/s auf H100 SXM; 3,9 TB/s auf H100 NVL | H100 hat einen großen Vorteil bei bandbreitengebundenem Prefill, Decode und KV-Cache-Transfer. |
| FP8 Tensor Core Peak mit Sparsity | 1.466 TFLOPS | 3.958 TFLOPS auf H100 SXM; 3.341 TFLOPS auf H100 NVL | H100 hat eine deutlich höhere Obergrenze, wenn der Serving-Stack und die Genauigkeitsrichtlinie FP8 nutzen können. |
| Interconnect | PCIe Gen4 x16; kein NVLink | PCIe Gen5 plus NVLink auf SXM/NVL-Konfigurationen | H100 ist stärker für Scale-up und Multi-GPU-Inferenz. |
| MIG | Nein | Bis zu 7 MIG-Instanzen | H100 ist besser, wenn Sie Hardware-Partitionierung für Auslastung oder Isolation benötigen. |
| Maximale Leistung | 350W | Bis zu 700W auf SXM; 350-400W auf NVL | L40S lässt sich möglicherweise einfacher in Servern mit niedrigerer Leistungsaufnahme unterbringen; H100 kann pro GPU mehr Arbeit erledigen. |
Diese Spezifikationen erklären, warum ein generischer L40S vs H100-Benchmark die Beschaffung in die Irre führen kann. H100 hat die technische Obergrenze. L40S kann dennoch gewinnen, wenn H100 um ein Vielfaches teurer ist und die Anwendung diese Obergrenze nicht vollständig nutzt.
Formel für Durchsatz pro Dollar
Vergleichen Sie bei Inferenz die akzeptierte Ausgabe, nicht rohe theoretische FLOPS:
accepted_output_per_dollar =
  akzeptierte Ausgabetokens oder akzeptierte Antworten pro Stunde
  / effektive Stundenkosten
Dann die versteckten Kosten einbeziehen:
effektive_Stundenkosten =
  GPU-Stundensatz
  + Speicher- und Snapshot-Kosten
  + Netzwerk- und Egress-Kosten
  + Kosten für Leerlaufkapazität
  + Kosten für Wiederholungen und fehlgeschlagene Anfragen
  + Orchestrierungs- oder Managed-Service-Overhead
Die Break-even-Regel ist einfach:
Erforderlicher Geschwindigkeitsvorteil von H100 gegenüber L40S =
  effektive Stundenkosten von H100 / effektive Stundenkosten von L40S
Wenn H100 3x so viel kostet wie L40S, muss H100 mehr als 3x akzeptierte Ausgaben pro Stunde liefern, um beim Durchsatz pro Dollar zu gewinnen, noch bevor Sie den Geschäftswert durch geringere Latenz berücksichtigen. Wenn H100 1,8x so viel kostet, ist die Hürde niedriger. Wenn L40S OOM-Wiederholungen, kleine Batch-Größen oder verfehlte p99-Latenz verursacht, ist der günstigere Stundenpreis nicht der günstigere Service.
Für ein breiteres Arbeitsblatt zu versteckten Kosten siehe Flatkeys Leitfaden zu GPU-Mietpreisen.
Öffentliche Preisbeispiele, geprüft am 12. Oktober 2026
Öffentliche GPU-Preise sind keine dauerhaften Tarifkarten. Sie variieren je nach Anbieter, Region, Verfügbarkeit, Sicherheitsstufe, Reservierung, Abrechnungseinheit und danach, ob die Kapazität Marketplace, dediziert, On-Demand oder gebunden ist.
| Anbieterseite | L40S-Beispiel | H100-Beispiel | Was es zeigt |
|---|---|---|---|
| RunPod-Preise | L40S: Community Cloud 0,79 $/Std., Secure Cloud 1,09 $/Std. | H100 PCIe: Community Cloud 1,99 $/Std., Secure Cloud 2,89 $/Std.; H100 SXM: Community Cloud 2,69 $/Std., Secure Cloud 3,49 $/Std.; H100 NVL: Community Cloud 2,59 $/Std., Secure Cloud 3,19 $/Std. | Direkt zitierte Zeilen können H100 vor versteckten Kosten etwa 2,5x bis 3,4x den L40S-Stundensatz kosten lassen. |
| Lambda-Preise | In dem für diesen Artikel geprüften öffentlichen Pricing-HTML wurde keine direkte L40S-Zeile gefunden | H100-Zeilen sind über Self-Service- und Cluster-Konfigurationen verfügbar, einschließlich H100-SXM- und H100-PCIe-Beispielen | Die Abdeckung der Anbieter unterscheidet sich; gehen Sie nicht davon aus, dass jede GPU-Auswahl bei jedem Anbieter verfügbar ist. |
Mit den RunPod-Community-Cloud-Beispielen sieht der Break-even-Geschwindigkeitsvorteil so aus:
| Vergleich | H100-Preis | L40S-Preis | H100-Preisaufschlag | Break-even-Bedeutung |
|---|---|---|---|---|
| H100 PCIe vs L40S | 1,99 $/Std. | 0,79 $/Std. | 2,52x | H100 PCIe benötigt mehr als 2,52x akzeptierte Ausgaben pro Stunde, um bei reiner GPU-Miete zu gewinnen. |
| H100 SXM vs L40S | 2,69 $/Std. | 0,79 $/Std. | 3,41x | H100 SXM braucht einen großen Durchsatzgewinn oder einen Latenz-/Geschäftsgrund, um den Aufpreis zu rechtfertigen. |
| H100 NVL vs L40S | 2,59 $/Std. | 0,79 $/Std. | 3,28x | H100 NVL muss seinen Speicher-/Interconnect-Vorteil im Workload ausspielen. |
| Secure H100 SXM vs Secure L40S | 3,49 $/Std. | 1,09 $/Std. | 3,20x | Sichere Kapazität verändert den absoluten Satz, aber die Break-even-Idee bleibt dieselbe. |
Verwenden Sie diese Zeilen nicht als universelle Wahrheit. Nutzen Sie sie, um die Mathematik zu verstehen: Eine Entscheidung zur NVIDIA L40S vs H100 Inferenzleistung ändert sich, wenn sich das Angebot ändert.
Wo L40S gewinnt
L40S verdient in der Regel den ersten Benchmark-Platz, wenn der Workload kostensensitiv und technisch begrenzt ist:
- Das Modell ist 7B, 8B, 13B oder ein quantisierter 30B-ähnlicher Pfad, der in 48 GB mit KV-Cache-Puffer passt.
- Der Traffic ist batch-orientiert, asynchron, intern oder tolerant gegenüber höherer p95-Latenz.
- Sie können L40S mit Warteschlangen auslasten, statt für sofortige Antwort zu überprovisionieren.
- Sie benötigen eine universelle GPU, die auch Rendering, Medien, Bilderzeugung oder gemischte kreative Workloads bewältigen kann.
- Ihr Anbieterangebot macht H100 2,5x bis 4x teurer.
- Ihr Serving-Framework zeigt eine akzeptable p95/p99-Latenz bei realistischen Prompts.
L40S ist auch für Teams attraktiv, die frühe Inferenzprodukte entwickeln. Wenn sich Modellauswahl, Prompt-Form und Traffic noch ändern, kann eine günstigere GPU Experimente billiger machen, während Sie echte Nachfragedaten sammeln.
Wo H100 gewinnt
H100 verdient in der Regel den ersten Benchmark-Platz, wenn Latenz, Parallelität, Speicherbandbreite oder das Serving großer Modelle die Kosten treiben:
- RAG mit langem Kontext belastet Prefill und KV-Cache-Bewegung.
- p95- oder p99-Latenz wirkt sich auf Conversion, Bindung oder Support-Last aus.
- Das Modell ist groß genug, dass 48 GB auf L40S aggressive Quantisierung, kleine Batch-Größen oder Tensor Parallelism erzwingen.
- Sie benötigen MIG für Mandantenisolierung oder höhere Auslastung.
- Sie benötigen NVLink, NVSwitch oder H100-NVL-artige Skalierung für Inferenz der 70B-Klasse.
- Ihr Stack kann FP8- oder Hopper-optimierte Kernel ohne Qualitätsregression nutzen.
- Die Reduzierung der GPU-Anzahl gleicht den Stundenaufschlag aus.
H100 geht nicht nur um Spitzenleistung. Es kann die Produktion auch vereinfachen, wenn eine H100 mehrere GPUs niedrigerer Klasse ersetzt, Model-Sharding vermeidet oder die Tail-Latenz innerhalb des SLA hält.
Die Workload-Details, die den Gewinner ändern
Der häufigste Fehler beim NVIDIA L40S vs H100 Performance-Vergleich ist das Testen einer einzigen Prompt-Länge und eines einzigen Parallelitätsniveaus. LLM-Serving hat unterschiedliche Engpässe:
| Workload-Dimension | Warum das wichtig ist |
|---|---|
| Modellgröße | Ein 7B-Modell und ein 70B-Modell belasten Speicher, Bandbreite oder Interconnect nicht auf die gleiche Weise. |
| Präzision und Quantisierung | FP8, FP16, BF16, INT8, AWQ, GPTQ und andere Pfade verändern sowohl Qualität als auch Durchsatz. |
| Kontextlänge | Lange Prompts verlagern Kosten hin zu Prefill und KV-Cache-Druck. |
| Ausgabelänge | Lange Antworten verlagern Kosten hin zu Decode-Durchsatz und Scheduling. |
| Konkurrenz | Eine GPU, die bei Batchgröße 1 gewinnt, kann unter realem Traffic verlieren. |
| Akzeptanzrate | Fehlgeschlagene, zeitüberschrittene oder qualitativ schlechte Ausgaben zählen nicht als produktiver Durchsatz. |
| Serving-Framework | vLLM, SGLang, TensorRT-LLM, NVIDIA NIM und benutzerdefinierte Server haben unterschiedliche Optimierungspfade. |
| Provider-Form | CPU, RAM, lokales NVMe, Netzwerk, Image-Start und das Risiko durch Noisy Neighbors können ein günstiges GPU-Angebot dominieren. |
Wenn Sie gleichzeitig einen Serving-Stack auswählen, bietet Flatkeys vLLM vs SGLang-Leitfaden einen separaten Rahmen zur Messung von Durchsatz, Latenz, Modellunterstützung und Betrieb.
Benchmark-Plan für L40S vs H100 Inferenz
Führen Sie denselben Replay auf L40S und H100 aus. Halten Sie die Akzeptanzkriterien fest.
| Schritt | Was gemessen wird | Warum |
|---|---|---|
| 1. Workload einfrieren | Modell-ID, Quantisierung, Kontextverteilung, Ausgabeobergrenze, Qualitätsprüfungen | Verhindert gefälschte Äpfel-mit-Äpfeln-Ergebnisse. |
| 2. Serving-Stack einfrieren | vLLM, SGLang, TensorRT-LLM, NIM, CUDA, Treiber, Container-Image | Softwareänderungen können Hardwareeffekte verdecken. |
| 3. Eine Konkurrenzleiter ausführen | 1, 4, 8, 16, 32, 64 oder Ihr reales Traffic-Muster | Zeigt, wann jede GPU sättigt. |
| 4. Prefill und Decode trennen | Zeit bis zum ersten Token, Prompt-Tokens/Sek., Ausgabe-Tokens/Sek. | Zeigt, ob Bandbreite oder Decode der Engpass ist. |
| 5. Tail-Latenz verfolgen | p50, p95, p99, Warteschlangenwartezeit, Timeout-Rate | Kaufentscheidungen sollten das Nutzererlebnis schützen. |
| 6. Auslastung verfolgen | GPU-Auslastung, verwendeter Speicher, HBM/GDDR-Bandbreitendruck, CPU-Wartezeit, Speicher-Wartezeit | Bestätigt, dass die GPU der tatsächliche Engpass ist. |
| 7. Fehler zählen | OOM, Evictions, fehlerhafte Hosts, Cold Starts, Retry-Stürme | Fehlgeschlagene Arbeit gehört in die Kosten pro akzeptierter Ausgabe. |
| 8. Akzeptierte Kosten berechnen | Kosten pro 1 Mio. akzeptierte Ausgabe-Tokens, pro akzeptierter Antwort oder pro abgeschlossenem Job | Beschaffung braucht normierte Kosten, keine Benchmark-Screenshots. |
Minimales Replay:
100 kurze Prompts
100 mittlere Prompts
100 Prompts mit langem Kontext
gleiches Modell
gleiche Präzisions- oder Quantisierungsrichtlinie
gleiche maximale Ausgabe-Tokens
gleiche Server-Version
gleiche Konkurrenzleiter
gleiche Qualitäts- und Akzeptanzprüfungen
Entscheidungstabelle:
| Messgröße | L40S-Ergebnis | H100-Ergebnis |
|---|---|---|
| Stündlicher GPU-Preis | ||
| Effektive Stundenkosten | ||
| Akzeptierte Antworten/Stunde | ||
| Akzeptierte Ausgabe-Tokens/Stunde | ||
| Kosten pro 1 Mio. akzeptierte Ausgabe-Tokens | ||
| Zeit bis zum ersten Token p95 | ||
| End-to-End-Latenz p95/p99 | ||
| OOM- oder Retry-Rate | ||
| Durchschnittliche GPU-Auslastung | ||
| Betriebsnotizen |
Das ist das Wert-Asset für einen echten L40S-vs-H100-Benchmark: Der Gewinner ist die GPU mit den niedrigeren akzeptierten Kosten bei dem Latenz- und Zuverlässigkeitsniveau, das Ihr Produkt erfordert.
Beschaffungs-Checkliste
Bevor Sie eine der beiden GPUs mieten oder kaufen, fragen Sie nach:
- Exakte SKU: L40S, H100 PCIe, H100 SXM, H100 NVL, Speicherkapazität und Formfaktor.
- Knotenkonfiguration: Anzahl der GPUs, CPU, RAM, lokales NVMe, Netzwerk und ob GPUs einen starken Interconnect teilen.
- Abrechnungseinheit: pro Sekunde, Minute, Stunde, Monat oder vertraglich gebundene Laufzeit.
- Kapazitätsmodus: Marketplace, Secure Cloud, Dedicated, Reserved, Spot oder Cluster.
- Richtlinie für Unterbrechung und Ersatz.
- Region, Compliance, Tenancy und Anforderungen an die Datenverarbeitung.
- Preise für Storage und Snapshots.
- Richtlinie für Egress und Bandbreite.
- Unterstützung für Treiber, CUDA, Container und Serving-Framework.
- Observability: Auslastung, Speicher, Queueing, p95/p99, OOMs, Retries und Kosten pro Route.
- Support-SLA und Eskalationspfad.
Für eine umfassendere Checkliste auf Cluster-Ebene siehe Flatkeys GPU-Cluster-Mietleitfaden.
Wann eine Modell-API besser ist als beide GPUs
Die richtige Antwort auf L40S vs H100 kann auch „keine von beiden“ sein. Das Mieten von GPUs ist sinnvoll, wenn Sie proprietäre Gewichte, hohe Auslastung, strikte Latenzkontrolle, benutzerdefinierte Kernel, Anforderungen an Datenlokalität oder ein Team haben, das bereit ist, Inferenzinfrastruktur zu betreiben.
Verwenden Sie eine Modell-API oder einen Router, wenn:
- Der Traffic ist burstartig.
- Die Modellwahl ändert sich häufig.
- Sie benötigen Fallback über mehrere Anbieter hinweg.
- Sie müssen keine eigenen Gewichte hosten.
- Die GPU-Leerlaufzeit würde jeden API-Aufpreis übersteigen.
- Die Finanzabteilung benötigt Nutzungsaufzeichnungen auf Anfrageebene, Budgets pro Sub-Key, Rechnungen und Kostenallokation.
Flatkey passt zu dieser Seite der Entscheidung: ein Schlüssel, ein Guthaben, eine Rechnung, offizielle Modell-Endpunkte und Nutzungsaufzeichnungen auf Anfrageebene über Modellrouten hinweg. Vergleichen Sie die Kosten pro akzeptiertem Token einer dedizierten L40S oder H100 mit verwalteten Modellrouten, bevor Sie sich langfristig auf GPU-Kapazität festlegen.
Für verwandte Kostenarbeit sehen Sie Flatkeys Leitfäden zum besten GPU für LLM-Inferenz, H100 vs A100, H200 vs H100, Vergleich der KI-Modellpreise und Ausgabenmanagement für KI-APIs.
Endgültige Empfehlung
Für die meisten unabhängigen Entwickler und kleinen KI-Teams, die L40S vs H100 vergleichen, gilt diese Faustregel:
- Wählen Sie L40S, wenn das Modell passt, die Latenz moderat ist, Anfragen warten können und H100 mehr als das 2- bis 3-Fache des Stundensatzes kostet.
- Wählen Sie H100, wenn Speicherbandbreite, größerer Speicher, NVLink, MIG, hohe Parallelität, langer Kontext oder p95/p99-Latenz das Produktergebnis bestimmen.
- Benchmarken Sie beide, wenn die Workload zur 30B-Klasse gehört, gemischte Kontexte aufweist oder nahe der 48-GB-Speichergrenze liegt.
- Vergleichen Sie beide mit einer verwalteten Modell-API, wenn die Auslastung unsicher ist oder sich die Modellwahl häufig ändert.
Die stärkste Entscheidung zur NVIDIA L40S vs H100 performance ist nicht ein allgemeiner Benchmark-Sieger. Es ist die GPU, die die niedrigsten Kosten pro akzeptierter Ausgabe bei Einhaltung Ihres Latenz- und Zuverlässigkeitsziels liefert.
Häufige Fragen zu L40S vs H100
Ist H100 schneller als L40S für AI-Inferenz?
Ja, H100 hat ein deutlich höheres technisches Potenzial für KI-Inferenz, insbesondere wenn Speicherbandbreite, FP8-Durchsatz, größerer Speicher, NVLink und Hopper-optimiertes Serving wichtig sind. L40S kann dennoch beim Durchsatz pro Dollar gewinnen, wenn die Workload passt und der Stundenaufschlag von H100 zu hoch ist.
Ist L40S gut für LLM-Inferenz?
Ja. NVIDIA positioniert L40S für generative KI sowie LLM-Inferenz/-Training und nennt 48 GB GDDR6-ECC-Speicher plus Tensor Cores der vierten Generation mit FP8-Unterstützung. Sie ist am stärksten für kleinere und mittelgroße Modelle, Batch-Inferenz, gemischte KI-/Grafik-Workloads und kostensensitives Serving.
Sollte ich L40S oder H100 für 70B-Modelle verwenden?
Beginnen Sie mit H100, H100 NVL, H200 oder einer Multi-GPU-Konfiguration für Produktions-Inferenz in der 70B-Klasse, insbesondere bei langem Kontext oder strengen Latenzzielen. L40S kann für eingeschränkte oder quantisierte Experimente funktionieren, aber 48 GB Speicher können die Parallelität und den KV-Cache-Puffer begrenzen.
Was ist die beste Metrik für L40S vs H100?
Verwenden Sie die Kosten pro akzeptierter Ausgabe bei Ziel-Latenz. Verfolgen Sie akzeptierte Ausgabetokens pro Stunde, akzeptierte Antworten pro Stunde, p95/p99-Latenz, Retry-Rate, OOM-Rate, Auslastung und effektive Stundenkosten.
Reicht ein L40S-vs-H100-Benchmark aus, um Kapazität zu kaufen?
Nur wenn der Benchmark Ihre echte Prompt-Mischung, Kontextlängen, Ausgabelängen, Parallelität, Qualitätsprüfungen und die Anbieterumgebung wiedergibt. Ein generisches Tokens/sec-Ergebnis ist nützlich, aber allein keine Kaufentscheidung.


