
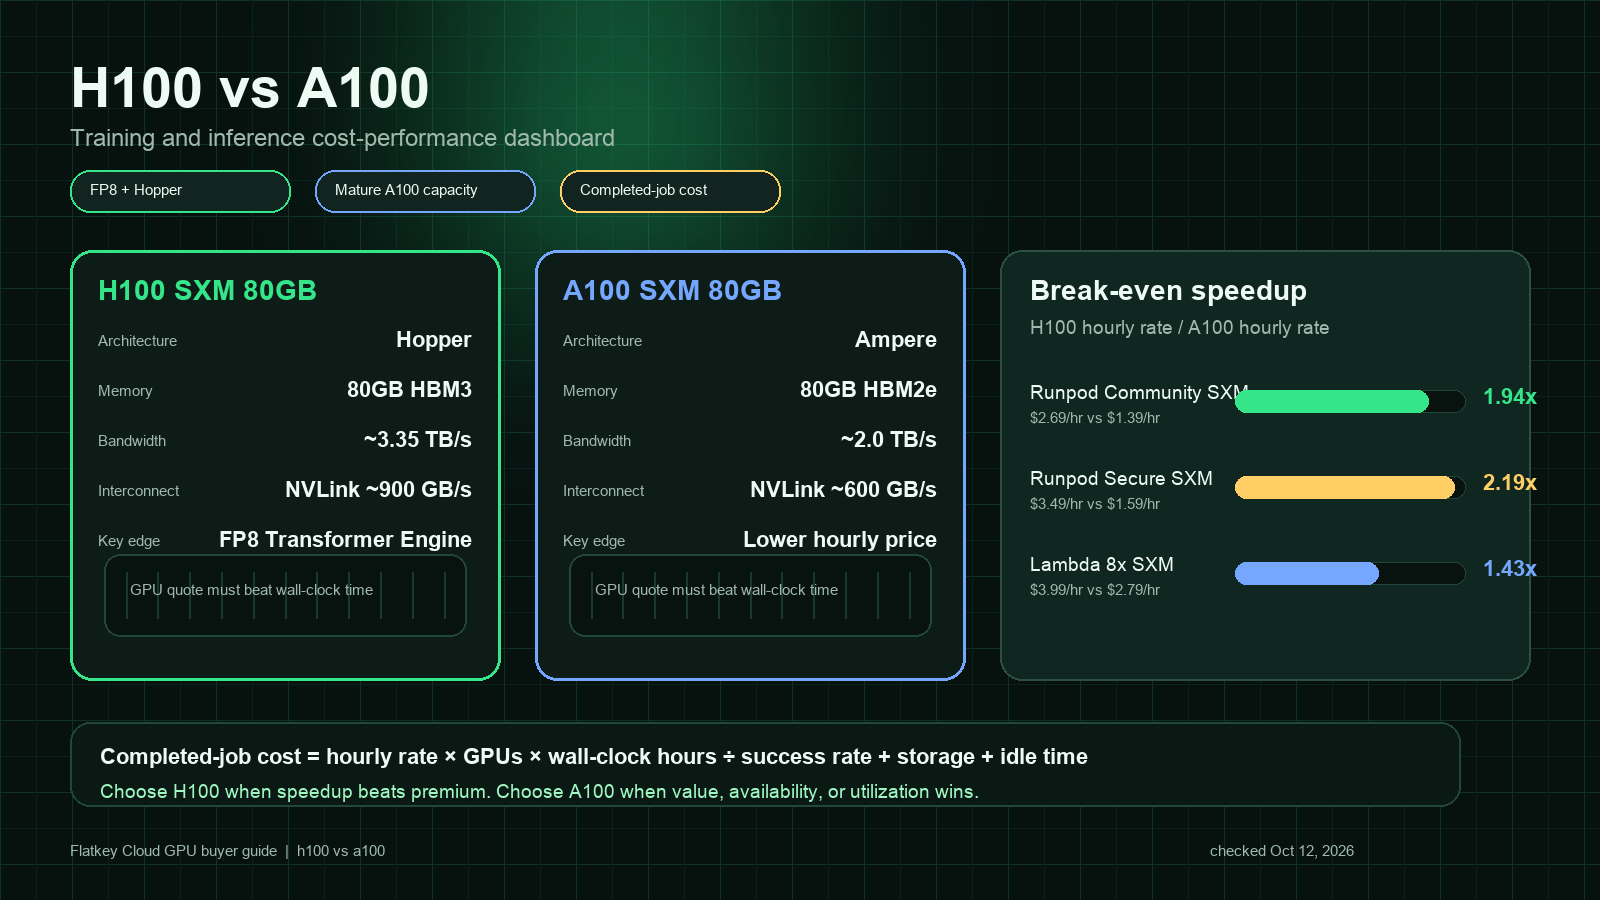
Jawaban singkat untuk H100 vs A100 cukup sederhana: pilih H100 ketika workload dapat memanfaatkan fitur Hopper seperti FP8 Transformer Engine, bandwidth memori yang lebih tinggi, NVLink generasi keempat yang lebih cepat, dan kernel inference yang lebih baru. Pilih A100 ketika pekerjaan bersifat stabil terhadap memori, throughput FP16/BF16 sudah cukup, ketersediaan lebih penting daripada kecepatan puncak, atau penawaran harga per jam A100 jauh lebih rendah.
Itulah sebabnya pertanyaan yang tepat bukan "GPU mana yang lebih cepat?" H100 adalah akselerator yang lebih baru dan lebih cepat. Pertanyaan bagi pembeli adalah: apakah H100 menyelesaikan pekerjaan training atau inference Anda cukup lebih cepat untuk mengimbangi premi harga A100?
Panduan ini membandingkan NVIDIA H100 vs A100 untuk AI training, inference LLM, fine-tuning, batch job, dan pengadaan cloud GPU. Harga berubah setiap minggu, jadi perlakukan baris harga publik di bawah sebagai contoh penawaran yang diperiksa pada 12 Oktober 2026, lalu jalankan ulang perhitungan yang sama pada daftar penyedia Anda.
Performa H100 vs A100: tabel keputusan cepat
| Workload | Biasanya pilih | Alasannya |
|---|---|---|
| Training LLM frontier atau pretraining terdistribusi berskala besar | H100 SXM | FP8 Transformer Engine, bandwidth memori lebih tinggi, NVLink lebih cepat, dan ruang skalabilitas multi-GPU yang lebih baik. |
| Fine-tuning model 7B hingga 70B | Tergantung | H100 unggul ketika waktu untuk training penting; A100 unggul ketika run tidak dibatasi throughput atau anggaran sudah tetap. |
| Inference LLM yang sensitif terhadap latensi | H100 | Jalur inference transformer yang lebih baik, bandwidth lebih tinggi, dan optimasi stack serving yang lebih baru. |
| Batch inference dengan SLA yang longgar | A100 | Harga per jam yang lebih rendah bisa menang jika utilisasi tinggi dan waktu antre masih dapat diterima. |
| Notebook multi-tenant, demo, dan job kecil | A100 | Ketersediaan yang matang, biaya lebih rendah, dan dukungan MIG menjadikan A100 pilihan default yang praktis. |
| Workload yang terikat memori dan muat dalam 80 GB | Uji keduanya | H100 memiliki bandwidth yang jauh lebih tinggi, tetapi A100 80 GB tetap bisa lebih murah per job yang selesai. |
| Workload CUDA legacy yang sudah dituning untuk Ampere | A100 terlebih dahulu | Risiko migrasi lebih rendah kecuali benchmarking H100 membuktikan peningkatan yang signifikan. |
Untuk sebagian besar tim yang membandingkan h100 vs a100 performance, mulailah dengan aturan dua baris:
- Jika job mahal karena terlalu lama berjalan, benchmark H100 terlebih dahulu.
- Jika job mahal karena GPU menganggur, gagal, atau menunggu data, perbaiki utilisasi sebelum membayar H100.
Perbedaan spesifikasi inti
Perbedaan NVIDIA A100 vs H100 yang paling penting adalah generasi arsitekturnya. A100 berbasis NVIDIA Ampere. H100 berbasis NVIDIA Hopper dan menambahkan Transformer Engine, akselerasi tensor FP8, NVLink yang lebih baru, dan batas daya SXM yang lebih tinggi. NVIDIA memposisikan H100 untuk AI besar, HPC, dan workload triliunan parameter, sementara A100 tetap menjadi akselerator pusat data yang banyak digunakan untuk training, inference, analitik, dan HPC. Sumber: halaman produk NVIDIA H100, halaman produk NVIDIA A100, dan line card GPU pusat data NVIDIA.
| Area | NVIDIA H100 SXM 80 GB | NVIDIA A100 SXM 80 GB | Implikasi bagi pembeli |
|---|---|---|---|
| Arsitektur | Hopper | Ampere | H100 adalah generasi yang lebih baru dan dioptimalkan untuk AI. |
| Memori | 80 GB HBM3 | 80 GB HBM2e | Kapasitas utama sama untuk varian umum 80 GB, tetapi H100 memiliki memori yang lebih cepat. |
| Bandwidth memori | Hingga sekitar 3,35 TB/s | Hingga sekitar 2,0 TB/s | H100 memiliki ruang yang lebih besar untuk training dan inference yang terikat memori. |
| Presisi tensor | Jalur tensor FP8, FP16, BF16, TF32, FP64 | Jalur tensor FP16, BF16, TF32, FP64 | FP8 dapat meningkatkan throughput transformer secara signifikan jika akurasinya tetap terjaga. |
| Generasi NVLink | NVLink generasi keempat, hingga bandwidth GPU-ke-GPU 900 GB/s pada SXM | NVLink generasi ketiga, hingga bandwidth GPU-ke-GPU 600 GB/s pada SXM | H100 lebih kuat untuk training multi-GPU dan paralelisme model besar. |
| MIG | Didukung | Didukung | Keduanya dapat mempartisi GPU untuk utilisasi multi-tenant. |
| Envelop daya SXM tipikal | Lebih tinggi | Lebih rendah | H100 mungkin memerlukan daya dan pendinginan lebih besar, tetapi bisa selesai lebih cepat. |
Angka-angka ini menjelaskan mengapa perbandingan h100 gpu vs a100 berubah tergantung workload. Model yang dapat menggunakan FP8 dan kernel yang lebih baru mungkin melihat H100 jauh lebih unggul. Job yang lebih kecil dan terhambat oleh preprocessing CPU, storage, atau network dapat menunjukkan peningkatan yang jauh lebih kecil.
Rumus performa biaya
Gunakan biaya per job yang selesai, bukan harga per jam:
completed_job_cost =
  GPU_hourly_rate
  x number_of_GPUs
  x wall_clock_hours
  / success_rate
  + storage
  + network
  + idle_time
  + orchestration_overhead
Kemudian bandingkan:
H100 must be at least this much faster to break even =
  H100_hourly_rate / A100_hourly_rate
Jika H100 berharga 1,8x lebih mahal daripada A100, maka H100 harus menyelesaikan job yang sama yang diterima lebih dari 1,8x lebih cepat untuk menang dalam biaya sewa GPU mentah. Jika biayanya 1,4x lebih mahal, ambang impasnya lebih rendah. Inilah sebabnya pemilihan GPU cloud harus selalu menggunakan SKU dan penawaran yang tepat: H100 SXM, H100 PCIe, H100 NVL, A100 SXM 80 GB, dan A100 PCIe 40 GB tidak dapat saling dipertukarkan.
Untuk lembar kerja yang lebih luas tentang biaya tersembunyi, lihat panduan Flatkey tentang harga sewa GPU.
Contoh harga GPU public cloud diperiksa 12 Oktober 2026
Tabel di bawah ini bukan indeks harga universal. Ini adalah cuplikan contoh publik yang menunjukkan seberapa lebar rentangnya.
| Halaman penyedia | Contoh H100 | Contoh A100 | Apa yang ditunjukkan |
|---|---|---|---|
| Harga Runpod | H100 SXM: Community Cloud $2.69/jam, Secure Cloud $3.49/jam; H100 PCIe: Community Cloud $1.99/jam, Secure Cloud $2.89/jam | A100 SXM: Community Cloud $1.39/jam, Secure Cloud $1.59/jam; A100 PCIe: Community Cloud $1.19/jam, Secure Cloud $1.59/jam | Pasar dan lingkungan aman dapat memiliki titik impas yang berbeda. |
| Harga Lambda | Baris klaster 8x H100 SXM: $3.99/GPU/jam; baris H100 SXM tunggal: $4.29/GPU/jam; baris H100 PCIe tunggal: $3.29/GPU/jam | Baris 8x A100 SXM 80 GB: $2.79/GPU/jam; baris A100 SXM 40 GB tunggal: $1.99/GPU/jam | Ukuran klaster, ukuran memori, dan konfigurasi node sama pentingnya dengan nama GPU. |
| Harga Massed Compute | Halaman mencantumkan tarif GPU on-demand dan konfigurasi | Halaman mencantumkan tarif GPU on-demand dan konfigurasi | Selalu periksa jumlah, memori, penyimpanan, dan detail instance sebelum membandingkan. |
Dari contoh-contoh ini, pembeli yang membandingkan performa a100 vs h100 seharusnya tidak mengasumsikan satu premi tetap. Dalam satu penawaran, H100 PCIe mungkin cukup dekat dengan A100 sehingga H100 mudah dibenarkan. Dalam penawaran lain, A100 mungkin cukup murah sehingga proses yang lebih lambat tetap lebih unggul.
Perbandingan training
Untuk training, H100 biasanya adalah GPU pertama yang diuji ketika:
- Anda melatih model transformer dan dapat dengan aman menggunakan presisi campuran FP8.
- Job cukup besar sehingga kecepatan kernel dan kecepatan interkoneksi mendominasi overhead setup.
- Anda menggunakan paralelisme model multi-node atau multi-GPU.
- Anda memiliki tenggat waktu ketat di mana waktu wall-clock yang lebih singkat lebih berharga daripada premi per jam.
- Tim Anda dapat menjaga GPU tetap sangat terpakai dengan data yang sudah disiapkan, checkpoint yang stabil, dan retry otomatis.
A100 masih dapat menjadi pembelian training yang lebih baik ketika:
- Model muat dengan rapi dalam 80 GB dan tidak banyak mendapat manfaat dari FP8.
- Anda melakukan fine-tuning, bukan pretraining.
- Anda menjalankan banyak eksperimen di mana kedalaman antrean lebih penting daripada run tunggal tercepat.
- Kode, driver, stack CUDA, dan monitoring Anda sudah stabil di A100.
- Anda membeli kapasitas reserved dan diskon A100 sangat besar.
Kebiasaan pengadaan yang penting adalah membandingkan biaya per training run yang diterima, bukan hanya token per detik. Run H100 yang cepat tetapi gagal di akhir karena checkpoint, data, atau ketidakstabilan distributed training bisa lebih mahal daripada run A100 yang lebih lambat tetapi selesai dengan andal.
Perbandingan inference
Untuk inference, H100 sering menang ketika jalur serving dioptimalkan untuk kernel LLM modern:
- Permintaan context panjang membebani bandwidth memori dan pergerakan KV-cache.
- Serving concurrency tinggi diuntungkan oleh optimisasi kernel yang lebih baru.
- SLO latensi cukup ketat sehingga latensi p95 atau p99 yang lebih rendah memiliki nilai bisnis.
- Model menggunakan FP8 atau jalur kuantisasi yang divalidasi oleh stack serving Anda.
- Anda dapat melakukan batching cukup banyak request untuk menjaga GPU tetap sibuk.
A100 sering menang ketika:
- Batch job dapat dijalankan semalaman.
- Volume request bersifat sporadis dan akan membuat H100 yang mahal menganggur.
- Model cukup kecil sehingga tier GPU yang lebih murah adalah pemenang sebenarnya.
- Anda melayani alat internal yang stabil, bukan traffic yang kritis terhadap pendapatan.
- Anda dapat mengalihkan overflow ke model API terkelola daripada mempertahankan kapasitas dedicated yang menganggur.
Untuk serving LLM, performa h100 vs a100 juga bergantung pada lapisan software: vLLM, TensorRT-LLM, SGLang, NVIDIA NIM, format kuantisasi, kebijakan batching, pengaturan KV-cache, dan distribusi panjang prompt. Jangan membeli H100 hanya berdasarkan benchmark generik. Jalankan kembali campuran prompt Anda sendiri.
Rencana benchmark praktis
Jalankan benchmark yang sama pada setiap SKU kandidat. Pertahankan kriteria penerimaan tetap.
| Langkah | Apa yang diukur | Mengapa penting |
|---|---|---|
| 1. Kunci workload | Model, panjang sequence, ukuran batch, presisi, dataset, kebijakan retry | Mencegah perbandingan apel-ke-apel palsu. |
| 2. Ukur throughput | Token training/detik, sampel/detik, atau token inference/detik | Menunjukkan kecepatan mentah. |
| 3. Ukur latensi | p50, p95, p99, time-to-first-token, kecepatan decode | Menangkap performa yang terlihat oleh pengguna. |
| 4. Lacak utilisasi | Utilisasi GPU, bandwidth memori, CPU wait, storage wait, network wait | Mengungkap apakah pilihan GPU adalah bottleneck sebenarnya. |
| 5. Lacak kegagalan | Job restart, OOM, error kernel, gangguan spot | Mengubah tarif per jam yang murah menjadi biaya selesai yang nyata. |
| 6. Hitung biaya yang diterima | Biaya per run selesai, output yang diterima, atau satu juta token yang dilayani | Inilah angka yang harus dibandingkan oleh pengadaan. |
Replay inference minimum:
100 prompt pendek
100 prompt menengah
100 prompt konteks panjang
model yang sama
presisi yang sama
versi server yang sama
tokens maksimum yang sama
ladder concurrency yang sama
pemeriksaan kualitas yang sama
Replay minimum untuk training:
checkpoint yang sama
shard dataset yang sama
target ukuran global batch yang sama
pengaturan optimizer yang sama
kebijakan presisi yang sama
interval checkpoint yang sama
metode pemulihan kegagalan yang sama
Seberapa jauh H100 harus lebih cepat?
Gunakan penawaran Anda, lalu hitung speedup titik impas.
| Contoh penawaran | Harga H100 | Harga A100 | Premium harga H100 | Interpretasi titik impas |
|---|---|---|---|---|
| Runpod Community H100 SXM vs A100 SXM | $2.69/jam | $1.39/jam | 1.94x | H100 harus selesai lebih dari 1.94x lebih cepat sebelum biaya tersembunyi agar menang dari sisi sewa GPU. |
| Runpod Secure H100 SXM vs A100 SXM | $3.49/jam | $1.59/jam | 2.19x | H100 membutuhkan speedup yang besar atau alasan latency/bisnis yang kuat. |
| Lambda 8x H100 SXM vs 8x A100 SXM 80 GB | $3.99/GPU/jam | $2.79/GPU/jam | 1.43x | H100 dapat menang dengan speedup yang jauh lebih kecil. |
| Lambda single H100 PCIe vs single A100 SXM 40 GB | $3.29/jam | $1.99/jam | 1.65x | Perbandingannya mencampur SKU; perbedaan memori dan interkoneksi harus dipertimbangkan. |
Di sinilah banyak perbandingan a100 vs h100 performance menjadi keliru. Benchmark yang mengatakan "H100 2x lebih cepat" belum cukup. Anda perlu tahu apakah penawaran H100 Anda 1.4x, 1.9x, atau 2.2x dari penawaran A100, dan apakah job benar-benar selesai dengan sukses pada kecepatan tersebut.
Daftar periksa pengadaan
Sebelum memilih H100 atau A100, minta vendor untuk:
- SKU GPU yang tepat: SXM, PCIe, NVL, ukuran memori, dan kebijakan MIG.
- Bentuk node: jumlah GPU, CPU, RAM, NVMe lokal, jaringan, dan interkoneksi.
- Fabric jaringan untuk klaster: NVLink/NVSwitch di dalam node, InfiniBand atau Ethernet antar node, kebijakan oversubscription.
- Harga dan performa storage: SSD lokal, persistent volume, object storage, waktu snapshot, dan restore.
- Kebijakan egress dan bandwidth.
- Unit penagihan: per detik, per menit, atau per jam.
- Kebijakan interupsi untuk kapasitas spot atau marketplace.
- Region dan batasan kepatuhan.
- SLA dukungan dan proses penggantian.
- Syarat reservasi dan aturan pembatalan.
Untuk distributed training, bentuk node bisa menentukan hasil. Delapan H100 di balik NVSwitch yang kuat dan fabric yang baik tidak sebanding dengan delapan GPU terisolasi yang terhubung melalui jalur jaringan yang lemah.
Kapan H100 sepadan dengan premi harganya
H100 biasanya layak dibayar ketika setidaknya dua dari hal berikut benar:
- Beban kerja sangat berat pada transformer dan tervalidasi dengan FP8 atau kernel yang dioptimalkan untuk Hopper.
- Waktu training menghambat rilis, pengiriman ke pelanggan, atau iterasi riset.
- Latensi p95 atau p99 inference memengaruhi pendapatan atau retensi pengguna.
- Job menggunakan komunikasi multi-GPU secara intensif.
- Provider menawarkan premium H100 yang moderat dibanding A100.
- Tim Anda dapat menjaga utilisasi tetap tinggi.
H100 lebih sulit dibenarkan ketika:
- GPU menganggur untuk sebagian besar jam.
- Loading data, preprocessing CPU, atau I/O jaringan menjadi bottleneck.
- Stack serving Anda belum dituning.
- Model cukup kecil untuk L40S, RTX PRO, atau managed API.
- Kapasitas A100 mendapat diskon besar.
Kapan A100 masih menjadi pilihan pragmatis
A100 tetap menjadi default yang praktis bagi banyak tim AI karena sudah matang, tersedia luas, dan masih kuat untuk training serta inference. Ini sangat berguna ketika Anda membutuhkan kapasitas yang dapat diprediksi untuk:
- Job fine-tuning.
- Generasi embedding.
- Batch inference.
- Alat AI internal.
- Notebook riset.
- Lingkungan multi-tenant yang menggunakan MIG.
- Beban kerja CUDA lama yang sudah divalidasi di Ampere.
Jika satu run A100 biayanya setengah dan selesai hanya 20% lebih lambat, A100 menang. Jika biayanya 30% lebih murah tetapi memakan waktu 2x lebih lama, H100 kemungkinan menang. Perhitungannya berubah lagi jika kapasitas A100 lebih mudah direservasi atau jika waktu tunggu H100 menunda proyek.
Di mana Flatkey berperan
Sewa GPU tidak selalu cara termurah untuk menjalankan AI. Untuk beberapa beban kerja, model API terkelola lebih murah karena Anda membayar per request yang berhasil, bukan menahan GPU. Untuk beban kerja lain, kapasitas GPU khusus lebih baik karena volume stabil, model kustom, kebutuhan latency yang ketat, atau persyaratan kontrol data.
Flatkey membantu tim membandingkan jalur-jalur tersebut dari sisi aplikasi: satu API key, satu saldo, satu ledger penggunaan, dan routing model di seluruh endpoint model resmi. Gunakan sewa GPU ketika beban kerja membutuhkan kapasitas khusus. Gunakan jalur model API ketika beban kerja bersifat bursty, lebih sederhana secara operasional, atau lebih murah per task yang diterima.
FAQ H100 vs A100
Apakah H100 lebih cepat daripada A100?
Ya. H100 adalah GPU generasi Hopper yang lebih baru dan memiliki keunggulan besar pada beban kerja berorientasi transformer, bandwidth memori, dukungan FP8, dan interkoneksi yang lebih baru. Keputusan sebenarnya adalah apakah kecepatan tambahan itu cukup untuk menutupi premium harga H100 untuk beban kerja Anda.
Apakah A100 masih bagus untuk inference LLM?
Ya. A100 masih merupakan GPU inference yang mumpuni, terutama untuk serving batch, alat internal, embedding, dan beban kerja dengan kebutuhan latensi sedang. H100 lebih kuat untuk serving transformer ber-throughput tinggi dan sensitif latensi ketika stack software telah dituning.
Haruskah saya membandingkan H100 SXM dengan A100 PCIe?
Hanya jika itu adalah kutipan aktual yang bisa Anda beli. Untuk perbandingan teknis, jaga form factor dan memori sedekat mungkin: H100 SXM vs A100 SXM, H100 PCIe vs A100 PCIe, 80 GB vs 80 GB jika tersedia.
Apakah FP8 membuat H100 secara otomatis lebih baik?
Tidak. FP8 hanya membantu ketika model dan stack software dapat menggunakannya tanpa kehilangan kualitas yang tidak dapat diterima. Validasi kualitas output, konvergensi, dan stabilitas sebelum mengasumsikan penghematan dari FP8.
Mana yang lebih baik untuk fine-tuning?
Untuk pekerjaan fine-tuning kecil dan menengah, A100 bisa lebih hemat biaya. Untuk pekerjaan yang lebih besar, tenggat waktu yang ketat, atau stack training yang mendapat manfaat dari bandwidth dan jalur FP8 milik H100, H100 bisa unggul.
Apa metrik terbaik untuk H100 vs A100?
Gunakan biaya per hasil yang diterima: training run yang selesai, checkpoint model yang diterima, satu juta token yang dilayani, batch yang berhasil, atau respons yang memenuhi latensi. Harga per jam saja tidak lengkap.
Intinya
Untuk h100 vs a100, H100 adalah pilihan performa dan A100 sering kali menjadi pilihan nilai. H100 menang ketika fitur Hopper mengurangi waktu penyelesaian cukup besar untuk mengalahkan premi per jam. A100 menang ketika beban kerja stabil, pemanfaatan tidak sempurna, selisih harga lebar, atau latensi bukan batasan.
Sebelum Anda memesan salah satu GPU, benchmark model Anda sendiri, putar ulang traffic Anda sendiri, dan hitung biaya per pekerjaan yang selesai. Itulah satu-satunya perbandingan H100 vs A100 yang tahan terhadap tinjauan pengadaan.


