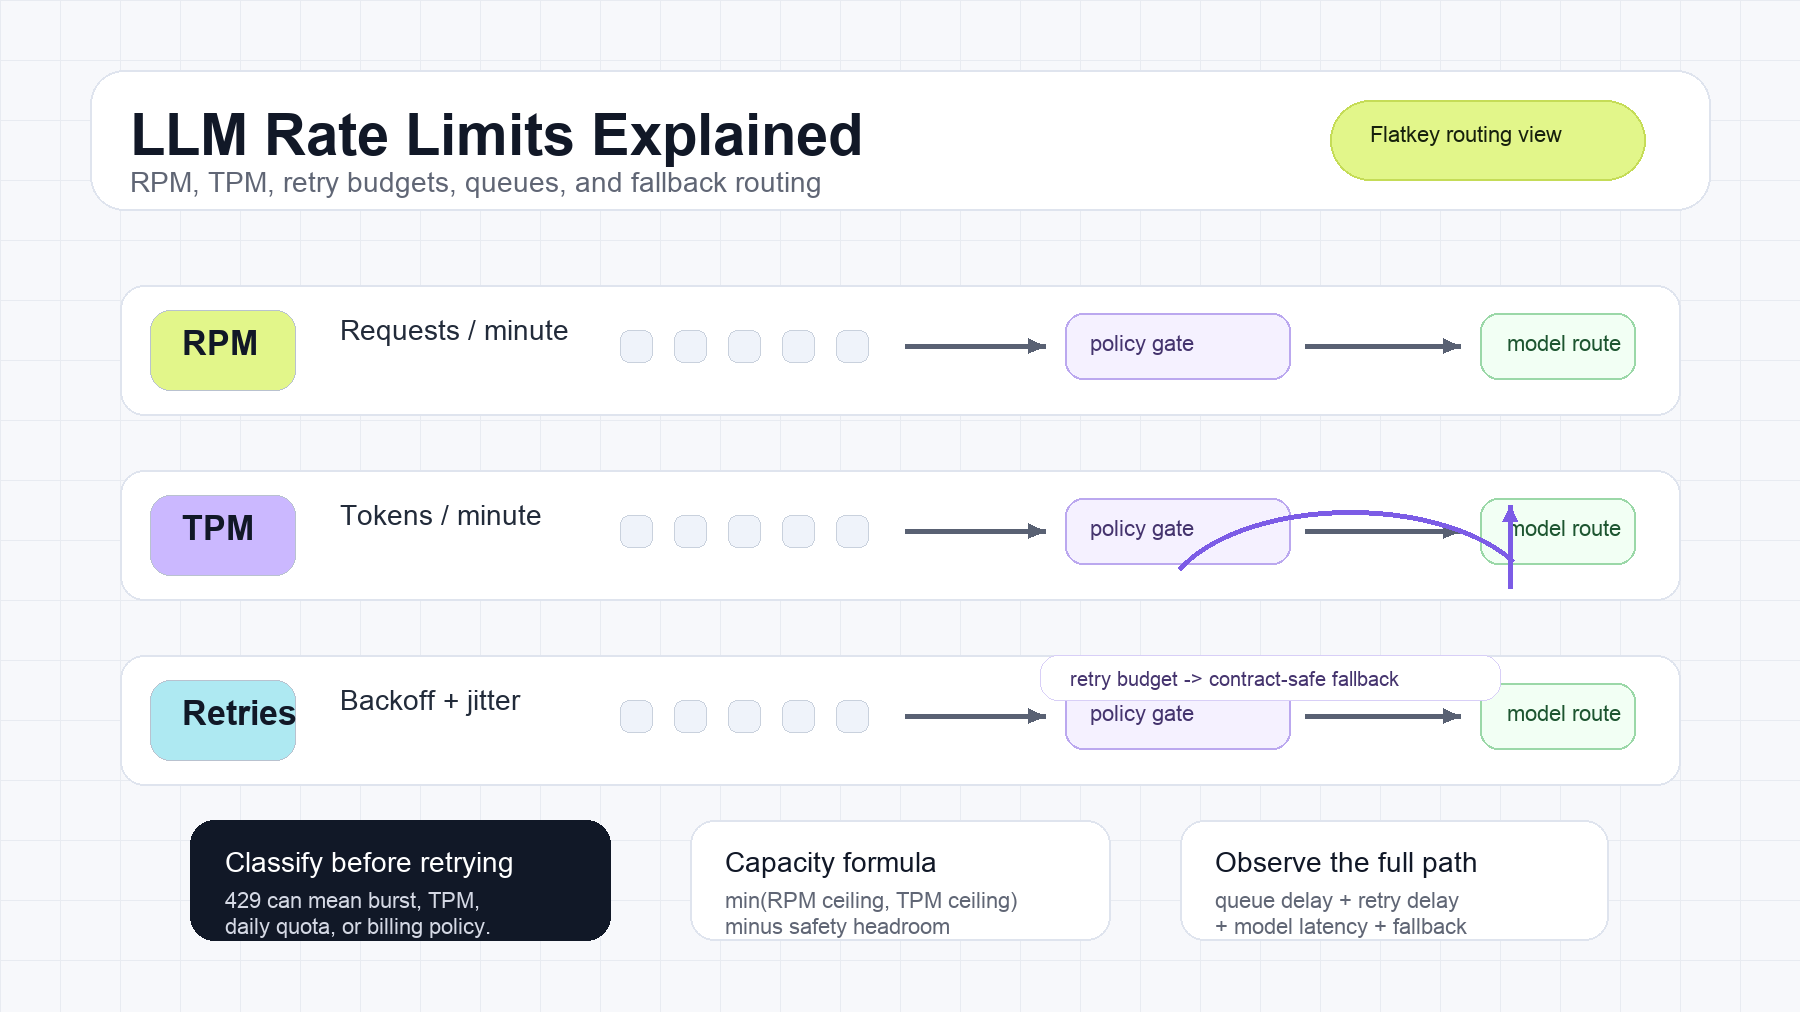
LLM レート制限の解説: RPM、TPM、リトライは、SDK の設定というより先に、本番の信頼性に関する話題です。レート制限は、一定の時間枠内でアプリケーションがプロバイダーやゲートウェイに対してどれだけのリクエスト、トークン、ジョブ、または同時生成を通せるかを決めます。リトライは、制限に達したときに何が起こるかを決めます。誤ったリトライポリシーは、小さなバーストを継続的な障害に変えてしまう可能性があります。
実践的なルールはシンプルです。RPM はリクエスト頻度を制御し、TPM はトークンのスループットを制御し、同時実行数は処理中の作業を制御し、リトライは制限されていなければ同じ希少な容量を消費します。 本番システムは、まず制約されているリソースを特定し、そのうえで、間隔を空ける、キューに入れる、トークンを減らす、短くリトライする、または契約互換の別モデルにルーティングするかを選ぶべきです。
このガイドでは、LLM レート制限の解説: RPM、TPM、リトライ を、AI プロダクトチームおよびプラットフォームチーム向けの運用プレイブックとして扱います。用語、容量計算、リトライポリシー、可観測性の項目、そして LLM API のレート制限が顧客インシデントにならないようにする Flatkey 風のゲートウェイ制御を解説します。
LLM レート制限の解説: RPM、TPM、リトライの要点
LLM のレート制限インシデントを切り分けるときは、この表を使ってください。
| シグナル | 測定対象 | 典型的な症状 | 最初の制御 |
|---|---|---|---|
| RPM | 1 分あたり、またはプロバイダー定義のウィンドウで受け入れられるリクエスト数 | 多数の小さな呼び出しが 429 で失敗する |
リクエストの間隔を空ける、バーストをキューに入れる、小さなタスクをまとめる |
| TPM | 1 分あたり、またはウィンドウ内で受け入れられる入力および/または出力トークン数 | 長いプロンプト、長い出力、または評価実行がスロットリングされる | トークンを予約する、コンテキストを短くする、出力を上限設定する |
| RPD / TPD | 1 日あたりに受け入れられるリクエスト数またはトークン数 | クォータがリセットされるまで作業が停止する | リトライを止める、再スケジュールする、より高いティアを申請する |
| 同時実行数 | 同時に処理中のリクエスト数またはジョブ数 | 控えめな RPM でも遅い生成が滞留する | ワーカー数を制限する、バックプレッシャーを追加する |
| リトライ予算 | 失敗後に呼び出し側が追加で消費できる作業量 | リトライストーム、レイテンシ増大、重複する副作用 | 試行回数、経過時間、リトライ可能なステータスを上限設定する |
| フォールバックルート | 代替可能なモデルまたはプロバイダー | メイン経路は制約されているが、プロダクトは依然として出力を必要とする | 機能、ポリシー、コストが適合するときだけルーティングする |
LLM レート制限の解説: RPM、TPM、リトライ の要点は、1 つの運用判断に集約されます。盲目的にリトライしないことです。429 は、同じリクエストをすぐに再送するよう命じるものではありません。どれか 1 つの容量バケット、クォータポリシー、課金状態、またはプロバイダーの保護機構がそのリクエストを拒否した、というシグナルです。
なぜレート制限が存在するのか
プロバイダーは、共有キャパシティを保護し、暴走するアカウントを防ぎ、課金やサービスティアのポリシーを一貫させるために LLM API のレート制限を適用します。OpenAI、Anthropic、Gemini はいずれもレート制限の概念を文書化していますが、バケット名、スコープ、ヘッダー、ダッシュボードはそれぞれ異なります。OpenAI はレート制限を文書化し、クライアントに対してバックオフで制限エラーを処理するよう推奨しています。Anthropic は、リクエスト数とトークン数を含み得るモデルレベルのレート制限に加え、組織およびワークスペースの支出制限を文書化しています。Gemini は、リクエスト、トークン、日次制限の概念を含むティアを文書化しています。
これらのプロバイダー側の制御は必要ですが、完全なプロダクトポリシーではありません。通常、それらはプロバイダー側の問い、つまり「このプロジェクトは今、もっとトラフィックを送れるか?」に答えます。アプリケーションは引き続き、プロダクト側の問いに答える必要があります。
- どの顧客、ワークスペース、チーム、または機能がバーストを引き起こしたか?
- 制約されているリソースは、リクエスト数、入力トークン、出力トークン、同時実行数、日次クォータ、または支出のどれか?
- このワークロードは待つべきか、性能を落とすべきか、処理量を下げるべきか、それとも即失敗させるべきか?
- フォールバックルートは、機能、データポリシー、価格、顧客契約の観点で許可されているか?
- リトライは制限を悪化させていないか?
関連するクォータ制御については、この記事に AI API のクォータ管理 と AI API の支出管理 を組み合わせてください。
RPM、TPM、同時実行数は異なる制限である
チームはしばしばレート制限を 1 つの数値として扱います。それでは本当のボトルネックが見えません。
RPM: 1 分あたりのリクエスト数
RPM は、プロバイダー定義の時間ウィンドウ内で受け入れられるリクエスト数を制限します。小さなプロンプト、ヘルスチェック、エージェントのツールループ、高ファンアウトの評価ジョブは、通常まず RPM に圧力をかけます。ワークロードが TPM を大きく下回っていても、あまりに多くの小さな呼び出しを送れば RPM に達することがあります。
TPM: 1 分あたりのトークン数
TPM はトークンのスループットを制限します。プロバイダーとモデルによっては、入力トークン、出力トークン、キャッシュ済みトークン、または入力と出力の別バケットを対象にする場合があります。長文コンテキストの検索、会話履歴、冗長な出力、複数候補の生成、並列評価は、通常 RPM より先に TPM に圧力をかけます。
同時実行数: 処理中の作業
同時実行数は RPM ではありません。1 分あたり 60 リクエストしか送れなくても、各生成に 20 秒かかるなら、システムの同時実行数は高くなりえます。ストリーミングや長時間実行のツール呼び出しで、これが明らかになります。ワーカープールとキューの深さを制限することは、リトライを増やすより優れた制御であることが多いです。
日次制限と支出制限
一部の制限は短い待機では回復しません。1日あたりのリクエスト制限、1日あたりのトークン制限、月間支出制限、請求上の制約は、通常リトライを停止すべきです。適切な対応は、再スケジュールする、ティアを引き上げる、予算を調整する、またはユーザーにキャパシティが尽きたことを伝えることです。
見出しの上限未満でも 429 が返る理由
「1,000 RPM」のように公開されている制限は、クライアントが分単位の最初の1秒に 1,000 リクエスト送信できることをほとんど意味しません。プロバイダーは、ローリングウィンドウ、トークンバケット、モデルプール、ティア固有のバーストルール、加速制限、または共有プロジェクトクォータを適用できます。
ローカルカウンター上では安全に見えても、リクエストに 429 Too Many Requests が返ることがあります。その理由は次のとおりです。
- 複数のワーカー、ユーザー、サービス、または環境が同じアカウント制限を共有している。
- 入力トークンと出力トークンが別々のバケットでカウントされる。
- あるモデルが別のモデルよりも小さいプールを持っている。
- 以前の失敗からのリトライが、まだリクエスト容量を消費している。
- トラフィックの立ち上がりが急すぎて、加速制御に引っかかっている。
- 日次、支出、ワークスペース、またはサービスティアのルールが有効になっている。
- プロバイダーが複数のキャパシティポリシーに対して汎用的な
429を返す。
そのため、LLM レート制限の解説: RPM、TPM、リトライ は、コードよりもまず分類から始めるべきです。利用可能であれば、ステータスコード、プロバイダーのエラー種別、レスポンスヘッダー、モデル、アカウントまたはプロジェクト、トークン見積もり、実トークン数、試行回数、キュー遅延、プロバイダーのリクエスト ID をログに記録してください。
キャパシティ計画の式
リクエストとトークンの独立した上限から始め、最大値を下回って運用します。
request_ceiling = RPM * safety_factor

token_ceiling = (TPM * safety_factor) / average_total_tokens_per_request

safe_requests_per_minute = min(request_ceiling, token_ceiling)
トークンのばらつき、共有利用者、リトライ挙動、そして見逃したレイテンシ目標がどれだけ高コストかに応じて、0.70 から 0.90 のような安全係数を使用します。
例:
RPM = 1,000
TPM = 2,000,000
average_total_tokens_per_request = 4,000
safety_factor = 0.80

request_ceiling = 1,000 * 0.80 = 800 requests/minute

token_ceiling = (2,000,000 * 0.80) / 4,000 = 400 requests/minute

safe_requests_per_minute = min(800, 400) = 400 requests/minute
この例では、制約要因は TPM です。ワーカーを増やしても持続可能なスループットは増えません。増えるのは、キューイング、リトライ、または 429 エラーです。
オンラインシステムでは、安全なリクエストレートを並行実行数の初期値に変換します。
target_concurrency ~= requests_per_second * average_request_seconds
安全レートが 1 分あたり 400 リクエストなら、これは約 1 秒あたり 6.67 リクエストです。平均モデルレイテンシが 3 秒なら、初期並行数は約 20 です。平均値だけでなく、p95 と p99 のレイテンシに対して調整してください。
TPM 安全性のためのトークン予約
TPM インシデントは、楽観的なスケジューリングから生じることがよくあります。アプリケーションは期待トークン数を基に作業を受け入れますが、モデルが想定より長い出力を返します。
より安全なスケジューラは、リクエスト送信前にトークンを予約します。
reservation:
  workload: support_answer
  model_route: primary_chat_route
  request_id: req_8f3a
  estimated_input_tokens: 3200
  max_output_tokens: 900
  reserved_total_tokens: 4100
  reservation_expires_at: 2026-10-10T11:03:00Z
レスポンス後は、予約トークンと実トークンを突き合わせます。
actual_usage:
  input_tokens: 3014
  output_tokens: 622
  total_tokens: 3636
  retry_attempts: 0
  accepted_result: true
本番では、p95 またはワークロード固有の見積もりに対して予約してください。実際の使用量は、コスト配賦と予測に使用します。この分離により、LLM API のレート制限は運用しやすくなります。アドミッションコントロールは安全な見積もりを使い、財務とプロダクトレビューは受け入れ済み結果あたりの実コストを確認します。
レート制限の判定ツリー
リクエストが拒否されたり、キューが増えたりした場合は、原因に応じて制御方法を決めます。
Did the provider return Retry-After or a reset header?
  yes -> wait for the hint if it fits the caller latency budget
  no  -> use bounded exponential backoff with jitter for transient classes

Is the cause daily quota, billing, permission, or hard spend limit?
  yes -> do not retry; fail, reschedule, or request capacity
  no  -> continue

Is RPM the binding constraint?
  yes -> pace requests, batch small work, or queue low priority traffic
  no  -> continue

Is TPM the binding constraint?
  yes -> shorten context, cap output, reserve tokens, or delay long jobs
  no  -> continue

Is concurrency the binding constraint?
  yes -> reduce workers, set queue deadlines, and apply backpressure
  no  -> continue

Is an eligible fallback route healthy and policy-approved?
  yes -> route after the retry budget is spent
  no  -> return a controlled failure
この判定ツリーは、LLM レート制限の解説: RPM、TPM、リトライ の価値ある資産です。これにより 429 処理が無限ループになるのを防ぎ、LLM レート制限の解説: RPM、TPM、リトライ を定義の話題からインシデント対応ワークフローへと変えます。
Retry-After の使い方
HTTP の Retry-After は、クライアントに次のリクエストを送るまでの待機時間を示します。RFC では、これは秒単位の遅延または HTTP 日付のいずれかとして定義されています。MDN の 429 Too Many Requests のリファレンスでも、クライアントがいつ再試行できるかを示すために Retry-After を使うことが説明されています。
実践的なルール:
- 呼び出し元のレイテンシ予算に収まる有効な
Retry-Afterは尊重する。 - 対話型の呼び出しでは非常に長い値に上限を設ける。ユーザー要求をいつまでも開いたままにしない。
- 無効または欠落した値は、クライアント側のバックオフを使う理由として扱う。
Retry-Afterがないからといって、再試行できない原因を再試行しない。- プロバイダーのヒントと、実際に使った遅延時間の両方を記録する。
対話型のユーザーフローでは、再試行予算はプロバイダーのヒントより小さいことがよくあります。その場合は、わかりやすいメッセージで素早く失敗させるか、別の経路に回します。バッチ処理では、エラーを返すよりもキューイングの方が適している場合があります。
ジッター付き指数バックオフ
指数バックオフは、失敗するたびに待機時間を増やします。ジッターはその待機時間をランダム化し、ワーカーが同時に再試行して集中しないようにします。AWS のバックオフとジッターのガイダンスは、上限付きの単純な指数バックオフでは、ランダム性がないと再試行がなおも集中し得る理由を説明しているため有用です。
よく使われるフルジッターの式:
delay_ms = random(0, min(cap_ms, base_ms * 2^attempt))
本番の再試行ポリシーには、待機時間の式以上のものが必要です:
| ポリシーフィールド | 推奨制御 |
|---|---|
| 再試行可能なステータス | 429、選択した 5xx、および一時的なネットワーク障害 |
| 再試行不可なステータス | 検証エラー、認証エラー、権限エラー、課金エラー、日次クォータ枯渇 |
| 最大試行回数 | 対話型呼び出しでは少数。大きくするのはオフラインジョブのみ |
| 最大経過時間 | ユーザーが見えるレイテンシ予算またはジョブの期限で制約する |
| ジッター | 複数ワーカーのシステムでは必須 |
| Retry-After | 有効で、かつ許容できる場合に使う |
| キャンセル | 呼び出し元が中断したら直ちに停止する |
| 可観測性 | 試行回数、待機時間、最終ステータス、リクエスト ID、キュー遅延 |
失敗したリクエストでもレート制限の容量を消費することがあります。だからこそ、再試行は後付けではなく、レート制限設計の一部でなければなりません。
OpenAI 互換 API 向け TypeScript 再試行ヘルパー
このヘルパーは、Retry-After がある場合はそれを使い、なければフルジッターを使います。試行回数または経過時間を使い切ると停止します。
type ChatRequest = {
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  max_tokens?: number;
};

const sleep = (milliseconds: number) =>
  new Promise((resolve) => setTimeout(resolve, milliseconds));

function retryAfterMilliseconds(response: Response): number | null {
  const value = response.headers.get("retry-after");
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) return Math.max(0, seconds * 1_000);

  const date = Date.parse(value);
  return Number.isNaN(date) ? null : Math.max(0, date - Date.now());
}

export async function createChatCompletion(
  apiKey: string,
  request: ChatRequest,
  options: { maxAttempts?: number; maxElapsedMs?: number } = {},
) {
  const maxAttempts = options.maxAttempts ?? 4;
  const maxElapsedMs = options.maxElapsedMs ?? 30_000;
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt += 1) {
    const response = await fetch("https://router.flatkey.ai/v1/chat/completions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify(request),
    });

    if (response.ok) return response.json();

    const retryable = response.status === 429 || response.status >= 500;
    const finalAttempt = attempt === maxAttempts - 1;
    if (!retryable || finalAttempt) {
      throw new Error(`LLM request failed with ${response.status}: ${await response.text()}`);
    }

    const serverDelay = retryAfterMilliseconds(response);
    const exponentialCap = Math.min(8_000, 500 * 2 ** attempt);
    const jitteredDelay = Math.random() * exponentialCap;
    const delayMs = serverDelay ?? jitteredDelay;

    if (Date.now() + delayMs - startedAt >= maxElapsedMs) {
      throw new Error("LLM retry budget exhausted");
    }

    await sleep(delayMs);
  }

  throw new Error("Unreachable retry state");
}
本番で使用する前に、リクエストタイムアウト、構造化されたエラークラス、テレメトリ、キャンセルを追加してください。呼び出しが外部への副作用を発生させる可能性がある場合は、再試行する前に業務処理を冪等にしてください。
再試行、キュー、削減、それともルーティング?
回復力のあるシステムには、スロットリングに対する応答が 1 つだけではありません。
| 状況 | リトライ | キュー | トークン削減 | 別ルートへ振り分け |
|---|---|---|---|---|
短時間の一時的な 429 が1回発生 |
はい、上限付きで | 任意 | いいえ | 通常は不要 |
| 継続的な RPM 枯渇 | 非常に限定的 | はい | 通常は不要 | 場合による |
| 継続的な TPM 枯渇 | 非常に限定的 | はい | はい | 場合による |
| 日次クォータの消化 | いいえ | 後でリセットされることが許容できる場合のみ | いいえ | 場合による |
| 課金または権限エラー | いいえ | いいえ | いいえ | いいえ、まずアクセスを修正する |
| 代替先が健全な状態でプロバイダーが過負荷 | 短時間なら | 任意 | いいえ | はい、ポリシーチェック後に |
| 部分的なストリームがすでに配信済み | 通常は再生しない | 継続または明示的に再開する場合もある | 場合による | 明確なセマンティクスがある場合のみ |
処理を待てる場合、キューイングはプロバイダーとユーザー体験を守ります。トークン削減は TPM を保護します。ルーティングは、代替ルートが同じプロダクト契約を満たす場合にのみ可用性を守ります。
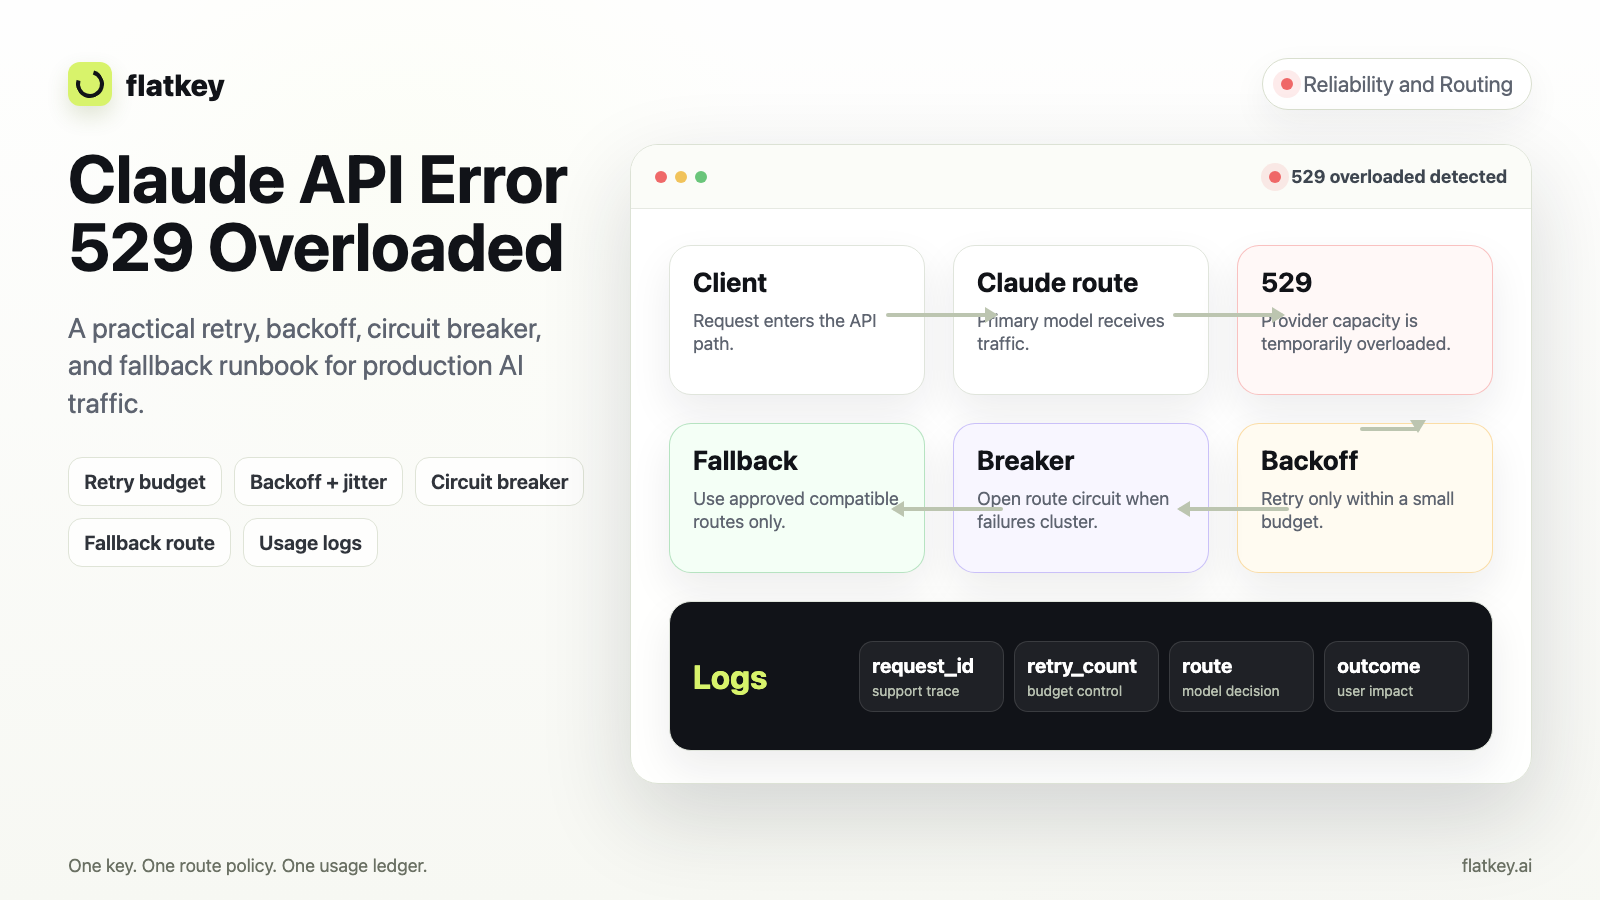
過負荷固有のパターンについては、API Error 529 overloaded のプレイブックを使ってください。コスト面の影響については、リトライとフォールバックの挙動を AI gateway pricing および how to compare AI model prices に結び付けて考えてください。
モデル評価におけるレート制限
レート制限はモデル比較を無効にすることがあります。
モデル A を 10 ワーカーでテストし、モデル B を 100 ワーカーでテストした場合、ハーネスがキューイングとリトライを引き起こしたために、モデル B のほうが遅く見えることがあります。その測定は、モデルのレイテンシよりもテスト構成について多くを語っています。
妥当性のある評価のためには、以下を行ってください。
- モデルのレイテンシ、キュー遅延、リトライ遅延を分離する。
- 各ルートで同じ到着プロセス、または正規化された利用率レベルを使う。
- プロバイダーがアクセラレーション制御を使う場合は、トラフィックを段階的にウォームアップする。
- 完了したタスクごとのトークン数と試行回数を記録する。
- 初回成功率と最終的な成功率を分けて報告する。
- トークン単価だけでなく、受理されたタスクあたりのコストを比較する。
- 品質テストとは別に過負荷テストを実行する。
これは無料または低価格帯のアカウントでは特に重要です。free LLM APIs の記事は有用な背景情報です。無料枠は多くの場合、本番負荷ではなく試用向けに設計されています。
アラート対象のメトリクス
以下をプロバイダー、モデル、ルート、テナント、ワークロード、環境ごとに追跡してください。
- 1分あたりのリクエスト数。
- 1分あたりの入力トークン数と出力トークン数。
- 見積もり上の予約トークンと実際に使用したトークン数。
- キュー深度と、キュー内で最も古い項目の経過時間。
- レート容量を待つ時間。
- 初回成功率。
- 成功したリクエストあたりのリトライ回数。
- 分類された原因ごとの
429発生率。 - リトライ増幅率: 総試行回数 ÷ 成功結果数。
- フォールバック率とフォールバック結果。
- エンドツーエンドの p50、p95、p99 レイテンシ。
- 成功または受理されたタスクあたりのコスト。
OpenTelemetry の生成 AI セマンティック規約は、モデル、操作、トークン、応答、エラーテレメトリの標準化に役立ちます。さらに、顧客、ワークスペース、トラフィッククラス、環境、機能、所有者といった製品固有の次元も保持してください。
429 の総数だけに対するアラートはノイズが多いです。より良いシグナルは、スロットリング率、キュー滞留時間、リトライ増幅率、最終失敗率を組み合わせたものです。
本番向けレート制限アーキテクチャ
堅牢なリクエスト経路には通常、7つの制御レイヤーがあります。
client
  -> admission control
  -> priority queue
  -> token reservation
  -> RPM + TPM limiter
  -> provider/model route
  -> bounded retry controller
  -> contract-safe fallback
  -> usage, cost, and latency ledger
キューが呼び出し元の期限に間に合わない場合は、admission control を使います。重要でない評価が本番トラフィックを押し出さないように、優先度キューを使います。TPM を正確に保つためにトークン予約を使います。SDK、キュー、ゲートウェイ、ワーカーレイヤーがそれぞれ独立してリトライしないよう、中央集約型のリトライコントローラーを使います。
利用台帳には次を記録する必要があります。
rate_limit_event:
  request_id: req_8f3a
  workspace_id: ws_42
  environment: production
  workflow: support_answer
  route_requested: primary_chat_route
  route_final: fallback_chat_route
  estimated_input_tokens: 3200
  max_output_tokens: 900
  actual_input_tokens: 3014
  actual_output_tokens: 622
  attempt_count: 2
  retry_delay_ms: 740
  queue_delay_ms: 1180
  final_status: success
  classified_limit: transient_rpm_burst
  accepted_result: true
これにより、LLM API のレート制限はインシデント後にレビュー可能になります。また、リトライやフォールバックが受理結果あたりのコストを変えた場合に、財務チームとプロダクトチームが必要とする証拠にもなります。
Flatkey の役割
Flatkey は、対応モデルルート向けに 1 つの API キーと OpenAI 互換のベース URL をチームに提供します。これにより上流の LLM レート制限がなくなるわけではありません。代わりに、ルーティング、利用状況のレビュー、ポリシーをプロバイダー間で一貫させられる 1 つの統合面を提供します。
LLM レート制限の解説: RPM、TPM、リトライ のワークフローでは、ゲートウェイ層は次のような場合に役立ちます。
- アプリケーションには、サービス全体に散在するプロバイダーごとのロジックではなく、単一のリトライ、キュー、フォールバック方針が必要です。
- プロダクトチームは、ルートの健全性、レイテンシ、トークン、承認済み結果のコストを 1 つの台帳で比較する必要があります。
- プラットフォームチームは、環境またはワークフローごとのモデル許可リスト、サブキー予算、使用制御を必要としています。
- 財務部門は、分断されたプロバイダーダッシュボードではなく、1 つの残高、請求書、リクエストレベルの証跡を必要としています。
- オペレーターは、ルートが制約されているときに、アプリケーション SDK を書き換えずに適格なトラフィックを移動できる必要があります。
それでもゲートウェイは、モデル固有の契約を保持するべきです。コンテキストウィンドウ、ツールの動作、構造化出力、安全ポリシー、データ制御、レイテンシ、コストがそのワークロードに対して許容できる場合を除き、あるモデルから別のモデルへルーティングしないでください。本番リリース前に、Flatkey モデルディレクトリとFlatkey の価格表で現在のルート可用性と価格を確認してください。
よくある間違い
RPM を同時実行数として扱う
RPM は、時間あたりの受け入れ数を測定します。同時実行数は、進行中の作業量を測定します。生成が遅いと、RPM がそれほど高くなくても同時実行数が高くなることがあります。
すべての 429 を即座にリトライする
即時リトライはワーカーを同期させ、より多くの容量を消費します。有効な場合は Retry-After を尊重し、ジッターを追加し、リトライ予算を上限で制限してください。
すべてのモデルに 1 つのリミッターを使う
プロバイダーは、モデルごとの個別プールや共有アカウントプールを使用する場合があります。リミッターは、文書化されたクォータの範囲と、観測されたレスポンスヘッダーに従うべきです。
共有コンシューマーを無視する
ダッシュボード、評価ランナー、コーディングエージェント、本番 API が 1 つのプロジェクトを共有することがあります。ワークロードごとに容量を確保し、可能な場合は重要なトラフィックを分離してください。
部分ストリームをリトライする
一度トークンがユーザーに届いた、またはツールアクションが実行された後にサイレント再実行すると、出力や副作用が重複する可能性があります。継続、再開、または冪等性のセマンティクスを明示的に定義してください。
プロバイダーのレイテンシだけを測定する
エンドユーザーのレイテンシには、キュー遅延、リトライ遅延、フォールバック遅延、モデルレイテンシが含まれます。全体経路でアラートを出し、各要素は分けて保持してください。
FAQ
RPM と TPM の違いは何ですか?
RPM は、一定時間内に何件のリクエストが受け入れられるかを制限します。TPM は、何個の入力トークンおよび/または出力トークンが受け入れられるかを制限します。短いプロンプトでは通常まず RPM に達し、長文コンテキストや高出力のワークロードでは TPM に先に達することが多いです。
RPM 制限に達していないのに 429 エラーが出るのはなぜですか?
プロバイダーは、ローリングウィンドウ、トークンバケット、共有アカウントクォータ、別個のトークン制限、モデル固有プール、日次制限、または加速制御を適用している場合があります。ローカルのリクエストカウンターは、クォータ範囲全体を表していない可能性があります。
すべての 429 をリトライすべきですか?
いいえ。短時間のスロットリングは、小さな予算とジッター付きでリトライしてください。日次クォータ枯渇、請求制限、権限エラー、検証エラー、または現実的な回復見込みのない持続的な過負荷は、繰り返しリトライしないでください。
指数バックオフは成功を保証しますか?
いいえ。バックオフは衝突を減らし、一時的な容量が回復する時間を与えますが、クォータを増やすことはできません。枯渇が続く場合は、需要を下げる、容量を増やす、作業を遅らせる、または別の適格ルートを使う必要があります。
リトライはレート制限にカウントされますか?
カウントされる場合があります。プロバイダーは、失敗したリクエストや試行をアクティブな制限に算入することがあるため、リトライの増幅は監視し、上限を設ける必要があります。
LLM リクエストは何回リトライすべきですか?
普遍的な回数はありません。ユーザーに見えるレイテンシ予算と失敗モードから試行回数を決めてください。対話型アプリケーションは通常、失敗またはルーティングする前に、短い試行を数回行うだけで十分です。オフラインジョブは、より長いキューを許容できます。
最終チェックリスト
本番環境で LLM レート制限の解説: RPM、TPM、リトライ を実装する際は、次のチェックリストを使用してください:
- モデルの RPM、TPM、日次制限、支出上限、同時実行数を個別に管理する。
- リクエスト上限とトークン上限の最小値から容量を計算する。
- 安全係数をかけて、公開上限より低く運用する。
- 変動幅の大きいリクエストを送信する前にトークンを予約する。
- 継続的な負荷にはキューとペーシングを使用する。
- 有効で負担可能な場合は
Retry-Afterを尊重する。 - 有効なサーバーのヒントがない場合は、ジッター付きの指数バックオフを使う。
- 試行回数と総リトライ時間に上限を設ける。
- クォータ、請求、権限、検証エラーではリトライを停止する。
- 部分ストリームや冪等でない副作用を再実行しない。
- 必要なプロダクト契約を維持できるモデルのみにルーティングする。
- 評価では、キュー遅延とリトライ遅延をモデルレイテンシから分離する。
- 生の
429件数だけでなく、リトライ増幅とキュー滞留時間に対してアラートを出す。 - リクエスト ID、トークン推定値、実トークン数、試行回数、フォールバックルート、最終結果を使用台帳に記録する。
レート制限は、エラーメッセージである前にキャパシティ計画の制御です。LLM レート制限の解説: RPM、TPM、リトライ から得られる持続的な要点は、リクエスト頻度、トークンスループット、同時実行数、リトライ、フォールバック結果を独立して測定し、429 を本番ノイズではなく実行可能なシグナルにすることです。
出典
- OpenAI のレート制限ドキュメント: https://platform.openai.com/docs/guides/rate-limits
- OpenAI Cookbook、レート制限の扱い方: https://cookbook.openai.com/examples/how_to_handle_rate_limits
- Anthropic のレート制限: https://docs.anthropic.com/en/api/rate-limits
- Gemini API のレート制限: https://ai.google.dev/gemini-api/docs/rate-limits
- RFC 9110 Retry-After: https://www.rfc-editor.org/rfc/rfc9110.html#name-retry-after
- MDN 429 Too Many Requests: https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429
- AWS Architecture Blog、指数バックオフとジッター: https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- OpenTelemetry の生成 AI セマンティック規約: https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Flatkey の価格: https://flatkey.ai/pricing
- Flatkey のモデルディレクトリ: https://flatkey.ai/models