LLM 速率限制详解:RPM、TPM 与重试首先是一个生产可靠性话题,其次才是一个 SDK 设置。速率限制决定了你的应用在一个时间窗口内能通过提供商或网关发出多少请求、处理多少 token、执行多少作业或并发生成多少结果。重试决定了当触及限制时会发生什么。错误的重试策略会把一次小幅突发变成持续性中断。
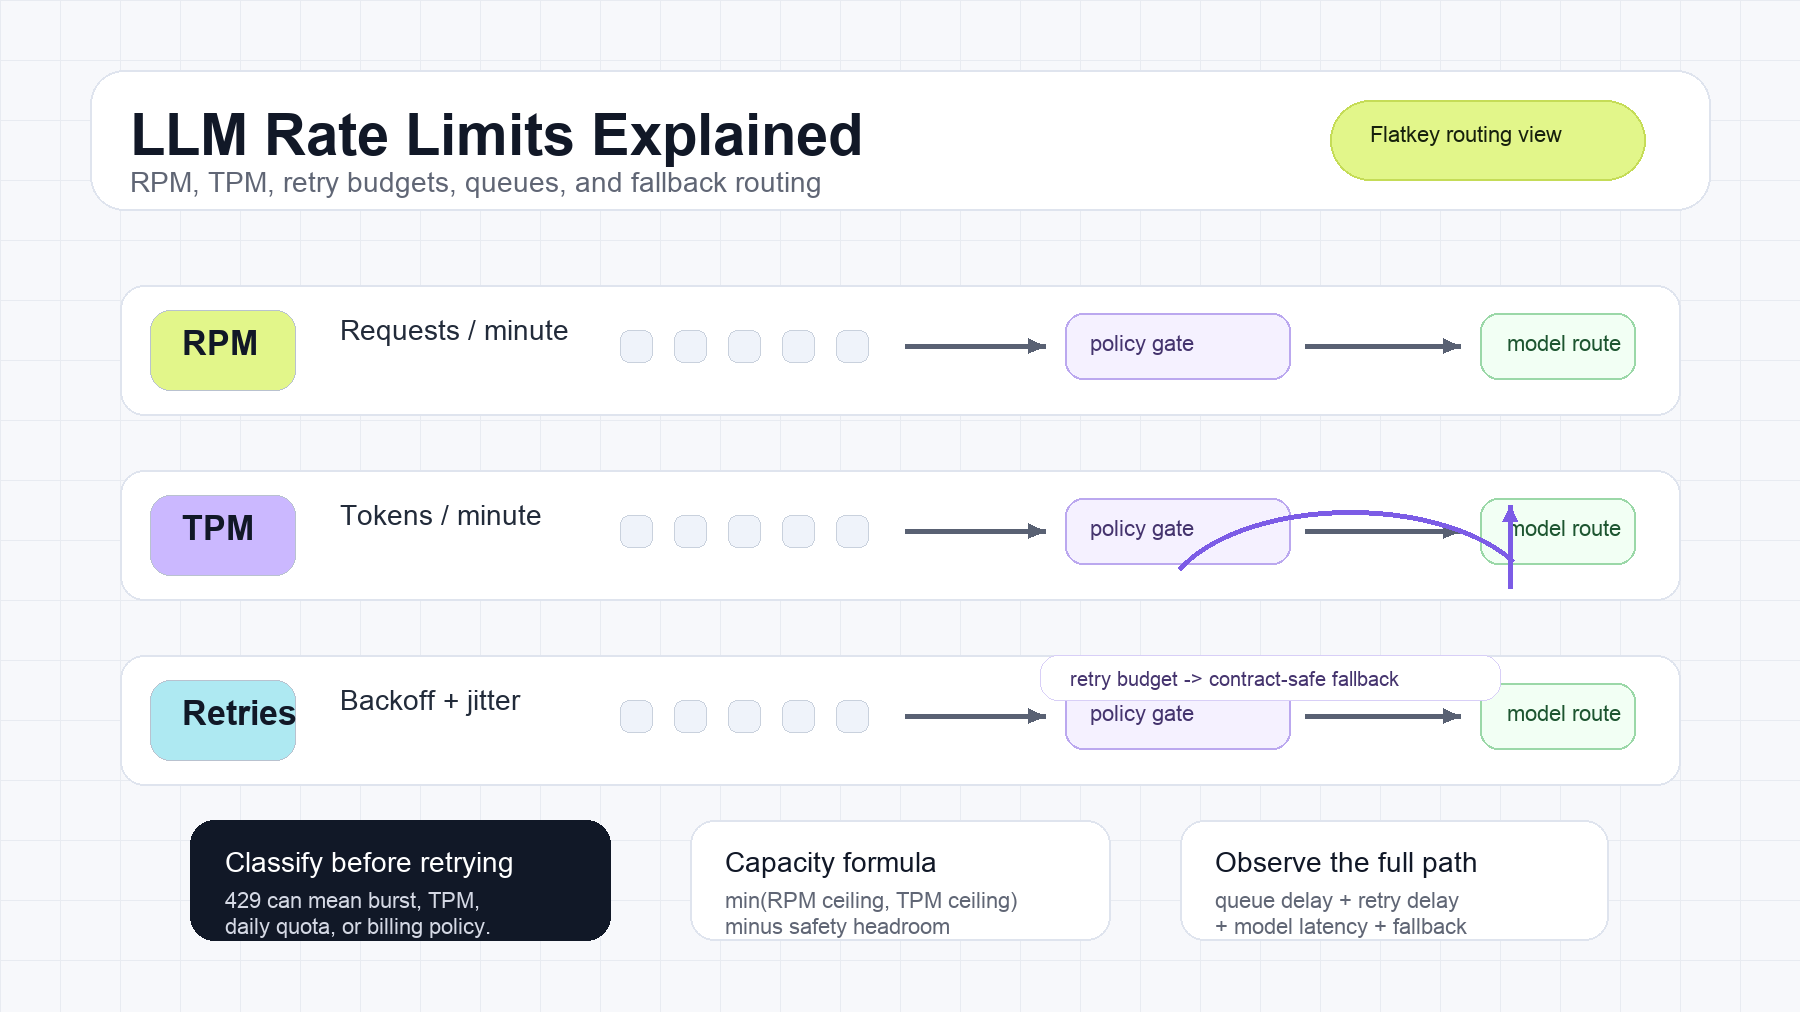
实用规则很简单:RPM 控制请求频率,TPM 控制 token 吞吐量,并发控制在途工作,而重试会消耗同样稀缺的容量,除非它们是有上限的。 生产系统应先识别受限资源,再在限速、排队、减少 token、短暂重试或路由到另一个兼容契约的模型之间做选择。
本指南将 LLM 速率限制详解:RPM、TPM 与重试 视为 AI 产品和平台团队的运行手册。它涵盖术语、容量计算、重试策略、可观测性字段,以及 Flatkey 风格的网关控制,这些都能防止 LLM API 速率限制演变为客户事故。
LLM 速率限制详解:RPM、TPM 与重试 快速答案
当你在处理一次 LLM 速率限制事件时,可使用此表。
| 信号 | 它衡量什么 | 典型症状 | 首要控制措施 |
|---|---|---|---|
| RPM | 每分钟或提供商定义窗口内允许的请求数 | 大量小请求失败并返回 429 |
控制请求节奏,排队突发流量,批处理小任务 |
| TPM | 每分钟或窗口内允许的输入和/或输出 token 数 | 长提示词、长输出或评估运行被限流 | 预留 token、缩短上下文、限制输出 |
| RPD / TPD | 每天允许的请求数或 token 数 | 工作停止,直到配额重置 | 停止重试、重新安排、申请更高档位 |
| 并发 | 同时在途的请求或作业数 | 即使 RPM 不高,缓慢生成也会堆积 | 限制工作线程,增加背压 |
| 重试预算 | 调用方在失败后允许额外消耗多少工作量 | 重试风暴、延迟膨胀、重复副作用 | 限制尝试次数、耗时和可重试状态 |
| 回退路由 | 符合条件的替代模型或提供商 | 主路由受限,但产品仍需要输出 | 仅在能力、策略和成本匹配时路由 |
LLM 速率限制详解:RPM、TPM 与重试最终归结为一个运行决策:不要盲目重试。429 不是立即再次发送同一请求的指令。它表示某个容量桶、配额策略、计费状态或提供商保护机制拒绝了该请求。
为什么会有速率限制
提供商实施 LLM API 速率限制,是为了保护共享容量、防止账户失控增长,并保持计费或服务层级策略一致。OpenAI、Anthropic 和 Gemini 都记录了速率限制概念,但它们公开的桶名称、作用域、标头和仪表板各不相同。OpenAI 文档说明了速率限制,并建议客户端通过退避来处理限制错误。Anthropic 文档说明了组织和工作区的支出限制,以及可能包含请求和 token 的模型级速率限制。Gemini 文档说明了包含请求、token 和每日限制概念的层级。
这些提供商控制是必要的,但它们并不是完整的产品策略。它们通常回答的是提供商侧问题:“这个项目现在还能发送更多流量吗?” 你的应用仍然需要回答产品侧问题:
- 是哪个客户、工作区、团队或功能导致了突发流量?
- 受限资源是请求数、输入 token、输出 token、并发、每日配额,还是支出?
- 这项工作负载应该等待、降级、降速,还是快速失败?
- 在能力、数据策略、价格和客户合同上,是否允许使用回退路由?
- 重试是否正在让限制变得更糟?
对于相邻的配额控制,可将本文与 AI API 配额管理 和 AI API 支出管理 配合阅读。
RPM、TPM 和并发是不同的限制
团队常把速率限制当作一个数字来看待。这会掩盖真正的瓶颈。
RPM:每分钟请求数
RPM 限制在提供商定义的时间窗口内允许的请求数量。小提示词、健康检查、代理工具循环以及高扇出评估任务通常首先给 RPM 施压。如果发送了太多小请求,即使远低于 TPM 也可能触发 RPM 限制。
TPM:每分钟 token 数
TPM 限制 token 吞吐量。根据提供商和模型的不同,该限制可能考虑输入 token、输出 token、缓存 token,或者分别设置输入和输出桶。长上下文检索、对话历史、冗长输出、多候选生成以及并行评估通常会先给 TPM 施压,而不是 RPM。
并发:在途工作
并发不是 RPM。一个系统每分钟只能发送 60 个请求,但如果每次生成需要 20 秒,仍然可能拥有很高的并发。流式输出和长时间运行的工具调用会让这一点显现出来。限制工作线程池和队列深度,通常比增加重试更有效。
每日限制和支出限制
某些限制不会在短暂休眠后恢复。每日请求限制、每日令牌限制、每月支出限制以及计费限制通常都应停止重试。正确的做法是重新安排、提升套餐层级、调整预算,或告知用户容量已耗尽。
为什么会在表面限制以下收到 429
像“1,000 RPM”这样的公开限制,几乎不意味着客户端可以在一分钟的第一秒发送 1,000 个请求。提供方可能会实施滑动窗口、令牌桶、模型池、按层级划分的突发规则、加速限制,或共享项目配额。
即使本地计数器看起来安全,请求仍可能收到 429 Too Many Requests,原因包括:
- 多个工作进程、用户、服务或环境共享同一个账户限制。
- 输入令牌和输出令牌计入不同的桶。
- 某个模型的配额池比另一个模型更窄。
- 早前失败的重试仍在消耗请求容量。
- 流量爬升过快,超出了加速控制的承受范围。
- 每日、支出、工作区或服务层级规则处于启用状态。
- 提供方为多种容量策略返回通用的
429。
这就是为什么 LLM 速率限制详解:RPM、TPM 与重试 应该从分类开始,而不是从代码开始。请记录状态码、提供方错误类型、响应头、模型、账户或项目、令牌估算、实际令牌、尝试次数、队列延迟,以及可用时的提供方请求 ID。
容量规划公式
先为请求和令牌分别设定独立上限,然后在低于最大值的范围内运行。
request_ceiling = RPM * safety_factor

token_ceiling = (TPM * safety_factor) / average_total_tokens_per_request

safe_requests_per_minute = min(request_ceiling, token_ceiling)
根据令牌波动、共享消费者、重试行为以及错过延迟目标的代价,使用诸如 0.70 到 0.90 之间的安全系数。
示例:
RPM = 1,000
TPM = 2,000,000
average_total_tokens_per_request = 4,000
safety_factor = 0.80

request_ceiling = 1,000 * 0.80 = 800 requests/minute

token_ceiling = (2,000,000 * 0.80) / 4,000 = 400 requests/minute

safe_requests_per_minute = min(800, 400) = 400 requests/minute
在这个例子中,TPM 是绑定约束。增加更多工作进程不会提高可持续吞吐量,只会带来更多排队、更多重试,或更多 429 错误。
对于在线系统,将安全请求速率换算为并发起始点:
target_concurrency ~= requests_per_second * average_request_seconds
如果安全速率是每分钟 400 个请求,那大约是每秒 6.67 个请求。如果模型平均延迟为 3 秒,起始并发数大约是 20。调优时应对照 p95 和 p99 延迟,而不只是平均值。
用于 TPM 安全性的令牌预留
TPM 事件通常源于乐观调度。应用根据预期令牌接收工作,但模型实际输出比计划更长。
更安全的调度器会在发送请求之前预留令牌:
reservation:
  workload: support_answer
  model_route: primary_chat_route
  request_id: req_8f3a
  estimated_input_tokens: 3200
  max_output_tokens: 900
  reserved_total_tokens: 4100
  reservation_expires_at: 2026-10-10T11:03:00Z
在收到响应后,将预留令牌与实际令牌进行对账:
actual_usage:
  input_tokens: 3014
  output_tokens: 622
  total_tokens: 3636
  retry_attempts: 0
  accepted_result: true
在生产环境中,应基于 p95 或按工作负载定制的估算来预留。使用实际用量进行成本归因和预测。这样的分离让 LLM API 速率限制更易运维:准入控制使用安全估算,而财务和产品审查则使用已接受结果的实际成本。
速率限制决策树
当请求被拒绝或队列增长时,应根据原因决定控制方式。
Did the provider return Retry-After or a reset header?
  yes -> wait for the hint if it fits the caller latency budget
  no  -> use bounded exponential backoff with jitter for transient classes

Is the cause daily quota, billing, permission, or hard spend limit?
  yes -> do not retry; fail, reschedule, or request capacity
  no  -> continue

Is RPM the binding constraint?
  yes -> pace requests, batch small work, or queue low priority traffic
  no  -> continue

Is TPM the binding constraint?
  yes -> shorten context, cap output, reserve tokens, or delay long jobs
  no  -> continue

Is concurrency the binding constraint?
  yes -> reduce workers, set queue deadlines, and apply backpressure
  no  -> continue

Is an eligible fallback route healthy and policy-approved?
  yes -> route after the retry budget is spent
  no  -> return a controlled failure
这个决策树是 LLM 速率限制详解:RPM、TPM 与重试 的核心价值资产。它避免 429 处理演变成无限循环,并将 LLM 速率限制详解:RPM、TPM 与重试 从定义话题转变为事件响应工作流。
如何使用 Retry-After
HTTP Retry-After 会告诉客户端在再次发起请求之前需要等待多长时间。RFC 将其定义为以秒为单位的延迟,或一个 HTTP 日期。MDN 的 429 Too Many Requests 参考文档也描述了使用 Retry-After 来指示客户端何时可以重试。
实践规则:
- 当
Retry-After有效且符合调用方的延迟预算时,遵循它。 - 对于交互式调用,要限制非常长的值;不要让用户请求无限期保持打开状态。
- 将无效或缺失的值视为使用客户端退避的理由。
- 不要因为
Retry-After缺失,就去重试不可重试的原因。 - 记录提供方的提示以及实际使用的延迟。
对于交互式用户流程,重试预算通常比提供方提示更小。在这种情况下,应快速失败并给出有用的信息,或转到其他路径。对于批处理任务,排队往往比返回错误更好。
带抖动的指数退避
指数退避会在每次失败尝试后增加延迟。抖动会对该延迟进行随机化,这样多个工作线程就不会同步并一起重试。AWS 的退避与抖动指南很有用,因为它解释了为什么即使有上限,普通的指数退避如果没有随机性,重试仍然会聚集在一起。
一个常见的全抖动公式:
delay_ms = random(0, min(cap_ms, base_ms * 2^attempt))
生产环境中的重试策略需要的不只是延迟公式:
| 策略字段 | 推荐控制 |
|---|---|
| 可重试状态 | 429、选定的 5xx,以及瞬时网络故障 |
| 不可重试状态 | 校验错误、认证错误、权限错误、计费错误、每日配额耗尽 |
| 最大尝试次数 | 交互式调用次数要少;只有离线任务才可更高 |
| 最长耗时 | 受用户可见延迟预算或作业截止时间约束 |
| 抖动 | 多工作线程系统必需 |
| Retry-After | 在有效且可承受时使用 |
| 取消 | 当调用方中止时立即停止 |
| 可观测性 | 尝试次数、等待时间、最终状态、请求 ID、队列延迟 |
失败的请求仍然可能消耗速率限制容量。这就是为什么重试必须纳入速率限制规划,而不是事后补充。
适用于 OpenAI 兼容 API 的 TypeScript 重试辅助函数
这个辅助函数在存在 Retry-After 时使用它,否则使用全抖动。它会在尝试次数或耗时耗尽时停止。
type ChatRequest = {
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  max_tokens?: number;
};

const sleep = (milliseconds: number) =>
  new Promise((resolve) => setTimeout(resolve, milliseconds));

function retryAfterMilliseconds(response: Response): number | null {
  const value = response.headers.get("retry-after");
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) return Math.max(0, seconds * 1_000);

  const date = Date.parse(value);
  return Number.isNaN(date) ? null : Math.max(0, date - Date.now());
}

export async function createChatCompletion(
  apiKey: string,
  request: ChatRequest,
  options: { maxAttempts?: number; maxElapsedMs?: number } = {},
) {
  const maxAttempts = options.maxAttempts ?? 4;
  const maxElapsedMs = options.maxElapsedMs ?? 30_000;
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt += 1) {
    const response = await fetch("https://router.flatkey.ai/v1/chat/completions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify(request),
    });

    if (response.ok) return response.json();

    const retryable = response.status === 429 || response.status >= 500;
    const finalAttempt = attempt === maxAttempts - 1;
    if (!retryable || finalAttempt) {
      throw new Error(`LLM request failed with ${response.status}: ${await response.text()}`);
    }

    const serverDelay = retryAfterMilliseconds(response);
    const exponentialCap = Math.min(8_000, 500 * 2 ** attempt);
    const jitteredDelay = Math.random() * exponentialCap;
    const delayMs = serverDelay ?? jitteredDelay;

    if (Date.now() + delayMs - startedAt >= maxElapsedMs) {
      throw new Error("LLM retry budget exhausted");
    }

    await sleep(delayMs);
  }

  throw new Error("Unreachable retry state");
}
在投入生产之前,添加请求超时、结构化错误类、遥测和取消机制。如果调用可能产生外部副作用,请先将业务操作设计为幂等,再进行重试。
重试、排队、降级还是路由?
一个有弹性的系统对限流有不止一种应对方式。
| 情况 | 重试 | 排队 | 减少 Token | 路由到其他位置 |
|---|---|---|---|---|
一次短暂的瞬时 429 |
是,受限地重试 | 可选 | 否 | 通常不需要 |
| 持续性 RPM 耗尽 | 非常有限 | 是 | 通常不需要 | 有时 |
| 持续性 TPM 耗尽 | 非常有限 | 是 | 是 | 有时 |
| 每日配额耗尽 | 否 | 仅当稍后重置可接受时 | 否 | 也许 |
| 计费或权限错误 | 否 | 否 | 否 | 否,先修复访问权限 |
| 提供方过载,但有健康的备用路径 | 短暂重试 | 可选 | 否 | 是,在通过策略检查后 |
| 部分流已经送达 | 通常不回放 | 也许继续或显式重启 | 也许 | 仅在语义明确时 |
当工作可以等待时,排队能保护提供方和用户体验。减少 Token 能保护 TPM。仅当备用路径满足相同的产品契约时,路由切换才有助于保障可用性。
对于特定过载场景,请使用 API 错误 529 过载 的处理方案。对于成本影响,请将重试和回退行为与 AI 网关定价 以及 如何在切换提供方前比较 AI 模型价格 联系起来。
模型评估中的速率限制
速率限制可能使模型对比失效。
如果模型 A 使用 10 个工作线程测试,而模型 B 使用 100 个工作线程,那么模型 B 可能看起来更慢,因为测试框架引入了排队和重试。这个测量结果更多反映的是测试配置,而不是模型延迟。
要进行有说服力的评估:
- 区分模型延迟、排队延迟和重试延迟。
- 每条路由使用相同的到达过程或标准化利用率水平。
- 当提供方使用加速控制时,逐步预热流量。
- 记录每个已完成任务的 Token 数和尝试次数。
- 分别报告首次尝试成功率和最终成功率。
- 比较每个已接受任务的成本,而不只是 Token 单价。
- 将过载测试与质量测试分开运行。
这对免费或低配账户尤其重要。免费 LLM API 这篇文章很有参考价值,因为免费额度通常是为探索而设计的,而不是为生产负载设计的。
需要告警的指标
按提供方、模型、路由、租户、工作负载和环境跟踪这些指标:
- 每分钟请求数。
- 每分钟输入 Token 和每分钟输出 Token。
- 估算预留 Token 与实际使用 Token。
- 队列深度以及队列中最旧项目的等待时长。
- 等待速率容量的时间。
- 首次尝试成功率。
- 每个成功请求的重试次数。
- 按分类原因划分的
429速率。 - 重试放大比:总尝试次数除以成功结果数。
- 回退率及回退结果。
- 端到端 p50、p95 和 p99 延迟。
- 每个成功或已接受任务的成本。
OpenTelemetry 的生成式 AI 语义约定可以帮助标准化模型、操作、Token、响应和错误遥测。也要保留产品特定维度:客户、工作区、流量类别、环境、功能和负责人。
仅仅对总 429 数量发出告警会很嘈杂。更好的信号会把限流速率、队列等待时长、重试放大比和最终失败率结合起来。
生产环境的速率限制架构
一个稳健的请求路径通常有七层控制:
client
  -> admission control
  -> priority queue
  -> token reservation
  -> RPM + TPM limiter
  -> provider/model route
  -> bounded retry controller
  -> contract-safe fallback
  -> usage, cost, and latency ledger
当队列无法满足调用方的截止时间要求时,使用接入控制。使用优先级队列,避免非关键评估挤占生产流量。使用 Token 预留来确保 TPM 真实可信。使用集中式重试控制器,避免 SDK、队列、网关和工作线程各自独立重试。
使用记录台账应记录:
rate_limit_event:
  request_id: req_8f3a
  workspace_id: ws_42
  environment: production
  workflow: support_answer
  route_requested: primary_chat_route
  route_final: fallback_chat_route
  estimated_input_tokens: 3200
  max_output_tokens: 900
  actual_input_tokens: 3014
  actual_output_tokens: 622
  attempt_count: 2
  retry_delay_ms: 740
  queue_delay_ms: 1180
  final_status: success
  classified_limit: transient_rpm_burst
  accepted_result: true
这样一来,事后就可以审查 LLM API 的速率限制。它也能为财务和产品团队提供证据,当重试或回退改变每个已接受结果的成本时,便于他们判断。
Flatkey 如何融入
Flatkey 为团队提供一个 API 密钥,以及一个与 OpenAI 兼容的基础 URL,用于支持的模型路由。这并不会移除上游 LLM 的速率限制。它提供了一个统一的集成入口,使路由、使用审查和策略可以在各个提供方之间保持一致。
对于 LLM 速率限制详解:RPM、TPM 与重试 工作流,当以下情况发生时,网关层会很有帮助:
- 您的应用需要一个统一的重试、队列和回退策略,而不是在各个服务中散落着按供应商分别处理的逻辑。
- 产品团队需要在一份账本中比较路由健康状况、延迟、token 以及接受结果成本。
- 平台团队需要按环境或工作流设置模型白名单、子密钥预算和使用控制。
- 财务团队需要一个余额、发票和请求级证据,而不是彼此割裂的供应商仪表盘。
- 运营团队需要在某条路由受限时迁移符合条件的流量,而无需重写应用 SDK。
网关仍应保留模型特定的契约。除非上下文窗口、工具行为、结构化输出、安全策略、数据控制、延迟和成本都适合该工作负载,否则不要将流量从一个模型路由到另一个模型。在正式上线前,请在 Flatkey 模型目录 和 Flatkey 定价 中查看当前路由可用性和价格。
常见错误
将 RPM 当作并发
RPM 衡量的是随时间接收请求的数量。并发衡量的是进行中的工作量。缓慢生成会在较低的 RPM 下造成较高并发。
对每个 429 都立即重试
立即重试会使工作线程同步,并消耗更多容量。请在有效时遵守 Retry-After,加入抖动,并限制重试预算。
对每个模型都使用同一个限流器
供应商可能使用独立的模型池或共享的账户池。限流器应遵循文档中定义的配额范围和观察到的响应头。
忽视共享消费者
仪表盘、评估运行器、编码代理和生产 API 可能共享同一个项目。应按工作负载预留容量,并在可能时隔离关键流量。
重试部分流式输出
一旦 token 已到达用户端,或某个工具动作已经执行,静默回放就可能重复输出或产生副作用。请明确定义继续、重启或幂等语义。
只测量供应商延迟
终端用户延迟包括排队延迟、重试延迟、回退延迟和模型延迟。应对整条路径进行告警,并保持各组成部分可分离。
FAQ
RPM 和 TPM 有什么区别?
RPM 限制随时间被接纳的请求数量。TPM 限制被接纳的输入和/或输出 token 数量。小型提示通常先碰到 RPM;长上下文或高输出工作负载通常先碰到 TPM。
为什么在低于 RPM 限制时仍会收到 429 错误?
供应商可能实施滚动窗口、令牌桶、共享账户配额、单独的 token 限制、特定模型池、每日限制或加速控制。您的本地请求计数器可能并不能代表完整的配额范围。
我应该重试每个 429 吗?
不应该。对于短暂的限流,可以在较小预算内并结合抖动进行重试。不要反复重试每日配额耗尽、计费限制、权限错误、校验错误,或没有现实恢复窗口的持续过载。
指数退避能保证成功吗?
不能。退避可以减少碰撞,并给暂时性容量恢复时间,但它不能创造配额。持续性耗尽需要降低需求、增加容量、延迟工作,或使用其他符合条件的路由。
重试会计入速率限制吗?
有可能。供应商可能会将失败请求或尝试计入活动限制,因此必须监控并限制重试放大效应。
一次 LLM 请求应该重试多少次?
没有统一答案。重试次数应根据用户可见延迟预算和失败模式来设定。交互式应用通常只需要少量短重试,然后就应失败或改路由;离线任务可以容忍更长的队列等待。
最终检查清单
在生产环境中实现 LLM 速率限制详解:RPM、TPM 与重试 时,请使用以下清单:
- 分别建模 RPM、TPM、每日限制、支出限制和并发。
- 根据请求上限和 token 上限中的较小值计算容量。
- 以安全系数在发布的最大值以下运行。
- 在发送高方差请求前预留 token。
- 对持续负载使用队列和节奏控制。
- 在有效且可承受时遵守
Retry-After。 - 当没有有效的服务器提示时,使用带抖动的指数退避。
- 限制尝试次数和总重试时间。
- 对于配额、计费、权限和校验错误停止重试。
- 避免回放部分流式输出或非幂等副作用。
- 只路由到能够保留所需产品契约的模型。
- 在评估中将队列延迟和重试延迟与模型延迟分开。
- 不仅要对原始
429数量告警,还要对重试放大和队列时长告警。 - 在使用账本中记录请求 ID、token 估算、实际 token、尝试次数、回退路由和最终结果。
速率限制首先是容量规划控制,其次才是错误消息。LLM 速率限制详解:RPM、TPM 与重试 的核心可持续结论是:将请求频率、token 吞吐量、并发、重试和回退结果分别进行度量,这样 429 就会成为可操作的信号,而不是生产噪音。
来源
- OpenAI 速率限制文档:https://platform.openai.com/docs/guides/rate-limits
- OpenAI Cookbook,处理速率限制:https://cookbook.openai.com/examples/how_to_handle_rate_limits
- Anthropic 速率限制:https://docs.anthropic.com/en/api/rate-limits
- Gemini API 速率限制:https://ai.google.dev/gemini-api/docs/rate-limits
- RFC 9110 Retry-After:https://www.rfc-editor.org/rfc/rfc9110.html#name-retry-after
- MDN 429 Too Many Requests:https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429
- AWS Architecture 博客,指数退避与抖动:https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- OpenTelemetry 生成式 AI 语义约定:https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Flatkey 定价:https://flatkey.ai/pricing
- Flatkey 模型目录:https://flatkey.ai/models