LLM Rate Limits Explained: RPM, TPM, and Retries là một chủ đề về độ tin cậy vận hành trước khi nó là một thiết lập SDK. Giới hạn tốc độ quyết định số lượng yêu cầu, token, công việc hoặc lượt sinh đồng thời mà ứng dụng của bạn có thể đẩy qua một nhà cung cấp hoặc gateway trong một khoảng thời gian. Cơ chế thử lại quyết định điều gì xảy ra khi chạm giới hạn. Chính sách thử lại sai có thể biến một đợt tăng đột biến nhỏ thành một sự cố ngừng dịch vụ kéo dài.
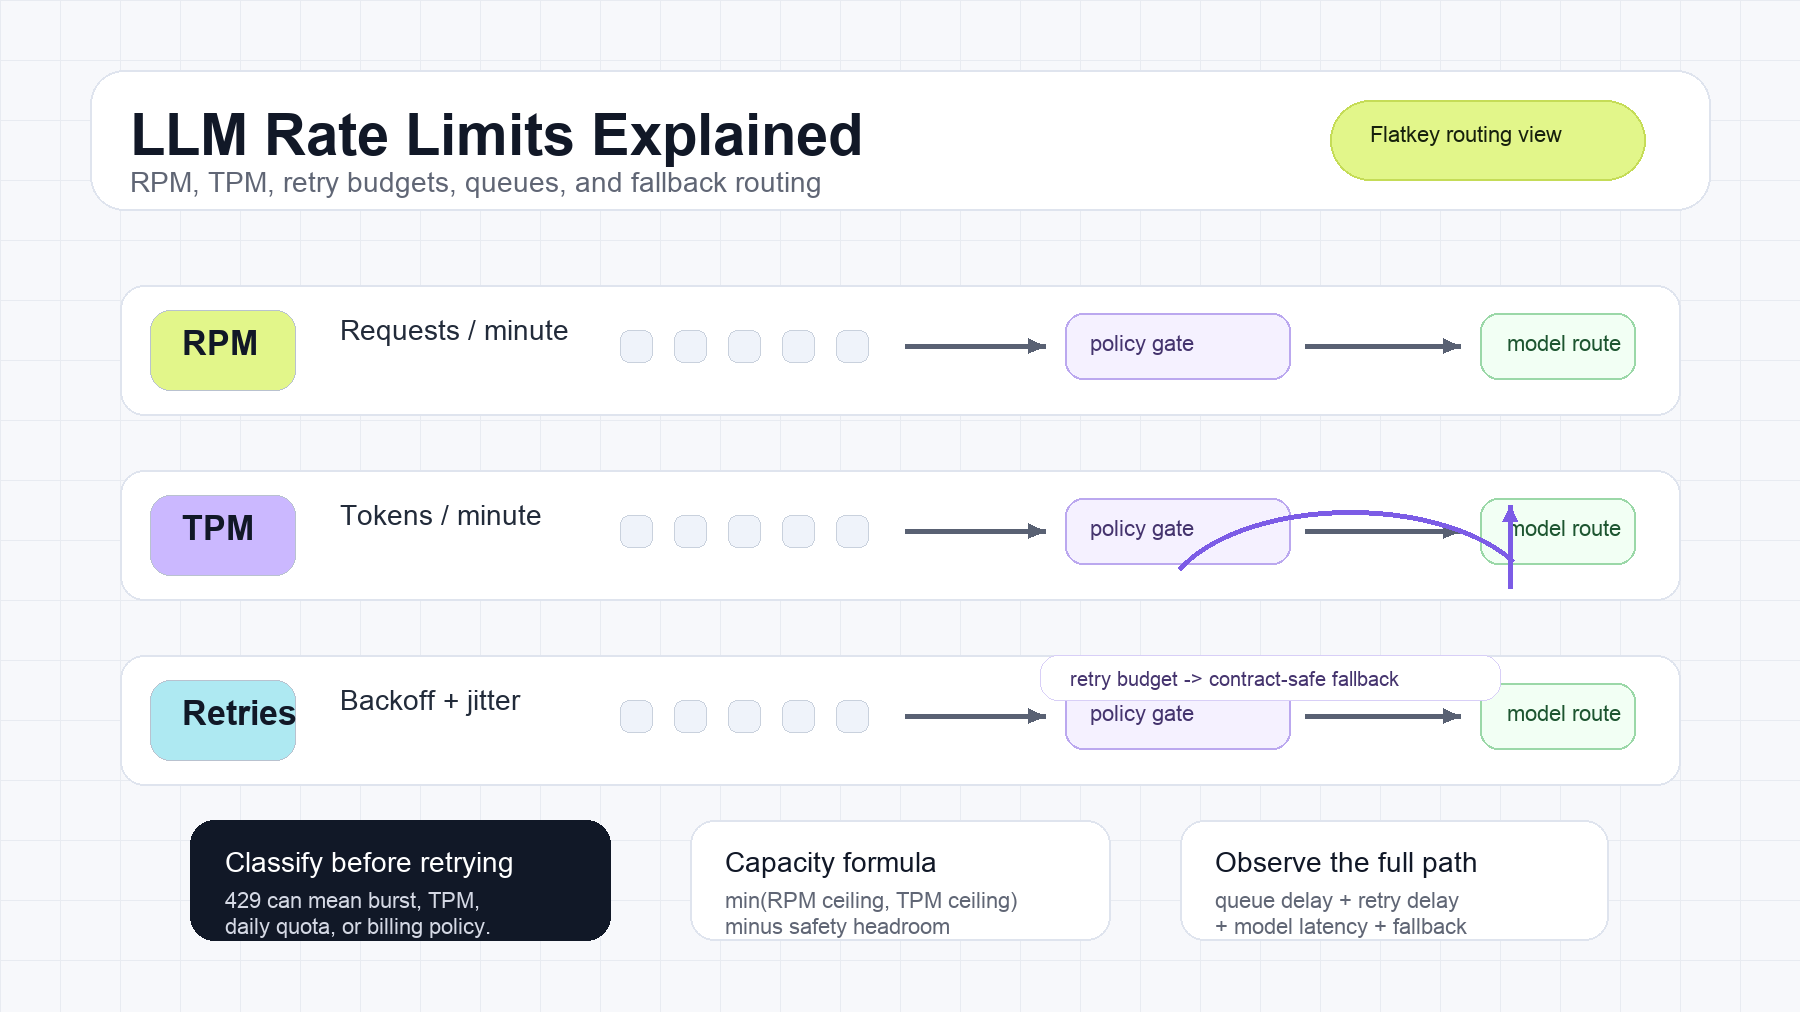
Quy tắc thực tế rất đơn giản: RPM kiểm soát tần suất yêu cầu, TPM kiểm soát thông lượng token, độ đồng thời kiểm soát khối lượng công việc đang chạy, và các lần thử lại sẽ tiêu tốn cùng một năng lực khan hiếm nếu không bị giới hạn. Một hệ thống production nên xác định trước tài nguyên bị hạn chế, sau đó chọn giữa điều tiết nhịp, xếp hàng, giảm token, thử lại trong thời gian ngắn, hoặc chuyển sang một model tương thích về hợp đồng khác.
Hướng dẫn này xem LLM Rate Limits Explained: RPM, TPM, and Retries như một playbook vận hành cho các đội sản phẩm AI và nền tảng. Nội dung bao gồm các thuật ngữ, phép tính năng lực, chính sách thử lại, các trường quan sát được, và các cơ chế điều khiển gateway theo kiểu Flatkey giúp giới hạn tốc độ API LLM không trở thành sự cố của khách hàng.
LLM Rate Limits Explained: RPM, TPM, and Retries - Trả lời nhanh
Hãy dùng bảng này khi bạn đang phân loại một sự cố giới hạn tốc độ LLM.
| Tín hiệu | Nó đo lường điều gì | Triệu chứng điển hình | Kiểm soát đầu tiên |
|---|---|---|---|
| RPM | Số yêu cầu được chấp nhận mỗi phút hoặc trong cửa sổ do nhà cung cấp định nghĩa | Nhiều lệnh gọi nhỏ thất bại với 429 |
Điều tiết yêu cầu, xếp hàng các đợt tăng đột biến, gộp lô các tác vụ nhỏ |
| TPM | Token đầu vào và/hoặc đầu ra được chấp nhận mỗi phút hoặc trong cửa sổ | Prompt dài, output dài, hoặc các lượt chạy đánh giá bị giới hạn | Đặt trước token, rút ngắn ngữ cảnh, giới hạn output |
| RPD / TPD | Số yêu cầu hoặc token được chấp nhận mỗi ngày | Công việc dừng lại cho đến khi quota được đặt lại | Dừng thử lại, lên lịch lại, yêu cầu gói cao hơn |
| Độ đồng thời | Số yêu cầu hoặc công việc đang xử lý cùng lúc | Lượt sinh chậm bị dồn ứ ngay cả khi RPM vừa phải | Giới hạn worker, thêm backpressure |
| Ngân sách thử lại | Lượng công việc bổ sung mà bên gọi có thể tiêu tốn sau khi thất bại | Bão thử lại, độ trễ tăng, tác dụng phụ trùng lặp | Giới hạn số lần thử, thời gian trôi qua, và các trạng thái có thể thử lại |
| Đường dự phòng | Model hoặc nhà cung cấp thay thế đủ điều kiện | Đường chính bị giới hạn nhưng sản phẩm vẫn cần đầu ra | Chỉ chuyển tuyến khi phù hợp về năng lực, chính sách và chi phí |
LLM Rate Limits Explained: RPM, TPM, and Retries quy về một quyết định vận hành: không thử lại một cách mù quáng. Một 429 không phải là lệnh gửi lại ngay chính yêu cầu đó. Nó là tín hiệu cho thấy một bucket năng lực, chính sách quota, trạng thái thanh toán, hoặc cơ chế bảo vệ của nhà cung cấp đã từ chối yêu cầu.
Vì sao tồn tại giới hạn tốc độ
Các nhà cung cấp áp đặt giới hạn tốc độ API LLM để bảo vệ năng lực dùng chung, ngăn các tài khoản vượt kiểm soát, và giữ cho chính sách thanh toán hoặc cấp dịch vụ nhất quán. OpenAI, Anthropic và Gemini đều có tài liệu về các khái niệm giới hạn tốc độ, nhưng chúng hiển thị tên bucket, phạm vi, header và dashboard khác nhau. OpenAI tài liệu hóa giới hạn tốc độ và khuyên client xử lý lỗi giới hạn bằng backoff. Anthropic tài liệu hóa giới hạn chi tiêu ở cấp tổ chức và workspace cùng các giới hạn tốc độ ở cấp model có thể bao gồm request và token. Gemini tài liệu hóa các tier với các khái niệm giới hạn request, token và theo ngày.
Các kiểm soát ở phía nhà cung cấp đó là cần thiết, nhưng không phải là chính sách sản phẩm đầy đủ. Chúng thường trả lời câu hỏi phía nhà cung cấp: “Dự án này có thể gửi thêm lưu lượng ngay bây giờ không?” Ứng dụng của bạn vẫn cần trả lời các câu hỏi phía sản phẩm:
- Khách hàng, workspace, nhóm hay tính năng nào đã gây ra đợt tăng đột biến?
- Tài nguyên bị giới hạn là request, token đầu vào, token đầu ra, độ đồng thời, quota theo ngày hay chi tiêu?
- Khối lượng công việc này nên chờ, suy giảm, hạ cấp hay fail fast?
- Đường dự phòng có được phép theo năng lực, chính sách dữ liệu, giá và hợp đồng khách hàng không?
- Các lần thử lại có đang làm giới hạn tệ hơn không?
Đối với các kiểm soát quota liên quan, hãy kết hợp bài viết này với quản lý quota AI API và quản lý chi tiêu AI API.
RPM, TPM và độ đồng thời là các giới hạn khác nhau
Các nhóm thường xem giới hạn tốc độ như một con số duy nhất. Điều đó che giấu điểm nghẽn thực sự.
RPM: Số yêu cầu mỗi phút
RPM giới hạn số lượng yêu cầu được chấp nhận trong một khoảng thời gian do nhà cung cấp định nghĩa. Prompt nhỏ, kiểm tra sức khỏe, vòng lặp công cụ của agent, và các job đánh giá có độ fan-out cao thường tạo áp lực lên RPM trước tiên. Một workload có thể thấp hơn TPM rất nhiều mà vẫn chạm RPM nếu nó gửi quá nhiều lệnh gọi nhỏ.
TPM: Số token mỗi phút
TPM giới hạn thông lượng token. Tùy theo nhà cung cấp và model, giới hạn có thể tính token đầu vào, token đầu ra, token được cache, hoặc các bucket đầu vào và đầu ra riêng biệt. Truy xuất ngữ cảnh dài, lịch sử hội thoại, đầu ra dài dòng, sinh nhiều ứng viên, và các lượt đánh giá song song thường gây áp lực lên TPM trước RPM.
Độ đồng thời: Công việc đang xử lý
Độ đồng thời không phải là RPM. Một hệ thống có thể chỉ gửi 60 yêu cầu mỗi phút nhưng vẫn có độ đồng thời cao nếu mỗi lần sinh mất 20 giây. Streaming và các cuộc gọi công cụ kéo dài sẽ làm điều này trở nên rõ ràng. Giới hạn nhóm worker và độ sâu hàng đợi thường là các kiểm soát tốt hơn so với việc tăng số lần thử lại.
Giới hạn theo ngày và giới hạn chi tiêu
Một số giới hạn không thể phục hồi chỉ sau một khoảng ngủ ngắn. Giới hạn yêu cầu theo ngày, giới hạn token theo ngày, giới hạn chi tiêu theo tháng và các hạn chế thanh toán thường nên dừng việc thử lại. Hành động đúng là lên lịch lại, nâng cấp bậc, điều chỉnh ngân sách hoặc thông báo cho người dùng rằng năng lực đã cạn.
Tại sao bạn có thể nhận 429 dưới mức giới hạn công bố
Một giới hạn được công bố như “1.000 RPM” hiếm khi có nghĩa là một client có thể gửi 1.000 yêu cầu trong giây đầu tiên của một phút. Nhà cung cấp có thể áp dụng cửa sổ trượt, token bucket, nhóm mô hình, quy tắc burst theo từng bậc, giới hạn tăng tốc, hoặc hạn ngạch dự án dùng chung.
Một yêu cầu có thể nhận 429 Too Many Requests ngay cả khi bộ đếm cục bộ trông có vẻ an toàn vì:
- Nhiều worker, người dùng, dịch vụ hoặc môi trường chia sẻ cùng một giới hạn tài khoản.
- Token đầu vào và đầu ra được tính ở các bucket khác nhau.
- Một mô hình có pool hẹp hơn so với mô hình khác.
- Các lần thử lại từ những lỗi trước đó vẫn đang tiêu tốn năng lực yêu cầu.
- Nhịp tăng lưu lượng quá dốc đối với các kiểm soát tăng tốc.
- Quy tắc theo ngày, chi tiêu, workspace hoặc bậc dịch vụ đang hoạt động.
- Nhà cung cấp trả về
429chung cho nhiều chính sách năng lực.
Đó là lý do Giải thích giới hạn tốc độ LLM: RPM, TPM và cơ chế thử lại nên bắt đầu bằng phân loại, không phải bằng code. Hãy ghi log mã trạng thái, loại lỗi của nhà cung cấp, các header phản hồi, mô hình, tài khoản hoặc dự án, ước tính token, token thực tế, số lần thử, độ trễ hàng đợi và ID yêu cầu của nhà cung cấp khi có.
Công thức lập kế hoạch năng lực
Bắt đầu với các ngưỡng độc lập cho yêu cầu và token, rồi vận hành thấp hơn mức tối đa.
request_ceiling = RPM * safety_factor

token_ceiling = (TPM * safety_factor) / average_total_tokens_per_request

safe_requests_per_minute = min(request_ceiling, token_ceiling)
Hãy dùng hệ số an toàn như 0.70 đến 0.90 tùy theo độ biến thiên token, người tiêu thụ dùng chung, hành vi thử lại và mức độ tốn kém của việc bỏ lỡ mục tiêu độ trễ.
Ví dụ:
RPM = 1,000
TPM = 2,000,000
average_total_tokens_per_request = 4,000
safety_factor = 0.80

request_ceiling = 1,000 * 0.80 = 800 requests/minute

token_ceiling = (2,000,000 * 0.80) / 4,000 = 400 requests/minute

safe_requests_per_minute = min(800, 400) = 400 requests/minute
Trong ví dụ này, TPM là ràng buộc chi phối. Việc thêm nhiều worker hơn sẽ không làm tăng throughput bền vững. Nó sẽ tạo ra nhiều hàng đợi hơn, nhiều lần thử lại hơn hoặc nhiều lỗi 429 hơn.
Đối với hệ thống trực tuyến, hãy chuyển tốc độ yêu cầu an toàn thành điểm khởi đầu cho độ đồng thời:
target_concurrency ~= requests_per_second * average_request_seconds
Nếu tốc độ an toàn là 400 yêu cầu mỗi phút, tức khoảng 6.67 yêu cầu mỗi giây. Nếu độ trễ trung bình của mô hình là 3 giây, độ đồng thời khởi đầu vào khoảng 20. Hãy hiệu chỉnh theo p95 và p99 của độ trễ, không chỉ theo mức trung bình.
Dự trữ token để đảm bảo an toàn cho TPM
Các sự cố TPM thường bắt nguồn từ việc lập lịch quá lạc quan. Ứng dụng tiếp nhận công việc dựa trên số token kỳ vọng, nhưng mô hình tạo ra đầu ra dài hơn dự kiến.
Một bộ lập lịch an toàn hơn sẽ dự trữ token trước khi gửi yêu cầu:
reservation:
  workload: support_answer
  model_route: primary_chat_route
  request_id: req_8f3a
  estimated_input_tokens: 3200
  max_output_tokens: 900
  reserved_total_tokens: 4100
  reservation_expires_at: 2026-10-10T11:03:00Z
Sau phản hồi, hãy đối soát token đã dự trữ với token thực tế:
actual_usage:
  input_tokens: 3014
  output_tokens: 622
  total_tokens: 3636
  retry_attempts: 0
  accepted_result: true
Hãy dự trữ theo p95 hoặc các ước tính riêng cho từng workload trong môi trường sản xuất. Dùng mức sử dụng thực tế cho việc phân bổ chi phí và dự báo. Sự tách biệt đó giúp giới hạn tốc độ API LLM dễ vận hành hơn: kiểm soát tiếp nhận dùng ước tính an toàn, trong khi tài chính và sản phẩm xem xét chi phí thực tế trên mỗi kết quả được chấp nhận.
Cây quyết định giới hạn tốc độ
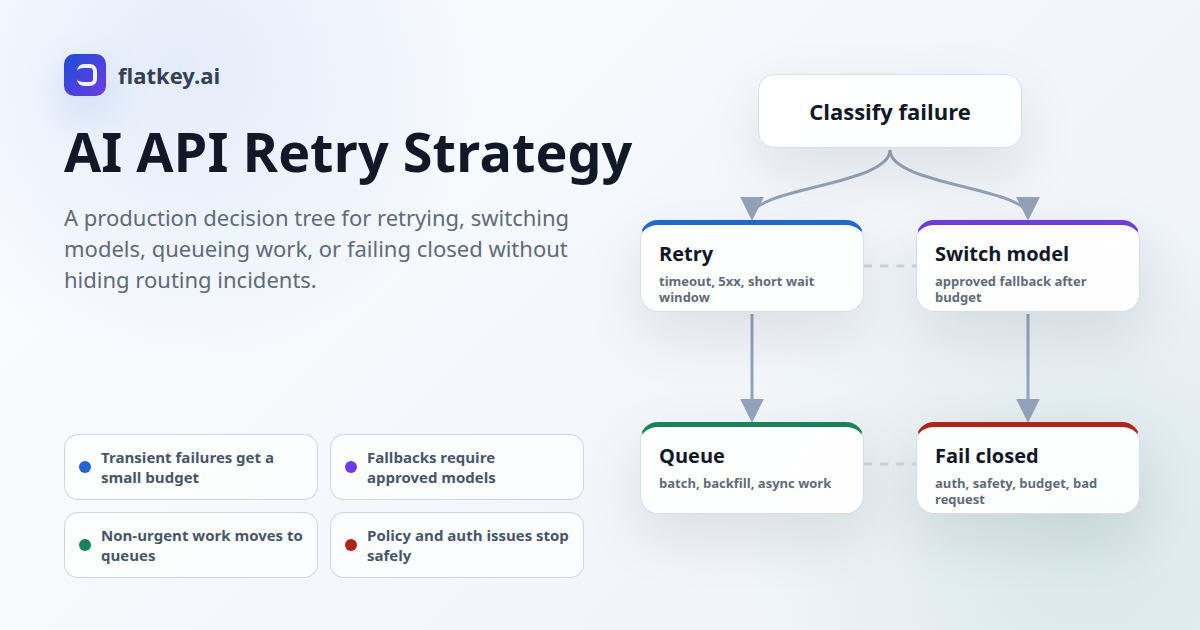
Khi một yêu cầu bị từ chối hoặc hàng đợi tăng lên, hãy xác định kiểm soát dựa trên nguyên nhân.
Did the provider return Retry-After or a reset header?
  yes -> wait for the hint if it fits the caller latency budget
  no  -> use bounded exponential backoff with jitter for transient classes

Is the cause daily quota, billing, permission, or hard spend limit?
  yes -> do not retry; fail, reschedule, or request capacity
  no  -> continue

Is RPM the binding constraint?
  yes -> pace requests, batch small work, or queue low priority traffic
  no  -> continue

Is TPM the binding constraint?
  yes -> shorten context, cap output, reserve tokens, or delay long jobs
  no  -> continue

Is concurrency the binding constraint?
  yes -> reduce workers, set queue deadlines, and apply backpressure
  no  -> continue

Is an eligible fallback route healthy and policy-approved?
  yes -> route after the retry budget is spent
  no  -> return a controlled failure
Cây quyết định này là tài sản giá trị cho Giải thích giới hạn tốc độ LLM: RPM, TPM và cơ chế thử lại. Nó ngăn việc xử lý 429 biến thành một vòng lặp vô hạn, và biến Giải thích giới hạn tốc độ LLM: RPM, TPM và cơ chế thử lại từ chủ đề định nghĩa thành một quy trình ứng phó sự cố.
Cách sử dụng Retry-After
HTTP Retry-After cho biết cho client biết cần đợi bao lâu trước khi gửi thêm một yêu cầu khác. RFC định nghĩa nó là либо một độ trễ tính bằng giây hoặc một ngày giờ HTTP. Tài liệu tham chiếu 429 Too Many Requests của MDN cũng mô tả việc dùng Retry-After để chỉ ra khi nào client có thể thử lại.
Các quy tắc thực tế:
- Tôn trọng một
Retry-Afterhợp lệ khi nó phù hợp với ngân sách độ trễ của bên gọi. - Giới hạn các giá trị quá dài đối với các cuộc gọi tương tác; đừng để một yêu cầu của người dùng mở mãi.
- Xem các giá trị không hợp lệ hoặc bị thiếu là lý do để dùng cơ chế backoff phía client.
- Đừng thử lại các nguyên nhân không thể thử lại chỉ vì
Retry-Afterkhông có mặt. - Ghi lại gợi ý từ nhà cung cấp và độ trễ thực tế đã dùng.
Đối với các luồng người dùng tương tác, ngân sách thử lại thường nhỏ hơn gợi ý của nhà cung cấp. Trong trường hợp đó, hãy thất bại nhanh với thông báo hữu ích hoặc chuyển hướng sang nơi khác. Với công việc batch, xếp hàng có thể tốt hơn là trả về lỗi.
Backoff mũ với Jitter
Backoff mũ làm tăng độ trễ sau mỗi lần thử thất bại. Jitter ngẫu nhiên hóa độ trễ đó để các worker không đồng bộ và thử lại cùng lúc. Hướng dẫn về backoff và jitter của AWS hữu ích vì nó giải thích tại sao backoff mũ có giới hạn đơn thuần vẫn có thể làm các lần thử lại bị dồn cụm nếu không có tính ngẫu nhiên.
Một công thức full-jitter phổ biến:
delay_ms = random(0, min(cap_ms, base_ms * 2^attempt))
Một chính sách thử lại ở môi trường production cần nhiều hơn công thức độ trễ:
| Trường chính sách | Kiểm soát khuyến nghị |
|---|---|
| Trạng thái có thể thử lại | 429, một số 5xx được chọn, và các lỗi mạng tạm thời |
| Trạng thái không thể thử lại | lỗi xác thực dữ liệu, lỗi xác thực quyền, lỗi phân quyền, lỗi thanh toán, hết hạn mức quota hằng ngày |
| Số lần thử tối đa | Số lượng nhỏ cho các cuộc gọi tương tác; lớn hơn chỉ cho công việc ngoại tuyến |
| Tổng thời gian tối đa | Giới hạn bởi ngân sách độ trễ người dùng nhìn thấy hoặc deadline của job |
| Jitter | Bắt buộc cho các hệ thống nhiều worker |
| Retry-After | Dùng khi hợp lệ và có thể chấp nhận được |
| Hủy | Dừng ngay khi bên gọi hủy |
| Khả năng quan sát | Số lần thử, thời gian chờ, trạng thái cuối, request ID, độ trễ hàng đợi |
Các yêu cầu không thành công vẫn có thể tiêu thụ năng lực giới hạn tốc độ. Đó là lý do thử lại phải là một phần của kế hoạch giới hạn tốc độ, chứ không phải điều nghĩ tới sau cùng.
Trợ giúp thử lại bằng TypeScript cho các API tương thích OpenAI
Trợ giúp này dùng Retry-After khi có, nếu không thì dùng full jitter. Nó dừng khi đã hết số lần thử hoặc hết thời gian đã trôi qua.
type ChatRequest = {
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  max_tokens?: number;
};

const sleep = (milliseconds: number) =>
  new Promise((resolve) => setTimeout(resolve, milliseconds));

function retryAfterMilliseconds(response: Response): number | null {
  const value = response.headers.get("retry-after");
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) return Math.max(0, seconds * 1_000);

  const date = Date.parse(value);
  return Number.isNaN(date) ? null : Math.max(0, date - Date.now());
}

export async function createChatCompletion(
  apiKey: string,
  request: ChatRequest,
  options: { maxAttempts?: number; maxElapsedMs?: number } = {},
) {
  const maxAttempts = options.maxAttempts ?? 4;
  const maxElapsedMs = options.maxElapsedMs ?? 30_000;
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt += 1) {
    const response = await fetch("https://router.flatkey.ai/v1/chat/completions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify(request),
    });

    if (response.ok) return response.json();

    const retryable = response.status === 429 || response.status >= 500;
    const finalAttempt = attempt === maxAttempts - 1;
    if (!retryable || finalAttempt) {
      throw new Error(`LLM request failed with ${response.status}: ${await response.text()}`);
    }

    const serverDelay = retryAfterMilliseconds(response);
    const exponentialCap = Math.min(8_000, 500 * 2 ** attempt);
    const jitteredDelay = Math.random() * exponentialCap;
    const delayMs = serverDelay ?? jitteredDelay;

    if (Date.now() + delayMs - startedAt >= maxElapsedMs) {
      throw new Error("LLM retry budget exhausted");
    }

    await sleep(delayMs);
  }

  throw new Error("Unreachable retry state");
}
Thêm timeout yêu cầu, các lớp lỗi có cấu trúc, telemetry và cơ chế hủy trước khi dùng trong production. Nếu cuộc gọi có thể tạo ra tác động bên ngoài, hãy làm cho thao tác nghiệp vụ trở nên idempotent trước khi thử lại.
Thử lại, xếp hàng, giảm bớt, hay chuyển tuyến?
Một hệ thống có khả năng phục hồi có nhiều hơn một phản ứng đối với việc bị giới hạn.
| Tình huống | Thử lại | Hàng đợi | Giảm token | Chuyển tuyến nơi khác |
|---|---|---|---|---|
Một lỗi 429 ngắn, thoáng qua |
Có, giới hạn | Tùy chọn | Không | Thường là không |
| RPM cạn kiệt kéo dài | Rất hạn chế | Có | Thường là không | Đôi khi |
| TPM cạn kiệt kéo dài | Rất hạn chế | Có | Có | Đôi khi |
| Hạn ngạch hằng ngày đã hết | Không | Chỉ khi có thể chấp nhận việc đặt lại sau đó | Không | Có thể |
| Lỗi thanh toán hoặc quyền truy cập | Không | Không | Không | Không, hãy sửa quyền truy cập trước |
| Nhà cung cấp quá tải nhưng có phương án dự phòng hoạt động tốt | Trong thời gian ngắn | Tùy chọn | Không | Có, sau khi kiểm tra chính sách |
| Luồng phát một phần đã được trả về | Thường không phát lại | Có thể tiếp tục hoặc khởi động lại rõ ràng | Có thể | Chỉ với ngữ nghĩa rõ ràng |
Xếp hàng bảo vệ nhà cung cấp và trải nghiệm người dùng khi công việc có thể chờ. Giảm token bảo vệ TPM. Chuyển tuyến bảo vệ tính sẵn sàng chỉ khi tuyến thay thế đáp ứng cùng một hợp đồng sản phẩm.
Đối với các mẫu xử lý quá tải cụ thể, hãy dùng sổ tay API Error 529 overloaded. Về tác động chi phí, hãy liên kết hành vi thử lại và chuyển dự phòng với AI gateway pricing và how to compare AI model prices.
Giới hạn tốc độ trong đánh giá mô hình
Giới hạn tốc độ có thể làm vô hiệu hóa một phép so sánh mô hình.
Nếu mô hình A được kiểm thử với 10 worker và mô hình B với 100 worker, mô hình B có thể trông chậm hơn vì harness đã gây ra hàng đợi và thử lại. Phép đo đó phản ánh cấu hình kiểm thử nhiều hơn là độ trễ của mô hình.
Để có các đánh giá có cơ sở:
- Tách riêng độ trễ mô hình, độ trễ hàng đợi và độ trễ thử lại.
- Sử dụng cùng một phân phối đầu vào hoặc cùng mức sử dụng đã chuẩn hóa cho mỗi tuyến.
- Khởi động lưu lượng tăng dần khi nhà cung cấp dùng cơ chế tăng tốc.
- Ghi lại token và số lần thử cho mỗi tác vụ hoàn tất.
- Báo cáo riêng tỷ lệ thành công ở lần đầu và tỷ lệ thành công cuối cùng.
- So sánh chi phí trên mỗi tác vụ được chấp nhận, không chỉ giá token.
- Chạy kiểm thử quá tải tách biệt với kiểm thử chất lượng.
Điều này đặc biệt quan trọng với tài khoản miễn phí hoặc gói thấp. Bài viết free LLM APIs hữu ích để tham khảo vì các giới hạn miễn phí thường được thiết kế cho mục đích khám phá, không phải tải sản xuất.
Các chỉ số cần cảnh báo
Theo dõi các chỉ số này theo nhà cung cấp, mô hình, tuyến, tenant, khối lượng công việc và môi trường:
- Số yêu cầu mỗi phút.
- Số token đầu vào mỗi phút và số token đầu ra mỗi phút.
- Số token ước tính đã đặt trước so với số token thực tế đã dùng.
- Độ sâu hàng đợi và độ tuổi của mục lâu nhất trong hàng đợi.
- Thời gian chờ để có năng lực tốc độ.
- Tỷ lệ thành công ở lần đầu.
- Số lần thử lại trên mỗi yêu cầu thành công.
- Tỷ lệ
429theo nguyên nhân đã phân loại. - Độ khuếch đại thử lại: tổng số lần thử chia cho số kết quả thành công.
- Tỷ lệ chuyển dự phòng và kết quả chuyển dự phòng.
- Độ trễ đầu-cuối p50, p95 và p99.
- Chi phí trên mỗi tác vụ thành công hoặc được chấp nhận.
Các quy ước ngữ nghĩa AI tạo sinh của OpenTelemetry có thể giúp chuẩn hóa telemetry về mô hình, thao tác, token, phản hồi và lỗi. Hãy giữ cả các chiều đặc thù của sản phẩm: khách hàng, workspace, loại lưu lượng, môi trường, tính năng và chủ sở hữu.
Cảnh báo chỉ dựa trên tổng số 429 sẽ rất nhiễu. Một tín hiệu tốt hơn là kết hợp tỷ lệ bị giới hạn, độ tuổi hàng đợi, độ khuếch đại thử lại và tỷ lệ lỗi cuối cùng.
Kiến trúc giới hạn tốc độ cho môi trường sản xuất
Một đường xử lý yêu cầu vững chắc thường có bảy lớp điều khiển:
client
  -> admission control
  -> priority queue
  -> token reservation
  -> RPM + TPM limiter
  -> provider/model route
  -> bounded retry controller
  -> contract-safe fallback
  -> usage, cost, and latency ledger
Dùng admission control khi hàng đợi không thể đáp ứng deadline của bên gọi. Dùng hàng đợi ưu tiên để các tác vụ đánh giá không quan trọng không lấn át lưu lượng sản xuất. Dùng đặt trước token để TPM được kiểm soát đúng. Dùng bộ điều phối thử lại tập trung để SDK, hàng đợi, gateway và lớp worker không tự thử lại một cách độc lập.
Sổ cái sử dụng nên ghi lại:
rate_limit_event:
  request_id: req_8f3a
  workspace_id: ws_42
  environment: production
  workflow: support_answer
  route_requested: primary_chat_route
  route_final: fallback_chat_route
  estimated_input_tokens: 3200
  max_output_tokens: 900
  actual_input_tokens: 3014
  actual_output_tokens: 622
  attempt_count: 2
  retry_delay_ms: 740
  queue_delay_ms: 1180
  final_status: success
  classified_limit: transient_rpm_burst
  accepted_result: true
Điều này giúp xem xét lại các giới hạn tốc độ API LLM sau sự cố. Nó cũng cung cấp cho đội tài chính và sản phẩm bằng chứng họ cần khi thử lại hoặc chuyển dự phòng làm thay đổi chi phí trên mỗi kết quả được chấp nhận.
Flatkey phù hợp như thế nào
Flatkey cung cấp cho các đội một API key và một base URL tương thích OpenAI cho các tuyến mô hình được hỗ trợ. Điều đó không loại bỏ các giới hạn tốc độ LLM ở phía upstream. Nó cung cấp cho các đội một bề mặt tích hợp duy nhất để routing, xem xét sử dụng và chính sách có thể được thống nhất xuyên suốt các nhà cung cấp.
Đối với quy trình Giải thích giới hạn tốc độ LLM: RPM, TPM và cơ chế thử lại, một lớp gateway hữu ích khi:
- Ứng dụng của bạn cần một chính sách thử lại, hàng đợi và dự phòng duy nhất thay vì logic riêng theo từng nhà cung cấp rải rác khắp các dịch vụ.
- Các nhóm sản phẩm cần so sánh sức khỏe tuyến, độ trễ, token và chi phí kết quả được chấp nhận trong một sổ cái duy nhất.
- Các nhóm nền tảng cần danh sách cho phép mô hình, ngân sách sub-key và kiểm soát sử dụng theo môi trường hoặc quy trình làm việc.
- Bộ phận tài chính cần một số dư, một hóa đơn và bằng chứng ở cấp yêu cầu thay vì các bảng điều khiển nhà cung cấp rời rạc.
- Người vận hành cần chuyển lưu lượng đủ điều kiện khi một tuyến bị giới hạn mà không cần viết lại SDK của ứng dụng.
Cổng vẫn nên giữ nguyên các hợp đồng đặc thù theo mô hình. Không chuyển tuyến từ một mô hình sang mô hình khác trừ khi cửa sổ ngữ cảnh, hành vi công cụ, đầu ra có cấu trúc, chính sách an toàn, kiểm soát dữ liệu, độ trễ và chi phí đều phù hợp với tải công việc đó. Kiểm tra tình trạng khả dụng và giá hiện tại của tuyến trong danh mục mô hình Flatkey và giá Flatkey trước khi ra mắt sản xuất.
Những Sai Lầm Thường Gặp
Xem RPM như Đồng Thời
RPM đo số lượt được tiếp nhận theo thời gian. Đồng thời đo khối lượng công việc đang xử lý. Các lần tạo chậm có thể tạo ra mức đồng thời cao dù RPM chỉ ở mức vừa phải.
Thử Lại Ngay Mọi Lỗi 429
Thử lại ngay sẽ đồng bộ hóa các worker và tiêu tốn thêm năng lực. Tôn trọng Retry-After khi giá trị hợp lệ, thêm jitter và giới hạn ngân sách thử lại.
Dùng Một Bộ Giới Hạn Cho Mọi Mô Hình
Các nhà cung cấp có thể dùng các pool mô hình riêng hoặc pool tài khoản dùng chung. Bộ giới hạn nên bám theo phạm vi hạn ngạch được tài liệu hóa và các header phản hồi quan sát được.
Bỏ Qua Các Người Dùng Chung
Một dashboard, trình chạy đánh giá, tác nhân lập trình và API sản xuất có thể dùng chung một dự án. Hãy dành trước năng lực theo tải công việc và cô lập lưu lượng quan trọng khi có thể.
Thử Lại Các Luồng Một Phần
Một khi token đã đến tay người dùng hoặc một hành động công cụ đã được thực thi, việc phát lại âm thầm có thể nhân đôi đầu ra hoặc tác dụng phụ. Hãy định nghĩa rõ nghĩa của tiếp tục, khởi động lại hoặc tính bất biến idempotency.
Chỉ Đo Độ Trễ Của Nhà Cung Cấp
Độ trễ người dùng cuối bao gồm độ trễ hàng đợi, độ trễ thử lại, độ trễ dự phòng và độ trễ mô hình. Hãy cảnh báo trên toàn bộ đường đi và tách riêng các thành phần.
Câu Hỏi Thường Gặp
Sự khác nhau giữa RPM và TPM là gì?
RPM giới hạn số lượng yêu cầu được tiếp nhận theo thời gian. TPM giới hạn số lượng token đầu vào và/hoặc đầu ra được tiếp nhận. Prompt ngắn thường chạm RPM trước; các tải công việc ngữ cảnh dài hoặc đầu ra cao thường chạm TPM trước.
Vì sao tôi nhận lỗi 429 dù chưa vượt giới hạn RPM?
Nhà cung cấp có thể áp dụng cửa sổ trượt, token bucket, hạn ngạch tài khoản dùng chung, giới hạn token riêng, pool riêng theo mô hình, giới hạn theo ngày hoặc kiểm soát gia tốc. Bộ đếm yêu cầu cục bộ của bạn có thể không phản ánh toàn bộ phạm vi hạn ngạch.
Tôi có nên thử lại mọi lỗi 429 không?
Không. Hãy thử lại tình trạng giới hạn tạm thời với ngân sách nhỏ và jitter. Không nên thử lại lặp đi lặp lại khi hết hạn ngạch theo ngày, bị hạn chế thanh toán, lỗi quyền truy cập, lỗi xác thực hoặc quá tải kéo dài mà không có cửa sổ phục hồi thực tế.
Backoff hàm mũ có đảm bảo thành công không?
Không. Backoff giúp giảm va chạm và cho năng lực tạm thời thời gian phục hồi. Nó không thể tạo ra hạn ngạch. Khi cạn kiệt kéo dài, cần giảm nhu cầu, tăng năng lực, trì hoãn công việc hoặc chọn một tuyến đủ điều kiện khác.
Các lần thử lại có bị tính vào giới hạn tốc độ không?
Có thể. Nhà cung cấp có thể tính các yêu cầu hoặc lần thử không thành công vào giới hạn đang áp dụng, vì vậy việc khuếch đại do thử lại phải được giám sát và giới hạn.
Một yêu cầu LLM nên thử lại bao nhiêu lần?
Không có con số chung cho mọi trường hợp. Hãy đặt số lần thử theo ngân sách độ trễ mà người dùng nhìn thấy và theo chế độ lỗi. Các ứng dụng tương tác thường chỉ cần vài lần thử ngắn trước khi thất bại hoặc chuyển tuyến; các tác vụ ngoại tuyến có thể chịu được hàng đợi lâu hơn.
Danh Sách Kiểm Tra Cuối Cùng
Sử dụng danh sách kiểm tra này khi triển khai Giải thích giới hạn tốc độ LLM: RPM, TPM và cơ chế thử lại trong sản xuất:
- Mô hình hóa riêng RPM, TPM, giới hạn theo ngày, giới hạn chi tiêu và mức đồng thời.
- Tính năng lực từ giá trị nhỏ nhất giữa trần yêu cầu và trần token.
- Vận hành thấp hơn mức tối đa được công bố với hệ số an toàn.
- Dành trước token trước khi gửi các yêu cầu có độ biến thiên cao.
- Dùng hàng đợi và điều tiết nhịp cho tải kéo dài.
- Tôn trọng
Retry-Afterkhi giá trị hợp lệ và chi phí chấp nhận được. - Dùng backoff hàm mũ với jitter khi không có gợi ý hợp lệ từ máy chủ.
- Giới hạn số lần thử và tổng thời gian thử lại.
- Dừng thử lại đối với các lỗi hạn ngạch, thanh toán, quyền và xác thực.
- Tránh phát lại luồng một phần hoặc các tác dụng phụ không idempotent.
- Chỉ chuyển tuyến đến các mô hình giữ nguyên hợp đồng sản phẩm bắt buộc.
- Tách độ trễ hàng đợi và độ trễ thử lại khỏi độ trễ mô hình trong các bài đánh giá.
- Cảnh báo về khuếch đại do thử lại và tuổi hàng đợi, không chỉ số lượng
429thô. - Ghi lại request ID, ước tính token, token thực tế, số lần thử, tuyến dự phòng và kết quả cuối cùng trong sổ cái sử dụng.
Giới hạn tốc độ là các kiểm soát lập kế hoạch năng lực trước khi chúng là thông báo lỗi. Điều rút ra bền vững từ Giải thích giới hạn tốc độ LLM: RPM, TPM và cơ chế thử lại là đo tần suất yêu cầu, thông lượng token, mức đồng thời, số lần thử lại và kết quả dự phòng một cách độc lập để 429 trở thành tín hiệu có thể hành động thay vì tiếng ồn sản xuất.
Nguồn
- Tài liệu giới hạn tốc độ của OpenAI: https://platform.openai.com/docs/guides/rate-limits
- OpenAI Cookbook, xử lý giới hạn tốc độ: https://cookbook.openai.com/examples/how_to_handle_rate_limits
- Giới hạn tốc độ của Anthropic: https://docs.anthropic.com/en/api/rate-limits
- Giới hạn tốc độ của Gemini API: https://ai.google.dev/gemini-api/docs/rate-limits
- RFC 9110 Retry-After: https://www.rfc-editor.org/rfc/rfc9110.html#name-retry-after
- MDN 429 Quá nhiều yêu cầu: https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429
- Blog Kiến trúc AWS, exponential backoff và jitter: https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- Quy ước ngữ nghĩa AI tạo sinh của OpenTelemetry: https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Giá của Flatkey: https://flatkey.ai/pricing
- Danh mục mô hình của Flatkey: https://flatkey.ai/models