
NVLink vs. NVSwitch: GPU-Interconnects erklärt für KI-Cluster
Wenn Sie NVLink vs. NVSwitch vergleichen, lautet die kurze Antwort:
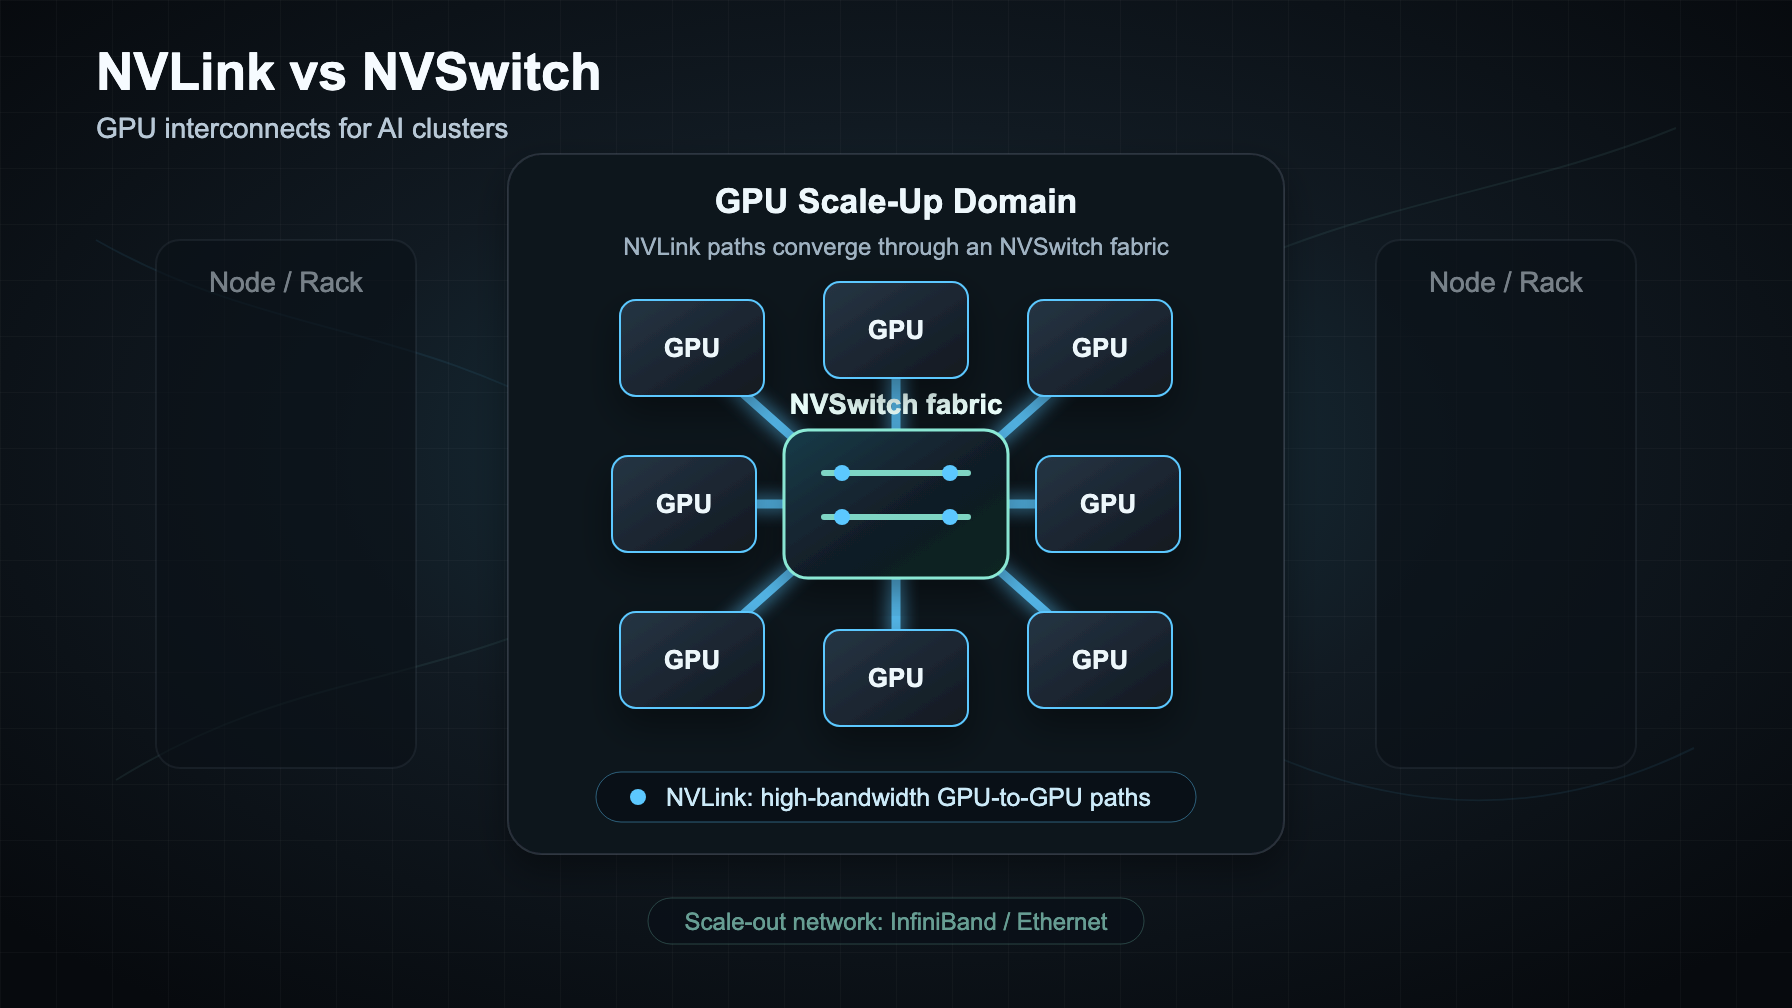
- NVLink ist die GPU-zu-GPU-Verbindung mit hoher Bandbreite.
- NVSwitch ist die Switching-Fabric, die es vielen über NVLink verbundenen GPUs ermöglicht, miteinander zu kommunizieren, ohne dass jedes GPU-Paar auf eine schmale Punkt-zu-Punkt-Lane beschränkt wird.
- InfiniBand oder Ethernet ist weiterhin das Scale-out-Netzwerk, das Systeme, Racks, Speicher und größere Cluster verbindet.
Dieser Unterschied ist wichtig, wenn Sie GPUs mieten, ein HGX- oder DGX-System kaufen oder entscheiden, ob ein Workload wirklich direkten Clusterzugriff statt einer verwalteten Modell-API benötigt. Eine schnelle GPU reicht nicht aus, wenn das Modell zu viel Zeit mit Warten auf Tensor-Parallel-Synchronisationen, All-Reduce, All-Gather, Reduce-Scatter oder All-to-All-Traffic verbringt.
Dieser Leitfaden erklärt die Unterschiede zwischen nvidia nvlink vs nvswitch in praktischen Clusterbegriffen: was jede Komponente tut, wo InfiniBand ins Bild passt, wann die Topologie die LLM-Performance verändert und welche Fragen Sie stellen sollten, bevor Sie sich auf eine teure GPU-Cluster-Architektur festlegen.
NVLink vs. NVSwitch: der schnelle Unterschied
| Ebene | Was es ist | Typischer Umfang | Was es verbessert | Was es nicht ersetzt |
|---|---|---|---|---|
| NVLink | Direkte GPU-Interconnects mit hoher Bandbreite | GPU-zu-GPU-Verbindungen innerhalb unterstützter NVIDIA-Plattformen | Tensor Parallelism, Peer-GPU-Speicherbewegungen, kollektive Kommunikation innerhalb einer Scale-up-Domäne | Es ist nicht selbst ein Cluster-Netzwerk |
| NVSwitch | Switch-Silizium und Fabric für NVLink-Endpunkte | Je nach Plattform ein Multi-GPU-Server-, Baseboard- oder Rack-Scale-NVLink-Domäne | All-to-All-GPU-Kommunikation, nicht blockierende oder höher-bisektionsfähige GPU-Fabric, größere GPU-Domänen | Es ersetzt nicht die Notwendigkeit von InfiniBand/Ethernet für das Cluster-Scale-out |
| InfiniBand / Ethernet | Netzwerk-Fabric zwischen Systemen und Racks | Node-zu-Node, Speicher, Management, Multi-Rack-Cluster | Verteiltes Training über viele Nodes, Speicherzugriff, Service-Traffic, Scheduling-Domänen | Es erzeugt nicht die lokale NVLink-Bandbreite zwischen GPUs innerhalb eines Nodes |
Der Unterschied zwischen nvlink vs nvswitch lässt sich am einfachsten als Link vs. Fabric merken. NVLink ist die Straße zwischen GPUs. NVSwitch ist die Kreuzung, die es erlaubt, dass viele dieser Straßen zusammenlaufen, ohne jede Fahrt in einen schmalen Punkt-zu-Punkt-Pfad zu verwandeln.
Was NVLink macht
NVLink ist NVIDIAs Hochgeschwindigkeits-Interconnect für die GPU-zu-GPU-Kommunikation. Er ist für die Traffic-Muster ausgelegt, die über herkömmliche PCIe-Pfade teuer werden: modellparallele Schichten, synchronisierte Tensor-Shards, Peer-Speicherzugriff und häufige Kollektive.
Auf aktuellen öffentlichen NVIDIA-Plattformen ist die Generation entscheidend:
| Plattformgeneration | Öffentlicher NVIDIA-Referenzpunkt | NVLink-Bandbreite pro GPU |
|---|---|---|
| Hopper | H100/H200-Generation | 900 GB/s |
| Blackwell | B200/GB200-Generation | 1.800 GB/s |
| Vera Rubin | Angekündigte Plattform der nächsten Generation | 3.000 GB/s vorläufig |
Für einen Infrastruktureinkäufer bedeuten diese Zahlen keine Garantie, dass jeder Workload eine entsprechende Beschleunigung erhält. Sie zeigen die Kommunikationsobergrenze, die die Topologie bietet. Der tatsächliche Gewinn hängt von Modellgröße, Parallelisierungsstrategie, Batch-Größe, Sequenzlänge, Framework-Verhalten, Platzierung und davon ab, ob der Workload durch Kommunikation begrenzt ist.
Nutzen Sie NVLink als Kaufsignal, wenn Ihr Workload mehrere GPUs für eine Anfrage, einen Trainingsschritt oder eine Modell-Shard-Gruppe verwendet. Weniger wichtig ist es, wenn jede GPU unabhängige Jobs mit wenig Peer-Kommunikation bedient.
Was NVSwitch macht
NVSwitch ist die Switching-Ebene, die viele NVLink-Endpunkte zu einer GPU-Fabric mit höherer Bandbreite verbindet. Ohne Switch-Fabric kann ein Multi-GPU-System am Ende das verfügbare Link-Budget jeder GPU auf viele Punkt-zu-Punkt-Verbindungen aufteilen. Mit NVSwitch können unterstützte Systeme jeder GPU einen gleichmäßigeren Pfad zu jeder anderen GPU in der NVLink-Domäne bieten.
Deshalb ist nvswitch vs nvlink keine Wahl zwischen zwei Alternativen. NVSwitch nutzt NVLink-Verbindungen, um eine Fabric aufzubauen. Der Switch ist nützlich, weil acht, sechzehn oder zweiundsiebzig GPUs sich nicht wie zwei per Kabel verbundene GPUs verhalten.
In öffentlichen NVIDIA-Beispielen:
- DGX H100/H200-Systeme verwenden acht H100- oder H200-GPUs und geben 900 GB/s GPU-zu-GPU-Bandbreite sowie Cluster-Vernetzung über ConnectX-7 InfiniBand/Ethernet-Ports an.
- DGX B200-Systeme verwenden acht B200-GPUs und geben zwei NVSwitches der fünften Generation mit 14,4 TB/s aggregierter Bandbreite an; vergleichen Sie die Kaufabwägungen in unserem Leitfaden B200 vs H200.
- GB200 NVL72 verbindet 36 Grace-CPUs und 72 Blackwell-GPUs in einem Rack-Scale-Design; NVIDIA beschreibt es als 72-GPU-NVLink-Domäne mit 130 TB/s GPU-Kommunikation mit geringer Latenz. Zur Plattformauswahl siehe GB200 vs B200.
Die praktische Schlussfolgerung: NVSwitch wird umso wichtiger, je mehr GPUs sich in einer Scale-up-Domäne befinden und je mehr der kritische Pfad des Workloads aus GPU-zu-GPU-Kommunikation besteht.
NVLink vs. NVSwitch vs. InfiniBand
Die Formulierung nvlink vs nvswitch vs infiniband verbirgt oft drei verschiedene Designfragen:
- Innerhalb eines GPU-Systems: Haben die GPUs genug Peer-Bandbreite für Tensor Parallelism, Pipeline-Stufen oder Multi-GPU-Inferenz?
- Innerhalb einer Rack-Scale-Domäne: Können viele GPUs als eine größere Accelerator-Fabric für großes Model Parallelism fungieren?
- Über viele Knoten oder Racks hinweg: Kann das Cluster-Netzwerk verteiltes Training, Datenladen, Storage, Checkpointing und Service-Traffic vorhersagbar transportieren?
NVLink und NVSwitch beantworten die ersten beiden Fragen. InfiniBand oder Ethernet beantwortet die dritte.
Ein Beispiel: Ein Acht-GPU-HGX- oder DGX-Knoten mit NVSwitch kann hervorragend für eine Modellreplik geeignet sein, die enges Tensor Parallelism über die GPUs im Knoten hinweg benötigt. Wenn Sie Hunderte oder Tausende von GPUs brauchen, benötigen Sie weiterhin ein Scale-out-Netzwerk. In Blackwell-Rack-Systemen kombiniert NVIDIA große NVLink-Domänen mit InfiniBand oder Spectrum-X Ethernet, um über den Rack hinaus zu skalieren.
Fragen Sie nicht, ob NVLink InfiniBand ersetzt. Fragen Sie, welcher Traffic in der NVLink-Domäne bleiben sollte und welcher Traffic die Cluster-Fabric überqueren muss.
Warum KI-Workloads sich für die Topologie interessieren
Moderne LLM-Workloads sind nicht nur Matrixmultiplikation. Sobald ein Modell über Geräte hinweg aufgeteilt ist, kann jede Schicht Kommunikation einführen.
Gängige Kommunikationsmuster umfassen:
- All-Reduce: jeder Rank trägt Werte bei und erhält das reduzierte Ergebnis.
- Reduce-Scatter und All-Gather: gängige Bausteine für Tensor- und Data-Parallel-Strategien.
- All-to-all: jeder Rank sendet unterschiedliche Datenblöcke an andere Ranks, was für einige expert-parallele und routing-intensive Designs wichtig ist.
- KV-Cache- und Aktivierungsbewegung: von der Implementierung abhängig, aber oft empfindlich gegenüber Lokalität und Platzierung.
NCCL dokumentiert diese Kollektive als rankbasierte Operationen über CUDA-Geräte hinweg. Das ist wichtig, weil die Software Ranks sieht, nicht Marketingbegriffe. Eine gute Fabric hilft nur dann, wenn Rank-Platzierung, Framework, Container, NCCL-Einstellungen und Scheduler-Layout dem Job erlauben, sie zu nutzen.
In NVIDIAs Diskussion zur LLM-Inferenz erfordert Tensor-Parallel-Inferenz, dass GPUs nach der Arbeit an einer Modellschicht Ergebnisse austauschen, bevor die nächste Schicht fortfahren kann. Wenn dieser Austausch langsam ist, können Tensor Cores untätig bleiben. Das ist der zentrale Grund, warum NVSwitch für Multi-GPU-Serving relevant sein kann.
Wann NVSwitch Beachtung verdient
Priorisieren Sie NVSwitch-basierte Systeme, wenn eines davon zutrifft:
- Sie betreiben Modelle, die Tensor Parallelism über mehrere GPUs benötigen, um Latenzziele zu erreichen.
- Trainings- oder Fine-Tuning-Jobs zeigen in Profilern hohe Collective-Zeiten.
- Sie planen Large-Batch-Inferenz, bei der die GPU-zu-GPU-Synchronisierung mit der Parallelität zunimmt.
- Sie benötigen vorhersagbare All-to-all-Kommunikation über jede GPU in einem Acht-GPU-Knoten hinweg.
- Sie evaluieren Rack-Scale-Systeme wie GB200 NVL72, bei denen die NVLink-Domäne ein primäres Produktmerkmal ist.
NVSwitch ist weniger entscheidend, wenn:
- Jobs sind embarrassingly parallel und jede GPU führt unabhängige Arbeit aus.
- Der Workload ist an CPU, Storage oder Data-Loader gebunden.
- Das Modell passt bequem auf eine einzelne GPU und wird dort bedient.
- Die Anwendung gehostete Modell-APIs aufruft und die Hardware-Topologie nicht direkt verwaltet.
- Der Engpass ist die Inter-Node-Fabric und nicht die GPU-Kommunikation innerhalb des Knotens.
Die richtige Frage lautet nicht: "Hat diese GPU NVLink?" Sie lautet: "Wird mein kritischer Workload mehrere GPUs in derselben NVLink/NVSwitch-Domäne genug auslasten, um den Aufpreis zu rechtfertigen?"
Beschaffungs-Checkliste für NVLink-vs.-NVSwitch-Systeme
Nutzen Sie diese Checkliste, bevor Sie einen GPU-Cluster mieten oder kaufen, und kombinieren Sie sie mit einer GPU-Cluster-TCO-Prüfung, bevor Sie eine lange Reservierung unterschreiben.
| Frage | Warum das wichtig ist |
|---|---|
| Welcher genaue GPU-SKU und Formfaktor wird angeboten? | H100 PCIe, H100 SXM, H200, B200 und GB200-Systeme können sehr unterschiedliche Topologien und Bandbreiten aufweisen. |
| Ist das System NVLink-only Point-to-Point, NVSwitch-basiert oder eine Rack-Scale-NVLink-Domäne? | "Hat NVLink" reicht nicht aus. Sie brauchen die Form der Fabric. |
| Wie viele GPUs sind in einer NVLink-Domäne? | Die Domänengröße beeinflusst Tensor-Parallel- und Model-Parallel-Platzierungsoptionen. |
| Wie sieht das Inter-Node-Netzwerk aus: InfiniBand, RoCE, Spectrum-X Ethernet oder gewöhnliches Ethernet? | NVSwitch behebt kein schwaches Scale-out-Netzwerk. |
| Sind NCCL-Tests für die exakt gemietete Konfiguration verfügbar? | Synthetische Kollektive zeigen, ob Topologie, Treiber, Rails und Container korrekt verbunden sind. |
| Können Sie einen vollständigen Knoten oder eine vollständige Domäne reservieren? | Shared Tenancy kann Annahmen über Lokalität und Wiederholbarkeit zerstören. |
| Sind Netzwerklanes und NIC-Platzierung dokumentiert? | NCCL benötigt möglicherweise die richtige Schnittstellenauswahl und rail-bewusste Platzierung im großen Maßstab. |
| Was passiert, wenn eine GPU, ein Switch-Tray oder eine NIC degradiert ist? | Resilienz und Austauschrichtlinien beeinflussen die Produktionsverfügbarkeit. |
| Welcher Benchmark muss vor einer langen Reservierung bestanden werden? | Akzeptierte Ausführungskosten sind nützlicher als ein reiner Stundenpreis. |
Benchmark-Plan: Beweisen Sie die Fabric, bevor Sie reservieren
Führen Sie bei teuren GPU-Reservierungen vor der langfristigen Bindung einen Topologie-Abnahmetest durch.
- Inventarisieren Sie die Topologie. Erfassen Sie
nvidia-smi topo -m, GPU-SKU, Treiber, CUDA, NCCL-Version, NICs und das Container-Image. - Führen Sie NCCL-Collectives aus. Testen Sie All-Reduce, Reduce-Scatter, All-Gather und All-to-All mit Nachrichtengrößen, die Ihrer Workload ähneln.
- Messen Sie die Latenz der realen Workload. Verwenden Sie Ihr tatsächliches Modell, die Kontextlänge, die Batch-Policy und die Parallelismuseinstellungen.
- Vergleichen Sie die Platzierung innerhalb derselben Domäne und domänenübergreifend. Prüfen Sie, ob der Scheduler Ranks versehentlich über langsamere Pfade verschiebt.
- Verfolgen Sie die Kosten pro akzeptierter Ausgabe. Messen Sie bei Inference die akzeptierten Tokens oder erfolgreichen Antworten pro Dollar, nicht nur Tokens pro Sekunde. Bei Training messen Sie den Loss-Fortschritt oder abgeschlossene Samples pro Dollar.
- Dokumentieren Sie das Fehlverhalten. Beenden Sie einen Worker, starten Sie einen Container neu oder simulieren Sie eine beeinträchtigte NIC, wenn der Anbieter dies zulässt.
Wenn ein Anbieter Ihnen die Topologie nicht nennen oder keinen grundlegenden NCCL-Benchmark ausführen kann, sollten Sie das als Risikosignal werten. Stundensätze brauchen außerdem Kontext aus GPU-Mietpreisen, Kapazitätszusagen, Netzwerk-Add-ons und Kosten durch fehlgeschlagene Läufe.
Häufige Fehler
Fehler 1: NVLink als Synonym für NVSwitch zu behandeln. Eine Plattform kann NVLink-Verbindungen bieten, ohne Ihnen dasselbe All-to-All-Verhalten wie ein NVSwitch-basiertes System zu geben.
Fehler 2: Anzunehmen, dass NVSwitch das Netzwerkdesign überflüssig macht. NVSwitch hilft bei der Scale-up-GPU-Domäne. Multi-Node-Training benötigt weiterhin ein ernstzunehmendes InfiniBand- oder Ethernet-Design.
Fehler 3: Bandbreite für unabhängige Jobs zu kaufen. Wenn jede GPU einen separaten Inference-Worker ausführt, verbessert NVSwitch die Auslastung möglicherweise nicht genug, um die Kosten zu rechtfertigen.
Fehler 4: Stündliche GPU-Preise ohne Topologie zu vergleichen. Zwei Angebote mit "8x H100" können sich unterschiedlich verhalten, wenn eines SXM mit NVSwitch ist und ein anderes PCIe oder ein schwächeres Netzwerk hat.
Fehler 5: Software-Platzierung zu ignorieren. NCCL-Rank-Mapping, Container-Versionen, Auswahl der Netzwerkschnittstelle und Scheduler-Policy können Hardwarevorteile zunichtemachen.
Entscheidungsmatrix
| Workload | Bedeutung von NVLink | Bedeutung von NVSwitch | Bedeutung des Scale-out-Netzwerks | Praktische Empfehlung |
|---|---|---|---|---|
| Single-GPU-Inference | Niedrig | Niedrig | Niedrig bis mittel | Optimieren Sie GPU-Speicher, Batch-Verarbeitung und Modellwahl, bevor Sie für NVSwitch bezahlen. |
| 2-8-GPU Tensor-Parallel-Inference | Hoch | Hoch bei 8-GPU-Systemen | Mittel | Bevorzugen Sie NVSwitch-basierte H100/H200/B200-Systeme und benchmarken Sie die reale Latenz. |
| Verteiltes Multi-Node-Training | Hoch innerhalb jedes Nodes | Hoch innerhalb jedes Nodes | Sehr hoch | Bewerten Sie sowohl das Node-Fabric als auch InfiniBand/Ethernet; urteilen Sie nicht nur nach der GPU-SKU. |
| Expert-Parallel- oder All-to-All-intensive Modelle | Hoch | Hoch | Hoch beim Crossing von Nodes | Testen Sie All-to-All und Platzierung direkt; die Topologie kann dominieren. |
| Batch-Offline-Generierung | Mittel | Mittel | Mittel | Messen Sie akzeptierte Ausgabe pro Dollar; NVSwitch kann bei höheren Batch-Größen helfen. |
| API-first-Produkt-Workload | Meist abstrahiert | Meist abstrahiert | Verantwortung des Anbieters | Vergleichen Sie direkte GPU-Kontrolle mit einer Modell-/API-Baseline, bevor Sie Hardware mieten. |
Wo Flatkey passt
Flatkey ist ein einheitliches LLM-API-Gateway: ein Schlüssel, eine Rechnung und ein OpenAI-kompatibler Endpoint über viele Text-, Bild- und Videomodelle hinweg. Das ersetzt keine direkten GPU-Cluster, wenn Sie benutzerdefinierte Kernel, private Gewichte, Fine-Tuning-Kontrolle oder topologiespezifische Performance-Arbeit benötigen.
Es ist als Baseline nützlich, wenn das Geschäftsziel Output ist und nicht der Besitz der Infrastruktur. Bevor Sie einen topologieintensiven Cluster für Inference reservieren, vergleichen Sie den Cluster-Plan mit einem verwalteten Modell-/API-Pfad:
- Welche Qualität und Latenz erhalten Sie mit gehosteten Modellen?
- Wie hoch sind die Kosten pro akzeptierter Antwort nach Retries und fehlgeschlagenen Generierungen?
- Wie viel Engineering-Zeit wird der Cluster-Betrieb verbrauchen?
- Erfordert die Workload direkte Kontrolle über den GPU-Speicher oder nur zuverlässige Modellausgaben?
Wenn die Modell-/API-Baseline die Produktanforderung bereits erfüllt, ist NVLink vs. NVSwitch möglicherweise eine Optimierung, die Sie noch nicht selbst tragen müssen. Wenn die Workload private Bereitstellung, Custom Serving oder harte Latenzziele im großen Maßstab erfordert, vergleichen Sie die Kompromisse zwischen GPU-Cloud vs. Model-API und nutzen Sie dann die obige Checkliste, um die richtige Topologie zu kaufen statt den bekanntesten GPU-Namen.
FAQ
Ist NVSwitch schneller als NVLink?
NVSwitch ist nicht einfach „schnelleres NVLink“. NVLink ist die GPU-Verbindung. NVSwitch ist das Fabric, das mehrere NVLink-Endpunkte verbindet, damit viele GPUs effizient kommunizieren können. In unterstützten Systemen kann NVSwitch die hohe GPU-zu-GPU-Bandbreite über mehr GPU-Paare hinweg erhalten als ein einfaches Punkt-zu-Punkt-Layout.
Brauche ich NVSwitch für LLM-Inference?
Sie müssen NVSwitch beachten, wenn Inference mehrere GPUs für eine Modellreplik verwendet, insbesondere bei Tensor Parallelism unter Latenz- oder Durchsatzvorgaben. Wenn jede GPU unabhängige Single-GPU-Jobs bedient, ist NVSwitch möglicherweise deutlich weniger wichtig.
Ersetzt NVLink InfiniBand?
Nein. NVLink und NVSwitch sind Scale-up-GPU-Fabrics. InfiniBand oder Ethernet verbindet Nodes, Racks, Speicher und größere Cluster. Große KI-Systeme benötigen oft beides.
Was ist der größte Unterschied zwischen nvlink und nvswitch?
Der größte Unterschied zwischen nvlink und nvswitch ist der Umfang. NVLink ist eine direkte Kommunikationsverbindung zwischen GPUs. NVSwitch verbindet viele mit NVLink ausgestattete GPUs zu einem breiteren All-to-All-Fabric.
Sollte ich H100, H200, B200 oder GB200 basierend auf NVSwitch wählen?
Entscheiden Sie sich nicht nur anhand des Interconnect-Labels. Stimmen Sie den GPU-Speicher, die Unterstützung von Präzisionsformaten, Verfügbarkeit, Kühlung, Software-Reife, NVLink-Domäne, Scale-out-Netzwerk und akzeptierte Output-Kosten auf Ihre Workload ab. Führen Sie dann vor der Festlegung einen Topologie-Benchmark aus.
Fazit
Für KI-Cluster ist nvlink vs nvswitch kein Wettstreit zwischen zwei austauschbaren Funktionen. NVLink ist die Hochgeschwindigkeitsverbindung zwischen GPUs. NVSwitch ist das Fabric, das viele über NVLink verbundene GPUs als größere Kommunikationsdomäne nutzbar macht. InfiniBand oder Ethernet ist das Scale-out-Netzwerk um diese Domäne herum.
Die Kauflektion ist einfach: Fragen Sie nach der Topologie, nicht nur nach dem GPU-Namen. Wenn Ihre Workload durch Kommunikation begrenzt ist, kann NVSwitch zentral für die Leistung sein. Wenn Ihre Workload durch Output begrenzt ist und keine Hardwarekontrolle erfordert, benchmarken Sie einen Modell-/API-Pfad mit Flatkey, bevor Sie eine Topologie mieten, die Sie betreiben müssen.
Offizielle Referenzen
- NVIDIA, "NVIDIA NVLink and NVLink Switch"
- NVIDIA Technical Blog, "NVIDIA NVLink and NVIDIA NVSwitch Supercharge Large Language Model Inference"
- NVIDIA DGX H100/H200 User Guide
- NVIDIA DGX B200 User Guide
- NVIDIA GB200 NVL72
- NVIDIA NCCL User Guide, "Collective Operations"
- NVIDIA NCCL User Guide, "Environment Variables"


