
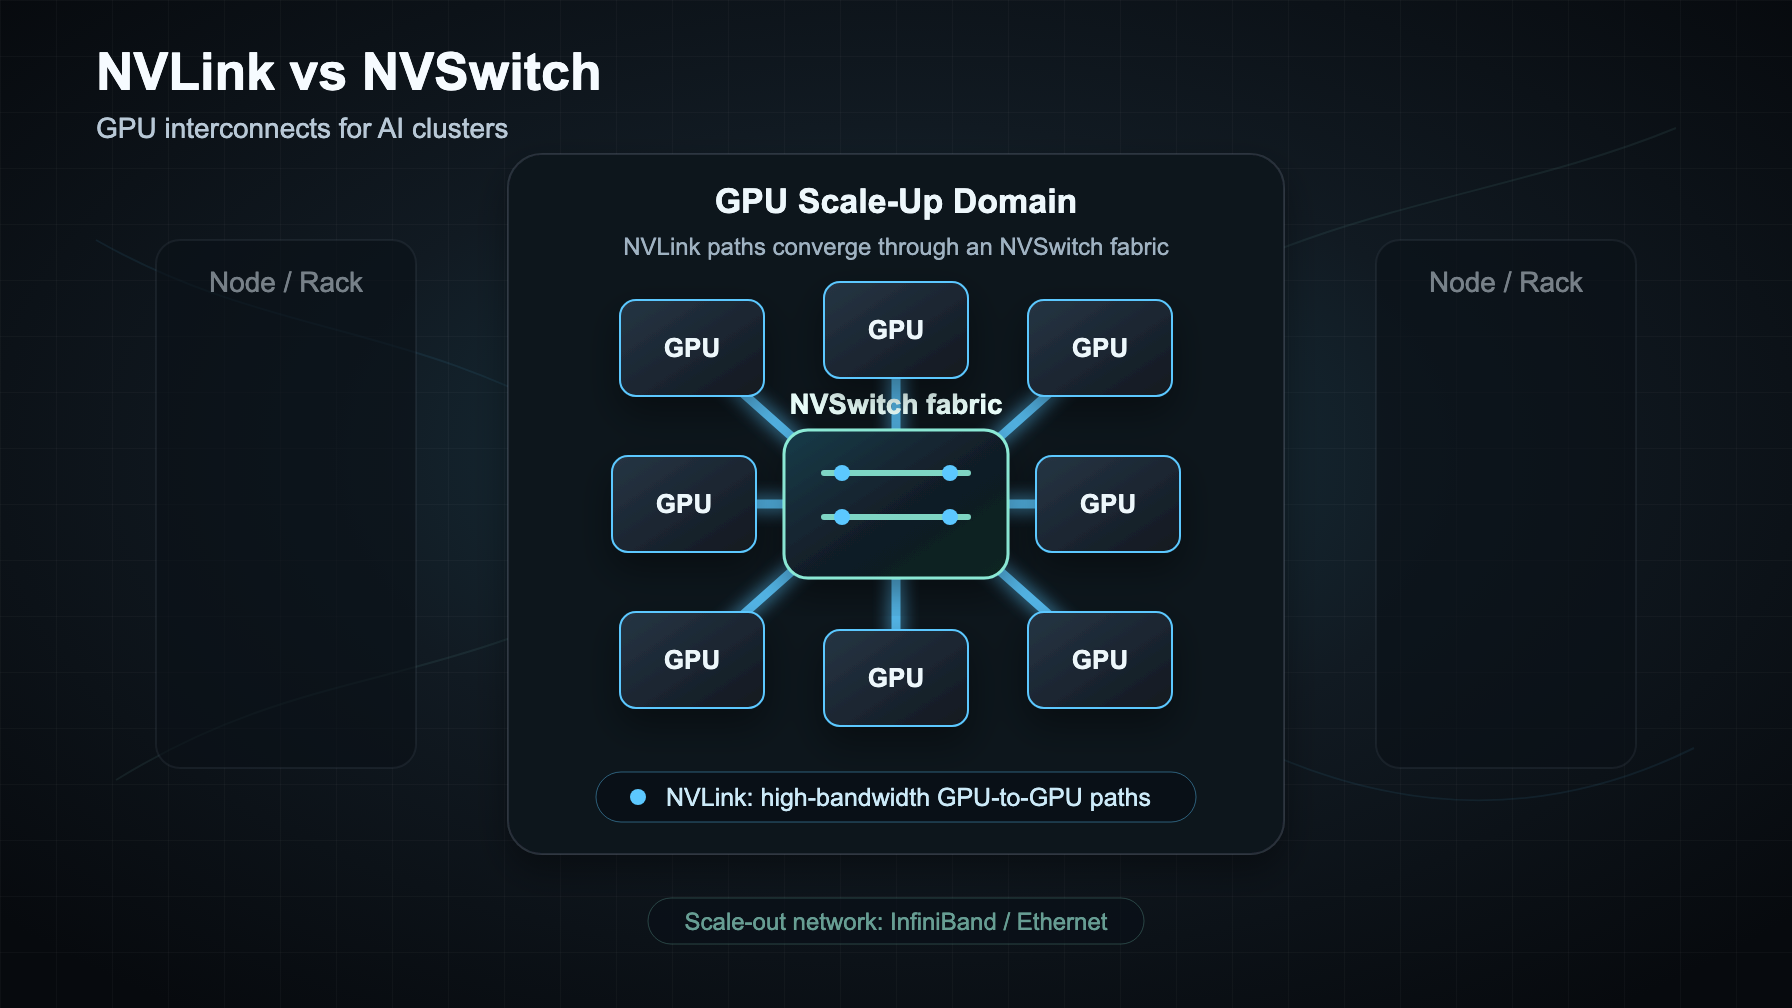
NVLink vs NVSwitch: Interconexões de GPU explicadas para clusters de IA
Se você está comparando NVLink vs NVSwitch, a resposta curta é esta:
- NVLink é o link de alta largura de banda entre GPU e GPU.
- NVSwitch é a malha de switching que permite que muitas GPUs conectadas por NVLink se comuniquem entre si sem obrigar cada par de GPUs a usar uma pequena via ponto a ponto.
- InfiniBand ou Ethernet ainda é a rede de escala horizontal que conecta sistemas, racks, storage e clusters maiores.
Essa distinção importa quando você está alugando GPUs, comprando um sistema HGX ou DGX, ou decidindo se uma carga de trabalho realmente precisa de acesso direto ao cluster em vez de uma API de modelo gerenciada. Uma GPU rápida não é suficiente se o modelo passa tempo demais esperando sincronizações de tensor parallel, all-reduce, all-gather, reduce-scatter ou tráfego all-to-all.
Este guia explica as diferenças entre nvidia nvlink vs nvswitch em termos práticos de cluster: o que cada componente faz, onde o InfiniBand se encaixa, quando a topologia altera o desempenho de LLM e quais perguntas fazer antes de se comprometer com uma cara arquitetura de cluster de GPU.
NVLink vs NVSwitch: a diferença rápida
| Camada | O que é | Escopo típico | O que melhora | O que não substitui |
|---|---|---|---|---|
| NVLink | Interconexão direta de alta largura de banda entre GPUs | Links GPU a GPU dentro de plataformas NVIDIA compatíveis | Tensor parallelism, movimentação de memória entre GPUs pares, comunicação coletiva dentro de um domínio scale-up | Não é, por si só, uma rede de cluster |
| NVSwitch | Silício de switching e malha para endpoints NVLink | Servidor multi-GPU, baseboard ou domínio NVLink em escala de rack, dependendo da plataforma | Comunicação all-to-all entre GPUs, malha GPU não bloqueante ou com maior bisseção, domínios de GPU maiores | Não elimina a necessidade de InfiniBand/Ethernet para o scale-out do cluster |
| InfiniBand / Ethernet | Malha de rede entre sistemas e racks | Node-to-node, storage, gerenciamento, clusters multirack | Treinamento distribuído em muitos nós, acesso a storage, tráfego de serviços, domínios de agendamento | Não cria largura de banda NVLink local entre GPUs dentro de um nó |
A diferença entre nvlink vs nvswitch é mais fácil de lembrar como link vs malha. NVLink é a estrada entre GPUs. NVSwitch é o entroncamento que permite que muitas dessas estradas se encontrem sem transformar cada viagem em um caminho estreito ponto a ponto.
O que o NVLink faz
NVLink é a interconexão de alta velocidade da NVIDIA para comunicação GPU a GPU. Ele foi projetado para os padrões de tráfego que ficam caros em caminhos PCIe comuns: camadas de model parallel, shards de tensor sincronizados, acesso à memória entre pares e coletivos de alta frequência.
Nas plataformas públicas atuais da NVIDIA, a geração importa:
| Geração da plataforma | Ponto de referência público da NVIDIA | Largura de banda NVLink por GPU |
|---|---|---|
| Hopper | Geração H100/H200 | 900 GB/s |
| Blackwell | Geração B200/GB200 | 1.800 GB/s |
| Vera Rubin | Plataforma de próxima geração anunciada | 3.000 GB/s preliminares |
Para um comprador de infraestrutura, esses números não garantem que toda carga de trabalho terá um ganho de velocidade correspondente. Eles indicam o teto de comunicação disponível para a topologia. O ganho real depende do tamanho do modelo, da estratégia de paralelismo, do batch size, do comprimento da sequência, do comportamento do framework, do placement e de a carga de trabalho ser limitada por comunicação.
Use o NVLink como um sinal de compra quando sua carga de trabalho usa várias GPUs para uma única requisição, um único passo de treino ou um grupo de shards do modelo. Ele é bem menos importante quando cada GPU atende trabalhos independentes com pouca comunicação entre pares.
O que o NVSwitch faz
NVSwitch é a camada de switching que conecta muitos endpoints NVLink em uma malha de GPU de maior largura de banda. Sem uma malha de switch, um sistema multi-GPU pode acabar dividindo o orçamento de links disponível de cada GPU entre muitas conexões ponto a ponto. Com o NVSwitch, sistemas compatíveis podem dar a cada GPU um caminho mais uniforme para todas as outras GPUs no domínio NVLink.
É por isso que nvswitch vs nvlink não é uma escolha entre dois substitutos. O NVSwitch usa conexões NVLink para construir uma malha. O switch é útil porque oito, dezesseis ou setenta e duas GPUs não se comportam como duas GPUs ligadas por cabos.
Nos exemplos públicos da NVIDIA:
- Sistemas DGX H100/H200 usam oito GPUs H100 ou H200 e indicam 900 GB/s de largura de banda GPU a GPU com rede de cluster via portas ConnectX-7 InfiniBand/Ethernet.
- Sistemas DGX B200 usam oito GPUs B200 e indicam dois switches NVLink de quinta geração com 14,4 TB/s de largura de banda agregada; compare os trade-offs de compra em nosso guia B200 vs H200.
- GB200 NVL72 conecta 36 CPUs Grace e 72 GPUs Blackwell em um design em escala de rack; a NVIDIA o descreve como um domínio NVLink de 72 GPUs com 130 TB/s de comunicação GPU de baixa latência. Para seleção de plataforma, veja GB200 vs B200.
O ponto prático: o NVSwitch se torna mais importante à medida que o número de GPUs em um domínio scale-up cresce e conforme mais do caminho crítico da carga de trabalho passa a ser comunicação GPU a GPU.
NVLink vs NVSwitch vs InfiniBand
A expressão nvlink vs nvswitch vs infiniband muitas vezes esconde três perguntas de projeto diferentes:
- Dentro de um único sistema de GPU: As GPUs têm largura de banda entre pares suficiente para paralelismo tensor, estágios de pipeline ou inferência em várias GPUs?
- Dentro de um domínio de escala de rack: Muitas GPUs podem atuar como um tecido acelerador maior para paralelismo de modelos grandes?
- Através de muitos nós ou racks: A rede do cluster pode transportar de forma previsível o treinamento distribuído, o carregamento de dados, o armazenamento, o checkpointing e o tráfego de serviço?
NVLink e NVSwitch respondem às duas primeiras perguntas. InfiniBand ou Ethernet respondem à terceira.
Por exemplo, um nó HGX ou DGX com oito GPUs e NVSwitch pode ser excelente para uma réplica de modelo que precisa de forte paralelismo tensor entre GPUs no nó. Se você precisa de centenas ou milhares de GPUs, ainda precisa de uma rede de expansão. Em sistemas de rack Blackwell, a NVIDIA combina grandes domínios NVLink com InfiniBand ou Ethernet Spectrum-X para escalar além do rack.
Não pergunte se o NVLink substitui o InfiniBand. Pergunte qual tráfego deve permanecer dentro do domínio NVLink e qual tráfego precisa cruzar o tecido do cluster.
Por que as cargas de trabalho de IA se importam com a topologia
As cargas de trabalho modernas de LLM não são apenas multiplicação de matrizes. Depois que um modelo é विभidido entre dispositivos, cada camada pode introduzir comunicação.
Os padrões comuns de comunicação incluem:
- All-reduce: cada rank contribui com valores e recebe o resultado reduzido.
- Reduce-scatter e all-gather: blocos de construção comuns para estratégias de paralelismo tensor e de dados.
- All-to-all: cada rank envia diferentes blocos para outros ranks, o que importa para alguns designs com paralelismo de especialistas e muita roteirização.
- Movimentação de cache KV e ativações: depende da implementação, mas geralmente é sensível à localidade e ao posicionamento.
O NCCL documenta esses coletivos como operações baseadas em ranks entre dispositivos CUDA. Isso é importante porque o software enxerga ranks, não termos de marketing. Um tecido bom só ajuda se o posicionamento dos ranks, o framework, o contêiner, as configurações do NCCL e o layout do agendador permitirem que o trabalho o use.
Na discussão da NVIDIA sobre inferência de LLM, a inferência com paralelismo tensor exige que as GPUs troquem resultados após o trabalho em uma camada do modelo antes que a próxima camada possa prosseguir. Quando essa troca é lenta, os Tensor Cores podem ficar ociosos. Esse é o motivo central pelo qual o NVSwitch pode ser importante para serving em várias GPUs.
Quando vale a pena prestar atenção ao NVSwitch
Priorize sistemas baseados em NVSwitch quando uma destas condições for verdadeira:
- Você atende modelos que precisam de paralelismo tensor entre várias GPUs para atingir metas de latência.
- Trabalhos de treinamento ou fine-tuning mostram alto tempo de coletivos nos perfis.
- Você planeja executar inferência em grandes lotes, em que a sincronização GPU a GPU aumenta com a concorrência.
- Você precisa de comunicação all-to-all previsível entre todas as GPUs em um nó com oito GPUs.
- Você está avaliando sistemas em escala de rack, como o GB200 NVL72, em que o domínio NVLink é um recurso principal do produto.
O NVSwitch é menos decisivo quando:
- Os trabalhos são embarrassingly parallel e cada GPU executa trabalho independente.
- A carga de trabalho é limitada por CPU, armazenamento ou carregamento de dados.
- O modelo cabe confortavelmente e atende em uma única GPU.
- A aplicação chama APIs de modelos hospedados e não gerencia diretamente a topologia do hardware.
- O gargalo é o tecido entre nós, em vez da comunicação GPU a GPU intra-nó.
A pergunta certa não é "Esta GPU tem NVLink?" É "Minha carga de trabalho crítica manterá várias GPUs no mesmo domínio NVLink/NVSwitch ocupadas o suficiente para justificar o prêmio?"
Lista de verificação de aquisição para sistemas NVLink vs NVSwitch
Use esta lista de verificação antes de alugar ou comprar um cluster de GPU e combine-a com uma revisão de TCO de cluster de GPU antes de assinar uma reserva longa.
| Pergunta | Por que isso importa |
|---|---|
| Qual SKU exato de GPU e formato são oferecidos? | Sistemas H100 PCIe, H100 SXM, H200, B200 e GB200 podem expor topologia e largura de banda muito diferentes. |
| O sistema é apenas ponto a ponto com NVLink, baseado em NVSwitch ou um domínio NVLink em escala de rack? | "Ter NVLink" não é suficiente. Você precisa da forma do tecido. |
| Quantas GPUs há em um domínio NVLink? | O tamanho do domínio afeta as opções de posicionamento para paralelismo tensor e paralelismo de modelo. |
| Qual é a rede entre nós: InfiniBand, RoCE, Ethernet Spectrum-X ou Ethernet comum? | O NVSwitch não corrige uma rede de expansão fraca. |
| Há testes NCCL disponíveis para o formato exato alugado? | Coletivos sintéticos revelam se a topologia, os drivers, as vias e os contêineres estão conectados corretamente. |
| É possível reservar um nó completo ou domínio? | O compartilhamento entre locatários pode quebrar suposições sobre localidade e repetibilidade. |
| As vias de rede e o posicionamento da NIC estão documentados? | O NCCL pode precisar de seleção correta de interface e posicionamento consciente das vias em escala. |
| O que acontece quando uma GPU, bandeja de switch ou NIC está degradada? | A resiliência e a política de substituição afetam o tempo de atividade em produção. |
| Qual benchmark deve ser aprovado antes de uma reserva longa? | O custo de saída aceita é mais útil do que um preço horário bruto. |
Plano de benchmark: prove o tecido antes de reservar
Para reservas de GPU de alto custo, execute um teste de aceitação da topologia antes de se comprometer com um prazo longo.
- Inventarie a topologia. Capture
nvidia-smi topo -m, GPU SKU, driver, CUDA, versão do NCCL, NICs e imagem do contêiner. - Execute coletivas do NCCL. Teste all-reduce, reduce-scatter, all-gather e all-to-all em tamanhos de mensagem que se assemelhem à sua carga de trabalho.
- Meça a latência real da carga de trabalho. Use o seu modelo real, comprimento de contexto, política de batch e configurações de paralelismo.
- Compare a colocação dentro do mesmo domínio e entre nós. Verifique se o agendador move acidentalmente ranks por caminhos mais lentos.
- Acompanhe o custo por saída aceita. Para inferência, meça tokens aceitos ou respostas bem-sucedidas por dólar, não apenas tokens por segundo. Para treinamento, meça progresso de loss ou amostras concluídas por dólar.
- Registre o comportamento de falha. Mate um worker, reinicie um contêiner ou simule uma NIC degradada, se o provedor permitir.
Se um provedor não consegue lhe informar a topologia nem executar um benchmark NCCL básico, trate isso como um sinal de risco. As tarifas por hora também precisam de contexto a partir dos preços de aluguel de GPU, compromissos de capacidade, complementos de rede e custos de execuções com falha.
Erros comuns
Erro 1: Tratar NVLink como sinônimo de NVSwitch. Uma plataforma pode expor links NVLink sem lhe dar o mesmo comportamento all-to-all de um sistema baseado em NVSwitch.
Erro 2: Assumir que o NVSwitch elimina o design de rede. O NVSwitch ajuda no domínio de GPU de scale-up. O treinamento multinó é ainda precisa de um design sério de InfiniBand ou Ethernet.
Erro 3: Comprar banda para jobs independentes. Se cada GPU executa um worker de inferência separado, o NVSwitch pode não melhorar a utilização o suficiente para justificar o custo.
Erro 4: Comparar preços horários de GPU sem topologia. Duas ofertas de "8x H100" podem se comportar de forma diferente se uma for SXM com NVSwitch e outra for PCIe ou tiver uma rede mais fraca.
Erro 5: Ignorar a alocação de software. O mapeamento de ranks do NCCL, as versões dos contêineres, a seleção da interface de rede e a política do agendador podem apagar as vantagens do hardware.
Matriz de decisão
| Carga de trabalho | Importância do NVLink | Importância do NVSwitch | Importância da rede de scale-out | Recomendação prática |
|---|---|---|---|---|
| Inferência em GPU única | Baixa | Baixa | Baixa a média | Otimize a memória da GPU, o batching e a escolha do modelo antes de pagar por NVSwitch. |
| Inferência com paralelismo de tensor em 2 a 8 GPUs | Alta | Alta em sistemas de 8 GPUs | Média | Prefira sistemas H100/H200/B200 com NVSwitch e faça benchmark da latência real. |
| Treinamento distribuído multinó | Alta dentro de cada nó | Alta dentro de cada nó | Muito alta | Avalie tanto o fabric do nó quanto InfiniBand/Ethernet; não julgue apenas pela GPU SKU. |
| Modelos com paralelismo de especialistas ou muito all-to-all | Alta | Alta | Alta ao cruzar nós | Teste all-to-all e posicionamento diretamente; a topologia pode dominar. |
| Geração offline em batch | Média | Média | Média | Meça a saída aceita por dólar; NVSwitch pode ajudar em tamanhos de batch mais altos. |
| Carga de trabalho de produto com API em primeiro lugar | Normalmente abstraída | Normalmente abstraída | Responsabilidade do provedor | Compare o controle direto da GPU com uma base de modelo/API antes de alugar hardware. |
Onde a Flatkey se encaixa
Flatkey é um gateway unificado de API para LLM: uma chave, uma fatura e um endpoint compatível com OpenAI em muitos modelos de texto, imagem e vídeo. Isso não substitui clusters de GPU diretos quando você precisa de kernels personalizados, pesos privados, controle de fine-tuning ou trabalho de desempenho específico da topologia.
É útil como base quando o objetivo do negócio é a saída, não a propriedade da infraestrutura. Antes de reservar um cluster pesado em topologia para inferência, compare o plano do cluster com um caminho gerenciado de modelo/API:
- Que qualidade e latência você obtém de modelos hospedados?
- Qual é o custo por resposta aceita após retries e gerações com falha?
- Quanto tempo de engenharia as operações do cluster vão consumir?
- A carga de trabalho exige controle direto da memória da GPU ou apenas saídas confiáveis do modelo?
Se a base de modelo/API já atende ao requisito do produto, NVLink vs NVSwitch pode ser uma otimização que você ainda não precisa assumir. Se a carga de trabalho precisa de implantação privada, serving personalizado ou metas rígidas de latência em escala, compare as vantagens de GPU cloud vs model API e, então, use a lista de verificação acima para comprar a topologia certa em vez do nome de GPU mais reconhecido.
FAQ
O NVSwitch é mais rápido que o NVLink?
O NVSwitch não é simplesmente "NVLink mais rápido". NVLink é o link da GPU. NVSwitch é o fabric que conecta vários endpoints NVLink para que muitas GPUs possam se comunicar de forma eficiente. Em sistemas compatíveis, o NVSwitch pode preservar alta largura de banda GPU a GPU em mais pares de GPU do que um layout simples ponto a ponto.
Preciso de NVSwitch para inferência de LLM?
Você precisa se preocupar com NVSwitch quando a inferência usa várias GPUs para uma réplica de modelo, especialmente paralelismo de tensor sob metas de latência ou throughput. Se cada GPU atende jobs independentes em uma única GPU, o NVSwitch pode importar muito menos.
O NVLink substitui o InfiniBand?
Não. NVLink e NVSwitch são fabrics de scale-up de GPU. InfiniBand ou Ethernet conecta nós, racks, armazenamento e clusters maiores. Sistemas de IA grandes geralmente precisam dos dois.
Qual é a maior diferença entre nvlink e nvswitch?
A maior diferença entre nvlink e nvswitch é o escopo. NVLink é um link direto de comunicação entre GPUs. NVSwitch conecta muitas GPUs equipadas com NVLink em uma malha all-to-all mais ampla.
Devo escolher H100, H200, B200 ou GB200 com base no NVSwitch?
Não escolha apenas pelo rótulo da interconexão. Combine a memória da GPU, o suporte a precisão, a disponibilidade, o resfriamento, a maturidade do software, o domínio NVLink, a rede de scale-out e o custo de saída aceito com sua carga de trabalho. Depois, execute um benchmark de topologia antes de se comprometer.
Conclusão
Para clusters de IA, nvlink vs nvswitch não é uma disputa entre dois recursos intercambiáveis. NVLink é o link de alta velocidade entre GPUs. NVSwitch é a malha que torna muitas GPUs conectadas por NVLink utilizáveis como um domínio de comunicação maior. InfiniBand ou Ethernet é a rede de scale-out em torno desse domínio.
A lição de compra é simples: peça a topologia, não apenas o nome da GPU. Se sua carga de trabalho for limitada por comunicação, o NVSwitch pode ser central para o desempenho. Se sua carga de trabalho for limitada por saída e não exigir controle de hardware, faça benchmark de um caminho de modelo/API com Flatkey antes de alugar uma topologia que você terá de operar.
Referências oficiais
- NVIDIA, "NVIDIA NVLink and NVLink Switch"
- NVIDIA Technical Blog, "NVIDIA NVLink and NVIDIA NVSwitch Supercharge Large Language Model Inference"
- NVIDIA DGX H100/H200 User Guide
- NVIDIA DGX B200 User Guide
- NVIDIA GB200 NVL72
- NVIDIA NCCL User Guide, "Collective Operations"
- NVIDIA NCCL User Guide, "Environment Variables"


