
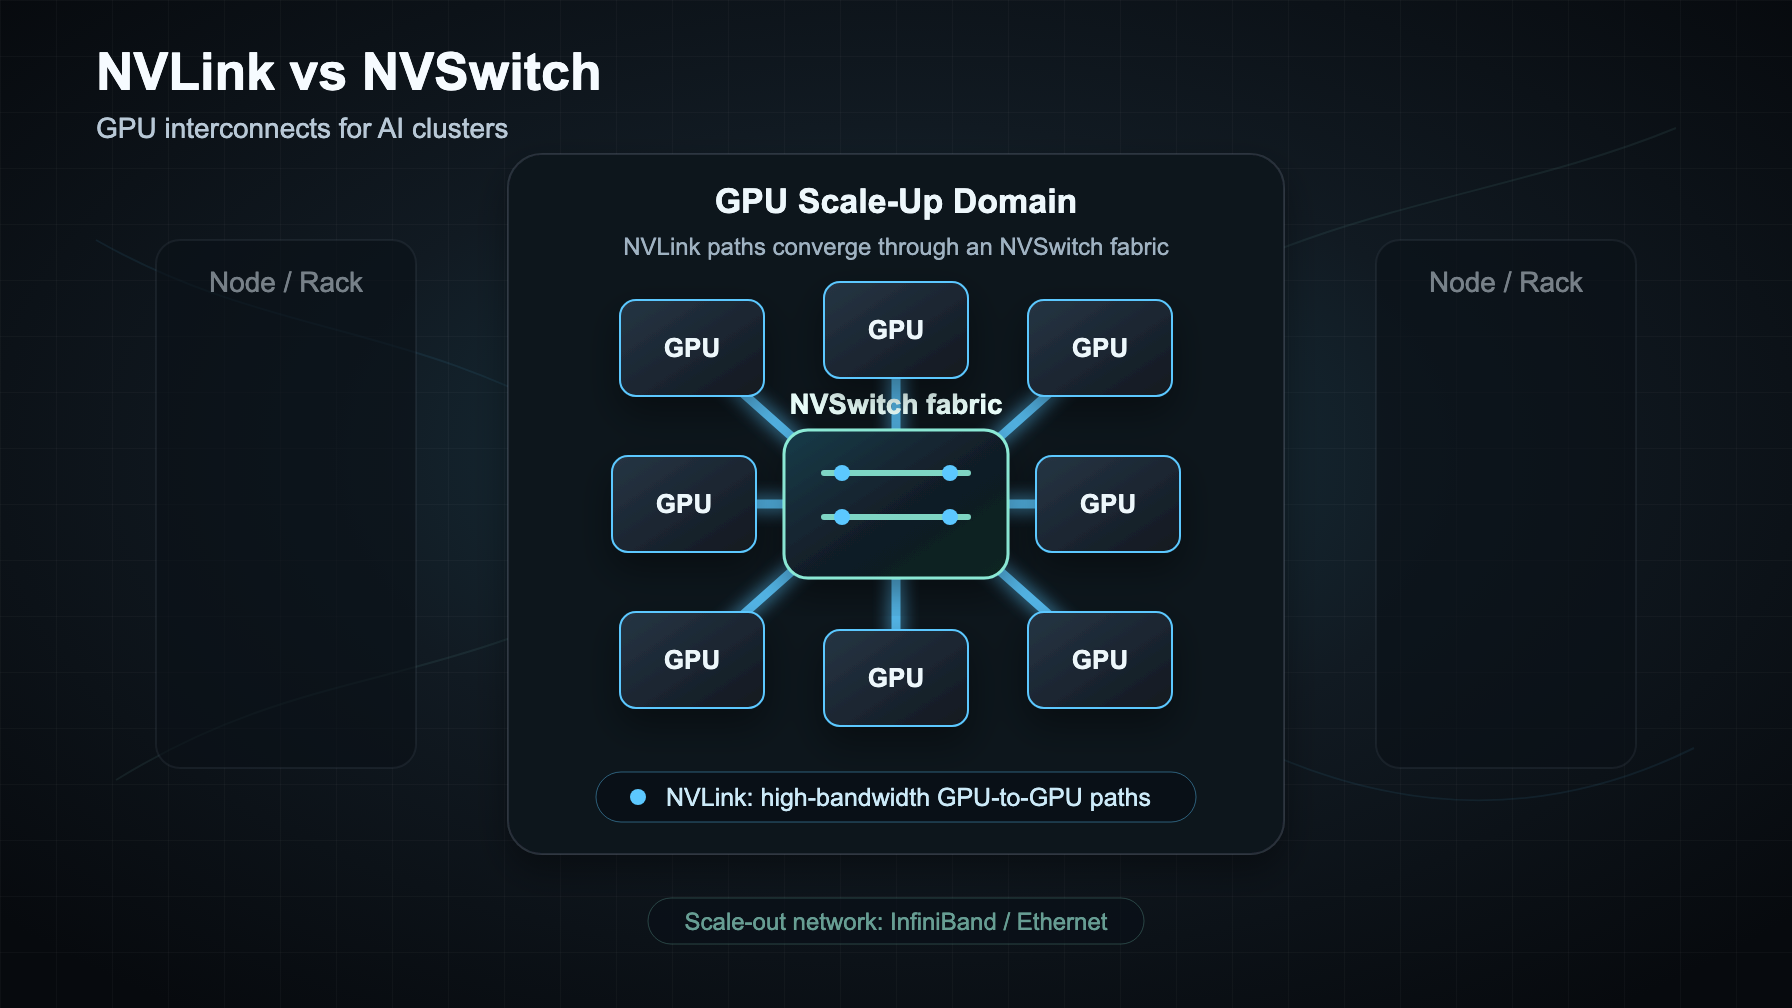
NVLink vs NVSwitch: Объяснение GPU-интерконнектов для AI-кластеров
Если вы сравниваете NVLink vs NVSwitch, короткий ответ такой:
- NVLink — это высокопропускное соединение GPU-to-GPU.
- NVSwitch — это коммутирующая fabric, которая позволяет многим GPU, подключенным через NVLink, взаимодействовать друг с другом, не заставляя каждую пару GPU работать через узкий point-to-point канал.
- InfiniBand or Ethernet по-прежнему остается сетью scale-out, которая соединяет системы, стойки, хранилища и более крупные кластеры.
Это различие важно, когда вы арендуете GPU, покупаете систему HGX или DGX или решаете, действительно ли рабочей нагрузке нужен прямой доступ к кластеру вместо управляемого model API. Быстрого GPU недостаточно, если модель слишком много времени тратит на ожидание синхронизаций tensor-parallel, all-reduce, all-gather, reduce-scatter или all-to-all трафика.
Это руководство объясняет различия nvidia nvlink vs nvswitch в практических терминах кластера: что делает каждый компонент, где место InfiniBand, когда топология влияет на производительность LLM и какие вопросы задать перед тем, как подписываться на дорогую GPU cluster architecture.
NVLink vs NVSwitch: краткая разница
| Layer | Что это | Типичный охват | Что улучшает | Что не заменяет |
|---|---|---|---|---|
| NVLink | Прямой высокопропускной GPU interconnect | Соединения GPU-to-GPU внутри поддерживаемых платформ NVIDIA | Tensor parallelism, перемещение памяти между GPU, коллективные коммуникации внутри scale-up домена | Сам по себе это не кластерная сеть |
| NVSwitch | Switch silicon и fabric для NVLink endpoints | Многопроцессорный сервер, baseboard или rack-scale NVLink domain в зависимости от платформы | GPU communication all-to-all, неблокирующая или более высокая bisection GPU fabric, более крупные GPU-домены | Он не устраняет необходимость в InfiniBand/Ethernet для cluster scale-out |
| InfiniBand / Ethernet | Сетевая fabric между системами и стойками | Node-to-node, storage, management, multi-rack clusters | Distributed training на многих узлах, доступ к хранилищу, service traffic, scheduling domains | Он не создает локальную NVLink bandwidth между GPU внутри узла |
Разницу nvlink vs nvswitch проще всего запомнить как link vs fabric. NVLink — это дорога между GPU. NVSwitch — это развязка, которая позволяет многим таким дорогам сходиться вместе, не превращая каждую поездку в узкий point-to-point маршрут.
Что делает NVLink
NVLink — это высокоскоростной interconnect NVIDIA для GPU-to-GPU communication. Он предназначен для patterns трафика, которые становятся дорогими по обычным PCIe-каналам: model parallel layers, синхронизированные tensor shards, peer memory access и высокочастотные collectives.
На текущих публичных платформах NVIDIA значение имеет поколение:
| Поколение платформы | Публичная reference point NVIDIA | NVLink bandwidth на GPU |
|---|---|---|
| Hopper | Поколение H100/H200 | 900 GB/s |
| Blackwell | Поколение B200/GB200 | 1,800 GB/s |
| Vera Rubin | Анонсированная платформа следующего поколения | 3,000 GB/s preliminary |
Для покупателя инфраструктуры эти цифры не означают, что каждая рабочая нагрузка получит сопоставимый прирост скорости. Они показывают потолок коммуникаций, доступный топологии. Реальный выигрыш зависит от размера модели, стратегии parallelism, batch size, sequence length, поведения framework, размещения и того, ограничена ли рабочая нагрузка коммуникациями.
Используйте NVLink как сигнал к покупке, когда ваша рабочая нагрузка использует несколько GPU для одного запроса, одного training step или одной группы model shard. Это намного менее важно, когда каждый GPU обслуживает независимые задачи с небольшим объемом peer communication.
Что делает NVSwitch
NVSwitch — это switching layer, который соединяет многие NVLink endpoints в более высокопропускную GPU fabric. Без switch fabric многопроцессорная система может распределить доступный каждому GPU link budget по множеству point-to-point соединений. С NVSwitch поддерживаемые системы могут дать каждому GPU более равномерный путь к каждому другому GPU в NVLink domain.
Именно поэтому nvswitch vs nvlink — это не выбор между двумя заменами. NVSwitch использует соединения NVLink, чтобы построить fabric. Коммутатор полезен потому, что восемь, шестнадцать или семьдесят два GPU не ведут себя как два GPU, соединенные кабелем.
В публичных примерах NVIDIA:
- Системы DGX H100/H200 используют восемь GPU H100 или H200 и указывают 900 GB/s GPU-to-GPU bandwidth с cluster networking через порты ConnectX-7 InfiniBand/Ethernet.
- Системы DGX B200 используют восемь GPU B200 и указывают два NVLink switch пятого поколения с 14.4 TB/s aggregate bandwidth; сравните компромиссы при покупке в нашем руководстве B200 vs H200.
- GB200 NVL72 соединяет 36 процессоров Grace и 72 GPU Blackwell в rack-scale design; NVIDIA описывает его как 72-GPU NVLink domain с 130 TB/s low-latency GPU communication. Для выбора платформы см. GB200 vs B200.
Практический вывод: NVSwitch становится важнее по мере роста числа GPU в одном scale-up domain и по мере того, как все большая часть критического пути рабочей нагрузки становится GPU-to-GPU communication.
NVLink vs NVSwitch vs InfiniBand
Фраза nvlink vs nvswitch vs infiniband часто скрывает три разных вопроса проектирования:
- Внутри одной GPU-системы: хватает ли у GPU пропускной способности для peer-to-peer для tensor parallelism, pipeline stages или multi-GPU inference?
- Внутри одного rack-scale домена: могут ли многие GPU работать как один более крупный accelerator fabric для крупномасштабного model parallelism?
- Между многими узлами или стойками: может ли сеть кластера предсказуемо передавать трафик распределённого обучения, загрузки данных, хранения, checkpointing и сервисный трафик?
NVLink и NVSwitch отвечают на первые два вопроса. InfiniBand или Ethernet отвечают на третий.
Например, восьми-GPU узел HGX или DGX с NVSwitch может отлично подойти для model replica, которой нужна жёсткая tensor parallelism между GPU в узле. Если вам нужны сотни или тысячи GPU, вам всё равно нужна scale-out сеть. В rack-системах Blackwell NVIDIA сочетает большие домены NVLink с InfiniBand или Spectrum-X Ethernet, чтобы масштабироваться за пределы стойки.
Не спрашивайте, заменяет ли NVLink InfiniBand. Спрашивайте, какой трафик должен оставаться внутри домена NVLink, а какой трафик должен пересекать cluster fabric.
Почему AI-нагрузкам важна топология
Современные LLM-нагрузки — это не просто умножение матриц. Как только модель разделяется между устройствами, каждый слой может создавать необходимость в обмене данными.
К распространённым шаблонам обмена данными относятся:
- All-reduce: каждый rank вносит значения и получает reduced result.
- Reduce-scatter и all-gather: распространённые базовые блоки для стратегий tensor и data parallel.
- All-to-all: каждый rank отправляет разные фрагменты другим rank'ам, что важно для некоторых экспертно-параллельных и heavily routing-oriented архитектур.
- Перемещение KV cache и activations: зависит от реализации, но часто чувствительно к локальности и размещению.
NCCL описывает эти collective-операции как операции на основе rank'ов между CUDA-устройствами. Это важно, потому что программное обеспечение видит rank'и, а не маркетинговые термины. Хороший fabric помогает только если размещение rank'ов, framework, container, настройки NCCL и раскладка scheduler'а позволяют задаче использовать его.
В обсуждении LLM inference от NVIDIA tensor-parallel inference требует, чтобы GPU обменялись результатами после работы над слоем модели, прежде чем сможет продолжиться следующий слой. Когда этот обмен медленный, Tensor Cores могут простаивать. В этом и состоит ключевая причина, почему NVSwitch может быть важен для multi-GPU serving.
Когда на NVSwitch стоит обратить внимание
Отдавайте приоритет системам на базе NVSwitch, когда верно одно из следующих условий:
- Вы обслуживаете модели, которым нужна tensor parallelism на нескольких GPU, чтобы уложиться в latency targets.
- Задачи обучения или fine-tuning показывают высокое время collective-операций в профайлерах.
- Вы планируете выполнять large batch inference, где синхронизация GPU-to-GPU растёт с concurrency.
- Вам нужна предсказуемая all-to-all коммуникация между всеми GPU в восьми-GPU узле.
- Вы оцениваете rack-scale системы, такие как GB200 NVL72, где домен NVLink является ключевой особенностью продукта.
NVSwitch менее критичен, когда:
- Задачи embarrassingly parallel и каждый GPU выполняет независимую работу.
- Нагрузка ограничена CPU, storage или data-loader bottleneck'ом.
- Модель удобно помещается на одном GPU и обслуживается на нём.
- Приложение вызывает hosted model APIs и не управляет hardware topology напрямую.
- Узким местом является inter-node fabric, а не intra-node GPU communication.
Правильный вопрос не: "Есть ли у этого GPU NVLink?" Правильный вопрос: "Будет ли моя критически важная нагрузка достаточно загружать несколько GPU в одном домене NVLink/NVSwitch, чтобы оправдать надбавку?"
Чек-лист для закупки систем NVLink vs NVSwitch
Используйте этот чек-лист перед арендой или покупкой GPU-кластера и дополните его проверкой TCO GPU-кластера перед подписанием долгосрочной резервации.
| Вопрос | Почему это важно |
|---|---|
| Какой именно GPU SKU и form factor предлагается? | H100 PCIe, H100 SXM, H200, B200 и системы GB200 могут иметь очень разную топологию и пропускную способность. |
| Система только point-to-point на NVLink, на базе NVSwitch или это rack-scale домен NVLink? | "Есть NVLink" — этого недостаточно. Вам нужна форма fabric. |
| Сколько GPU находится в одном домене NVLink? | Размер домена влияет на варианты размещения для tensor parallel и model-parallel. |
| Какова inter-node сеть: InfiniBand, RoCE, Spectrum-X Ethernet или обычный Ethernet? | NVSwitch не исправит слабую scale-out сеть. |
| Доступны ли NCCL-тесты для точно такой же арендованной конфигурации? | Синтетические collective-операции показывают, корректно ли настроены topology, драйверы, rails и containers. |
| Можно ли закрепить за собой полный узел или домен? | Shared tenancy может нарушить предположения о локальности и повторяемости. |
| Документированы ли network rails и размещение NIC? | Масштабу NCCL может потребоваться правильный выбор интерфейса и placement с учётом rails. |
| Что происходит, если один GPU, лоток коммутатора или NIC деградирует? | Надёжность и политика замены влияют на uptime production. |
| Какой benchmark должен пройти перед долгосрочной резервацией? | Стоимость за accepted-output полезнее, чем просто почасовая цена. |
План бенчмарка: проверьте fabric до резервации
Для дорогих GPU-резерваций выполните topology acceptance test, прежде чем брать обязательство на долгий срок.
- Инвентаризируйте топологию. Зафиксируйте
nvidia-smi topo -m, SKU GPU, драйвер, CUDA, версию NCCL, NIC и образ контейнера. - Запустите коллективные операции NCCL. Проверьте all-reduce, reduce-scatter, all-gather и all-to-all на размерах сообщений, похожих на вашу рабочую нагрузку.
- Измерьте задержку реальной рабочей нагрузки. Используйте вашу фактическую модель, длину контекста, политику batch и настройки параллелизма.
- Сравните размещение внутри домена и между узлами. Проверьте, не переводит ли планировщик случайно ранги на более медленные пути.
- Отслеживайте стоимость на принятый вывод. Для инференса измеряйте количество принятых токенов или успешных ответов на доллар, а не только токены в секунду. Для обучения измеряйте прогресс по loss или завершённые сэмплы на доллар.
- Фиксируйте поведение при сбоях. Завершите worker, перезапустите контейнер или смоделируйте деградацию NIC, если провайдер это позволяет.
Если провайдер не может показать вам топологию или запустить базовый бенчмарк NCCL, считайте это сигналом риска. Почасовые ставки тоже нужно рассматривать в контексте цен аренды GPU, обязательств по мощности, сетевых доплат и затрат на неудачные запуски.
Распространённые ошибки
Ошибка 1: Считать NVLink синонимом NVSwitch. Платформа может предоставлять соединения NVLink, не давая того же поведения all-to-all, что и система на базе NVSwitch.
Ошибка 2: Предполагать, что NVSwitch устраняет необходимость в сетевом проектировании. NVSwitch помогает в scale-up-домене GPU. Многоузловое обучение по-прежнему требует серьёзной архитектуры InfiniBand или Ethernet.
Ошибка 3: Покупать пропускную способность для независимых задач. Если каждый GPU запускает отдельный inference worker, NVSwitch может не улучшить утилизацию настолько, чтобы оправдать стоимость.
Ошибка 4: Сравнивать почасовые цены на GPU без учёта топологии. Два предложения "8x H100" могут вести себя по-разному, если одно — SXM с NVSwitch, а другое — PCIe или с более слабой сетью.
Ошибка 5: Игнорировать размещение в ПО. Распределение рангов NCCL, версии контейнеров, выбор сетевого интерфейса и политика планировщика могут свести на нет преимущества железа.
Матрица решений
| Рабочая нагрузка | Важность NVLink | Важность NVSwitch | Важность масштабирования по сети | Практическая рекомендация |
|---|---|---|---|---|
| Инференс на одном GPU | Низкая | Низкая | От низкой до средней | Оптимизируйте память GPU, batching и выбор модели, прежде чем платить за NVSwitch. |
| Tensor-parallel инференс на 2-8 GPU | Высокая | Высокая на системах с 8 GPU | Средняя | Предпочитайте системы H100/H200/B200 на базе NVSwitch и измеряйте реальную задержку. |
| Распределённое обучение на нескольких узлах | Высокая внутри каждого узла | Высокая внутри каждого узла | Очень высокая | Оценивайте и fabric узла, и InfiniBand/Ethernet; не судите только по SKU GPU. |
| Expert-parallel или модели с интенсивным all-to-all | Высокая | Высокая | Высокая при переходе между узлами | Тестируйте all-to-all и размещение напрямую; топология может доминировать. |
| Пакетная офлайн-генерация | Средняя | Средняя | Средняя | Измеряйте принятый вывод на доллар; NVSwitch может помочь при больших batch sizes. |
| Нагрузка продукта с API-first | Обычно абстрагирована | Обычно абстрагирована | Ответственность провайдера | Сравните прямое управление GPU с базовым вариантом на модели/API, прежде чем арендовать железо. |
Где здесь Flatkey
Flatkey — это единый шлюз API для LLM: один ключ, один счёт и OpenAI-совместимая конечная точка для множества текстовых, графических и видео-моделей. Это не заменяет прямые GPU-кластеры, когда вам нужны собственные kernels, приватные веса, контроль fine-tuning или работа с производительностью под конкретную топологию.
Это полезно как базовая точка отсчёта, когда бизнес-цель — результат, а не владение инфраструктурой. Перед тем как резервировать кластер с тяжёлой топологией для инференса, сравните план кластера с управляемым маршрутом через модель/API:
- Какое качество и задержку вы получаете от hosted-моделей?
- Какова стоимость одного принятого ответа после повторов и неудачных генераций?
- Сколько инженерного времени потребует эксплуатация кластера?
- Требует ли рабочая нагрузка прямого контроля памяти GPU или только надёжных выходов модели?
Если базовый вариант на модели/API уже соответствует требованиям продукта, NVLink vs NVSwitch может быть оптимизацией, которую вам пока не нужно брать на себя. Если же нагрузке нужны приватное развёртывание, кастомный serving или жёсткие целевые задержки в масштабе, сравните компромиссы GPU cloud vs model API, а затем используйте чек-лист выше, чтобы купить правильную топологию, а не самый узнаваемый GPU-бренд.
FAQ
NVSwitch быстрее, чем NVLink?
NVSwitch — это не просто «более быстрый NVLink». NVLink — это GPU-соединение. NVSwitch — это fabric, который соединяет несколько конечных точек NVLink, чтобы многие GPU могли эффективно обмениваться данными. В поддерживаемых системах NVSwitch может сохранять высокую пропускную способность GPU-to-GPU для большего числа пар GPU, чем простая point-to-point схема.
Нужен ли мне NVSwitch для инференса LLM?
Вам нужно учитывать NVSwitch, когда инференс использует несколько GPU для одной реплики модели, особенно при tensor parallelism и целевых ограничениях по задержке или пропускной способности. Если каждый GPU обслуживает независимые задачи на одном GPU, NVSwitch может быть гораздо менее важен.
Заменяет ли NVLink InfiniBand?
Нет. NVLink и NVSwitch — это scale-up fabric для GPU. InfiniBand или Ethernet соединяют узлы, стойки, хранилище и более крупные кластеры. Крупные AI-системы часто нуждаются в обоих.
В чём главное различие nvlink vs nvswitch?
Самое большое отличие между nvlink и nvswitch — это масштаб. NVLink — это прямое соединение для связи между GPU. NVSwitch объединяет множество GPU с NVLink в более широкую fabric-сеть «все со всеми».
Стоит ли выбирать H100, H200, B200 или GB200, ориентируясь на NVSwitch?
Не выбирайте только по названию интерконнекта. Сопоставьте объем памяти GPU, поддержку нужной точности, доступность, охлаждение, зрелость ПО, домен NVLink, масштабируемую сеть и допустимую стоимость вывода с вашей рабочей нагрузкой. Затем перед окончательным решением выполните бенчмарк топологии.
Заключение
Для AI-кластеров nvlink vs nvswitch — это не противостояние двух взаимозаменяемых функций. NVLink — это высокоскоростная связь между GPU. NVSwitch — это fabric, который делает множество GPU, соединенных через NVLink, пригодными для использования как более крупного домена связи. InfiniBand или Ethernet — это масштабируемая сеть вокруг этого домена.
Простой вывод для закупки: запрашивайте топологию, а не только название GPU. Если ваша нагрузка ограничена коммуникациями, NVSwitch может быть ключевым фактором производительности. Если ваша нагрузка ограничена выводом и не требует аппаратного управления, протестируйте путь модели/API с Flatkey, прежде чем арендовать топологию, которую вам придется обслуживать.
Официальные источники
- NVIDIA, "NVIDIA NVLink and NVLink Switch"
- Технический блог NVIDIA, "NVIDIA NVLink and NVIDIA NVSwitch Supercharge Large Language Model Inference"
- Руководство пользователя NVIDIA DGX H100/H200
- Руководство пользователя NVIDIA DGX B200
- NVIDIA GB200 NVL72
- Руководство пользователя NVIDIA NCCL, "Collective Operations"
- Руководство пользователя NVIDIA NCCL, "Environment Variables"


