
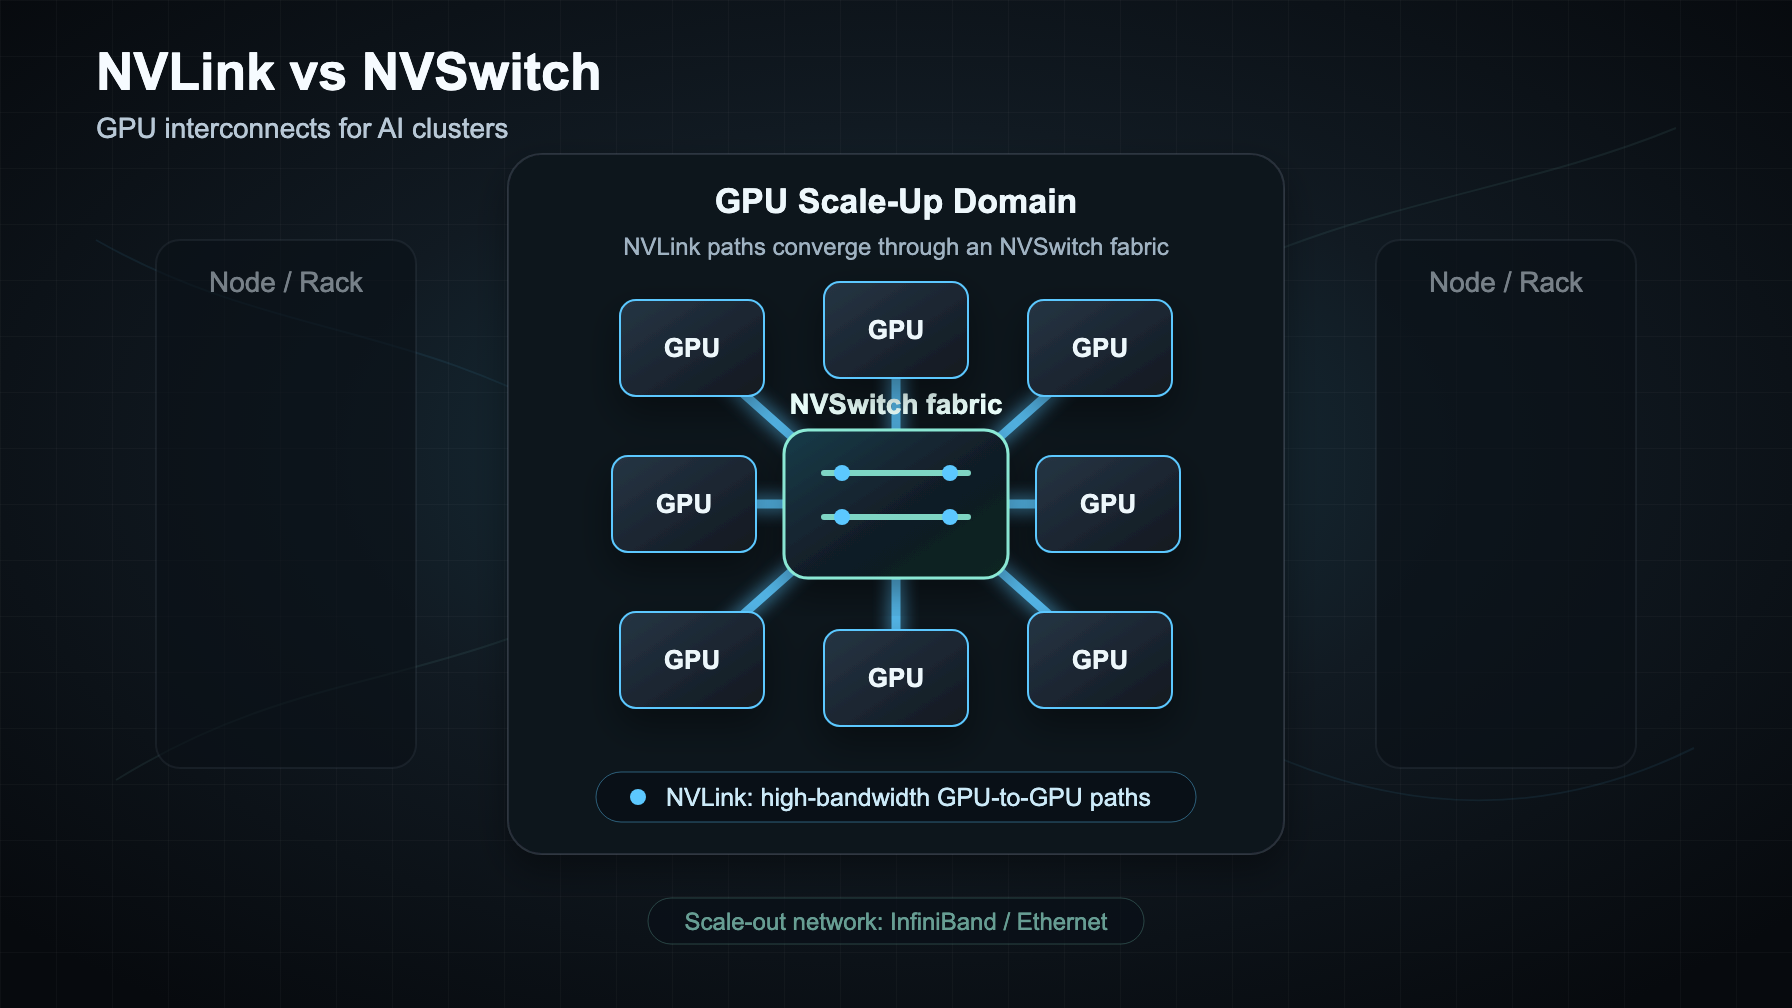
NVLink vs NVSwitch: AIクラスター向けGPUインターコネクトを解説
NVLink vs NVSwitch を比較しているなら、簡単に言うと次のとおりです:
- NVLink は、高帯域幅のGPU間リンクです。
- NVSwitch は、NVLinkで接続された多数のGPUが、すべてのGPUペアを狭いポイントツーポイントのレーンに押し込むことなく相互通信できるようにするスイッチングファブリックです。
- InfiniBand または Ethernet は、システム、ラック、ストレージ、より大規模なクラスターを接続するスケールアウトネットワークのままです。
GPUをレンタルする場合、HGXやDGXシステムを購入する場合、あるいはワークロードにマネージドモデルAPIではなく直接のクラスターアクセスが本当に必要かを判断する場合、この違いは重要です。テンソル並列同期、all-reduce、all-gather、reduce-scatter、all-to-allトラフィックを待つ時間が長すぎるなら、高速なGPUだけでは不十分です。
このガイドでは、nvidia nvlink vs nvswitch の違いを実用的なクラスターの観点から説明します。各コンポーネントの役割、InfiniBand の位置づけ、どのトポロジーがLLM性能を変えるのか、そして高価な GPU cluster architecture に踏み切る前に何を確認すべきかを解説します。
NVLink vs NVSwitch: すぐわかる違い
| レイヤー | それは何か | 典型的な範囲 | 改善するもの | 置き換えられないもの |
|---|---|---|---|---|
| NVLink | GPU間の直接的な高帯域幅インターコネクト | 対応するNVIDIAプラットフォーム内のGPU間リンク | テンソル並列、ピアGPUメモリ転送、スケールアップ領域内の集団通信 | それ自体はクラスター網にはならない |
| NVSwitch | NVLinkエンドポイント向けのスイッチシリコンとファブリック | プラットフォームに応じたマルチGPUサーバー、ベースボード、またはラックスケールのNVLink領域 | 全対全GPU通信、ノンブロッキングまたはより高いビセクション帯域のGPUファブリック、より大きなGPUドメイン | クラスターのスケールアウトにはInfiniBand/Ethernetが依然として必要 |
| InfiniBand / Ethernet | システム間およびラック間のネットワークファブリック | ノード間、ストレージ、管理、マルチラッククラスター | 多ノードにまたがる分散学習、ストレージアクセス、サービストラフィック、スケジューリング領域 | ノード内GPU間のローカルなNVLink帯域幅は作り出せない |
nvlink vs nvswitch の違いは、リンク対ファブリック と覚えるのが最も簡単です。NVLink はGPU間の道路です。NVSwitch は、各移動を狭いポイントツーポイント経路にせずに、それらの道路を多数合流させる立体交差です。
NVLink の役割
NVLink は、GPU間通信のためのNVIDIAの高速インターコネクトです。通常のPCIe経路では高コストになるトラフィックパターン、つまりモデル並列レイヤー、同期されたテンソルシャード、ピアメモリアクセス、高頻度の集団通信向けに設計されています。
現在の公開NVIDIAプラットフォームでは、世代が重要です:
| プラットフォーム世代 | 公開NVIDIAの参照点 | GPUあたりのNVLink帯域幅 |
|---|---|---|
| Hopper | H100/H200世代 | 900 GB/s |
| Blackwell | B200/GB200世代 | 1,800 GB/s |
| Vera Rubin | 発表済みの次世代プラットフォーム | 3,000 GB/s の予備値 |
インフラ購入者にとって、これらの数値は、すべてのワークロードが同じ比率で高速化されることを保証するものではありません。トポロジーが提供できる通信上限を示しています。実際の改善は、モデルサイズ、並列化戦略、バッチサイズ、シーケンス長、フレームワークの挙動、配置、そしてワークロードが通信ボトルネックかどうかに左右されます。
1回のリクエスト、1回の学習ステップ、または1つのモデルシャードグループで複数GPUを使うワークロードなら、NVLink は購入判断の強い材料になります。各GPUがほとんどピア通信のない独立ジョブを処理する場合は、重要度はかなり低くなります。
NVSwitch の役割
NVSwitch は、複数のNVLinkエンドポイントをより高帯域なGPUファブリックに接続するスイッチング層です。スイッチファブリックがなければ、マルチGPUシステムでは各GPUが使えるリンク予算を多数のポイントツーポイント接続に分割することになりがちです。NVSwitch があると、対応システムではNVLinkドメイン内の各GPUから他のGPUへの経路をより均一にできます。
だからこそ nvswitch vs nvlink は、代替手段同士の選択ではありません。NVSwitch はNVLink接続を使ってファブリックを構築します。スイッチが有用なのは、8基、16基、あるいは72基のGPUは、2基のGPUをケーブルでつないだだけの状態とは振る舞いが違うからです。
公開されているNVIDIAの例では:
- DGX H100/H200 システムは8基のH100またはH200 GPUを搭載し、ConnectX-7 InfiniBand/Ethernetポート経由のクラスター接続とともに、GPU間帯域幅900 GB/sを示しています。
- DGX B200 システムは8基のB200 GPUを搭載し、第5世代NVLinkスイッチ2基と合計14.4 TB/sの帯域幅を示しています。購入上の比較は、B200 vs H200 ガイドをご覧ください。
- GB200 NVL72 は、36基のGrace CPUと72基のBlackwell GPUをラックスケール設計で接続します。NVIDIAはこれを、130 TB/sの低遅延GPU通信を備えた72-GPUのNVLinkドメインと説明しています。プラットフォーム選定については、GB200 vs B200 を参照してください。
実務上の要点は、1つのスケールアップ領域内のGPU数が増えるほど、そしてワークロードのクリティカルパスのより多くがGPU間通信になるほど、NVSwitch の重要性が増すということです。
NVLink vs NVSwitch vs InfiniBand
nvlink vs nvswitch vs infiniband という表現の背後には、しばしば3つの異なる設計上の問いが隠れています:
- 1つのGPUシステム内: GPUは、テンソル並列、パイプラインステージ、またはマルチGPU推論に十分なピア帯域幅を持っているか?
- 1つのラックスケール・ドメイン内: 多数のGPUが、より大きなアクセラレータ・ファブリックとして機能し、大規模なモデル並列を実現できるか?
- 複数ノードまたはラックをまたいで: クラスタネットワークは、分散学習、データ読み込み、ストレージ、チェックポイント作成、サービス系トラフィックを予測可能に運べるか?
NVLinkとNVSwitchは最初の2つの質問に答えます。InfiniBandまたはEthernetは3つ目に答えます。
たとえば、NVSwitchを備えた8 GPUのHGXまたはDGXノードは、ノード内のGPU間で緊密なテンソル並列を必要とするモデルレプリカに非常に適しています。何百、何千ものGPUが必要な場合は、依然としてスケールアウトネットワークが必要です。Blackwellのラックシステムでは、NVIDIAは大規模なNVLinkドメインをInfiniBandまたはSpectrum-X Ethernetと組み合わせ、ラックを超えてスケールできるようにしています。
NVLinkがInfiniBandを置き換えるかどうかを問うのではありません。どのトラフィックをNVLinkドメイン内に留めるべきか、どのトラフィックがクラスタファブリックを越えなければならないかを問うべきです。
AIワークロードがトポロジを気にする理由
現代のLLMワークロードは単なる行列積ではありません。モデルがデバイス間に分割されると、各レイヤーで通信が発生し得ます。
一般的な通信パターンには次のものがあります。
- All-reduce: 各rankが値を提供し、縮約結果を受け取ります。
- Reduce-scatterとall-gather: テンソル並列およびデータ並列戦略の一般的な構成要素です。
- All-to-all: 各rankが他のrankへ異なるチャンクを送信します。これは一部のエキスパート並列やルーティング重視の設計で重要です。
- KVキャッシュとアクティベーションの移動: 実装依存ですが、多くの場合、局所性と配置に敏感です。
NCCLは、これらの集団通信をCUDAデバイス間のrankベースの操作として文書化しています。これは、ソフトウェアが見るのはマーケティング用語ではなくrankだから重要です。優れたファブリックでも、rankの配置、フレームワーク、コンテナ、NCCL設定、スケジューラのレイアウトがジョブにそれを使わせられなければ意味がありません。
NVIDIAのLLM推論の解説では、テンソル並列推論では、次のレイヤーに進む前に、GPUがあるモデルレイヤーでの処理後に結果を交換する必要があります。この交換が遅いと、Tensor Coreは待機状態になります。これが、マルチGPUサービスでNVSwitchが重要になり得る根本的な理由です。
NVSwitchを重視すべき場面
次のいずれかに当てはまる場合は、NVSwitch対応システムを優先してください。
- レイテンシ目標を満たすために、複数GPUにまたがるテンソル並列が必要なモデルを提供している。
- トレーニングやファインチューニングのジョブで、プロファイラ上の集団通信時間が高い。
- GPU間同期が並列度の増加とともに増える大規模バッチ推論を実行する予定である。
- 8 GPUノード全体で、予測可能なall-to-all通信が必要である。
- GB200 NVL72のようなラックスケールシステムを評価しており、NVLinkドメインが主要な製品機能である。
NVSwitchの重要性が相対的に低いのは、次の場合です。
- ジョブが完全に独立しており、各GPUがそれぞれ独自の作業を実行する。
- ワークロードがCPU、ストレージ、またはデータローダーにボトルネックを持つ。
- モデルが1つのGPUに無理なく収まり、そのまま提供できる。
- アプリケーションがホスト型モデルAPIを呼び出し、ハードウェアのトポロジを直接管理しない。
- ボトルネックがノード内GPU通信ではなく、ノード間ファブリックにある。
正しい問いは「このGPUはNVLinkを搭載しているか?」ではありません。「自分の重要なワークロードは、プレミアムを正当化できるほど、同じNVLink/NVSwitchドメイン内の複数GPUを十分に使い切るか?」です。
NVLink対NVSwitchシステムの調達チェックリスト
GPUクラスタをレンタルまたは購入する前にこのチェックリストを使い、長期予約を結ぶ前にGPUクラスタTCOの確認と組み合わせてください。
| 質問 | 重要な理由 |
|---|---|
| 提供される正確なGPU SKUとフォームファクタは何か? | H100 PCIe、H100 SXM、H200、B200、GB200システムは、トポロジと帯域幅が大きく異なる場合があります。 |
| システムはNVLinkのみのポイントツーポイントか、NVSwitch対応か、またはラックスケールのNVLinkドメインか? | 「NVLinkを搭載している」だけでは不十分です。必要なのはファブリックの形です。 |
| 1つのNVLinkドメインに何枚のGPUがあるか? | ドメインサイズは、テンソル並列やモデル並列の配置オプションに影響します。 |
| ノード間ネットワークは何か: InfiniBand、RoCE、Spectrum-X Ethernet、または通常のEthernetか? | NVSwitchは弱いスケールアウトネットワークを修正しません。 |
| 借りる形状に対するNCCLテストは利用できるか? | 合成的な集団通信は、トポロジ、ドライバ、レール、コンテナが正しく配線されているかを明らかにします。 |
| ノード全体またはドメイン全体を専有できるか? | 共有テナンシーは、局所性と再現性に関する前提を崩す可能性があります。 |
| ネットワークレールとNICの配置は文書化されているか? | NCCLは、規模が大きい場合に正しいインターフェース選択とレールを意識した配置を必要とすることがあります。 |
| GPU、スイッチトレイ、またはNICの1つが劣化した場合はどうなるか? | 耐障害性と交換ポリシーは、本番稼働時間に影響します。 |
| 長期予約の前に通過すべきベンチマークは何か? | 受け入れ済み出力のコストは、単純な時間単価よりも有用です。 |
ベンチマーク計画: 予約前にファブリックを検証する
高コストのGPU予約では、長期契約にコミットする前にトポロジ受け入れテストを実行してください。
- トポロジを棚卸しする。
nvidia-smi topo -m、GPU SKU、ドライバ、CUDA、NCCL バージョン、NIC、コンテナイメージを取得する。 - NCCL の集団通信を実行する。 ワークロードに近いメッセージサイズで、all-reduce、reduce-scatter、all-gather、all-to-all をテストする。
- 実ワークロードのレイテンシを測定する。 実際のモデル、コンテキスト長、バッチ方針、並列化設定を使う。
- 同一ドメイン内とクロスノード配置を比較する。 スケジューラが誤って rank をより遅い経路に移していないか確認する。
- 受理済み出力あたりのコストを追跡する。 推論では、トークン毎秒だけでなく、受理済みトークン数や成功レスポンス数をドルあたりで測定する。学習では、ロスの進捗や完了サンプル数をドルあたりで測定する。
- 障害時の挙動を記録する。 ベンダーが許すなら、ワーカーを停止し、コンテナを再起動し、または劣化した NIC をシミュレートする。
ベンダーがトポロジを教えられない、または基本的な NCCL ベンチマークを実行できない場合は、それをリスクシグナルとして扱うべきです。時間単価も、GPU レンタル価格、容量のコミット、ネットワークの追加料金、失敗実行のコストとあわせて考える必要があります。
よくある間違い
間違い 1: NVLink を NVSwitch の同義語として扱う。 プラットフォームは NVLink リンクを備えていても、NVSwitch ベースのシステムと同じ all-to-all 動作を提供するとは限りません。
間違い 2: NVSwitch がネットワーク設計を不要にすると考える。 NVSwitch はスケールアップの GPU ドメインを支援します。マルチノード学習には、依然として本格的な InfiniBand または Ethernet 設計が必要です。
間違い 3: 独立ジョブのために帯域幅を買う。 すべての GPU が別々の推論ワーカーを動かすなら、NVSwitch はコストを正当化するほど利用率を改善しない可能性があります。
間違い 4: トポロジなしで時間単価の GPU 価格を比較する。 2 つの「8x H100」オファーでも、一方が NVSwitch 付きの SXM で、もう一方が PCIe だったりネットワークが弱かったりすると、挙動は異なります。
間違い 5: ソフトウェア配置を無視する。 NCCL の rank マッピング、コンテナのバージョン、ネットワークインターフェースの選択、スケジューラポリシーによって、ハードウェアの優位性は消えてしまうことがあります。
意思決定マトリクス
| ワークロード | NVLink の重要度 | NVSwitch の重要度 | スケールアウトネットワークの重要度 | 実践的な推奨 |
|---|---|---|---|---|
| 単一 GPU 推論 | 低 | 低 | 低〜中 | NVSwitch にお金を払う前に、GPU メモリ、バッチ処理、モデル選択を最適化する。 |
| 2〜8 GPU のテンソル並列推論 | 高 | 8 GPU システムでは高い | 中 | NVSwitch 付きの H100/H200/B200 システムを優先し、実際のレイテンシをベンチマークする。 |
| マルチノード分散学習 | 各ノード内で高い | 各ノード内で高い | 非常に高い | ノード内ファブリックと InfiniBand/Ethernet の両方を評価する。GPU SKU だけで判断しない。 |
| エキスパート並列または all-to-all が重いモデル | 高 | 高 | ノードをまたぐ場合は高い | all-to-all と配置を直接テストする。トポロジが支配的になることがある。 |
| バッチ型オフライン生成 | 中 | 中 | 中 | 受理済み出力あたりのコストを測定する。NVSwitch はより大きなバッチサイズで役立つ場合がある。 |
| API ファーストの製品ワークロード | 通常は抽象化される | 通常は抽象化される | プロバイダの責任 | ハードウェアを借りる前に、直接 GPU 制御とモデル/API のベースラインを比較する。 |
Flatkey の位置づけ
Flatkey は統合 LLM API ゲートウェイです。1 つのキー、1 枚の請求書、そして多くのテキスト・画像・動画モデルにわたる OpenAI 互換エンドポイントを提供します。これは、カスタムカーネル、プライベート重み、ファインチューニングの制御、またはトポロジ固有の性能改善が必要な場合に、直接 GPU クラスターを置き換えるものではありません。
ビジネス目標がインフラ所有ではなく出力である場合、これはベースラインとして有用です。推論のためにトポロジ重視のクラスターを予約する前に、クラスター案をマネージドなモデル/API ルートと比較してください:
- ホスト型モデルからどの程度の品質とレイテンシが得られるか?
- 再試行と失敗生成を含めた、受理済みレスポンスあたりのコストはいくらか?
- クラスター運用にどれだけのエンジニアリング時間が消費されるか?
- そのワークロードは直接 GPU メモリ制御を必要とするか、それとも信頼できるモデル出力だけでよいか?
モデル/API のベースラインがすでに製品要件を満たすなら、NVLink vs NVSwitch はまだ自分で持つ必要のない最適化かもしれません。ワークロードがプライベート展開、カスタムサービング、または大規模な厳しいレイテンシ目標を必要とするなら、GPU クラウド vs モデル API のトレードオフを比較し、最も有名な GPU 名ではなく、適切なトポロジを買うために上のチェックリストを使ってください。
FAQ
NVSwitch は NVLink より速いのですか?
NVSwitch は単に「より速い NVLink」ではありません。NVLink は GPU のリンクです。NVSwitch は複数の NVLink エンドポイントを接続し、多数の GPU が効率的に通信できるようにするファブリックです。対応システムでは、NVSwitch は単純なポイントツーポイント構成よりも多くの GPU ペアにわたって高い GPU 間帯域幅を維持できます。
LLM 推論に NVSwitch は必要ですか?
推論で 1 つのモデルレプリカに複数 GPU を使う場合、特にレイテンシまたはスループット目標の下でテンソル並列を使うなら、NVSwitch を重視する必要があります。各 GPU が独立した単一 GPU ジョブを処理するなら、NVSwitch の重要性はかなり低くなるかもしれません。
NVLink は InfiniBand の代わりになりますか?
いいえ。NVLink と NVSwitch はスケールアップの GPU ファブリックです。InfiniBand または Ethernet は、ノード、ラック、ストレージ、より大きなクラスターを接続します。大規模な AI システムでは、両方が必要になることがよくあります。
nvlink と nvswitch の最大の違いは何ですか?
nvlink と nvswitch の最大の違いはスコープです。NVLink は GPU 間の直接通信リンクです。NVSwitch は、NVLink 対応 GPU を多数接続し、より広いオールトゥオールのファブリックを構成します。
NVSwitch を基準に H100、H200、B200、GB200 のどれを選ぶべきですか?
インターコネクトのラベルだけで選ばないでください。GPU メモリ、精度サポート、入手性、冷却、ソフトウェアの成熟度、NVLink ドメイン、スケールアウト नेटवर्क、そして許容される出力コストをワークロードに合わせてください。そのうえで、導入を決める前にトポロジーのベンチマークを実施してください。
結論
AI クラスターにおいて、nvlink vs nvswitch は、互換的な 2 つの機能のどちらが優れているかという対立ではありません。NVLink は高速 GPU リンクです。NVSwitch は、多数の NVLink 接続 GPU をより大きな通信ドメインとして利用可能にするファブリックです。InfiniBand または Ethernet は、そのドメインの外側にあるスケールアウト नेटवर्कです。
購入時の教訓はシンプルです。GPU 名だけでなく、トポロジーを確認してください。ワークロードが通信ボトルネックなら、NVSwitch は性能の中心になる可能性があります。ワークロードが出力ボトルネックで、ハードウェア制御を必要としないなら、運用しなければならないトポロジーを借りる前に、Flatkey を使ってモデル/API パスをベンチマークしてください。
公式参照
- NVIDIA, "NVIDIA NVLink and NVLink Switch"
- NVIDIA Technical Blog, "NVIDIA NVLink and NVIDIA NVSwitch Supercharge Large Language Model Inference"
- NVIDIA DGX H100/H200 User Guide
- NVIDIA DGX B200 User Guide
- NVIDIA GB200 NVL72
- NVIDIA NCCL User Guide, "Collective Operations"
- NVIDIA NCCL User Guide, "Environment Variables"


