
NVLink vs NVSwitch: Interkoneksi GPU Dijelaskan untuk Klaster AI
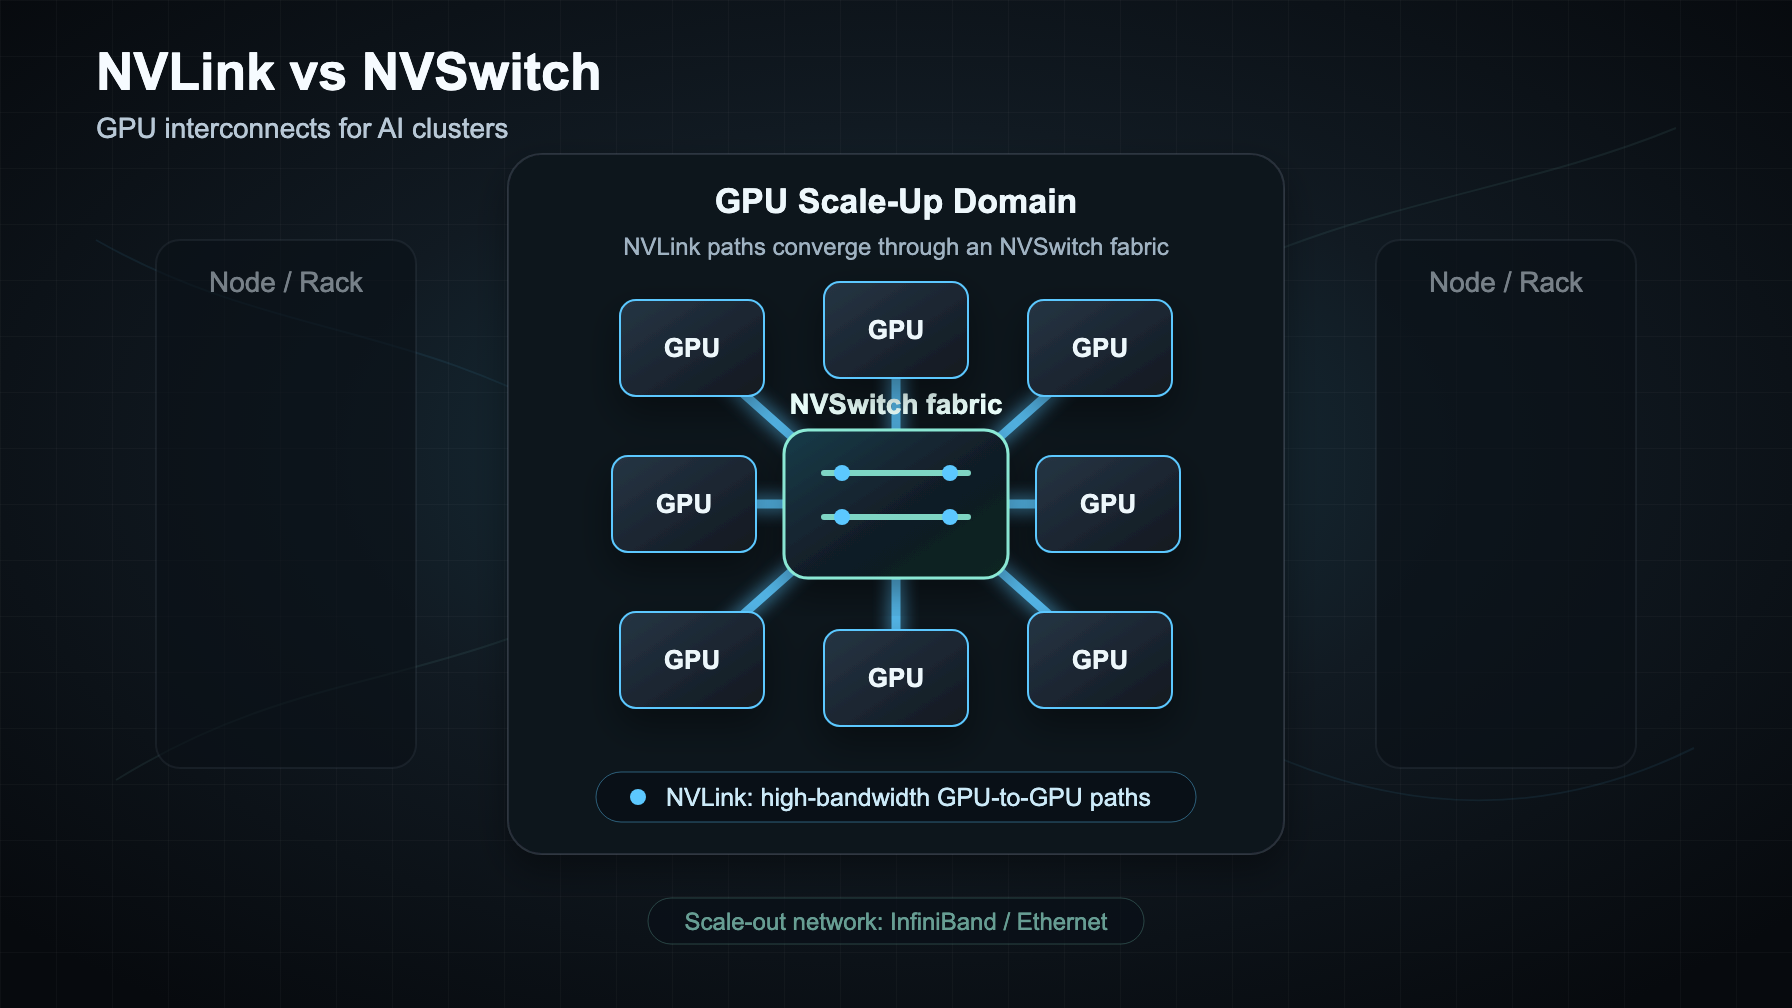
Jika Anda membandingkan NVLink vs NVSwitch, jawaban singkatnya adalah:
- NVLink adalah tautan GPU-ke-GPU berbandwidth tinggi.
- NVSwitch adalah fabric switching yang memungkinkan banyak GPU yang terhubung NVLink saling berkomunikasi tanpa memaksa setiap pasangan GPU masuk ke jalur point-to-point yang sempit.
- InfiniBand atau Ethernet tetap menjadi jaringan scale-out yang menghubungkan sistem, rack, storage, dan klaster yang lebih besar.
Pembedaan ini penting saat Anda menyewa GPU, membeli sistem HGX atau DGX, atau memutuskan apakah sebuah workload benar-benar membutuhkan akses klaster langsung alih-alih API model terkelola. GPU yang cepat saja tidak cukup jika model menghabiskan terlalu banyak waktu menunggu sinkronisasi tensor-parallel, all-reduce, all-gather, reduce-scatter, atau lalu lintas all-to-all.
Panduan ini menjelaskan perbedaan nvidia nvlink vs nvswitch dalam istilah klaster yang praktis: apa yang dilakukan masing-masing komponen, di mana posisi InfiniBand, kapan topologi mengubah performa LLM, dan pertanyaan apa yang harus diajukan sebelum berkomitmen pada arsitektur klaster GPU yang mahal.
NVLink vs NVSwitch: perbedaan singkat
| Lapisan | Apa itu | Ruang lingkup tipikal | Apa yang ditingkatkannya | Apa yang tidak digantikannya |
|---|---|---|---|---|
| NVLink | Interkoneksi GPU langsung berbandwidth tinggi | Tautan GPU-ke-GPU di dalam platform NVIDIA yang didukung | Tensor parallelism, perpindahan memori GPU peer, komunikasi kolektif di dalam domain scale-up | Ini bukan jaringan klaster itu sendiri |
| NVSwitch | Silicon switching dan fabric untuk endpoint NVLink | Server multi-GPU, baseboard, atau domain NVLink skala rack tergantung platform | Komunikasi GPU all-to-all, fabric GPU non-blocking atau bisection yang lebih tinggi, domain GPU yang lebih besar | Ini tidak menghilangkan kebutuhan akan InfiniBand/Ethernet untuk scale-out klaster |
| InfiniBand / Ethernet | Fabric jaringan antar sistem dan rack | Node-ke-node, storage, manajemen, klaster multi-rack | Pelatihan terdistribusi di banyak node, akses storage, traffic layanan, domain penjadwalan | Ini tidak menciptakan bandwidth NVLink lokal antar GPU di dalam sebuah node |
Perbedaan nvlink vs nvswitch paling mudah diingat sebagai link vs fabric. NVLink adalah jalan antara GPU. NVSwitch adalah persimpangan yang memungkinkan banyak jalan itu bertemu tanpa membuat setiap perjalanan menjadi jalur point-to-point yang sempit.
Apa yang dilakukan NVLink
NVLink adalah interkoneksi berkecepatan tinggi NVIDIA untuk komunikasi GPU-ke-GPU. Teknologi ini dirancang untuk pola lalu lintas yang menjadi mahal melalui jalur PCIe biasa: lapisan model parallel, shard tensor yang tersinkron, akses memori peer, dan kolektif berfrekuensi tinggi.
Pada platform NVIDIA publik saat ini, generasinya penting:
| Generasi platform | Titik referensi NVIDIA publik | Bandwidth NVLink per GPU |
|---|---|---|
| Hopper | Generasi H100/H200 | 900 GB/s |
| Blackwell | Generasi B200/GB200 | 1.800 GB/s |
| Vera Rubin | Platform generasi berikutnya yang diumumkan | 3.000 GB/s awal |
Bagi pembeli infrastruktur, angka-angka itu bukan jaminan bahwa setiap workload akan mendapat percepatan yang setara. Angka tersebut menunjukkan batas komunikasi yang tersedia bagi topologi. Peningkatan aktual bergantung pada ukuran model, strategi paralelisme, ukuran batch, panjang sequence, perilaku framework, penempatan, dan apakah workload tersebut terikat pada komunikasi.
Gunakan NVLink sebagai sinyal pembelian ketika workload Anda menggunakan beberapa GPU untuk satu request, satu langkah training, atau satu grup shard model. NVLink jauh kurang penting ketika setiap GPU melayani pekerjaan independen dengan sedikit komunikasi peer.
Apa yang dilakukan NVSwitch
NVSwitch adalah lapisan switching yang menghubungkan banyak endpoint NVLink menjadi fabric GPU berbandwidth lebih tinggi. Tanpa fabric switch, sistem multi-GPU dapat berakhir membagi anggaran link yang tersedia pada setiap GPU ke banyak koneksi point-to-point. Dengan NVSwitch, sistem yang didukung dapat memberi setiap GPU jalur yang lebih seragam ke setiap GPU lain di domain NVLink.
Itulah mengapa nvswitch vs nvlink bukan pilihan antara dua pengganti. NVSwitch menggunakan koneksi NVLink untuk membangun sebuah fabric. Switch berguna karena delapan, enam belas, atau tujuh puluh dua GPU tidak berperilaku seperti dua GPU yang dihubungkan kabel.
Pada contoh NVIDIA publik:
- Sistem DGX H100/H200 menggunakan delapan GPU H100 atau H200 dan mencantumkan bandwidth GPU-ke-GPU 900 GB/s dengan jaringan klaster melalui port ConnectX-7 InfiniBand/Ethernet.
- Sistem DGX B200 menggunakan delapan GPU B200 dan mencantumkan dua switch NVLink generasi kelima dengan bandwidth agregat 14,4 TB/s; bandingkan trade-off pembeliannya dalam panduan B200 vs H200 kami.
- GB200 NVL72 menghubungkan 36 CPU Grace dan 72 GPU Blackwell dalam desain skala rack; NVIDIA menggambarkannya sebagai domain NVLink 72-GPU dengan komunikasi GPU berlatensi rendah sebesar 130 TB/s. Untuk pemilihan platform, lihat GB200 vs B200.
Inti praktisnya: NVSwitch menjadi lebih penting seiring bertambahnya jumlah GPU dalam satu domain scale-up dan seiring semakin banyaknya jalur kritis workload yang bergantung pada komunikasi GPU-ke-GPU.
NVLink vs NVSwitch vs InfiniBand
Frasa nvlink vs nvswitch vs infiniband sering kali menyamarkan tiga pertanyaan desain yang berbeda:
- Di dalam satu sistem GPU: Apakah GPU memiliki bandwidth peer yang cukup untuk tensor parallelism, tahapan pipeline, atau inferensi multi-GPU?
- Di dalam satu domain skala-rak: Dapatkah banyak GPU bertindak sebagai satu fabric akselerator yang lebih besar untuk paralelisme model skala besar?
- Di seluruh banyak node atau rak: Dapatkah jaringan klaster membawa distributed training, pemuatan data, storage, checkpointing, dan lalu lintas layanan secara prediktif?
NVLink dan NVSwitch menjawab dua pertanyaan pertama. InfiniBand atau Ethernet menjawab pertanyaan ketiga.
Misalnya, node HGX atau DGX delapan GPU dengan NVSwitch bisa sangat baik untuk replika model yang memerlukan tensor parallelism ketat antargPU di dalam node. Jika Anda membutuhkan ratusan atau ribuan GPU, Anda tetap memerlukan jaringan scale-out. Pada sistem rak Blackwell, NVIDIA menggabungkan domain NVLink besar dengan InfiniBand atau Ethernet Spectrum-X untuk skala di luar rak.
Jangan tanyakan apakah NVLink menggantikan InfiniBand. Tanyakan lalu lintas mana yang harus tetap berada di dalam domain NVLink dan lalu lintas mana yang harus melintasi fabric klaster.
Mengapa beban kerja AI peduli pada topologi
Beban kerja LLM modern bukan sekadar perkalian matriks. Begitu sebuah model dibagi di beberapa perangkat, setiap lapisan dapat menambahkan komunikasi.
Pola komunikasi umum meliputi:
- All-reduce: setiap rank menyumbangkan nilai dan menerima hasil yang sudah direduksi.
- Reduce-scatter dan all-gather: blok pembangun umum untuk strategi tensor dan data parallel.
- All-to-all: setiap rank mengirim potongan berbeda ke rank lain, yang penting untuk beberapa desain expert-parallel dan yang berat pada routing.
- Perpindahan KV cache dan activation: bergantung pada implementasi, tetapi sering sensitif terhadap locality dan placement.
NCCL mendokumentasikan collective ini sebagai operasi berbasis rank di seluruh perangkat CUDA. Itu penting karena perangkat lunak melihat rank, bukan istilah pemasaran. Fabric yang baik hanya membantu jika penempatan rank, framework, container, pengaturan NCCL, dan tata letak scheduler memungkinkan job memanfaatkannya.
Dalam diskusi inferensi LLM NVIDIA, inferensi tensor-parallel mengharuskan GPU bertukar hasil setelah bekerja pada satu lapisan model sebelum lapisan berikutnya dapat dilanjutkan. Ketika pertukaran itu lambat, Tensor Core dapat menganggur. Itulah alasan inti NVSwitch dapat penting untuk serving multi-GPU.
Kapan NVSwitch layak diperhatikan
Prioritaskan sistem berbasis NVSwitch ketika salah satu hal berikut benar:
- Anda melayani model yang membutuhkan tensor parallelism di beberapa GPU untuk mencapai target latensi.
- Job training atau fine-tuning menunjukkan waktu collective yang tinggi di profiler.
- Anda berencana menjalankan inferensi batch besar di mana sinkronisasi GPU-ke-GPU meningkat seiring concurrency.
- Anda membutuhkan komunikasi all-to-all yang dapat diprediksi di seluruh GPU dalam satu node delapan GPU.
- Anda mengevaluasi sistem skala-rak seperti GB200 NVL72 di mana domain NVLink adalah fitur produk utama.
NVSwitch kurang menentukan ketika:
- Job bersifat embarrassingly parallel dan setiap GPU menjalankan pekerjaan independen.
- Beban kerja terikat pada CPU, storage, atau data-loader.
- Model dengan nyaman muat dan dilayani pada satu GPU.
- Aplikasi memanggil API model terkelola dan tidak mengelola topologi perangkat keras secara langsung.
- Bottleneck berada pada fabric antar-node, bukan komunikasi GPU intra-node.
Pertanyaan yang tepat bukan "Apakah GPU ini memiliki NVLink?" Melainkan "Apakah beban kerja kritis saya akan membuat banyak GPU di domain NVLink/NVSwitch yang sama sibuk cukup untuk membenarkan premi?"
Daftar periksa pengadaan untuk sistem NVLink vs NVSwitch
Gunakan daftar periksa ini sebelum menyewa atau membeli klaster GPU, dan pasangkan dengan ulasan TCO klaster GPU sebelum menandatangani reservasi jangka panjang.
| Pertanyaan | Mengapa ini penting |
|---|---|
| SKU GPU dan form factor apa yang tepat ditawarkan? | H100 PCIe, H100 SXM, H200, B200, dan sistem GB200 dapat mengekspos topologi dan bandwidth yang sangat berbeda. |
| Apakah sistem ini point-to-point hanya NVLink, berbasis NVSwitch, atau domain NVLink skala-rak? | "Punya NVLink" saja tidak cukup. Anda memerlukan bentuk fabric-nya. |
| Berapa banyak GPU dalam satu domain NVLink? | Ukuran domain memengaruhi opsi penempatan tensor parallel dan model-parallel. |
| Apa jaringan antar-node: InfiniBand, RoCE, Ethernet Spectrum-X, atau Ethernet biasa? | NVSwitch tidak memperbaiki jaringan scale-out yang lemah. |
| Apakah tes NCCL tersedia untuk bentuk sewaan yang tepat? | Collective sintetis mengungkap apakah topologi, driver, rail, dan container terhubung dengan benar. |
| Dapatkah Anda mengunci satu node penuh atau domain? | Shared tenancy dapat merusak asumsi tentang locality dan repeatability. |
| Apakah rail jaringan dan penempatan NIC didokumentasikan? | NCCL mungkin memerlukan pemilihan interface yang benar dan penempatan yang sadar rail pada skala besar. |
| Apa yang terjadi ketika satu GPU, switch tray, atau NIC mengalami degradasi? | Resiliensi dan kebijakan penggantian memengaruhi uptime produksi. |
| Benchmark apa yang harus lulus sebelum reservasi jangka panjang? | Biaya output yang diterima lebih berguna daripada harga per jam mentah. |
Rencana benchmark: buktikan fabric sebelum Anda reservasi
Untuk reservasi GPU berbiaya tinggi, jalankan uji penerimaan topologi sebelum berkomitmen untuk jangka panjang.
- Inventarisasi topologi. Tangkap
nvidia-smi topo -m, SKU GPU, driver, CUDA, versi NCCL, NIC, dan image container. - Jalankan collectives NCCL. Uji all-reduce, reduce-scatter, all-gather, dan all-to-all pada ukuran pesan yang menyerupai workload Anda.
- Ukur latensi workload nyata. Gunakan model aktual Anda, panjang konteks, kebijakan batch, dan pengaturan paralelisme.
- Bandingkan penempatan dalam domain dan lintas node. Periksa apakah scheduler tanpa sengaja memindahkan rank ke jalur yang lebih lambat.
- Lacak biaya per output yang diterima. Untuk inferensi, ukur token yang diterima atau respons sukses per dolar, bukan hanya token per detik. Untuk training, ukur progres loss atau sampel yang selesai per dolar.
- Catat perilaku kegagalan. Matikan worker, restart container, atau simulasikan NIC yang terdegradasi jika penyedia mengizinkannya.
Jika penyedia tidak dapat memberi tahu Anda topologi atau menjalankan benchmark NCCL dasar, anggap itu sebagai sinyal risiko. Tarif per jam juga perlu konteks dari harga sewa GPU, komitmen kapasitas, add-on jaringan, dan biaya run yang gagal.
Kesalahan umum
Kesalahan 1: Menganggap NVLink sebagai sinonim NVSwitch. Sebuah platform dapat mengekspos link NVLink tanpa memberi Anda perilaku all-to-all yang sama seperti sistem berbasis NVSwitch.
Kesalahan 2: Mengasumsikan NVSwitch menghilangkan desain jaringan. NVSwitch membantu domain GPU scale-up. Training multi-node tetap membutuhkan desain InfiniBand atau Ethernet yang serius.
Kesalahan 3: Membeli bandwidth untuk job independen. Jika setiap GPU menjalankan worker inferensi terpisah, NVSwitch mungkin tidak meningkatkan utilisasi cukup untuk membenarkan biayanya.
Kesalahan 4: Membandingkan harga GPU per jam tanpa topologi. Dua penawaran "8x H100" dapat berperilaku berbeda jika yang satu adalah SXM dengan NVSwitch dan yang lain PCIe atau memiliki jaringan yang lebih lemah.
Kesalahan 5: Mengabaikan penempatan software. Pemetaan rank NCCL, versi container, pemilihan antarmuka jaringan, dan kebijakan scheduler dapat menghapus keunggulan hardware.
Matriks keputusan
| Workload | Pentingnya NVLink | Pentingnya NVSwitch | Pentingnya jaringan scale-out | Rekomendasi praktis |
|---|---|---|---|---|
| Inferensi single-GPU | Rendah | Rendah | Rendah hingga sedang | Optimalkan memori GPU, batching, dan pilihan model sebelum membayar NVSwitch. |
| Inferensi tensor-parallel 2-8 GPU | Tinggi | Tinggi pada sistem 8-GPU | Sedang | Pilih sistem H100/H200/B200 berbasis NVSwitch dan benchmark latensi nyata. |
| Training terdistribusi multi-node | Tinggi di dalam tiap node | Tinggi di dalam tiap node | Sangat tinggi | Evaluasi fabric node dan InfiniBand/Ethernet; jangan menilai hanya dari SKU GPU. |
| Model expert-parallel atau heavy all-to-all | Tinggi | Tinggi | Tinggi saat melintasi node | Uji all-to-all dan placement secara langsung; topologi dapat mendominasi. |
| Batch offline generation | Sedang | Sedang | Sedang | Ukur output yang diterima per dolar; NVSwitch mungkin membantu pada ukuran batch yang lebih besar. |
| Workload produk API-first | Biasanya diabstraksikan | Biasanya diabstraksikan | Tanggung jawab penyedia | Bandingkan kontrol GPU langsung dengan baseline model/API sebelum menyewa hardware. |
Posisi Flatkey
Flatkey adalah gateway API LLM terpadu: satu key, satu tagihan, dan endpoint yang kompatibel dengan OpenAI di berbagai model teks, gambar, dan video. Itu tidak menggantikan klaster GPU langsung ketika Anda membutuhkan kernel kustom, bobot privat, kontrol fine-tuning, atau kerja performa yang spesifik topologi.
Ini berguna sebagai baseline ketika tujuan bisnis adalah output, bukan kepemilikan infrastruktur. Sebelum memesan klaster yang berat topologi untuk inferensi, bandingkan rencana klaster dengan rute model/API terkelola:
- Kualitas dan latensi apa yang Anda dapatkan dari model yang di-host?
- Berapa biaya per respons yang diterima setelah retry dan generasi gagal?
- Berapa banyak waktu engineering yang akan dihabiskan operasi klaster?
- Apakah workload memerlukan kontrol memori GPU langsung, atau hanya output model yang andal?
Jika baseline model/API sudah memenuhi kebutuhan produk, NVLink vs NVSwitch mungkin merupakan optimasi yang belum perlu Anda miliki. Jika workload memerlukan deployment privat, serving kustom, atau target latensi keras pada skala besar, bandingkan trade-off GPU cloud vs model API, lalu gunakan checklist di atas untuk membeli topologi yang tepat alih-alih nama GPU yang paling dikenali.
FAQ
Apakah NVSwitch lebih cepat daripada NVLink?
NVSwitch bukan sekadar "NVLink yang lebih cepat." NVLink adalah link GPU. NVSwitch adalah fabric yang menghubungkan banyak endpoint NVLink sehingga banyak GPU dapat berkomunikasi secara efisien. Pada sistem yang didukung, NVSwitch dapat mempertahankan bandwidth GPU-ke-GPU tinggi di lebih banyak pasangan GPU dibanding tata letak point-to-point sederhana.
Apakah saya butuh NVSwitch untuk inferensi LLM?
Anda perlu mempertimbangkan NVSwitch ketika inferensi menggunakan beberapa GPU untuk satu replika model, terutama tensor parallelism di bawah target latensi atau throughput. Jika setiap GPU melayani job single-GPU yang independen, NVSwitch mungkin jauh kurang penting.
Apakah NVLink menggantikan InfiniBand?
Tidak. NVLink dan NVSwitch adalah fabric scale-up GPU. InfiniBand atau Ethernet menghubungkan node, rack, storage, dan klaster yang lebih besar. Sistem AI besar sering membutuhkan keduanya.
Apa perbedaan terbesar nvlink vs nvswitch?
Perbedaan terbesar antara nvlink vs nvswitch adalah cakupannya. NVLink adalah jalur komunikasi GPU langsung. NVSwitch menghubungkan banyak GPU yang dilengkapi NVLink ke dalam fabric all-to-all yang lebih luas.
Haruskah saya memilih H100, H200, B200, atau GB200 berdasarkan NVSwitch?
Jangan memilih hanya berdasarkan label interkoneksi. Sesuaikan memori GPU, dukungan presisi, ketersediaan, pendinginan, kematangan perangkat lunak, domain NVLink, jaringan scale-out, dan biaya output yang diterima dengan beban kerja Anda. Lalu jalankan benchmark topologi sebelum berkomitmen.
Kesimpulan
Untuk klaster AI, nvlink vs nvswitch bukan pertarungan antara dua fitur yang dapat dipertukarkan. NVLink adalah link GPU berkecepatan tinggi. NVSwitch adalah fabric yang membuat banyak GPU yang terhubung NVLink dapat digunakan sebagai domain komunikasi yang lebih besar. InfiniBand atau Ethernet adalah jaringan scale-out di sekitar domain tersebut.
Pelajaran pembeliannya sederhana: minta topologinya, bukan hanya nama GPU-nya. Jika beban kerja Anda terikat pada komunikasi, NVSwitch bisa menjadi pusat performa. Jika beban kerja Anda terikat pada output dan tidak memerlukan kontrol hardware, benchmark jalur model/API dengan Flatkey sebelum Anda menyewa topologi yang nantinya harus Anda operasikan.
Referensi resmi
- NVIDIA, "NVIDIA NVLink dan NVLink Switch"
- NVIDIA Technical Blog, "NVIDIA NVLink dan NVIDIA NVSwitch Memperkuat Inferensi Model Bahasa Besar"
- Panduan Pengguna NVIDIA DGX H100/H200
- Panduan Pengguna NVIDIA DGX B200
- NVIDIA GB200 NVL72
- Panduan Pengguna NVIDIA NCCL, "Operasi Kolektif"
- Panduan Pengguna NVIDIA NCCL, "Variabel Lingkungan"


