
NVLink vs NVSwitch : interconnexions GPU expliquées pour les clusters d’IA
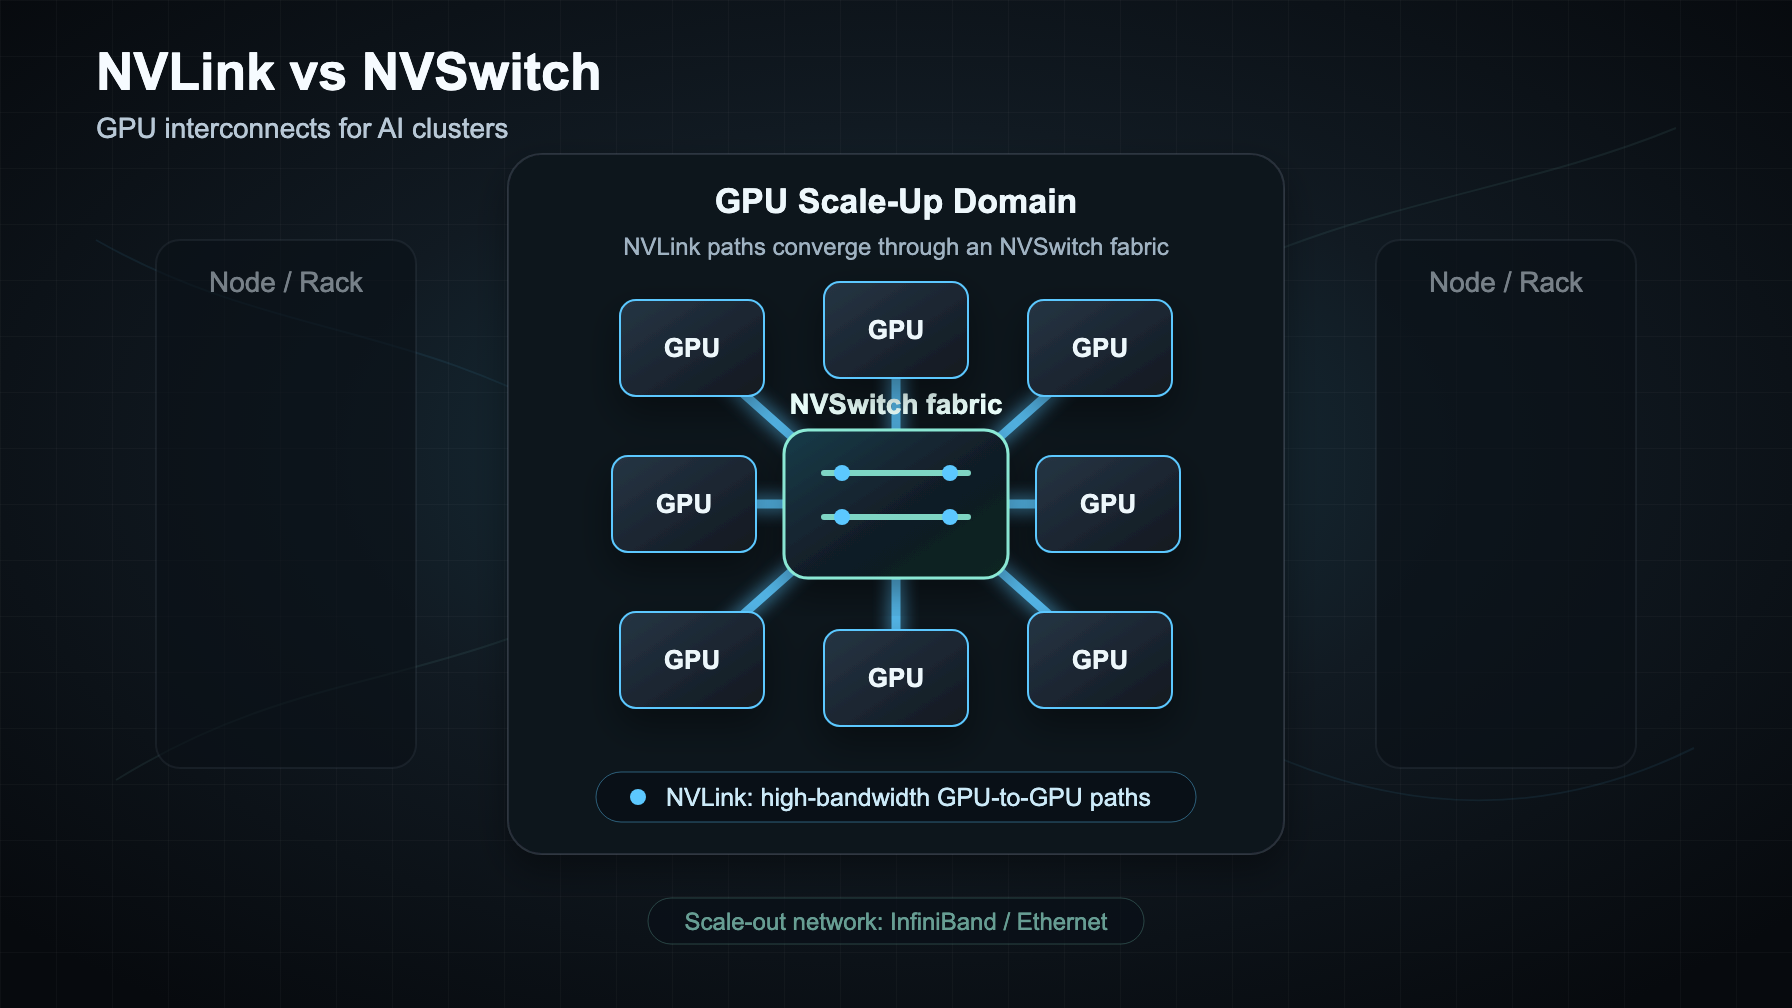
Si vous comparez NVLink vs NVSwitch, la réponse courte est la suivante :
- NVLink est la liaison GPU-à-GPU à haut débit.
- NVSwitch est le tissu de commutation qui permet à de nombreux GPU connectés via NVLink de communiquer entre eux sans obliger chaque paire de GPU à emprunter une petite ligne point à point.
- InfiniBand ou Ethernet reste le réseau de scale-out qui relie les systèmes, les racks, le stockage et les clusters plus vastes.
Cette distinction compte lorsque vous louez des GPU, achetez un système HGX ou DGX, ou décidez si une charge de travail a réellement besoin d’un accès direct au cluster plutôt que d’une API de modèle managée. Un GPU rapide ne suffit pas si le modèle passe trop de temps à attendre des synchronisations en tensor-parallel, des all-reduce, all-gather, reduce-scatter ou du trafic all-to-all.
Ce guide explique les différences entre nvidia nvlink vs nvswitch en termes pratiques de cluster : ce que fait chaque composant, où se situe InfiniBand, quand la topologie modifie les performances des LLM, et quelles questions poser avant de s’engager dans une coûteuse architecture de cluster GPU.
NVLink vs NVSwitch : la différence rapide
| Couche | Ce que c’est | Périmètre typique | Ce que cela améliore | Ce que cela ne remplace pas |
|---|---|---|---|---|
| NVLink | Interconnexion GPU directe à haut débit | Liaisons GPU-à-GPU au sein des plateformes NVIDIA prises en charge | Parallélisme tensoriel, mouvement de mémoire entre GPU pairs, communication collective dans un domaine de scale-up | Ce n’est pas, à lui seul, un réseau de cluster |
| NVSwitch | Silicium de commutation et tissu pour les terminaux NVLink | Serveur multi-GPU, carte mère ou domaine NVLink à l’échelle du rack selon la plateforme | Communication GPU all-to-all, tissu GPU non bloquant ou à plus forte bisection, domaines GPU plus vastes | Cela ne supprime pas le besoin d’InfiniBand/Ethernet pour le scale-out du cluster |
| InfiniBand / Ethernet | Tissu réseau entre systèmes et racks | Noeud à noeud, stockage, gestion, clusters multi-racks | Entraînement distribué sur de nombreux nœuds, accès au stockage, trafic de service, domaines de planification | Cela ne crée pas, à l’intérieur d’un nœud, la bande passante locale NVLink entre GPU |
La différence entre nvlink vs nvswitch est la plus facile à retenir comme liaison vs tissu. NVLink est la route entre les GPU. NVSwitch est l’échangeur qui permet à beaucoup de ces routes de converger sans transformer chaque trajet en un chemin point à point étroit.
Ce que fait NVLink
NVLink est l’interconnexion haut débit de NVIDIA pour la communication GPU-à-GPU. Elle est conçue pour les schémas de trafic qui deviennent coûteux sur des chemins PCIe ordinaires : couches de modèle parallèle, shards tensoriels synchronisés, accès à la mémoire d’un pair et collectifs à haute fréquence.
Sur les plateformes NVIDIA publiques actuelles, la génération compte :
| Génération de plateforme | Référence NVIDIA publique | Bande passante NVLink par GPU |
|---|---|---|
| Hopper | Génération H100/H200 | 900 GB/s |
| Blackwell | Génération B200/GB200 | 1 800 GB/s |
| Vera Rubin | Plateforme de nouvelle génération annoncée | 3 000 GB/s préliminaires |
Pour un acheteur d’infrastructure, ces chiffres ne garantissent pas qu’une charge de travail donnée obtiendra un gain de vitesse équivalent. Ils indiquent le plafond de communication disponible pour la topologie. Le gain réel dépend de la taille du modèle, de la stratégie de parallélisme, de la taille des lots, de la longueur de séquence, du comportement du framework, du placement et du fait que la charge de travail soit ou non limitée par la communication.
Utilisez NVLink comme signal d’achat lorsque votre charge de travail utilise plusieurs GPU pour une seule requête, une seule étape d’entraînement ou un seul groupe de shards de modèle. Il est bien moins important lorsque chaque GPU exécute des tâches indépendantes avec peu de communication entre pairs.
Ce que fait NVSwitch
NVSwitch est la couche de commutation qui relie de nombreux terminaux NVLink en un tissu GPU à plus haut débit. Sans tissu de commutation, un système multi-GPU peut finir par répartir le budget de liaison disponible de chaque GPU entre de nombreuses connexions point à point. Avec NVSwitch, les systèmes pris en charge peuvent offrir à chaque GPU un chemin plus uniforme vers tous les autres GPU du domaine NVLink.
C’est pourquoi nvswitch vs nvlink n’est pas un choix entre deux substituts. NVSwitch utilise des connexions NVLink pour construire un tissu. Le switch est utile parce que huit, seize ou soixante-douze GPU ne se comportent pas comme deux GPU câblés ensemble.
Dans les exemples publics de NVIDIA :
- Les systèmes DGX H100/H200 utilisent huit GPU H100 ou H200 et indiquent une bande passante GPU-à-GPU de 900 GB/s avec un réseau de cluster via des ports ConnectX-7 InfiniBand/Ethernet.
- Les systèmes DGX B200 utilisent huit GPU B200 et indiquent deux switches NVLink de cinquième génération avec 14,4 TB/s de bande passante agrégée ; comparez les arbitrages d’achat dans notre guide B200 vs H200.
- GB200 NVL72 relie 36 CPU Grace et 72 GPU Blackwell dans une conception à l’échelle du rack ; NVIDIA le décrit comme un domaine NVLink de 72 GPU avec 130 TB/s de communication GPU à faible latence. Pour la sélection de plateforme, voir GB200 vs B200.
À retenir en pratique : NVSwitch devient plus important à mesure que le nombre de GPU dans un domaine de scale-up augmente et qu’une part croissante du chemin critique de la charge de travail devient de la communication GPU-à-GPU.
NVLink vs NVSwitch vs InfiniBand
L’expression nvlink vs nvswitch vs infiniband masque souvent trois questions de conception différentes :
- À l’intérieur d’un seul système GPU : les GPU disposent-ils d’une bande passante entre pairs suffisante pour le parallélisme de tenseurs, les étapes de pipeline ou l’inférence multi-GPU ?
- À l’intérieur d’un domaine à l’échelle d’un rack : de nombreux GPU peuvent-ils agir comme un tissu d’accélération plus vaste pour le parallélisme de grands modèles ?
- Sur plusieurs nœuds ou racks : le réseau du cluster peut-il prendre en charge de manière prévisible l’entraînement distribué, le chargement de données, le stockage, les points de contrôle et le trafic de service ?
NVLink et NVSwitch répondent aux deux premières questions. InfiniBand ou Ethernet répond à la troisième.
Par exemple, un nœud HGX ou DGX à huit GPU avec NVSwitch peut être excellent pour une réplique de modèle qui nécessite un parallélisme de tenseurs étroit entre les GPU du nœud. Si vous avez besoin de centaines ou de milliers de GPU, il vous faut toujours un réseau de mise à l’échelle horizontale. Sur les systèmes rack Blackwell, NVIDIA combine de grands domaines NVLink avec InfiniBand ou l’Ethernet Spectrum-X pour aller au-delà du rack.
Ne demandez pas si NVLink remplace InfiniBand. Demandez quel trafic doit rester dans le domaine NVLink et quel trafic doit traverser le tissu du cluster.
Pourquoi les charges de travail d’IA se soucient de la topologie
Les charges de travail LLM modernes ne se limitent pas à la multiplication matricielle. Une fois qu’un modèle est réparti entre plusieurs dispositifs, chaque couche peut introduire de la communication.
Les schémas de communication courants incluent :
- All-reduce : chaque rang contribue des valeurs et reçoit le résultat réduit.
- Reduce-scatter et all-gather : briques de base courantes pour les stratégies de parallélisme de tenseurs et de données.
- All-to-all : chaque rang envoie des blocs différents à d’autres rangs, ce qui est important pour certaines conceptions à parallélisme d’experts et à forte logique de routage.
- Mouvement du cache KV et des activations : dépend de l’implémentation, mais souvent sensible à la localité et au placement.
NCCL documente ces collectives comme des opérations basées sur les rangs à travers des périphériques CUDA. C’est important parce que le logiciel voit des rangs, pas des termes marketing. Un bon tissu n’aide que si le placement des rangs, le framework, le conteneur, les paramètres NCCL et la disposition du planificateur permettent au travail de l’exploiter.
Dans la discussion de NVIDIA sur l’inférence LLM, l’inférence en parallélisme de tenseurs exige que les GPU échangent les résultats après le travail sur une couche de modèle avant que la couche suivante puisse continuer. Lorsque cet échange est lent, les Tensor Cores peuvent rester inactifs. C’est la raison fondamentale pour laquelle NVSwitch peut être important pour la diffusion multi-GPU.
Quand NVSwitch mérite qu’on s’y intéresse
Privilégiez les systèmes reposant sur NVSwitch lorsque l’un des cas suivants est vrai :
- Vous servez des modèles qui nécessitent un parallélisme de tenseurs sur plusieurs GPU pour atteindre les objectifs de latence.
- Les travaux d’entraînement ou de fine-tuning montrent un temps collectif élevé dans les profileurs.
- Vous prévoyez d’exécuter une inférence par grands lots où la synchronisation GPU-à-GPU augmente avec la concurrence.
- Vous avez besoin d’une communication all-to-all prévisible entre tous les GPU d’un nœud à huit GPU.
- Vous évaluez des systèmes à l’échelle d’un rack comme le GB200 NVL72, où le domaine NVLink est une fonctionnalité produit principale.
NVSwitch est moins déterminant lorsque :
- Les travaux sont massivement parallèles et chaque GPU exécute un travail indépendant.
- La charge de travail est limitée par le CPU, le stockage ou le chargeur de données.
- Le modèle tient confortablement sur un seul GPU et y est servi.
- L’application appelle des API de modèles hébergés et ne gère pas directement la topologie matérielle.
- Le goulot d’étranglement est le tissu inter-nœuds plutôt que la communication GPU interne au nœud.
La bonne question n’est pas « Ce GPU a-t-il NVLink ? » C’est « Ma charge de travail critique maintiendra-t-elle suffisamment occupés plusieurs GPU du même domaine NVLink/NVSwitch pour justifier la prime ? »
Liste de contrôle d’achat pour les systèmes NVLink vs NVSwitch
Utilisez cette liste de contrôle avant de louer ou d’acheter un cluster GPU, et associez-la à une revue du TCO d’un cluster GPU avant de signer une longue réservation.
| Question | Pourquoi c’est important |
|---|---|
| Quelle référence exacte de GPU et quel format sont proposés ? | Les systèmes H100 PCIe, H100 SXM, H200, B200 et GB200 peuvent présenter une topologie et une bande passante très différentes. |
| Le système repose-t-il sur un point à point NVLink uniquement, sur NVSwitch, ou sur un domaine NVLink à l’échelle d’un rack ? | « Dispose de NVLink » ne suffit pas. Vous avez besoin de la forme du tissu. |
| Combien de GPU y a-t-il dans un seul domaine NVLink ? | La taille du domaine influence les options de placement pour le parallélisme de tenseurs et le parallélisme de modèle. |
| Quel est le réseau inter-nœuds : InfiniBand, RoCE, Ethernet Spectrum-X ou Ethernet ordinaire ? | NVSwitch ne corrige pas un mauvais réseau de mise à l’échelle horizontale. |
| Des tests NCCL sont-ils disponibles pour la configuration exacte louée ? | Les collectives synthétiques révèlent si la topologie, les pilotes, les voies réseau et les conteneurs sont correctement câblés. |
| Pouvez-vous réserver un nœud ou un domaine complet ? | Le multitenant partagé peut casser les hypothèses de localité et de répétabilité. |
| Les voies réseau et le placement des NIC sont-ils documentés ? | NCCL peut avoir besoin d’une sélection correcte de l’interface et d’un placement conscient des voies à grande échelle. |
| Que se passe-t-il lorsqu’un GPU, un tiroir de commutation ou une NIC est dégradé ? | La résilience et la politique de remplacement affectent la disponibilité en production. |
| Quel benchmark doit réussir avant une longue réservation ? | Le coût d’acceptation du résultat est plus utile qu’un simple tarif horaire brut. |
Plan de benchmark : prouvez le tissu avant de réserver
Pour les réservations GPU à coût élevé, exécutez un test d’acceptation de la topologie avant de vous engager sur le long terme.
- Inventoriez la topologie. Capturez
nvidia-smi topo -m, le SKU GPU, le pilote, CUDA, la version de NCCL, les NIC et l’image de conteneur. - Exécutez les collectives NCCL. Testez all-reduce, reduce-scatter, all-gather et all-to-all à des tailles de messages qui ressemblent à celles de votre charge de travail.
- Mesurez la latence réelle de la charge de travail. Utilisez votre modèle réel, la longueur de contexte, la politique de batch et les paramètres de parallélisme.
- Comparez le placement intra-domaine et inter-nœuds. Vérifiez si l’ordonnanceur déplace accidentellement des ranks sur des chemins plus lents.
- Suivez le coût par sortie acceptée. Pour l’inférence, mesurez les tokens acceptés ou les réponses réussies par dollar, pas seulement les tokens par seconde. Pour l’entraînement, mesurez la progression de la perte ou les échantillons terminés par dollar.
- Enregistrez le comportement en cas de panne. Tuez un worker, redémarrez un conteneur ou simulez une NIC dégradée si le fournisseur l’autorise.
Si un fournisseur ne peut pas vous indiquer la topologie ou exécuter un benchmark NCCL de base, considérez cela comme un signal de risque. Les tarifs horaires ont aussi besoin du contexte fourni par les prix de location des GPU, des engagements de capacité, des compléments réseau et des coûts liés aux exécutions échouées.
Erreurs courantes
Erreur 1 : considérer NVLink comme synonyme de NVSwitch. Une plateforme peut exposer des liens NVLink sans vous offrir le même comportement all-to-all qu’un système reposant sur NVSwitch.
Erreur 2 : supposer que NVSwitch élimine la conception réseau. NVSwitch aide le domaine GPU scale-up. L’entraînement multi-nœuds nécessite toujours une conception InfiniBand ou Ethernet sérieuse.
Erreur 3 : acheter de la bande passante pour des tâches indépendantes. Si chaque GPU exécute un worker d’inférence séparé, NVSwitch peut ne pas améliorer suffisamment l’utilisation pour justifier le coût.
Erreur 4 : comparer les prix horaires des GPU sans la topologie. Deux offres « 8x H100 » peuvent se comporter différemment si l’une est en SXM avec NVSwitch et l’autre en PCIe ou dispose d’un réseau moins performant.
Erreur 5 : ignorer le placement logiciel. Le mapping des ranks NCCL, les versions des conteneurs, la sélection de l’interface réseau et la politique de l’ordonnanceur peuvent annuler les avantages matériels.
Matrice de décision
| Charge de travail | Importance de NVLink | Importance de NVSwitch | Importance du réseau scale-out | Recommandation pratique |
|---|---|---|---|---|
| Inférence sur un seul GPU | Faible | Faible | Faible à moyenne | Optimisez la mémoire GPU, le batching et le choix du modèle avant de payer pour NVSwitch. |
| Inférence tensor-parallèle sur 2 à 8 GPU | Élevée | Élevée sur les systèmes à 8 GPU | Moyenne | Privilégiez les systèmes H100/H200/B200 reposant sur NVSwitch et benchmarkez la latence réelle. |
| Entraînement distribué multi-nœuds | Élevée à l’intérieur de chaque nœud | Élevée à l’intérieur de chaque nœud | Très élevée | Évaluez à la fois le fabric du nœud et l’InfiniBand/Ethernet ; ne jugez pas uniquement selon le SKU GPU. |
| Modèles expert-parallel ou très lourds en all-to-all | Élevée | Élevée | Élevée lors du passage entre nœuds | Testez directement all-to-all et le placement ; la topologie peut dominer. |
| Génération batch hors ligne | Moyenne | Moyenne | Moyenne | Mesurez la sortie acceptée par dollar ; NVSwitch peut aider à des tailles de batch plus élevées. |
| Charge de travail produit API-first | Généralement abstraite | Généralement abstraite | Responsabilité du fournisseur | Comparez le contrôle direct du GPU à une base de référence modèle/API avant de louer du matériel. |
Où Flatkey s’intègre
Flatkey est une passerelle API LLM unifiée : une clé, une facture, et un point de terminaison compatible OpenAI sur de nombreux modèles texte, image et vidéo. Cela ne remplace pas des clusters GPU directs lorsque vous avez besoin de kernels personnalisés, de poids privés, d’un contrôle du fine-tuning ou d’un travail de performance spécifique à la topologie.
C’est utile comme base de référence lorsque l’objectif métier est la sortie, et non la possession de l’infrastructure. Avant de réserver un cluster à forte contrainte de topologie pour l’inférence, comparez le plan du cluster à une solution de modèle/API managée :
- Quelle qualité et quelle latence obtenez-vous avec les modèles hébergés ?
- Quel est le coût par réponse acceptée après les nouvelles tentatives et les générations échouées ?
- Combien de temps d’ingénierie les opérations de cluster vont-elles consommer ?
- La charge de travail nécessite-t-elle un contrôle direct de la mémoire GPU, ou seulement des sorties de modèle fiables ?
Si la base de référence modèle/API répond déjà aux exigences du produit, NVLink vs NVSwitch peut être une optimisation que vous n’avez pas encore besoin de maîtriser. Si la charge de travail nécessite un déploiement privé, un service personnalisé ou des objectifs de latence stricts à grande échelle, comparez les arbitrages GPU cloud vs model API, puis utilisez la liste de contrôle ci-dessus pour acheter la bonne topologie plutôt que le nom de GPU le plus reconnaissable.
FAQ
NVSwitch est-il plus rapide que NVLink ?
NVSwitch n’est pas simplement un « NVLink plus rapide ». NVLink est le lien GPU. NVSwitch est le fabric qui relie plusieurs points de terminaison NVLink afin que de nombreux GPU puissent communiquer efficacement. Dans les systèmes pris en charge, NVSwitch peut préserver une bande passante GPU-à-GPU élevée sur davantage de paires de GPU qu’une simple topologie point à point.
Ai-je besoin de NVSwitch pour l’inférence LLM ?
Vous devez vous soucier de NVSwitch lorsque l’inférence utilise plusieurs GPU pour une seule réplique du modèle, surtout avec du tensor parallelism soumis à des objectifs de latence ou de débit. Si chaque GPU sert des tâches indépendantes sur un seul GPU, NVSwitch peut être bien moins important.
NVLink remplace-t-il InfiniBand ?
Non. NVLink et NVSwitch sont des fabrics GPU scale-up. InfiniBand ou Ethernet connecte les nœuds, les racks, le stockage et les clusters plus grands. Les grands systèmes d’IA ont souvent besoin des deux.
Quelle est la plus grande différence nvlink vs nvswitch ?
La plus grande différence entre nvlink et nvswitch est la portée. NVLink est une liaison de communication directe entre GPU. NVSwitch connecte de nombreux GPU équipés de NVLink dans un tissu all-to-all plus vaste.
Dois-je choisir H100, H200, B200 ou GB200 en fonction de NVSwitch ?
Ne choisissez pas uniquement sur la base de l’étiquette d’interconnexion. Faites correspondre la mémoire du GPU, la prise en charge de la précision, la disponibilité, le refroidissement, la maturité logicielle, le domaine NVLink, le réseau de scale-out et le coût d’output accepté à votre charge de travail. Puis exécutez un benchmark de topologie avant de vous engager.
Conclusion
Pour les clusters d’IA, nvlink vs nvswitch n’est pas un duel entre deux fonctionnalités interchangeables. NVLink est la liaison GPU haute vitesse. NVSwitch est le tissu qui rend utilisables de nombreux GPU connectés par NVLink comme un domaine de communication plus vaste. InfiniBand ou Ethernet est le réseau de scale-out autour de ce domaine.
La leçon d’achat est simple : demandez la topologie, pas seulement le nom du GPU. Si votre charge de travail est limitée par la communication, NVSwitch peut être essentiel aux performances. Si votre charge de travail est limitée par la sortie et ne nécessite pas de contrôle matériel, benchmarkez un chemin modèle/API avec Flatkey avant de louer une topologie que vous devrez exploiter.
Références officielles
- NVIDIA, « NVIDIA NVLink and NVLink Switch »
- NVIDIA Technical Blog, « NVIDIA NVLink and NVIDIA NVSwitch Supercharge Large Language Model Inference »
- NVIDIA DGX H100/H200 User Guide
- NVIDIA DGX B200 User Guide
- NVIDIA GB200 NVL72
- NVIDIA NCCL User Guide, « Collective Operations »
- NVIDIA NCCL User Guide, « Environment Variables »


