
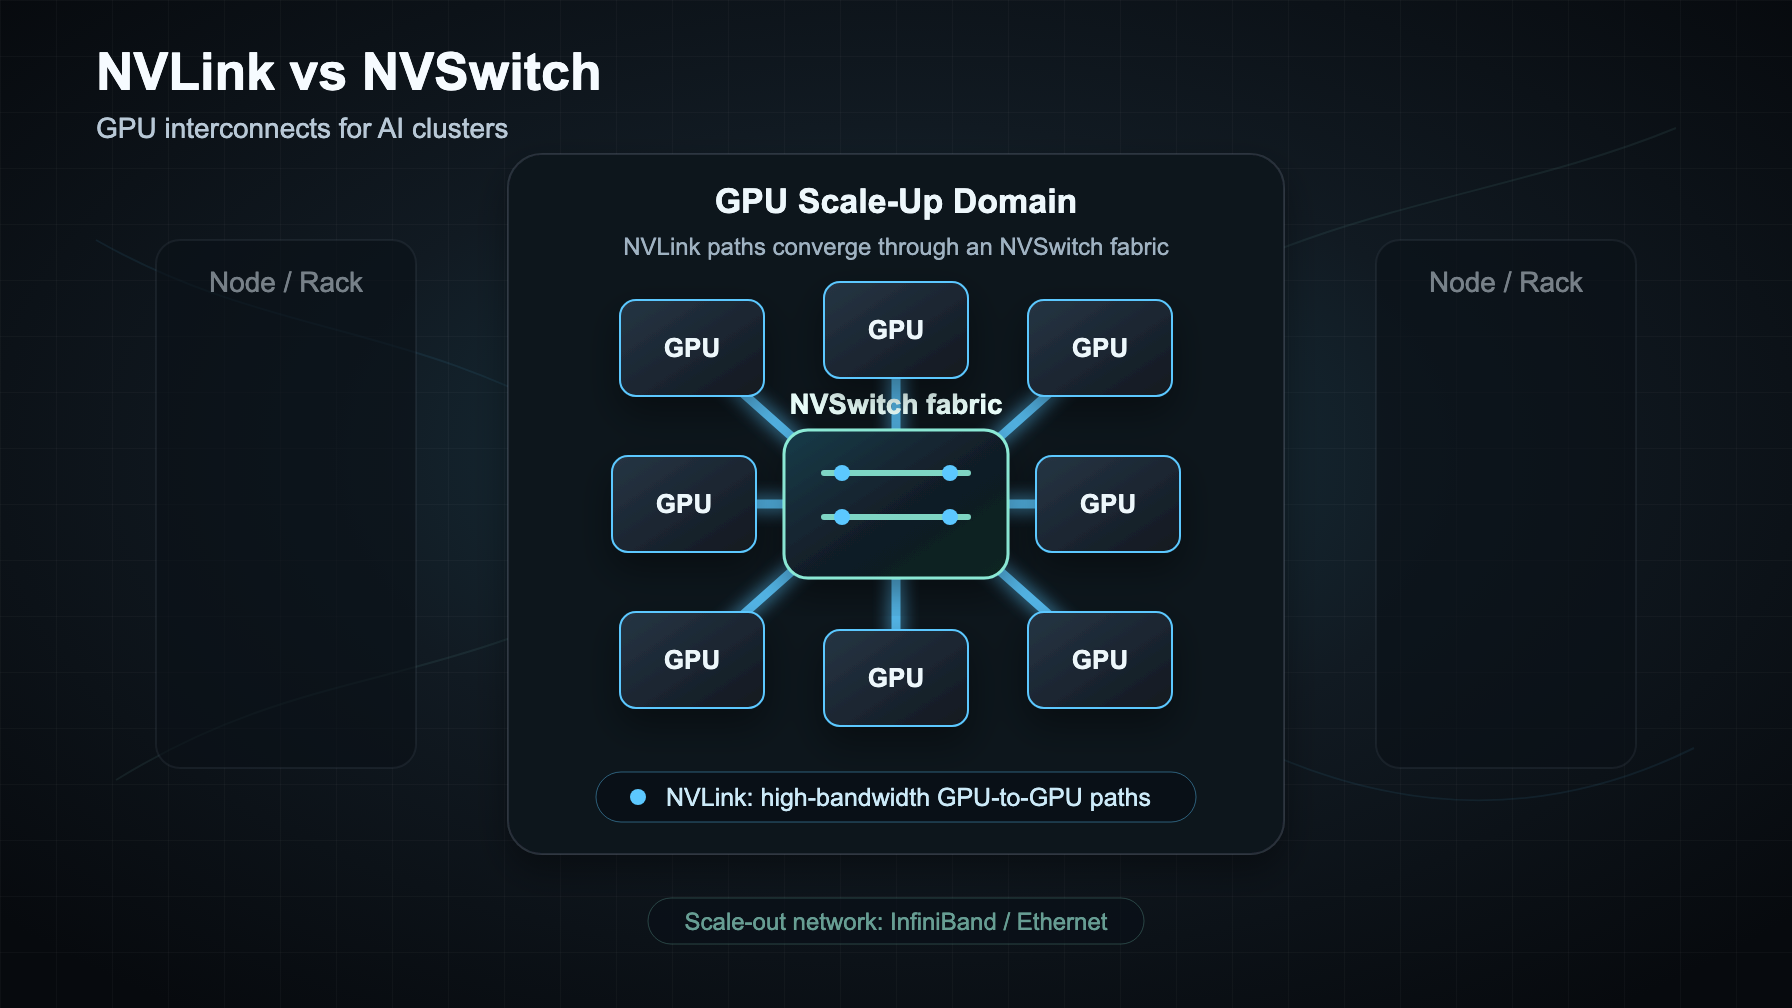
NVLink vs NVSwitch: Interconexiones de GPU explicadas para clústeres de IA
Si está comparando NVLink vs NVSwitch, la respuesta breve es esta:
- NVLink es el enlace GPU a GPU de alto ancho de banda.
- NVSwitch es la estructura de conmutación que permite que muchas GPU conectadas por NVLink se comuniquen entre sí sin obligar a cada par de GPU a usar un pequeño carril punto a punto.
- InfiniBand o Ethernet sigue siendo la red de escalado horizontal que conecta sistemas, racks, almacenamiento y clústeres más grandes.
Esa distinción importa cuando alquila GPU, compra un sistema HGX o DGX, o decide si una carga de trabajo realmente necesita acceso directo al clúster en lugar de una API de modelo gestionada. Una GPU rápida no basta si el modelo pasa demasiado tiempo esperando sincronizaciones de paralelismo tensorial, all-reduce, all-gather, reduce-scatter o tráfico all-to-all.
Esta guía explica las diferencias entre nvidia nvlink vs nvswitch en términos prácticos de clúster: qué hace cada componente, dónde encaja InfiniBand, cuándo la topología cambia el rendimiento de LLM y qué preguntas hacer antes de comprometerse con una costosa arquitectura de clúster de GPU.
NVLink vs NVSwitch: la diferencia rápida
| Capa | Qué es | Alcance típico | Qué mejora | Qué no reemplaza |
|---|---|---|---|---|
| NVLink | Interconexión directa GPU a GPU de alto ancho de banda | Enlaces GPU a GPU dentro de plataformas NVIDIA compatibles | Paralelismo tensorial, movimiento de memoria entre GPUs pares, comunicación colectiva dentro de un dominio de escalado vertical | No es por sí sola una red de clúster |
| NVSwitch | Silicio de conmutación y estructura para endpoints NVLink | Servidor multinodo GPU, placa base o dominio NVLink a escala de rack según la plataforma | Comunicación GPU a GPU all-to-all, estructura GPU no bloqueante o de mayor bisección, dominios GPU más grandes | No elimina la necesidad de InfiniBand/Ethernet para el escalado horizontal del clúster |
| InfiniBand / Ethernet | Estructura de red entre sistemas y racks | Entre nodos, almacenamiento, gestión, clústeres multirack | Entrenamiento distribuido en muchos nodos, acceso al almacenamiento, tráfico de servicios, dominios de planificación | No crea ancho de banda local NVLink entre GPUs dentro de un nodo |
La diferencia entre nvlink vs nvswitch es más fácil de recordar como enlace vs estructura. NVLink es la carretera entre GPUs. NVSwitch es el intercambio que permite que muchas de esas carreteras se encuentren sin convertir cada viaje en un estrecho camino punto a punto.
Qué hace NVLink
NVLink es la interconexión de alta velocidad de NVIDIA para la comunicación GPU a GPU. Está diseñada para los patrones de tráfico que resultan costosos a través de rutas PCIe ordinarias: capas de modelo paralelo, fragmentos tensoriales sincronizados, acceso a memoria entre pares y colectivas de alta frecuencia.
En las plataformas públicas actuales de NVIDIA, la generación importa:
| Generación de la plataforma | Punto de referencia público de NVIDIA | Ancho de banda NVLink por GPU |
|---|---|---|
| Hopper | Generación H100/H200 | 900 GB/s |
| Blackwell | Generación B200/GB200 | 1,800 GB/s |
| Vera Rubin | Plataforma de próxima generación anunciada | 3,000 GB/s preliminares |
Para un comprador de infraestructura, esas cifras no garantizan que cada carga de trabajo obtenga una mejora de velocidad equivalente. Indican el techo de comunicación disponible para la topología. La ganancia real depende del tamaño del modelo, la estrategia de paralelismo, el tamaño del lote, la longitud de secuencia, el comportamiento del framework, la colocación y de si la carga de trabajo está limitada por la comunicación.
Use NVLink como señal de compra cuando su carga de trabajo utilice varias GPU para una sola solicitud, un paso de entrenamiento o un grupo de fragmentos del modelo. Es mucho menos importante cuando cada GPU atiende trabajos independientes con poca comunicación entre pares.
Qué hace NVSwitch
NVSwitch es la capa de conmutación que conecta muchos endpoints NVLink en una estructura GPU de mayor ancho de banda. Sin una estructura de conmutación, un sistema multinodo GPU puede acabar dividiendo el presupuesto de enlaces disponible de cada GPU entre muchas conexiones punto a punto. Con NVSwitch, los sistemas compatibles pueden dar a cada GPU una ruta más uniforme hacia todas las demás GPU en el dominio NVLink.
Por eso nvswitch vs nvlink no es una elección entre dos sustitutos. NVSwitch utiliza conexiones NVLink para construir una estructura. El switch es útil porque ocho, dieciséis o setenta y dos GPU no se comportan como dos GPU conectadas por cable.
En ejemplos públicos de NVIDIA:
- Los sistemas DGX H100/H200 usan ocho GPU H100 o H200 y enumeran 900 GB/s de ancho de banda GPU a GPU con redes de clúster a través de puertos ConnectX-7 InfiniBand/Ethernet.
- Los sistemas DGX B200 usan ocho GPU B200 y enumeran dos switches NVLink de quinta generación con 14.4 TB/s de ancho de banda agregado; compare las ventajas y desventajas de compra en nuestra guía B200 vs H200.
- GB200 NVL72 conecta 36 CPU Grace y 72 GPU Blackwell en un diseño a escala de rack; NVIDIA lo describe como un dominio NVLink de 72 GPU con 130 TB/s de comunicación GPU de baja latencia. Para la selección de plataforma, consulte GB200 vs B200.
La conclusión práctica: NVSwitch adquiere más importancia a medida que aumenta el número de GPU en un dominio de escalado vertical y a medida que más del camino crítico de la carga de trabajo se convierte en comunicación GPU a GPU.
NVLink vs NVSwitch vs InfiniBand
La frase nvlink vs nvswitch vs infiniband suele ocultar tres preguntas de diseño distintas:
- Dentro de un sistema GPU: ¿Tienen las GPU suficiente ancho de banda entre pares para paralelismo de tensores, etapas de pipeline o inferencia multinodo?
- Dentro de un dominio a escala de rack: ¿Pueden muchas GPU actuar como una única estructura de aceleración más grande para paralelismo de modelos a gran escala?
- Entre muchos nodos o racks: ¿Puede la red del clúster transportar de forma predecible el entrenamiento distribuido, la carga de datos, el almacenamiento, el checkpointing y el tráfico de servicio?
NVLink y NVSwitch responden a las dos primeras preguntas. InfiniBand o Ethernet responden a la tercera.
Por ejemplo, un nodo HGX o DGX de ocho GPU con NVSwitch puede ser excelente para una réplica de modelo que necesita un paralelismo de tensores muy ajustado entre las GPU del nodo. Si necesitas cientos o miles de GPU, sigues necesitando una red de escalado horizontal. En los sistemas de rack Blackwell, NVIDIA combina grandes dominios NVLink con InfiniBand o Ethernet Spectrum-X para escalar más allá del rack.
No preguntes si NVLink reemplaza a InfiniBand. Pregunta qué tráfico debería permanecer dentro del dominio NVLink y qué tráfico debe cruzar la estructura del clúster.
Por qué las cargas de trabajo de IA se preocupan por la topología
Las cargas de trabajo modernas de LLM no son solo multiplicación de matrices. Una vez que un modelo se divide entre dispositivos, cada capa puede introducir comunicación.
Los patrones de comunicación comunes incluyen:
- All-reduce: cada rank aporta valores y recibe el resultado reducido.
- Reduce-scatter y all-gather: bloques de construcción comunes para estrategias de paralelismo de tensores y de datos.
- All-to-all: cada rank envía distintos fragmentos a otros ranks, lo cual importa para algunos diseños con paralelismo de expertos y mucha dependencia del enrutamiento.
- Movimiento de la caché KV y de activaciones: depende de la implementación, pero a menudo es sensible a la localidad y al emplazamiento.
NCCL documenta estas operaciones colectivas como operaciones basadas en ranks entre dispositivos CUDA. Eso es importante porque el software ve ranks, no términos de marketing. Una buena infraestructura solo ayuda si la colocación de tus ranks, el framework, el contenedor, la configuración de NCCL y la disposición del scheduler permiten que el trabajo la aproveche.
En la discusión de NVIDIA sobre inferencia de LLM, la inferencia con paralelismo de tensores requiere que las GPU intercambien resultados después de trabajar en una capa del modelo antes de que pueda continuar la siguiente capa. Cuando ese intercambio es lento, los Tensor Cores pueden quedar inactivos. Esa es la razón principal por la que NVSwitch puede importar para el serving multinodo.
Cuándo merece la pena prestar atención a NVSwitch
Prioriza sistemas basados en NVSwitch cuando se cumpla una de estas condiciones:
- Sirves modelos que necesitan paralelismo de tensores entre varias GPU para cumplir objetivos de latencia.
- Los trabajos de entrenamiento o fine-tuning muestran mucho tiempo de operaciones colectivas en los profiler.
- Planeas ejecutar inferencia con lotes grandes donde la sincronización GPU a GPU aumenta con la concurrencia.
- Necesitas comunicación all-to-all predecible entre todas las GPU de un nodo de ocho GPU.
- Estás evaluando sistemas a escala de rack como GB200 NVL72, donde el dominio NVLink es una característica principal del producto.
NVSwitch es menos decisivo cuando:
- Los trabajos son embarrassingly parallel y cada GPU ejecuta trabajo independiente.
- La carga de trabajo está limitada por CPU, almacenamiento o carga de datos.
- El modelo cabe cómodamente y se sirve en una sola GPU.
- La aplicación llama a APIs de modelos alojados y no gestiona directamente la topología del hardware.
- El cuello de botella es la red entre nodos, no la comunicación entre GPU dentro del nodo.
La pregunta correcta no es "¿Esta GPU tiene NVLink?" Es "¿Mantendrá mi carga de trabajo crítica ocupadas a varias GPU dentro del mismo dominio NVLink/NVSwitch lo suficiente como para justificar la prima?"
Lista de verificación de compras para sistemas NVLink frente a NVSwitch
Usa esta lista de verificación antes de alquilar o comprar un clúster de GPU, y acompáñala con una revisión de TCO de clúster GPU antes de firmar una reserva larga.
| Pregunta | Por qué importa |
|---|---|
| ¿Qué SKU exacto de GPU y factor de forma se ofrece? | Los sistemas H100 PCIe, H100 SXM, H200, B200 y GB200 pueden exponer topologías y anchos de banda muy distintos. |
| ¿El sistema es solo NVLink punto a punto, está respaldado por NVSwitch o es un dominio NVLink a escala de rack? | "Tener NVLink" no es suficiente. Necesitas la forma de la infraestructura. |
| ¿Cuántas GPU hay en un dominio NVLink? | El tamaño del dominio afecta a las opciones de colocación para paralelismo de tensores y paralelismo de modelos. |
| ¿Cuál es la red entre nodos: InfiniBand, RoCE, Ethernet Spectrum-X o Ethernet convencional? | NVSwitch no soluciona una red de escalado horizontal débil. |
| ¿Hay pruebas NCCL disponibles para la forma exacta alquilada? | Las operaciones colectivas sintéticas revelan si la topología, los drivers, las líneas y los contenedores están conectados correctamente. |
| ¿Puedes fijar un nodo completo o un dominio? | La tenencia compartida puede romper las suposiciones sobre localidad y repetibilidad. |
| ¿Están documentadas las líneas de red y la colocación de NIC? | NCCL puede necesitar una selección correcta de interfaz y una colocación consciente de las líneas a escala. |
| ¿Qué ocurre cuando una GPU, una bandeja de switch o una NIC se degrada? | La resiliencia y la política de reemplazo afectan al tiempo de actividad en producción. |
| ¿Qué benchmark debe aprobarse antes de una reserva larga? | El coste de salida aceptada es más útil que un precio horario bruto. |
Plan de benchmark: demuestra la infraestructura antes de reservar
Para reservas de GPU de alto coste, ejecuta una prueba de aceptación de topología antes de comprometerte a largo plazo.
- Inventaria la topología. Captura
nvidia-smi topo -m, el SKU de la GPU, el driver, CUDA, la versión de NCCL, las NIC y la imagen del contenedor. - Ejecuta colectivas NCCL. Prueba all-reduce, reduce-scatter, all-gather y all-to-all con tamaños de mensaje que se parezcan a tu carga de trabajo.
- Mide la latencia de la carga de trabajo real. Usa tu modelo real, la longitud de contexto, la política de batch y los ajustes de paralelismo.
- Compara la colocación dentro del dominio y entre nodos. Comprueba si el programador mueve accidentalmente los ranks por rutas más lentas.
- Sigue el coste por salida aceptada. Para inferencia, mide tokens aceptados o respuestas exitosas por dólar, no solo tokens por segundo. Para entrenamiento, mide progreso de la pérdida o muestras completadas por dólar.
- Registra el comportamiento ante fallos. Mata un worker, reinicia un contenedor o simula una NIC degradada si el proveedor lo permite.
Si un proveedor no puede decirte la topología ni ejecutar un benchmark básico de NCCL, tómalo como una señal de riesgo. Las tarifas por hora también necesitan contexto de precios de alquiler de GPU, compromisos de capacidad, complementos de red y costes de ejecuciones fallidas.
Errores comunes
Error 1: Tratar NVLink como sinónimo de NVSwitch. Una plataforma puede exponer enlaces NVLink sin ofrecerte el mismo comportamiento all-to-all que un sistema respaldado por NVSwitch.
Error 2: Suponer que NVSwitch elimina el diseño de red. NVSwitch ayuda al dominio de GPU de scale-up. El entrenamiento multi-nodo sigue necesitando un diseño serio de InfiniBand o Ethernet.
Error 3: Comprar ancho de banda para trabajos independientes. Si cada GPU ejecuta un worker de inferencia separado, NVSwitch puede no mejorar la utilización lo suficiente como para justificar el coste.
Error 4: Comparar precios de GPU por hora sin topología. Dos ofertas de "8x H100" pueden comportarse de forma diferente si una es SXM con NVSwitch y otra es PCIe o tiene una red más débil.
Error 5: Ignorar la colocación del software. El mapeo de ranks de NCCL, las versiones de contenedor, la selección de la interfaz de red y la política del programador pueden anular las ventajas del hardware.
Matriz de decisión
| Carga de trabajo | Importancia de NVLink | Importancia de NVSwitch | Importancia de la red de scale-out | Recomendación práctica |
|---|---|---|---|---|
| Inferencia en una sola GPU | Baja | Baja | Baja a media | Optimiza la memoria de la GPU, el batching y la elección del modelo antes de pagar por NVSwitch. |
| Inferencia tensor-parallel de 2-8 GPU | Alta | Alta en sistemas de 8 GPU | Media | Prefiere sistemas H100/H200/B200 respaldados por NVSwitch y evalúa la latencia real. |
| Entrenamiento distribuido multi-nodo | Alta dentro de cada nodo | Alta dentro de cada nodo | Muy alta | Evalúa tanto la interconexión del nodo como InfiniBand/Ethernet; no juzgues solo por el SKU de la GPU. |
| Modelos expert-parallel o con mucho all-to-all | Alta | Alta | Alta al cruzar nodos | Prueba all-to-all y la colocación directamente; la topología puede dominar. |
| Generación offline por lotes | Media | Media | Media | Mide la salida aceptada por dólar; NVSwitch puede ayudar con tamaños de batch más altos. |
| Carga de trabajo de producto API-first | Normalmente abstraída | Normalmente abstraída | Responsabilidad del proveedor | Compara el control directo de la GPU con una base de referencia de modelo/API antes de alquilar hardware. |
Dónde encaja Flatkey
Flatkey es una pasarela unificada de API para LLM: una clave, una factura y un endpoint compatible con OpenAI para muchos modelos de texto, imagen y vídeo. Eso no sustituye a los clústeres de GPU directos cuando necesitas kernels personalizados, pesos privados, control de fine-tuning o trabajo de rendimiento específico de la topología.
Es útil como línea base cuando el objetivo del negocio es la salida, no la propiedad de la infraestructura. Antes de reservar un clúster con topología intensiva para inferencia, compara el plan del clúster con una ruta de modelo/API gestionada:
- ¿Qué calidad y latencia obtienes de los modelos alojados?
- ¿Cuál es el coste por respuesta aceptada después de reintentos y generaciones fallidas?
- ¿Cuánto tiempo de ingeniería consumirá la operación del clúster?
- ¿La carga de trabajo requiere control directo de la memoria de la GPU o solo salidas fiables del modelo?
Si la línea base del modelo/API ya cumple el requisito del producto, NVLink frente a NVSwitch puede ser una optimización que aún no necesitas asumir. Si la carga de trabajo necesita despliegue privado, serving personalizado o objetivos de latencia estrictos a escala, compara las ventajas y desventajas de nube de GPU vs API de modelo, y luego usa la lista de verificación anterior para comprar la topología adecuada en lugar del nombre de GPU más reconocible.
FAQ
¿NVSwitch es más rápido que NVLink?
NVSwitch no es simplemente "NVLink más rápido". NVLink es el enlace de la GPU. NVSwitch es la estructura que conecta múltiples endpoints NVLink para que muchas GPU puedan comunicarse de forma eficiente. En los sistemas compatibles, NVSwitch puede preservar un ancho de banda alto entre GPU en más pares de GPU que un diseño simple punto a punto.
¿Necesito NVSwitch para la inferencia de LLM?
Debes prestar atención a NVSwitch cuando la inferencia usa varias GPU para una sola réplica del modelo, especialmente con paralelismo tensorial bajo objetivos de latencia o rendimiento. Si cada GPU atiende trabajos independientes de una sola GPU, NVSwitch puede importar mucho menos.
¿NVLink sustituye a InfiniBand?
No. NVLink y NVSwitch son tejidos de scale-up para GPU. InfiniBand o Ethernet conecta nodos, racks, almacenamiento y clústeres más grandes. Los sistemas de IA grandes a menudo necesitan ambos.
¿Cuál es la mayor diferencia entre nvlink y nvswitch?
La mayor diferencia entre nvlink y nvswitch es el alcance. NVLink es un enlace directo de comunicación entre GPU. NVSwitch conecta muchas GPU equipadas con NVLink en una red all-to-all más amplia.
¿Debería elegir H100, H200, B200 o GB200 en función de NVSwitch?
No elija solo por la etiqueta de interconexión. Ajuste la memoria de la GPU, el soporte de precisión, la disponibilidad, la refrigeración, la madurez del software, el dominio NVLink, la red de escala horizontal y el costo aceptado de salida a su carga de trabajo. Luego ejecute una prueba de referencia de topología antes de comprometerse.
Conclusión
Para los clústeres de IA, nvlink vs nvswitch no es una batalla entre dos funciones intercambiables. NVLink es el enlace de alta velocidad entre GPU. NVSwitch es la red que hace que muchas GPU conectadas por NVLink sean utilizables como un dominio de comunicación más grande. InfiniBand o Ethernet es la red de escala horizontal alrededor de ese dominio.
La lección de compra es simple: pida la topología, no solo el nombre de la GPU. Si su carga de trabajo está limitada por la comunicación, NVSwitch puede ser central para el rendimiento. Si su carga de trabajo está limitada por la salida y no requiere control de hardware, evalúe una ruta de modelo/API con Flatkey antes de alquilar una topología que tendrá que operar.
Referencias oficiales
- NVIDIA, "NVIDIA NVLink y NVLink Switch"
- Blog técnico de NVIDIA, "NVIDIA NVLink y NVIDIA NVSwitch potencian la inferencia de modelos de lenguaje de gran tamaño"
- Guía del usuario de NVIDIA DGX H100/H200
- Guía del usuario de NVIDIA DGX B200
- NVIDIA GB200 NVL72
- Guía del usuario de NVIDIA NCCL, "Operaciones colectivas"
- Guía del usuario de NVIDIA NCCL, "Variables de entorno"


