
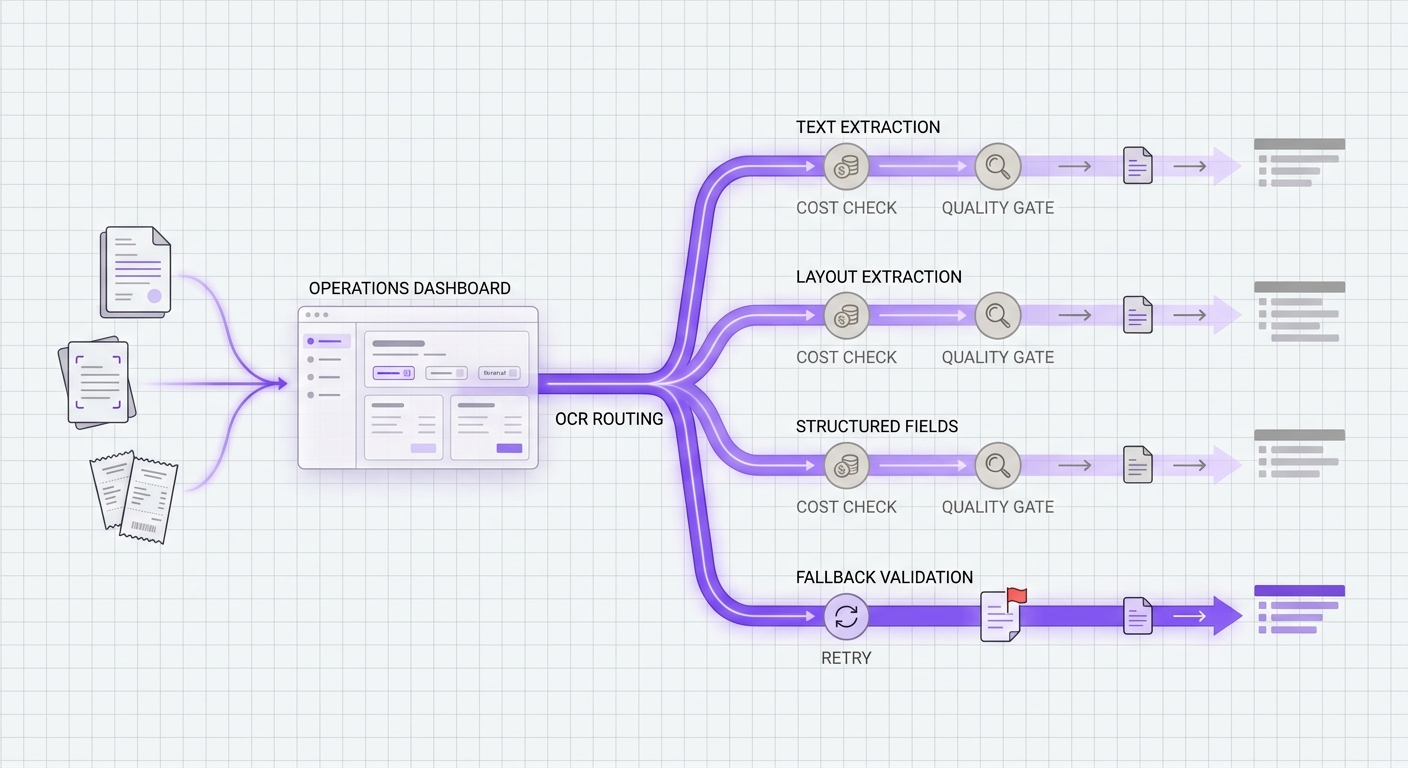
如果你正在规划 OCR 模型路由,真正有风险的并不是找不到一个能够从扫描件中读取文本的 OCR 模型。真正有风险的是:决定哪条路由处理简单图片,哪条路由处理多页 PDF,哪条路由提取结构化字段,以及当第一条路由失败时,允许哪个回退去处理同一类文档。
这就是为什么 OCR 模型路由应该从工作负载策略开始,而不是从供应商排行榜开始。低成本的文本 OCR 路径对于发票来说可能是错误选择;高质量的结构化提取器用于海量归档文本时可能是浪费;回退在表面上看起来很可靠,但它可能会悄悄丢掉表格、超出页数限制,或者在重试风暴中让成本翻倍。
本指南为媒体、产品和工程团队提供一种实用方法,帮助他们在标准化文档流量之前平衡文本提取成本、质量和回退检查。它将 AI OCR API 路由和文档 AI 模型路由视为运行决策,而不是一次性的基准测试练习。
快速答案
最安全的 OCR 模型路由策略会将文档任务分为四类:
| Route class | Use it for | Primary decision | Fallback rule |
|---|---|---|---|
| Plain text OCR | Screenshots, scanned notes, simple image text, searchable archives | Lowest approved cost per accepted page | Fallback only to another route that preserves text completeness and language coverage |
| Layout-aware OCR | PDFs, receipts, reports, catalogs, slide exports | Reading order, tables, paragraphs, and downstream chunk quality | Fallback only when layout quality remains acceptable |
| Structured extraction | Invoices, tax forms, contracts, IDs, claims, applications | Field accuracy and schema stability | Fallback only to a route that can return the same required fields |
| Restricted documents | Regulated or contract-sensitive files | Data handling, retention, region, and vendor approval | Fallback only inside the same approved provider set |
这就是 OCR 模型路由的核心:选择最适合文档及其输出形式的路由,然后只在备用方案能够满足相同的成本、质量和控制要求时才允许回退。
为什么文本提取成本容易被误读
OCR API 成本很少只是一个简单的数字。供应商可能会分别对基础 OCR、布局分析、表单、表格、查询、自定义提取或批处理定价。有些页面按页计费。有些工作流在同一页面需要结构化字段时会收取更高费用。有些限制会把流量从同步调用推送到异步任务。
在比较 OCR 路由之前,请将每个候选方案归一化为相同的操作单位:
| 指标 | 为什么它应该出现在路由表中 |
|---|---|
| 每个已接受页面的成本 | 如果某条路由会产生更多被拒绝的输出或重试,那么原始页面价格并不够。 |
| 每个已接受结构化文档的成本 | 发票和表单应按可用字段输出来衡量,而不只是按 OCR 文本来衡量。 |
| 同步页面/文件限制 | 无法接受该文件形态的路由不能作为有效回退。 |
| 异步作业限制 | 大型 PDF 和归档批次需要感知队列的路由。 |
| 功能层级 | 表单、表格、查询、签名和版式都会改变实际价格。 |
| 配额和限流行为 | 在低吞吐量下看起来便宜的路由,在批量负载下可能会失败。 |
官方定价页面说明了为什么单位归一化很重要。Amazon Textract 定价为 Detect Document Text、Analyze Document、Analyze Expense、Analyze ID 和 Analyze Lending 列出了单独的 API 和功能。其示例显示,在美国西部(俄勒冈),Detect Document Text 的价格为前 100 万页每页 $0.0015,而用于表单和表格的 Analyze Document 示例则将每个表格页 $0.015 与每个表单页 $0.05 组合计价。Google Document AI 定价将 Enterprise Document OCR、OCR add-ons、Layout Parser、Custom Extractor 和 Form Parser 列为单独的计费对象。Azure Document Intelligence 说明计费按月根据模型类型和已分析页数计算,其服务限制页面将路由行为与文件大小、页数以及每秒事务数限制绑定在一起。
OCR 模型路由的教训很简单:在统一工作负载、输出形态、计费单位和重试策略之前,不要比较各家供应商的首页标价。
在基准测试模型之前先构建路由表
团队常常会把几份测试文档送入多个 OCR 模型,然后选择那个“看起来最好”的模型。这对于演示可能有效,但无法形成持久的路由策略。
先构建路由表。对于文档 AI 模型路由来说,这个表是契约,它能防止简单 OCR、版式提取和结构化提取都坍塌为同一条默认路由。如果你已经在网关中跟踪路由质量,可以将此表与一个 AI 路由 API 指标 评分卡配合使用:
| 工作负载 | 示例输入 | 所需输出 | 默认路由行为 | 拒绝条件 |
|---|---|---|---|---|
| 可检索档案 OCR | 扫描版 PDF、截图、历史报告 | 可接受阅读顺序的纯文本 | 最低成本的已批准路由 | 缺页、语言错误、顺序混乱 |
| 收据或发票录入 | 收据、发票、付款文档 | 字段、总计、日期、明细行 | 结构化提取路由 | 必填字段缺失或置信度过低 |
| 目录或报告理解 | 产品目录、密集报告、幻灯片组 | 具备版面感知的文本和表格 | 带表格检查的版面路由 | 表格合并、列丢失、章节顺序被破坏 |
| 身份证或申请审核 | 身份证、申请表、入职表单 | 特定字段以及审计轨迹 | 已批准的受限路由 | 提供商未获授权、保留策略未知、字段不匹配 |
| 批量迁移 | 大型 PDF 或图像档案 | 完整的页面覆盖 | 带页面容量余量的异步路由 | 作业过大、限流、未完成 |
一旦有了这张表,模型评估就会更有价值。你不再是在问“哪个 OCR 模型最好?”而是在问“对于这个确切的文档类别,以这个成本和回退风险,哪条路由是可接受的?”这就是演示与能够经受生产流量考验的 AI OCR API 路由之间的实际差别。
质量门槛应与输出匹配,而不是与演示匹配
OCR 质量需要针对不同工作负载设置不同的门槛。
对于纯文本 OCR,衡量:
- 页面覆盖率。
- 字符和词语完整性。
- 阅读顺序。
- 对语言和手写体的容忍度。
- 需要人工复核的页面占比。
对于版面感知 OCR,衡量:
- 段落分组。
- 标题层级。
- 表格边界。
- 列顺序。
- 下游搜索、检索或复核界面质量是否提升。
对于结构化提取,衡量:
- 必填字段精确率。
- 必填字段召回率。
- 日期、金额、姓名和 ID 的规范化稳定性。
- 置信度校准。
- 主路由和回退路由之间的 schema 兼容性。
这正是许多 OCR 模型路由项目失败的地方。返回纯文本的回退并不等同于结构化发票提取器。即使某条路由保留了大多数词语,但丢失了表格边界,仍然可能破坏检索或复核工作流。一个精度很高但无法处理相同页数的模型,也不是批量 PDF 的安全回退选择。
回退检查是一项产品需求
回退不应该意味着“再试一个 OCR 提供商”。它应该意味着“尝试另一条已批准的路由,这条路由能够满足相同的工作负载契约”。
在某条路由可以成为回退之前,请使用这份清单:
| 回退检查 | 通过条件 |
|---|---|
| 相同文档类别 | 回退方案接受相同的文件类型、页数和大小。 |
| 相同输出契约 | 回退方案返回相同的必需文本、版式或字段。 |
| 相同数据控制 | 回退方案满足相同的保留、区域和客户合同规则。 |
| 相同可观测性 | 回退方案记录路由、成本、延迟、错误、置信度和拒绝原因。 |
| 受限重试成本 | 按作业、租户和批次限制重试与回退预算上限。 |
| 人工复核路径 | 非等价失败进入复核,而不是静默降级。 |
Amazon Textract 是一个有用的例子,说明为什么回退资格必须包含文档限制:它的 document limits 说明同步 PDF 和 TIFF 操作仅限一页,而异步 PDF 和 TIFF 操作最多允许 3,000 页。Azure Document Intelligence service limits 记录了 Standard 层分析事务默认 15 TPS 的限制、500 MB 的最大文档大小,以及 2,000 页的分析限制。Google Document AI quotas 记录了处理器配额、在线请求限制,以及生成式处理器版本的每分钟页数配额。
这些约束并不是边缘情况。它们决定了回退是否有效。
OCR 模型路由的实用决策树
当新的文档任务进入流水线时,使用这棵决策树:
- 在调用 OCR 路由之前先对文档分类。
- 决定输出需要纯文本、版式,还是结构化字段。
- 排除不满足保留、区域、合同、文件类型、页数或配额要求的路由。
- 估算每个被接受输出的成本,而不仅仅是原始每页成本。
- 运行主路由。
- 应用与工作负载相关的质量门控。
- 仅对瞬时错误或安全的幂等失败进行重试。
- 仅在相同路由类别内进行回退。
- 将非等价失败发送到复核或批处理队列。
- 记录路由决策、成本、置信度、回退原因,以及最终接受/拒绝状态。
以下是简化形式的路由策略:
document_job:
  classify:
    inputs: [file_type, page_count, document_type, customer_tier, data_region]
  exclude:
    - route_not_approved_for_data_policy
    - route_page_limit_below_job_size
    - route_missing_required_output_contract
  choose_primary:
    optimize_for: cost_per_accepted_output
    guardrails: [quality_gate, latency_budget, quota_headroom]
  fallback:
    allowed_only_when:
      - transient_error
      - same_route_class
      - same_output_contract
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log: [route, model, cost, latency, confidence, error_class, fallback_reason]
策略比模型列表更重要。以后可以添加新的 OCR 模型,而无需重写文档工作流。
Flatkey 在 OCR 模型路由中的作用
当团队希望为模型访问、支出可见性和路由审查提供一个统一的运维层,而不是把提供商密钥分散到各个代理、作业和服务中时,Flatkey 在 OCR 模型路由中很有用。如果你的团队仍在直接配置提供商账户,请先阅读 统一 AI API 工作流,然后再参照 模型回退策略手册 来映射 OCR 特定的回退规则。
Flatkey 当前的公开网站将产品定位为围绕一个密钥、一个平衡机制、模型和工具使用、按成功调用计费、共享账本,以及一个包含实时可用性、价格、端点支持和模型详情页面的公开 模型目录。对于 OCR 工作流而言,这使网关最适合作为控制平面:验证可用的多模态或文档能力路由,定义哪些工作负载可以使用它们,并在一个地方查看路由级别的成本和失败情况。
不要把任何网关目录当作你自己 OCR 质量测试的替代品。应将其视为一个让已批准路由、使用数据、回退策略和成本控制更易于运维的地方。当你准备比较路由经济性时,请使用当前的 Flatkey 定价 页面,而不是旧实现说明中的过时模型名称。
发布检查清单
在将 OCR 模型路由投入生产之前,请确认以下事项:
- 每个文档类别都有默认路由和允许的回退类别。
- 每条路由都有按已接受页面或已接受结构化文档计算的标准化成本。
- 每个结构化工作流都有字段级质量门槛。
- 同步和异步页面限制已经用真实文件测试过,而不是根据示例假设。
- 配额和限流行为已在压测中体现。
- 受限文档只能使用已批准的路由。
- 失败作业会记录发生回退的原因以及输出是否被接受。
- 财务可以按路由、工作负载、租户和回退原因追踪支出。
- 产品团队为非等价失败提供人工审核路径。
当 OCR 模型路由变得易于运维时,它才真正发挥作用:便宜的工作仍然便宜,结构化工作使用合适的模型,而回退绝不会在无人察觉的情况下改变文档契约。
FAQ
什么是 OCR 模型路由?
OCR 模型路由是一个策略层,它会根据文档类型、所需输出、成本、质量要求和回退约束,将每个文档任务发送到某个 OCR 或文档 AI 路由。
团队应如何比较 OCR API 成本?
应按已接受输出比较 OCR API 成本。对于纯 OCR,通常是每个已接受页面的成本。对于发票、表单、合同和身份证件,通常是在重试和审核拒绝之后,每份已接受结构化文档的成本。
什么时候 OCR 回退会变得不安全?
当备用路由无法接受相同的文件形态、页数、数据策略或输出契约时,回退就变得不安全。对于需要结构化发票字段的工作流来说,纯文本 OCR 路由并不是一个安全的回退选择。
一个 OCR 模型应该处理所有文档类型吗?
通常不应该。简单 OCR、版面提取、结构化提取、大批量 PDF 和受限文档在成本、质量和控制要求上都不同。
Flatkey 如何帮助进行 OCR 模型路由?
Flatkey 可以帮助团队通过一个密钥、一个平衡、模型可用性检查、使用可见性以及路由级审查来运营 OCR 模型路由。团队在生产流量迁移之前,仍然需要运行自己的文档质量测试。


