
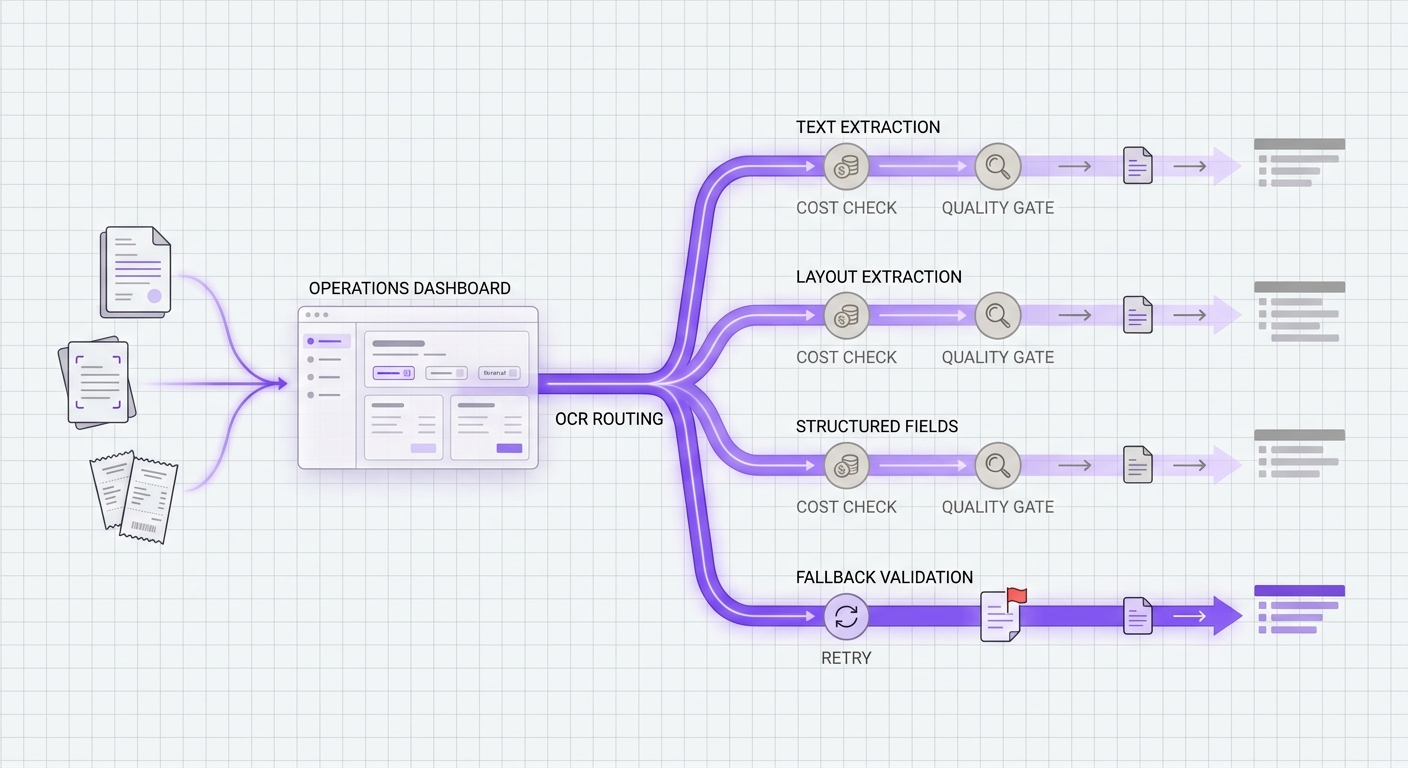
OCRモデルルーティングを計画する際、リスクが高いのはスキャンからテキストを読み取れるOCRモデルを見つけることではありません。リスクが高いのは、どのルートが単純な画像を処理するのか、どのルートが複数ページのPDFを処理するのか、どのルートが構造化フィールドを抽出するのか、そして最初のルートが失敗したときに同じ文書クラスに触れてよいフォールバックはどれなのかを決めることです。
だからこそ、OCRモデルルーティングはベンダーのランキングではなく、ワークロードポリシーから始めるべきです。安価なテキストOCRパスは請求書には不適切な選択かもしれません。高品質な構造化抽出器は、大量のアーカイブ文書には過剰かもしれません。フォールバックは、テーブルを静かに落としたり、ページ上限を超えたり、リトライストームのコストを倍増させたりするまで、信頼できるように見えることがあります。
このガイドでは、メディア、プロダクト、エンジニアリングの各チームが、文書トラフィックを標準化する前に、テキスト抽出コスト、品質、フォールバック検証のバランスを実務的に取る方法を示します。AI OCR APIルーティングとドキュメントAIモデルルーティングを、一回限りのベンチマークではなく、運用上の意思決定として扱います。
簡潔な答え
最も安全なOCRモデルルーティングポリシーは、文書ジョブを4つのクラスに分けます。
| ルートクラス | 用途 | 主な判断基準 | フォールバックルール |
|---|---|---|---|
| プレーンテキストOCR | スクリーンショット、スキャンしたメモ、単純な画像テキスト、検索可能なアーカイブ | 承認済みページあたりの最小コスト | テキストの完全性と言語カバレッジを維持できる別ルートへのフォールバックのみ |
| レイアウト認識OCR | PDF、レシート、レポート、カタログ、スライド書き出し | 読取順、表、段落、下流のチャンク品質 | レイアウト品質が許容範囲内に保てる場合のみフォールバック |
| 構造化抽出 | 請求書、税務書類、契約書、ID、請求、申請書 | フィールド精度とスキーマの安定性 | 同じ必須フィールドを返せるルートへのフォールバックのみ |
| 制限付き文書 | 規制対象または契約上機密性の高いファイル | データ処理、保持、リージョン、ベンダー承認 | 同じ承認済みプロバイダーセット内でのみフォールバック |
これがOCRモデルルーティングの中核です。文書と出力形式に合ったルートを選び、バックアップが同じコスト、品質、制御要件を満たせる場合にのみフォールバックを許可します。
テキスト抽出コストが誤解されやすい理由
OCR APIのコストは、きれいな一つの数字で表されることはほとんどありません。プロバイダーは、基本OCR、レイアウト分析、フォーム、テーブル、クエリ、カスタム抽出、バッチ処理をそれぞれ異なる料金で課金することがあります。ページ単位で課金される場合もあります。同じページに構造化フィールドが必要になると、ワークフローの費用が増えることもあります。制限によって、同期呼び出しから非同期ジョブへトラフィックが移されることもあります。
OCRルートを比較する前に、すべての候補を同じ運用単位に正規化してください。
| 指標 | ルーティング表に含めるべき理由 |
|---|---|
| 受理済みページあたりのコスト | ルートがより多くの拒否出力や再試行を生むなら、ページ単価そのものだけでは不十分です。 |
| 受理済み構造化ドキュメントあたりのコスト | 請求書やフォームは、OCRテキストだけでなく、利用可能なフィールド出力で測定すべきです。 |
| 同期ページ/ファイル制限 | ファイル形状を受け付けられないルートは、有効なフォールバックではありません。 |
| 非同期ジョブ制限 | 大きなPDFやアーカイブバッチには、キューを意識したルーティングが必要です。 |
| 機能ティア | フォーム、表、クエリ、署名、レイアウトによって、実効価格が変わることがあります。 |
| クォータとスロットリングの挙動 | 低ボリュームでは安価なルートでも、バッチ負荷下では失敗することがあります。 |
公式の料金ページは、なぜ単位の正規化が重要なのかを示しています。Amazon Textract の料金では、Detect Document Text、Analyze Document、Analyze Expense、Analyze ID、Analyze Lending に対して個別の API と機能が記載されています。例では、米国西部(オレゴン)で最初の100万ページについて Detect Document Text が1ページあたり $0.0015 と示されている一方、フォームと表の Analyze Document の例では、表ページあたり $0.015 とフォームページあたり $0.05 が組み合わされています。Google Document AI の料金では、Enterprise Document OCR、OCR add-ons、Layout Parser、Custom Extractor、Form Parser がそれぞれ別個の課金対象として並んでいます。Azure Document Intelligence では、課金はモデルの種類と解析したページ数に基づいて月次で計算されるとされており、サービス制限のページではルーティングの挙動がファイルサイズ、ページ数、1秒あたりのトランザクション上限に結びついています。
OCRモデルルーティングの教訓はシンプルです。ワークロード、出力形状、課金単位、再試行ポリシーを正規化するまでは、各ベンダーの表面的な価格を比較しないことです。
モデルをベンチマークする前にルート表を作る
チームはしばしば、いくつかのテスト文書を複数のOCRモデルに通して、「見た目が最も良い」ものを選びます。デモではそれで十分かもしれませんが、耐久性のあるルーティングポリシーにはなりません。
まずルート表を作成してください。ドキュメントAIのモデルルーティングでは、この表が、シンプルなOCR、レイアウト抽出、構造化抽出が1つのデフォルトルートに崩れ込むのを防ぐ契約になります。すでにゲートウェイでルーティング品質を追跡しているなら、この表をAIルーティングAPIメトリクスのスコアカードと組み合わせてください:
| ワークロード | 入力例 | 必要な出力 | デフォルトのルート動作 | 拒否条件 |
|---|---|---|---|---|
| 検索可能なアーカイブOCR | スキャンPDF、スクリーンショット、レガシーレポート | 許容できる読書順を備えたプレーンテキスト | 最も低コストの承認済みルート | ページ欠落、言語違い、順序の破綻 |
| レシートまたは請求書の取り込み | レシート、請求書、支払書類 | 項目、合計、日付、明細行 | 構造化抽出ルート | 必須項目の欠落または低信頼度 |
| カタログまたはレポートの理解 | 製品カタログ、密度の高いレポート、スライドデッキ | レイアウトを考慮したテキストと表 | 表チェック付きのレイアウトルート | 表の結合、列の欠落、セクション順の破綻 |
| IDまたは申請書の審査 | ID、申請書、オンボーディングフォーム | 特定の項目と監査証跡 | 承認済み制限ルート | プロバイダー未承認、保持期間不明、項目不一致 |
| バッチ移行 | 大きなPDFまたは画像アーカイブ | 完全なページカバレッジ | ページ上限に余裕のある非同期ルート | ジョブが大きすぎる、スロットリング、部分完了 |
この表ができると、モデル評価はより有用になります。もはや「どのOCRモデルが最適か?」と問うのではなく、「このコストとフォールバックリスクで、この特定の文書クラスに対してどのルートが許容できるか?」と問うようになります。それが、デモと、本番トラフィックに耐えうるAI OCR APIルーティングとの実践的な違いです。
品質ゲートはデモではなく、出力に合わせるべき
OCRの品質には、ワークロードごとに異なるゲートが必要です。
プレーンテキストOCRでは、次を測定します。
- ページカバレッジ。
- 文字と単語の完全性。
- 読書順。
- 言語と手書きへの耐性。
- 人手レビューが必要なページの割合。
レイアウト対応OCRでは、次を測定します。
- 段落のグルーピング。
- 見出しの階層。
- 表の境界。
- 列の順序。
- 下流の検索、取得、またはレビューUIの品質が向上するかどうか。
構造化抽出では、次を測定します。
- 必須項目の精度。
- 必須項目の再現率。
- 日付、金額、氏名、IDの正規化の安定性。
- 信頼度キャリブレーション。
- 主要ルートとフォールバックルート間のスキーマ互換性。
ここで多くのOCRモデルルーティングプロジェクトは失敗します。プレーンテキストを返すフォールバックは、構造化請求書抽出器と同等ではありません。大半の単語を保持していても表の境界を失うルートは、検索やレビューのワークフローを壊す可能性があります。同じページ数を処理できない高精度モデルは、バッチPDFに対する安全なフォールバックではありません。
フォールバック検証は製品要件である
フォールバックは「別のOCRプロバイダーを試す」という意味ではありません。「同じワークロード契約を満たせる、別の承認済みルートを試す」という意味であるべきです。
あるルートをフォールバックにできるかどうかを決める前に、このチェックリストを使ってください。
| フォールバック検証 | 合格条件 |
|---|---|
| 同じ文書クラス | フォールバックは同じファイルタイプ、ページ数、サイズを受け入れる。 |
| 同じ出力契約 | フォールバックは同じ必須テキスト、レイアウト、またはフィールドを返す。 |
| 同じデータ制御 | フォールバックは同じ保持、リージョン、顧客契約ルールを満たす。 |
| 同じ可観測性 | フォールバックはルート、コスト、レイテンシ、エラー、信頼度、拒否理由をログに記録する。 |
| 制限された再試行コスト | 再試行とフォールバックの予算は、ジョブ、テナント、バッチごとに上限が設定される。 |
| 手動レビュー経路 | 非同等の失敗は、静かな性能劣化ではなくレビューに送られる。 |
Amazon Textractは、フォールバックの適格性に文書制限を含める必要がある理由を示す有用な例です。document limitsによると、同期PDFおよびTIFF操作は1ページに制限され、非同期PDFおよびTIFF操作では最大3,000ページまで許可されます。Azure Document Intelligence service limitsは、Standard tierのanalyzeトランザクションに対するデフォルトの15 TPS制限、最大500 MBのドキュメントサイズ、2,000ページの分析上限を記載しています。Google Document AI quotasは、generative processor versions向けのprocessor quotas、オンラインリクエスト制限、ページ/分のクォータを記載しています。
これらの制約は特殊な例ではありません。フォールバックが有効かどうかを決定します。
実践的なOCRモデルルーティングの意思決定ツリー
新しい文書ジョブがパイプラインに入ったときは、この意思決定ツリーを使用してください。
- OCRルートを呼び出す前に、文書を分類する。
- 出力にプレーンテキスト、レイアウト、または構造化フィールドのどれが必要かを判断する。
- 保持、リージョン、契約、ファイルタイプ、ページ数、またはクォータ要件を満たさないルートを除外する。
- 生のページあたりのコストだけでなく、受け入れられた出力あたりのコストを見積もる。
- プライマリルートを実行する。
- ワークロード固有の品質ゲートを適用する。
- 再試行は、一時的なエラーまたは安全な冪等失敗に対してのみ行う。
- 同じルートクラス内でのみフォールバックする。
- 非同等の失敗はレビューまたはバッチキューに送る。
- ルートの決定、コスト、信頼度、フォールバック理由、および最終的な承認/却下状態をログに記録する。
ルーティングポリシーを簡潔に表すと次のとおりです。
document_job:
  classify:
    inputs: [file_type, page_count, document_type, customer_tier, data_region]
  exclude:
    - route_not_approved_for_data_policy
    - route_page_limit_below_job_size
    - route_missing_required_output_contract
  choose_primary:
    optimize_for: cost_per_accepted_output
    guardrails: [quality_gate, latency_budget, quota_headroom]
  fallback:
    allowed_only_when:
      - transient_error
      - same_route_class
      - same_output_contract
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log: [route, model, cost, latency, confidence, error_class, fallback_reason]
このポリシーは、モデル一覧よりも重要です。新しいOCRモデルは、文書ワークフローを書き直すことなく後から追加できます。
OCRモデルルーティングにおけるFlatkeyの位置づけ
Flatkey は、チームがモデルアクセス、支出の可視化、ルートレビューのための単一の運用レイヤーを求めていて、プロバイダーのキーをエージェント、ジョブ、サービス全体に散在させたくない場合に、OCRモデルルーティングで役立ちます。チームがまだプロバイダーの直接アカウントを使っているなら、まず 統一 AI API ワークフロー を参照し、その後 モデルのフォールバック戦略プレイブック に対して OCR 固有のフォールバックルールをマッピングしてください。
Flatkey の現在の公開サイトでは、1つのキー、1つの残高、モデルとツールの使用量、成功呼び出し課金、共有台帳、そしてリアルタイムの利用可能状況、価格、エンドポイント対応、モデル詳細ページを備えた公開 モデルディレクトリ を中心に製品が位置づけられています。OCR ワークフローでは、これによりゲートウェイはコントロールプレーンとして最も関連性が高くなります。利用可能なマルチモーダルまたはドキュメント対応ルートを検証し、どのワークロードがそれらを使えるかを定義し、ルートレベルのコストと失敗を一か所で確認できます。
どのゲートウェイのカタログも、自社の OCR 品質テストの代替とはみなさないでください。承認済みルート、使用データ、フォールバックポリシー、コスト管理を運用しやすくする場所として扱ってください。ルートの経済性を比較する準備ができたら、古い実装メモにある古いモデル名ではなく、現在の Flatkey の価格 表示を使ってください。
ローンチチェックリスト
OCR モデルルーティングを本番に移行する前に、次の項目を確認してください:
- すべての文書クラスにデフォルトルートと許可されたフォールバッククラスがある。
- すべてのルートに、受け入れられたページごと、または受け入れられた構造化文書ごとの正規化コストがある。
- すべての構造化ワークフローにフィールドレベルの品質ゲートがある。
- 同期および非同期のページ制限は、例から推測するのではなく、実ファイルでテストされている。
- クォータとスロットリングの挙動が負荷テストに反映されている。
- 制限付き文書は承認済みルートのみを使用できる。
- 失敗したジョブには、なぜフォールバックが発生したか、出力が受け入れられたかどうかが記録される。
- 財務部門は、ルート、ワークロード、テナント、フォールバック理由ごとに支出を追跡できる。
- 製品部門は、同等でない失敗に対する手動レビュー経路を持っている。
OCR モデルルーティングは、運用が退屈なくらいでうまく機能します。安価な作業は安いまま、構造化された作業には適切なモデルが使われ、フォールバックが文書契約を気づかれないまま変更することはありません。
FAQ
OCR model routing とは何ですか?
OCR model routing は、文書タイプ、必要な出力、コスト、品質要件、フォールバック制約に基づいて、各文書ジョブを OCR またはドキュメント AI ルートへ送るポリシーレイヤーです。
チームは OCR API のコストをどのように比較すべきですか?
OCR API のコストは、受け入れられた出力単位で比較してください。通常の OCR では、これは通常、受け入れられたページごとのコストです。請求書、フォーム、契約書、ID では、通常、再試行とレビューで却下されたものを除いた、受け入れられた構造化文書ごとのコストになります。
OCR においてフォールバックが危険になるのはいつですか?
バックアップルートが同じファイル形状、ページ数、データポリシー、または出力契約を受け入れられない場合、フォールバックは危険になります。プレーンテキストの OCR ルートは、構造化された請求書フィールドを必要とするワークフローにとって安全なフォールバックではありません。
1つの OCR モデルであらゆる文書タイプを処理すべきですか?
通常はいいえ。単純な OCR、レイアウト抽出、構造化抽出、大規模バッチ PDF、制限付き文書では、コスト、品質、制御の要件が異なります。
FlatkeyはOCRモデルルーティングにどう役立ちますか?
Flatkeyは、1つのキー、1つのバランス、モデルの利用可否チェック、使用状況の可視化、ルートレベルのレビューを通じて、チームがOCRモデルルーティングを運用するのを支援できます。本番トラフィックを移す前に、チームは引き続き独自の文書品質テストを実行する必要があります。


