
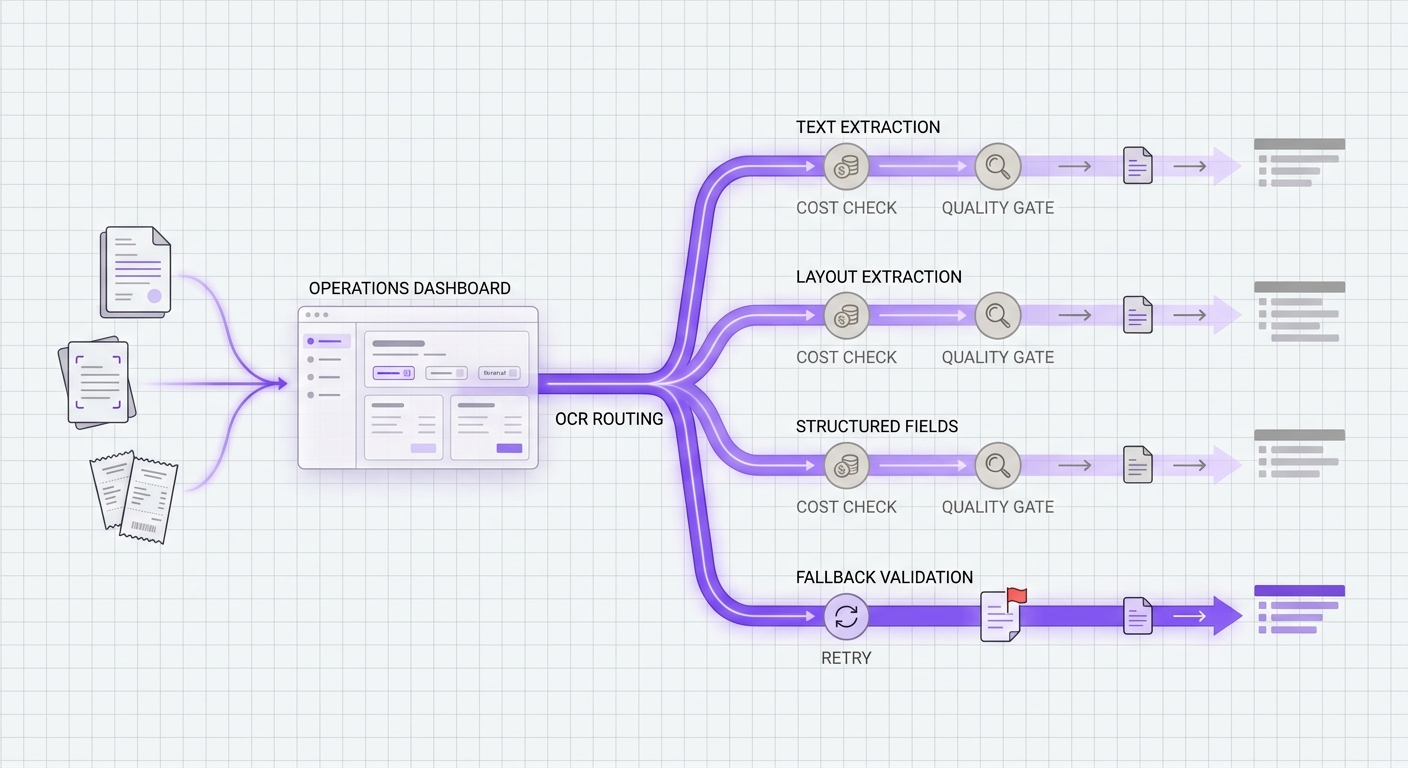
Если вы планируете маршрутизацию OCR-моделей, рискованная часть — не найти OCR-модель, которая умеет читать текст со скана. Рискованная часть — решить, какой маршрут должен обрабатывать простые изображения, какой маршрут должен обрабатывать многостраничные PDF, какой маршрут должен извлекать структурированные поля, и какой fallback имеет право касаться того же класса документов, когда первый маршрут не справляется.
Именно поэтому маршрутизацию OCR-моделей следует начинать с политики рабочей нагрузки, а не с рейтинга вендоров. Дешёвый путь OCR для текста может оказаться неправильным выбором для счетов. Высококачественный структурированный извлекатель может быть избыточным для массовых архивных текстов. Fallback может выглядеть надёжным, пока он молча не пропускает таблицы, не превышает лимиты страниц или не удваивает стоимость при шторме повторных попыток.
Это руководство даёт командам медиа, продукта и инженерии практический способ сбалансировать стоимость извлечения текста, качество и проверки fallback до того, как они стандартизируют документный трафик. Оно рассматривает маршрутизацию AI OCR API и маршрутизацию document AI model routing как операционные решения, а не разовые бенчмарк-упражнения.
Краткий ответ
Самая безопасная политика маршрутизации OCR-моделей разделяет документные задачи на четыре класса:
| Класс маршрута | Для чего использовать | Основное решение | Правило fallback |
|---|---|---|---|
| Простой OCR текста | Скриншоты, отсканированные заметки, простой текст на изображениях, архивы с возможностью поиска | Самая низкая одобренная стоимость за принятый страницу | Fallback только на другой маршрут, который сохраняет полноту текста и покрытие языков |
| OCR с учётом макета | PDF, квитанции, отчёты, каталоги, выгрузки слайдов | Порядок чтения, таблицы, абзацы и качество последующего чанкинга | Fallback только тогда, когда качество макета остаётся приемлемым |
| Структурированное извлечение | Счета, налоговые формы, контракты, удостоверения личности, претензии, заявки | Точность полей и стабильность схемы | Fallback только на маршрут, который может вернуть те же требуемые поля |
| Ограниченные документы | Регулируемые или чувствительные к условиям контракта файлы | Обработка данных, хранение, регион и одобрение вендора | Fallback только внутри того же утверждённого набора провайдеров |
Это и есть основа маршрутизации OCR-моделей: выбрать маршрут, который соответствует документу и форме выхода, а затем разрешать fallback только тогда, когда резервный вариант может обеспечить те же требования к стоимости, качеству и контролю.
Почему стоимость извлечения текста легко неверно оценить
Стоимость OCR API редко сводится к одной чистой цифре. Провайдеры могут по-разному тарифицировать базовый OCR, анализ макета, формы, таблицы, запросы, пользовательское извлечение или пакетную обработку. Некоторые страницы тарифицируются за страницу. Некоторые рабочие процессы требуют доплаты, когда одной и той же странице нужны структурированные поля. Некоторые ограничения переводят трафик из синхронного вызова в асинхронную задачу.
Прежде чем сравнивать OCR-маршруты, нормализуйте каждого кандидата к одной и той же операционной единице:
| Метрика | Почему она должна быть в таблице маршрутизации |
|---|---|
| Стоимость за принятую страницу | Сырая цена за страницу недостаточна, если маршрут приводит к большему числу отклонённых результатов или повторных попыток. |
| Стоимость за принятое структурированное документ | Счета и формы следует измерять по пригодному к использованию выводу полей, а не только по тексту OCR. |
| Синхронные лимиты на страницу/файл | Маршрут, который не может принять такую форму файла, не является допустимым вариантом отката. |
| Лимиты асинхронных заданий | Большие PDF и пакетные архивы требуют маршрутизации с учётом очередей. |
| Уровень функций | Формы, таблицы, запросы, подписи и макет могут менять фактическую цену. |
| Поведение квот и ограничения частоты | Маршрут, который дёшев при низком объёме, может не справиться при пакетной нагрузке. |
Официальные страницы с ценами показывают, почему важна нормализация единиц измерения. Цены Amazon Textract перечисляют отдельные API и функции для Detect Document Text, Analyze Document, Analyze Expense, Analyze ID и Analyze Lending. В примерах указано, что Detect Document Text стоит $0.0015 за страницу для первых одного миллиона страниц в US West (Oregon), тогда как пример Analyze Document для форм и таблиц объединяет $0.015 за страницу таблицы и $0.05 за страницу формы. Цены Google Document AI перечисляют Enterprise Document OCR, OCR add-ons, Layout Parser, Custom Extractor и Form Parser как отдельные платные поверхности. Azure Document Intelligence сообщает, что биллинг рассчитывается ежемесячно на основе типа модели и числа проанализированных страниц, а страница с ограничениями сервиса связывает поведение маршрутизации с размером файла, количеством страниц и лимитами транзакций в секунду.
Вывод для маршрутизации OCR-моделей прост: не сравнивайте рекламные цены провайдеров, пока не будут нормализованы рабочая нагрузка, форма вывода, единица биллинга и политика повторных попыток.
Постройте таблицу маршрутов до того, как начнёте бенчмарк моделей
Команды часто прогоняют несколько тестовых документов через разные OCR-модели и выбирают ту, которая "выглядит лучше всего". Для демонстрации это может сработать, но не формирует устойчивую политику маршрутизации.
Сначала постройте таблицу маршрутов. Для маршрутизации моделей document AI эта таблица — это контракт, который не позволяет простому OCR, извлечению макета и структурированному извлечению слиться в один маршрут по умолчанию. Если вы уже отслеживаете качество маршрутизации в шлюзе, сопоставьте эту таблицу с сводкой метрик API маршрутизации AI:
| Рабочая нагрузка | Пример входных данных | Требуемый результат | Поведение маршрута по умолчанию | Условие отклонения |
|---|---|---|---|---|
| OCR для поискового архива | Отсканированные PDF, скриншоты, устаревшие отчеты | Обычный текст с приемлемым порядком чтения | Маршрут с самой низкой утвержденной стоимостью | Отсутствующие страницы, неверный язык, нарушенный порядок |
| Обработка чеков или счетов | Чеки, счета, платежные документы | Поля, итоги, даты, позиции | Маршрут структурированного извлечения | Обязательное поле отсутствует или низкая уверенность |
| Понимание каталогов или отчетов | Каталоги товаров, плотные отчеты, слайды презентаций | Текст и таблицы с учетом макета | Маршрут с учетом макета и проверками таблиц | Таблицы объединены, столбцы потеряны, порядок разделов нарушен |
| Проверка удостоверений или заявок | Удостоверения, заявления, формы онбординга | Конкретные поля плюс аудиторский след | Утвержденный ограниченный маршрут | Провайдер не допущен, срок хранения неизвестен, несоответствие поля |
| Пакетная миграция | Большие PDF или архивы изображений | Полное покрытие страниц | Асинхронный маршрут с запасом по лимиту страниц | Задание слишком большое, троттлинг, частичное завершение |
Когда такая таблица существует, оценка моделей становится гораздо полезнее. Вы больше не спрашиваете "Какая OCR-модель лучшая?" Вы спрашиваете "Какой маршрут допустим для этого конкретного класса документов при этой стоимости и риске отката?" В этом и заключается практическая разница между демонстрацией и маршрутизацией AI OCR API, которая способна выдержать производственный трафик.
Пороги качества должны соответствовать результату, а не демонстрации
Качество OCR требует разных порогов для разных рабочих нагрузок.
Для OCR обычного текста измеряйте:
- Покрытие страниц.
- Полноту символов и слов.
- Порядок чтения.
- Устойчивость к языку и рукописному тексту.
- Долю страниц, требующих ручной проверки.
Для OCR с учетом макета измеряйте:
- Группировку абзацев.
- Иерархию заголовков.
- Границы таблиц.
- Порядок столбцов.
- Улучшается ли качество последующего поиска, извлечения или интерфейса проверки.
Для структурированного извлечения измеряйте:
- Точность обязательных полей.
- Полноту обязательных полей.
- Стабильность нормализации дат, сумм, имен и идентификаторов.
- Калибровку уверенности.
- Совместимость схем между основным и запасным маршрутами.
Именно здесь терпят неудачу многие проекты маршрутизации OCR-моделей. Запасной вариант, который возвращает обычный текст, не эквивалентен структурному извлекателю счетов. Маршрут, который сохраняет большинство слов, но теряет границы таблиц, все равно может нарушить рабочие процессы поиска или проверки. Модель с высокой точностью, которая не может обработать тот же объем страниц, не является безопасным запасным вариантом для пакетных PDF.
Проверки отката — это требование к продукту
Откат не должен означать "попробовать другого провайдера OCR". Он должен означать "попробовать другой утвержденный маршрут, который может выполнить тот же контракт рабочей нагрузки".
Используйте этот контрольный список, прежде чем маршрут сможет стать запасным:
| Проверка отката | Условие прохождения |
|---|---|
| Тот же класс документа | Резервный вариант принимает тот же тип файла, количество страниц и размер. |
| Тот же контракт на выходные данные | Резервный вариант возвращает тот же требуемый текст, разметку или поля. |
| Те же ограничения на данные | Резервный вариант соответствует тем же правилам хранения, региона и договора с клиентом. |
| Та же наблюдаемость | Резервный вариант логирует маршрут, стоимость, задержку, ошибки, уверенность и причину отклонения. |
| Ограниченная стоимость повторной попытки | Бюджеты на повторные попытки и откат ограничены для каждой задачи, арендатора и пакета. |
| Путь ручной проверки | Неэквивалентные сбои направляются на проверку, а не приводят к тихой деградации. |
Amazon Textract — полезный пример того, почему допустимость отката должна включать ограничения на документ: в его ограничениях на документы указано, что синхронные операции с PDF и TIFF ограничены одной страницей, тогда как асинхронные операции с PDF и TIFF допускают до 3 000 страниц. Ограничения сервиса Azure Document Intelligence документируют лимит по умолчанию 15 TPS для транзакций analyze в Standard tier, максимальный размер документа 500 МБ и ограничение на анализ до 2 000 страниц. Квоты Google Document AI документируют квоты процессоров, лимиты онлайн-запросов и квоты страниц в минуту для версий генеративных процессоров.
Эти ограничения — не пограничные случаи. Они определяют, является ли резервный вариант допустимым.
Практическое дерево решений для маршрутизации OCR-моделей
Используйте это дерево решений, когда новая задача по документу попадает в конвейер:
- Классифицируйте документ до вызова OCR-маршрута.
- Решите, нужны ли выходные данные в виде простого текста, разметки или структурированных полей.
- Исключите маршруты, которые не соответствуют требованиям к хранению, региону, договору, типу файла, количеству страниц или квотам.
- Оценивайте стоимость за принятый результат, а не только стоимость за необработанную страницу.
- Запускайте основной маршрут.
- Применяйте проверки качества, специфичные для нагрузки.
- Повторяйте попытку только при временных ошибках или безопасных идемпотентных сбоях.
- Переходите на резервный вариант только в рамках того же класса маршрута.
- Отправляйте неэквивалентные сбои на проверку или в пакетную очередь.
- Логируйте решение о маршруте, стоимость, уверенность, причину отката и итоговый статус принятия/отклонения.
Вот политика маршрутизации в компактном виде:
document_job:
  classify:
    inputs: [file_type, page_count, document_type, customer_tier, data_region]
  exclude:
    - route_not_approved_for_data_policy
    - route_page_limit_below_job_size
    - route_missing_required_output_contract
  choose_primary:
    optimize_for: cost_per_accepted_output
    guardrails: [quality_gate, latency_budget, quota_headroom]
  fallback:
    allowed_only_when:
      - transient_error
      - same_route_class
      - same_output_contract
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log: [route, model, cost, latency, confidence, error_class, fallback_reason]
Политика важнее, чем список моделей. Новые OCR-модели можно будет добавить позже, не переписывая рабочий процесс обработки документов.
Где Flatkey вписывается в маршрутизацию OCR-моделей
Flatkey полезен в маршрутизации OCR-моделей, когда команде нужен один операционный слой для доступа к моделям, прозрачности расходов и проверки маршрутов вместо того, чтобы разбрасывать ключи провайдеров по агентам, задачам и сервисам. Если ваша команда все еще подключает прямые аккаунты провайдеров, начните с workflow унифицированного AI API, а затем сопоставьте правила fallback для OCR с playbook стратегии fallback моделей.
Текущий публичный сайт Flatkey позиционирует продукт вокруг одной key, одного баланса, использования моделей и инструментов, биллинга по успешным вызовам, общего ledger и публичного каталога моделей с актуальной доступностью, ценами, поддержкой endpoint'ов и страницами с деталями моделей. Для OCR-workflow это делает gateway особенно полезным как control plane: проверять доступные мультимодальные или document-capable маршруты, определять, какие задачи могут их использовать, и просматривать затраты и сбои на уровне маршрутов в одном месте.
Не рассматривайте какой-либо каталог gateway как замену собственной OCR-проверки качества. Рассматривайте его как место, где утвержденные маршруты, данные об использовании, политика fallback и контроль затрат становятся проще в эксплуатации. Когда будете готовы сравнивать экономику маршрутов, используйте актуальную страницу ценообразования Flatkey, а не устаревшие названия моделей из старых заметок по внедрению.
Чек-лист запуска
Перед переводом маршрутизации OCR-моделей в production подтвердите следующие пункты:
- Для каждого класса документов есть маршрут по умолчанию и разрешенный класс fallback.
- У каждого маршрута есть нормализованная стоимость на принятую страницу или принятый структурированный документ.
- У каждого структурированного workflow есть quality gates на уровне полей.
- Лимиты sync и async по страницам протестированы на реальных файлах, а не предполагаются по примерам.
- Поведение квот и throttling отражено в нагрузочных тестах.
- Документы с ограниченным доступом могут использовать только утвержденные маршруты.
- Неудачные задачи фиксируют, почему произошел fallback и был ли результат принят.
- Финансы могут отследить расходы по маршруту, задаче, tenant и причине fallback.
- У продукта есть путь ручной проверки для неэквивалентных ошибок.
Маршрутизация OCR-моделей работает тогда, когда ею скучно управлять: дешевую работу оставляют дешевой, структурированная работа получает правильную модель, а fallback никогда не меняет контракт документа незаметно.
FAQ
Что такое маршрутизация OCR-моделей?
Маршрутизация OCR-моделей — это слой политики, который отправляет каждую задачу с документом в OCR- или document AI-маршрут в зависимости от типа документа, требуемого результата, стоимости, требований к качеству и ограничений fallback.
Как командам следует сравнивать стоимость OCR API?
Сравнивайте стоимость OCR API по принятому результату. Для обычного OCR это обычно стоимость за принятую страницу. Для счетов, форм, контрактов и удостоверений личности это обычно стоимость за принятый структурированный документ после повторных попыток и отклонений на проверке.
Когда fallback становится небезопасным для OCR?
Fallback становится небезопасным, когда резервный маршрут не может принять ту же форму файла, то же количество страниц, политику данных или контракт вывода. Маршрут OCR для простого текста не является безопасным fallback для workflow, которому нужны структурированные поля счета.
Должна ли одна OCR-модель обрабатывать все типы документов?
Обычно нет. Простое OCR, извлечение макета, структурированное извлечение, большие пакетные PDF и документы с ограниченным доступом имеют разные требования к стоимости, качеству и контролю.
Как Flatkey помогает с маршрутизацией OCR-моделей?
Flatkey может помочь командам управлять маршрутизацией OCR-моделей через один ключ, один баланс, проверки доступности моделей, прозрачность использования и проверку на уровне маршрута. Командам по-прежнему нужно проводить собственные тесты качества документов, прежде чем производственный трафик будет переведён.


