
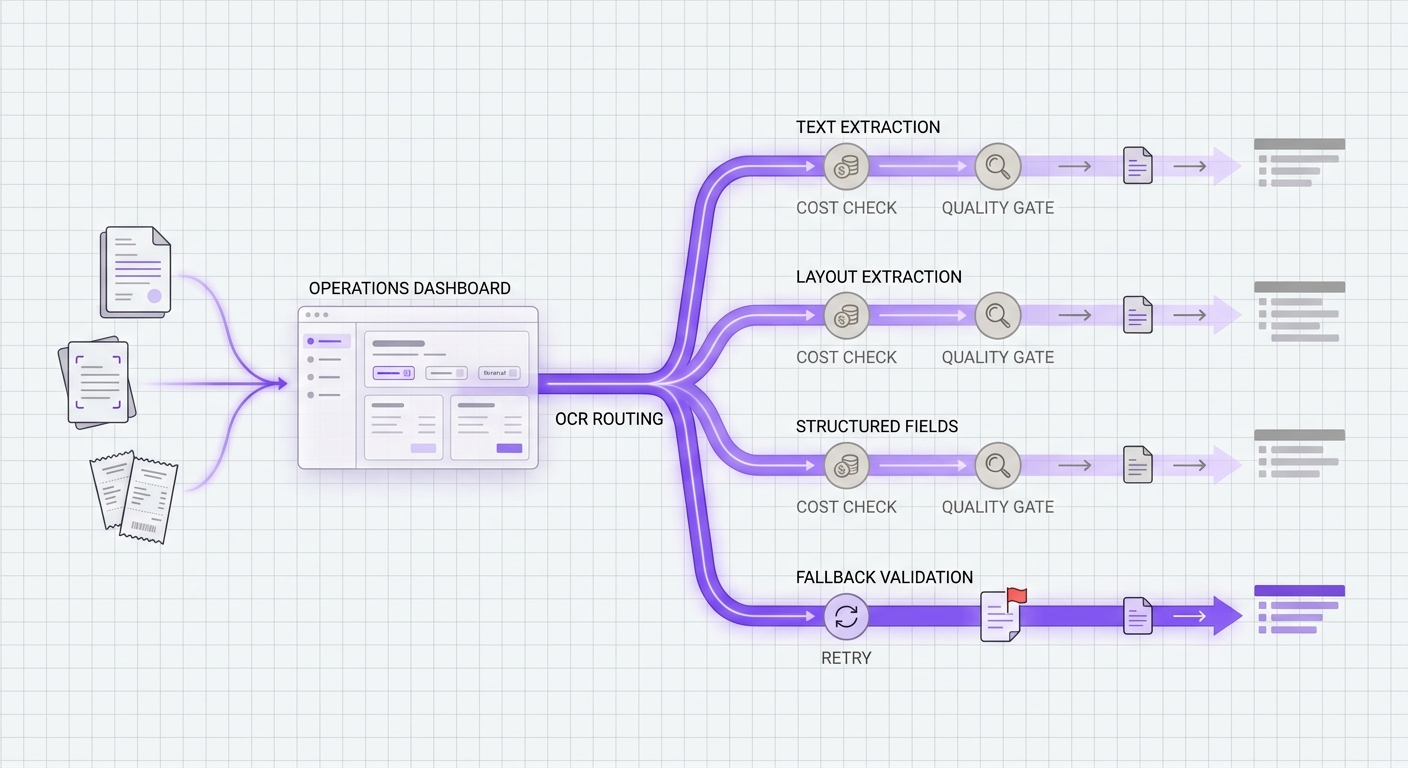
Se você está planejando o roteamento de modelos OCR, a parte arriscada não é encontrar um modelo OCR que consiga ler texto a partir de uma digitalização. A parte arriscada é decidir qual rota deve lidar com imagens simples, qual rota deve lidar com PDFs de várias páginas, qual rota deve extrair campos estruturados e qual fallback tem permissão para tocar a mesma classe de documento quando a primeira rota falha.
É por isso que o roteamento de modelos OCR deve começar pela política de workload, e não por um ranking de fornecedores. Um caminho de OCR de texto barato pode ser a escolha errada para faturas. Um extrator estruturado de alta qualidade pode ser desperdício para texto de arquivo em massa. Um fallback pode parecer confiável até descartar tabelas silenciosamente, ultrapassar limites de páginas ou dobrar o custo de uma tempestade de retries.
Este guia oferece às equipes de mídia, produto e engenharia uma forma prática de equilibrar custo, qualidade de extração de texto e verificações de fallback antes de padronizarem o tráfego de documentos. Ele trata o roteamento da API de OCR com IA e o roteamento de modelos de IA para documentos como decisões operacionais, e não como exercícios pontuais de benchmark.
Resposta rápida
A política mais segura de roteamento de modelos OCR separa os trabalhos de documentos em quatro classes:
| Route class | Use it for | Primary decision | Fallback rule |
|---|---|---|---|
| Plain text OCR | Screenshots, scanned notes, simple image text, searchable archives | Lowest approved cost per accepted page | Fallback only to another route that preserves text completeness and language coverage |
| Layout-aware OCR | PDFs, receipts, reports, catalogs, slide exports | Reading order, tables, paragraphs, and downstream chunk quality | Fallback only when layout quality remains acceptable |
| Structured extraction | Invoices, tax forms, contracts, IDs, claims, applications | Field accuracy and schema stability | Fallback only to a route that can return the same required fields |
| Restricted documents | Regulated or contract-sensitive files | Data handling, retention, region, and vendor approval | Fallback only inside the same approved provider set |
Este é o núcleo do roteamento de modelos OCR: escolha a rota que se encaixa no documento e na forma da saída, e então permita fallback apenas quando a alternativa puder satisfazer os mesmos requisitos de custo, qualidade e controle.
Por que o custo de extração de texto é fácil de interpretar mal
O custo da API de OCR raramente é um número simples. Os provedores podem cobrar de forma diferente por OCR básico, análise de layout, formulários, tabelas, consultas, extração personalizada ou processamento em lote. Algumas páginas são cobradas por página. Alguns fluxos pagam mais quando a mesma página precisa de campos estruturados. Alguns limites empurram o tráfego de uma chamada síncrona para um job assíncrono.
Antes de comparar rotas de OCR, normalize cada candidato para a mesma unidade operacional:
| Métrica | Por que ela deve constar na tabela de roteamento |
|---|---|
| Custo por página aceita | O preço bruto da página não basta se uma rota gerar mais saídas rejeitadas ou novas tentativas. |
| Custo por documento estruturado aceito | Faturas e formulários devem ser medidos pela saída de campos utilizáveis, não apenas pelo texto OCR. |
| Limites síncronos de página/arquivo | Uma rota que não consegue aceitar o formato do arquivo não é um fallback válido. |
| Limites assíncronos de job | PDFs grandes e lotes de arquivos compactados precisam de roteamento ciente da fila. |
| Camada de recursos | Formulários, tabelas, consultas, assinaturas e layout podem alterar o preço efetivo. |
| Comportamento de quota e throttling | Uma rota barata em baixo volume pode falhar sob carga em lote. |
As páginas oficiais de preços mostram por que a normalização de unidade importa. Preços do Amazon Textract lista APIs e recursos separados para Detect Document Text, Analyze Document, Analyze Expense, Analyze ID e Analyze Lending. Seus exemplos mostram o Detect Document Text a US$ 0,0015 por página para os primeiros um milhão de páginas em US West (Oregon), enquanto um exemplo do Analyze Document para formulários e tabelas combina US$ 0,015 por página de tabela e US$ 0,05 por página de formulário. Preços do Google Document AI lista Enterprise Document OCR, OCR add-ons, Layout Parser, Custom Extractor e Form Parser como superfícies precificadas separadas. Azure Document Intelligence diz que a cobrança é calculada mensalmente com base no tipo de modelo e nas páginas analisadas, e sua página de limites do serviço vincula o comportamento de roteamento ao tamanho do arquivo, ao número de páginas e aos limites de transações por segundo.
A lição para o roteamento de modelos OCR é simples: não compare os preços de destaque dos provedores até que a carga de trabalho, a forma da saída, a unidade de cobrança e a política de repetição tenham sido normalizadas.
Construa a tabela de rotas antes de comparar os modelos
As equipes часто executam alguns documentos de teste por vários modelos OCR e escolhem o que "parece melhor". Isso pode funcionar para uma demonstração, mas não produz uma política de roteamento duradoura.
Construa a tabela de rotas primeiro. Para o roteamento de modelos de IA de documentos, essa tabela é o contrato que impede OCR simples, extração de layout e extração estruturada de se fundirem em uma única rota padrão. Se você já acompanha a qualidade de roteamento em um gateway, combine esta tabela com um painel de pontuação de métricas de API de roteamento de IA:
| Carga de trabalho | Entrada de exemplo | Saída exigida | Comportamento padrão da rota | Condição de rejeição |
|---|---|---|---|---|
| OCR de arquivo pesquisável | PDFs digitalizados, capturas de tela, relatórios legados | Texto simples com ordem de leitura aceitável | Rota aprovada de menor custo | Páginas ausentes, idioma incorreto, ordenação quebrada |
| Ingestão de recibos ou faturas | Recibos, faturas, documentos de pagamento | Campos, totais, datas, itens de linha | Rota de extração estruturada | Campo obrigatório ausente ou baixa confiança |
| Compreensão de catálogos ou relatórios | Catálogos de produtos, relatórios densos, apresentações de slides | Texto e tabelas com consciência de layout | Rota de layout com verificações de tabela | Tabelas mescladas, colunas perdidas, ordem de seções quebrada |
| Análise de ID ou formulário de solicitação | IDs, solicitações, formulários de onboarding | Campos específicos mais trilha de auditoria | Rota restrita aprovada | Provedor não liberado, retenção desconhecida, incompatibilidade de campo |
| Migração em lote | PDFs grandes ou arquivos de imagem | Cobertura completa de páginas | Rota assíncrona com margem de capacidade por página | Job grande demais, limitação de taxa, conclusão parcial |
Quando essa tabela existe, a avaliação do modelo se torna mais útil. Você já não está perguntando "Qual modelo OCR é o melhor?" Você está perguntando "Qual rota é aceitável para esta classe exata de documento, a este custo e com este risco de fallback?" Essa é a diferença prática entre uma demonstração e o roteamento de API de OCR por IA que pode sobreviver ao tráfego de produção.
As Barreiras de Qualidade Devem Corresponder À Saída, Não À Demonstração
A qualidade de OCR precisa de barreiras diferentes para cargas de trabalho diferentes.
Para OCR de texto simples, meça:
- Cobertura de páginas.
- Completude de caracteres e palavras.
- Ordem de leitura.
- Tolerância a idioma e caligrafia.
- A parcela de páginas que exigem revisão humana.
Para OCR com consciência de layout, meça:
- Agrupamento de parágrafos.
- Hierarquia de títulos.
- Limites de tabela.
- Ordem das colunas.
- Se a qualidade da busca, recuperação ou UI de revisão a jusante melhora.
Para extração estruturada, meça:
- Precisão dos campos obrigatórios.
- Revocação dos campos obrigatórios.
- Estabilidade de normalização para datas, valores, nomes e IDs.
- Calibração de confiança.
- Compatibilidade de esquema entre as rotas principal e de fallback.
É aqui que muitos projetos de roteamento de modelos OCR falham. Um fallback que retorna texto simples não é equivalente a um extrator estruturado de faturas. Uma rota que preserva a maioria das palavras, mas perde os limites de tabela, ainda pode quebrar fluxos de trabalho de recuperação ou revisão. Um modelo de alta precisão que não consegue lidar com a mesma contagem de páginas não é um fallback seguro para PDFs em lote.
As Verificações de Fallback São Um Requisito do Produto
Fallback não deve significar "tente outro provedor de OCR". Deve significar "tente outra rota aprovada que possa atender ao mesmo contrato de carga de trabalho".
Use esta lista de verificação antes que uma rota possa se tornar um fallback:
| Verificação de fallback | Condição de aprovação |
|---|---|
| Mesma classe de documento | O fallback aceita o mesmo tipo de arquivo, contagem de páginas e tamanho. |
| Mesmo contrato de saída | O fallback retorna o mesmo texto, layout ou campos obrigatórios. |
| Mesmo controle de dados | O fallback atende às mesmas regras de retenção, região e contrato com o cliente. |
| Mesma observabilidade | O fallback registra rota, custo, latência, erros, confiança e motivo da rejeição. |
| Custo de retry limitado | Os orçamentos de retry e fallback são limitados por trabalho, tenant e lote. |
| Fluxo de revisão manual | Falhas não equivalentes vão para revisão em vez de degradação silenciosa. |
Amazon Textract é um exemplo útil de por que a elegibilidade de fallback deve incluir limites de documento: seus limites de documento dizem que as operações síncronas de PDF e TIFF são limitadas a uma página, enquanto as operações assíncronas de PDF e TIFF permitem até 3.000 páginas. Os limites de serviço do Azure Document Intelligence documentam um limite padrão de 15 TPS nas transações de análise da camada Standard, um tamanho máximo de documento de 500 MB e um limite de análise de 2.000 páginas. As cotas do Google Document AI documentam cotas de processadores, limites de solicitações online e cotas de páginas por minuto para versões generativas de processadores.
Essas restrições não são casos extremos. Elas determinam se um fallback é válido.
Uma Árvore de Decisão Prática para Roteamento de Modelos OCR
Use esta árvore de decisão quando um novo trabalho de documento entrar no pipeline:
- Classifique o documento antes de chamar uma rota OCR.
- Decida se a saída precisa de texto simples, layout ou campos estruturados.
- Exclua rotas que falhem em retenção, região, contrato, tipo de arquivo, contagem de páginas ou requisitos de cota.
- Estime o custo por saída aceita, não apenas o custo por página bruta.
- Execute a rota primária.
- Aplique controles de qualidade específicos da carga de trabalho.
- Refaça a tentativa apenas para erros transitórios ou falhas idempotentes seguras.
- Faça fallback apenas dentro da mesma classe de rota.
- Envie falhas não equivalentes para revisão ou para uma fila em lote.
- Registre a decisão de rota, o custo, a confiança, o motivo do fallback e o estado final aceito/rejeitado.
Aqui está a política de roteamento em uma forma compacta:
document_job:
  classify:
    inputs: [file_type, page_count, document_type, customer_tier, data_region]
  exclude:
    - route_not_approved_for_data_policy
    - route_page_limit_below_job_size
    - route_missing_required_output_contract
  choose_primary:
    optimize_for: cost_per_accepted_output
    guardrails: [quality_gate, latency_budget, quota_headroom]
  fallback:
    allowed_only_when:
      - transient_error
      - same_route_class
      - same_output_contract
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log: [route, model, cost, latency, confidence, error_class, fallback_reason]
A política importa mais do que a lista de modelos. Novos modelos OCR podem ser adicionados depois sem reescrever o fluxo de trabalho do documento.
Onde a Flatkey se Encaixa no Roteamento de Modelos OCR
O Flatkey é útil no roteamento de modelos OCR quando a equipe quer uma camada operacional única para acesso a modelos, visibilidade de gastos e revisão de rotas, em vez de espalhar chaves de provedores por agentes, jobs e serviços. Se sua equipe ainda estiver configurando contas diretas de provedores, comece com o fluxo de trabalho unificado da API de IA e depois mapeie as regras de fallback específicas de OCR contra o playbook de estratégia de fallback de modelos.
O site público atual da Flatkey posiciona o produto em torno de uma chave, um saldo, uso de modelos e ferramentas, cobrança por chamadas bem-sucedidas, um livro-razão compartilhado e um diretório de modelos público com disponibilidade em tempo real, preços, suporte a endpoints e páginas de detalhes dos modelos. Para fluxos de trabalho de OCR, isso torna o gateway mais relevante como um plano de controle: validar rotas multimodais ou capazes de lidar com documentos disponíveis, definir quais workloads podem usá-las e revisar custo e falhas no nível da rota em um só lugar.
Não trate nenhum catálogo de gateway como substituto do seu próprio teste de qualidade de OCR. Trate-o como o lugar onde rotas aprovadas, dados de uso, política de fallback e controles de custo se tornam mais fáceis de operar. Quando estiver pronto para comparar a economia das rotas, use a superfície atual de preços da Flatkey em vez de nomes de modelos desatualizados de notas antigas de implementação.
Checklist de lançamento
Antes de levar o roteamento de modelos OCR para produção, confirme estes itens:
- Toda classe de documento tem uma rota padrão e uma classe de fallback permitida.
- Toda rota tem um custo normalizado por página aceita ou documento estruturado aceito.
- Todo fluxo de trabalho estruturado tem verificações de qualidade no nível do campo.
- Os limites de páginas síncronos e assíncronos são testados com arquivos reais, não supostos a partir de exemplos.
- O comportamento de cotas e limitação de taxa está representado nos testes de carga.
- Documentos restritos só podem usar rotas aprovadas.
- Os jobs com falha registram por que o fallback aconteceu e se a saída foi aceita.
- O financeiro consegue rastrear os gastos por rota, workload, tenant e motivo do fallback.
- O produto tem um caminho de revisão manual para falhas não equivalentes.
O roteamento de modelos OCR funciona quando é fácil de operar: o trabalho barato continua barato, o trabalho estruturado recebe o modelo certo, e o fallback nunca altera o contrato do documento sem ser percebido.
FAQ
O que é roteamento de modelos OCR?
O roteamento de modelos OCR é a camada de política que envia cada job de documento para uma rota de OCR ou de IA para documentos com base no tipo de documento, na saída necessária, no custo, nos requisitos de qualidade e nas restrições de fallback.
Como as equipes devem comparar o custo de API OCR?
Compare o custo da API de OCR pela saída aceita. Para OCR simples, isso geralmente é o custo por página aceita. Para faturas, formulários, contratos e documentos de identidade, geralmente é o custo por documento estruturado aceito após retries e rejeições na revisão.
Quando o fallback se torna inseguro para OCR?
O fallback se torna inseguro quando a rota de backup não consegue aceitar a mesma forma de arquivo, contagem de páginas, política de dados ou contrato de saída. Uma rota de OCR de texto simples não é um fallback seguro para um fluxo de trabalho que exige campos estruturados de fatura.
Um único modelo OCR deve lidar com todos os tipos de documento?
Normalmente não. OCR simples, extração de layout, extração estruturada, PDFs grandes em lote e documentos restritos têm diferentes requisitos de custo, qualidade e controle.
Como a Flatkey ajuda no roteamento de modelos OCR?
A Flatkey pode ajudar equipes a operar o roteamento de modelos OCR por meio de uma chave, um saldo, verificações de disponibilidade do modelo, visibilidade de uso e revisão no nível da rota. As equipes ainda precisam realizar seus próprios testes de qualidade dos documentos antes que o tráfego de produção seja movido.


