
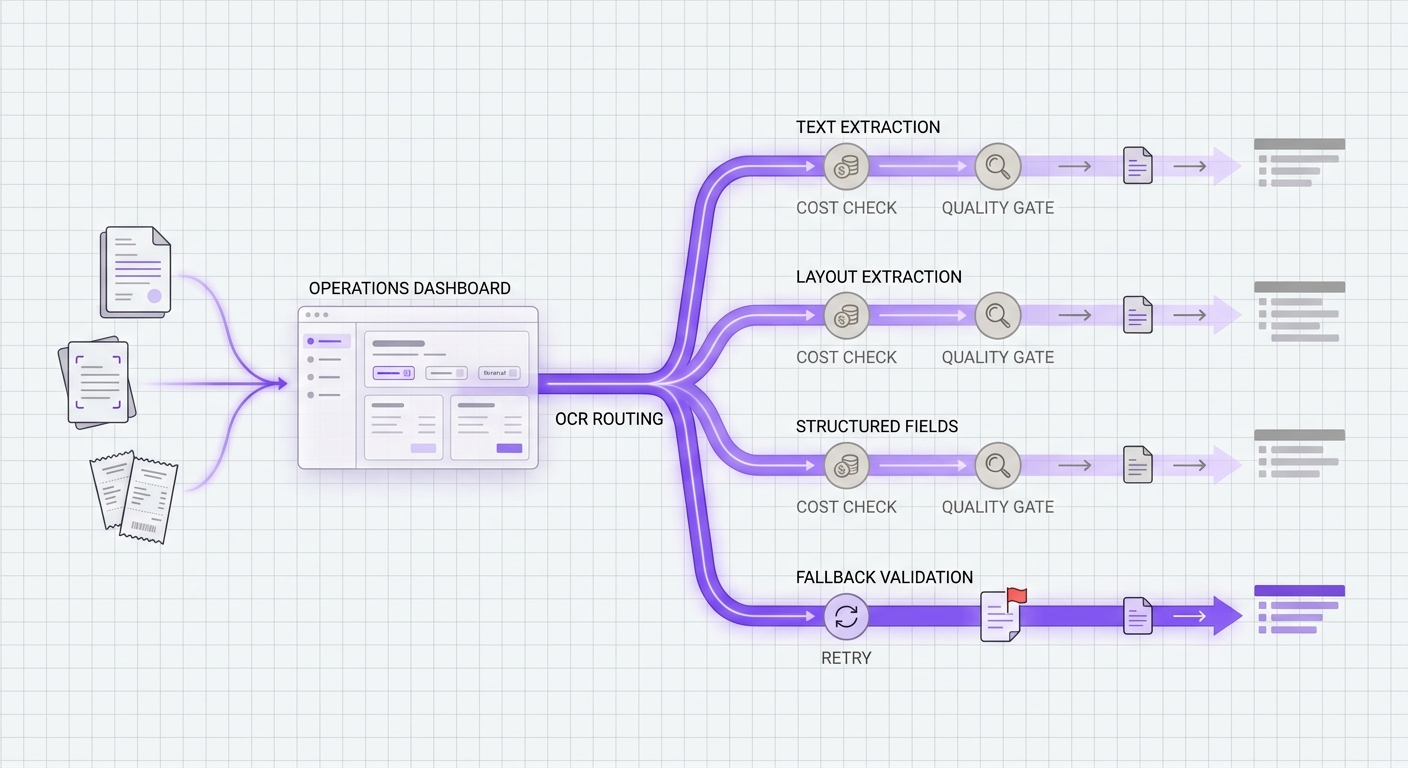
Nếu bạn đang lập kế hoạch định tuyến mô hình OCR, phần rủi ro không nằm ở việc tìm một mô hình OCR có thể đọc văn bản từ bản quét. Phần rủi ro là quyết định tuyến nào nên xử lý ảnh đơn giản, tuyến nào nên xử lý PDF nhiều trang, tuyến nào nên trích xuất các trường có cấu trúc, và cơ chế dự phòng nào được phép chạm vào cùng một lớp tài liệu khi tuyến đầu tiên thất bại.
Đó là lý do định tuyến mô hình OCR nên bắt đầu từ chính sách khối lượng công việc, chứ không phải bảng xếp hạng nhà cung cấp. Một lộ trình OCR văn bản rẻ có thể là lựa chọn sai cho hóa đơn. Một bộ trích xuất có cấu trúc chất lượng cao có thể lãng phí cho văn bản lưu trữ số lượng lớn. Một cơ chế dự phòng có vẻ đáng tin cậy cho đến khi nó âm thầm bỏ sót bảng, vượt quá giới hạn số trang, hoặc làm chi phí tăng gấp đôi khi có một làn sóng thử lại.
Hướng dẫn này cung cấp cho các nhóm truyền thông, sản phẩm và kỹ thuật một cách thực tế để cân bằng chi phí trích xuất văn bản, chất lượng và các kiểm tra dự phòng trước khi họ chuẩn hóa lưu lượng tài liệu. Nó xem việc định tuyến AI OCR API và định tuyến mô hình AI tài liệu như các quyết định vận hành, chứ không phải các bài kiểm tra benchmark một lần.
Trả lời nhanh
Chính sách định tuyến mô hình OCR an toàn nhất sẽ chia các công việc tài liệu thành bốn lớp:
| Lớp tuyến | Dùng cho | Quyết định chính | Quy tắc dự phòng |
|---|---|---|---|
| OCR văn bản thuần | Ảnh chụp màn hình, ghi chú đã quét, văn bản ảnh đơn giản, kho lưu trữ có thể tìm kiếm | Chi phí thấp nhất được phê duyệt trên mỗi trang được chấp nhận | Chỉ dự phòng sang một tuyến khác bảo toàn đầy đủ văn bản và phạm vi ngôn ngữ |
| OCR nhận biết bố cục | PDF, biên lai, báo cáo, danh mục, bản xuất từ slide | Thứ tự đọc, bảng, đoạn văn và chất lượng chia đoạn đầu ra | Chỉ dự phòng khi chất lượng bố cục vẫn chấp nhận được |
| Trích xuất có cấu trúc | Hóa đơn, biểu mẫu thuế, hợp đồng, giấy tờ tùy thân, yêu cầu bồi thường, hồ sơ đăng ký | Độ chính xác của trường và tính ổn định của lược đồ | Chỉ dự phòng sang một tuyến có thể trả về cùng các trường bắt buộc |
| Tài liệu bị hạn chế | Tệp chịu quản lý hoặc nhạy cảm về hợp đồng | Xử lý dữ liệu, lưu giữ, khu vực và phê duyệt nhà cung cấp | Chỉ dự phòng trong cùng bộ nhà cung cấp đã được phê duyệt |
Đây là cốt lõi của định tuyến mô hình OCR: chọn tuyến phù hợp với tài liệu và dạng đầu ra, rồi chỉ cho phép dự phòng khi bản sao lưu có thể đáp ứng cùng các yêu cầu về chi phí, chất lượng và kiểm soát.
Tại Sao Chi Phí Trích Xuất Văn Bản Dễ Bị Đánh Giá Sai
Chi phí API OCR hiếm khi là một con số rõ ràng duy nhất. Nhà cung cấp có thể định giá khác nhau cho OCR cơ bản, phân tích bố cục, biểu mẫu, bảng, truy vấn, trích xuất tùy chỉnh hoặc xử lý theo lô. Một số trang được tính phí theo trang. Một số quy trình phải trả nhiều hơn khi cùng một trang cần các trường có cấu trúc. Một số giới hạn đẩy lưu lượng từ lệnh đồng bộ sang công việc bất đồng bộ.
Trước khi so sánh các tuyến OCR, hãy chuẩn hóa mọi ứng viên về cùng một đơn vị vận hành:
| Chỉ số | Vì sao nó thuộc về bảng điều phối |
|---|---|
| Chi phí trên mỗi trang được chấp nhận | Giá thô mỗi trang là chưa đủ nếu một tuyến tạo ra nhiều đầu ra bị từ chối hoặc phải thử lại. |
| Chi phí trên mỗi tài liệu có cấu trúc được chấp nhận | Hóa đơn và biểu mẫu nên được đo bằng đầu ra trường có thể sử dụng, không chỉ bằng văn bản OCR. |
| Giới hạn đồng bộ theo trang/tệp | Một tuyến không thể chấp nhận dạng tệp đó thì không phải là phương án dự phòng hợp lệ. |
| Giới hạn tác vụ bất đồng bộ | Các tệp PDF lớn và lô lưu trữ cần định tuyến có nhận biết hàng đợi. |
| Cấp tính năng | Biểu mẫu, bảng, truy vấn, chữ ký và bố cục có thể làm thay đổi chi phí thực tế. |
| Hành vi hạn ngạch và điều tiết | Một tuyến rẻ ở lưu lượng thấp có thể thất bại khi tải theo lô. |
Các trang giá chính thức cho thấy vì sao chuẩn hóa đơn vị là quan trọng. Giá Amazon Textract liệt kê các API và tính năng riêng cho Detect Document Text, Analyze Document, Analyze Expense, Analyze ID và Analyze Lending. Các ví dụ của dịch vụ này cho thấy Detect Document Text ở mức $0.0015 cho mỗi trang trong một triệu trang đầu tiên ở US West (Oregon), trong khi ví dụ Analyze Document cho biểu mẫu và bảng kết hợp $0.015 cho mỗi trang bảng và $0.05 cho mỗi trang biểu mẫu. Giá Google Document AI liệt kê Enterprise Document OCR, OCR add-ons, Layout Parser, Custom Extractor và Form Parser như các bề mặt tính phí riêng biệt. Azure Document Intelligence cho biết việc tính phí được tính hàng tháng dựa trên loại mô hình và số trang đã phân tích, và trang giới hạn dịch vụ của nó gắn hành vi định tuyến với kích thước tệp, số trang và giới hạn giao dịch mỗi giây.
Bài học cho điều phối mô hình OCR rất đơn giản: đừng so sánh giá niêm yết của nhà cung cấp cho đến khi khối lượng công việc, dạng đầu ra, đơn vị tính phí và chính sách thử lại được chuẩn hóa.
Xây dựng bảng tuyến trước khi bạn benchmark các mô hình
Các nhóm thường chạy vài tài liệu thử qua một số mô hình OCR rồi chọn mô hình “trông tốt nhất”. Điều đó có thể hiệu quả cho bản demo, nhưng nó không tạo ra một chính sách định tuyến bền vững.
Hãy xây dựng bảng tuyến trước. Với điều phối mô hình AI tài liệu, bảng này là hợp đồng giúp OCR đơn giản, trích xuất bố cục và trích xuất có cấu trúc không bị gộp lại thành một tuyến mặc định. Nếu bạn đã theo dõi chất lượng định tuyến trong gateway, hãy ghép bảng này với một bảng điểm chỉ số API điều phối AI:
| Khối lượng công việc | Đầu vào ví dụ | Đầu ra yêu cầu | Hành vi tuyến mặc định | Điều kiện từ chối |
|---|---|---|---|---|
| OCR kho lưu trữ có thể tìm kiếm | PDF đã quét, ảnh chụp màn hình, báo cáo cũ | Văn bản thuần với thứ tự đọc chấp nhận được | Tuyến được phê duyệt có chi phí thấp nhất | Thiếu trang, sai ngôn ngữ, thứ tự bị lỗi |
| Nhập hóa đơn hoặc biên lai | Biên lai, hóa đơn, chứng từ thanh toán | Các trường, tổng tiền, ngày tháng, các dòng mục | Tuyến trích xuất có cấu trúc | Thiếu trường bắt buộc hoặc độ tin cậy thấp |
| Hiểu danh mục hoặc báo cáo | Danh mục sản phẩm, báo cáo dày đặc, bộ slide | Văn bản và bảng có nhận biết bố cục | Tuyến có nhận biết bố cục kèm kiểm tra bảng | Bảng bị gộp, mất cột, thứ tự phần bị hỏng |
| Rà soát ID hoặc hồ sơ đăng ký | Giấy tờ tùy thân, đơn đăng ký, biểu mẫu onboarding | Các trường cụ thể kèm dấu vết kiểm toán | Tuyến được phê duyệt có hạn chế | Nhà cung cấp chưa được phê duyệt, không rõ thời gian lưu trữ, trường không khớp |
| Migrating theo lô | PDF lớn hoặc kho ảnh | Độ phủ trang đầy đủ | Tuyến bất đồng bộ với biên độ dư cho giới hạn số trang | Job quá lớn, bị giới hạn tốc độ, hoàn thành một phần |
Khi bảng này đã tồn tại, việc đánh giá mô hình trở nên hữu ích hơn. Bạn không còn hỏi "Mô hình OCR nào tốt nhất?" nữa. Bạn đang hỏi "Tuyến nào là chấp nhận được cho đúng lớp tài liệu này ở mức chi phí và rủi ro dự phòng này?" Đó là khác biệt thực tế giữa một bản demo và việc điều phối AI OCR API có thể chịu được lưu lượng sản xuất.
Các cổng chất lượng phải khớp với đầu ra, không phải bản demo
Chất lượng OCR cần các cổng kiểm tra khác nhau cho các khối lượng công việc khác nhau.
Đối với OCR văn bản thuần, hãy đo:
- Độ phủ trang.
- Độ đầy đủ ký tự và từ.
- Thứ tự đọc.
- Khả năng chịu đựng ngôn ngữ và chữ viết tay.
- Tỷ lệ trang cần xem xét thủ công.
Đối với OCR nhận biết bố cục, hãy đo:
- Nhóm đoạn văn.
- Cấu trúc phân cấp tiêu đề.
- Ranh giới bảng.
- Thứ tự cột.
- Việc chất lượng của tìm kiếm, truy xuất hoặc giao diện xem xét ở khâu sau có được cải thiện hay không.
Đối với trích xuất có cấu trúc, hãy đo:
- Độ chính xác của trường bắt buộc.
- Độ bao phủ của trường bắt buộc.
- Độ ổn định chuẩn hóa cho ngày tháng, số tiền, tên và mã định danh.
- Hiệu chỉnh độ tin cậy.
- Tính tương thích schema giữa tuyến chính và tuyến dự phòng.
Đây là nơi nhiều dự án điều phối mô hình OCR thất bại. Một phương án dự phòng trả về văn bản thuần không tương đương với bộ trích xuất hóa đơn có cấu trúc. Một tuyến giữ được phần lớn từ ngữ nhưng làm mất ranh giới bảng vẫn có thể phá vỡ quy trình truy xuất hoặc rà soát. Một mô hình có độ chính xác cao nhưng không thể xử lý cùng số lượng trang thì không phải là phương án dự phòng an toàn cho PDF theo lô.
Kiểm tra dự phòng là một yêu cầu sản phẩm
Dự phòng không nên có nghĩa là "thử một nhà cung cấp OCR khác." Nó nên có nghĩa là "thử một tuyến khác đã được phê duyệt, có thể đáp ứng cùng một hợp đồng khối lượng công việc."
Hãy dùng danh sách kiểm tra này trước khi một tuyến có thể trở thành phương án dự phòng:
| Kiểm tra dự phòng | Điều kiện đạt |
|---|---|
| Cùng lớp tài liệu | Phương án dự phòng chấp nhận cùng loại tệp, số trang và kích thước. |
| Cùng hợp đồng đầu ra | Phương án dự phòng trả về cùng văn bản, bố cục hoặc các trường bắt buộc. |
| Cùng kiểm soát dữ liệu | Phương án dự phòng đáp ứng cùng các quy tắc về lưu trữ, khu vực và hợp đồng khách hàng. |
| Cùng khả năng quan sát | Phương án dự phòng ghi nhật ký tuyến, chi phí, độ trễ, lỗi, độ tin cậy và lý do bị từ chối. |
| Chi phí thử lại có giới hạn | Ngân sách thử lại và dự phòng được giới hạn theo từng job, tenant và lô. |
| Lộ trình xem xét thủ công | Các lỗi không tương đương được chuyển sang xem xét thay vì suy giảm âm thầm. |
Amazon Textract là một ví dụ hữu ích cho thấy vì sao điều kiện đủ để dự phòng phải bao gồm giới hạn tài liệu: giới hạn tài liệu của dịch vụ này cho biết các tác vụ PDF và TIFF đồng bộ bị giới hạn ở một trang, trong khi các tác vụ PDF và TIFF bất đồng bộ cho phép tối đa 3.000 trang. giới hạn dịch vụ Azure Document Intelligence ghi nhận giới hạn mặc định 15 TPS trên các giao dịch phân tích ở tầng Standard, kích thước tài liệu tối đa 500 MB và giới hạn phân tích 2.000 trang. hạn mức Google Document AI ghi nhận hạn mức bộ xử lý, giới hạn yêu cầu trực tuyến và hạn mức số trang mỗi phút cho các phiên bản bộ xử lý sinh.
Những ràng buộc đó không phải là các trường hợp ngoại lệ. Chúng quyết định liệu một phương án dự phòng có hợp lệ hay không.
Sơ đồ quyết định định tuyến mô hình OCR thực tế
Hãy dùng sơ đồ quyết định này khi một tác vụ tài liệu mới đi vào pipeline:
- Phân loại tài liệu trước khi gọi một tuyến OCR.
- Quyết định đầu ra cần văn bản thuần, bố cục hay các trường có cấu trúc.
- Loại trừ các tuyến không đáp ứng yêu cầu về lưu giữ, khu vực, hợp đồng, loại tệp, số trang hoặc hạn mức.
- Ước tính chi phí cho mỗi đầu ra được chấp nhận, không chỉ chi phí cho mỗi trang thô.
- Chạy tuyến chính.
- Áp dụng các cổng chất lượng theo từng khối lượng công việc.
- Chỉ thử lại đối với lỗi tạm thời hoặc các lỗi an toàn có thể thử lại idempotent.
- Chỉ chuyển sang phương án dự phòng trong cùng một lớp tuyến.
- Gửi các lỗi không tương đương đến khâu xem xét hoặc hàng đợi lô.
- Ghi nhật ký quyết định tuyến, chi phí, độ tin cậy, lý do dự phòng và trạng thái cuối cùng được chấp nhận/bị từ chối.
Đây là chính sách định tuyến ở dạng rút gọn:
document_job:
  classify:
    inputs: [file_type, page_count, document_type, customer_tier, data_region]
  exclude:
    - route_not_approved_for_data_policy
    - route_page_limit_below_job_size
    - route_missing_required_output_contract
  choose_primary:
    optimize_for: cost_per_accepted_output
    guardrails: [quality_gate, latency_budget, quota_headroom]
  fallback:
    allowed_only_when:
      - transient_error
      - same_route_class
      - same_output_contract
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log: [route, model, cost, latency, confidence, error_class, fallback_reason]
Chính sách quan trọng hơn danh sách mô hình. Có thể thêm các mô hình OCR mới sau này mà không cần viết lại quy trình xử lý tài liệu.
Flatkey phù hợp ở đâu trong định tuyến mô hình OCR
Flatkey hữu ích trong điều phối mô hình OCR khi đội ngũ muốn có một lớp vận hành duy nhất cho quyền truy cập mô hình, khả năng quan sát chi tiêu và rà soát tuyến xử lý thay vì rải khóa nhà cung cấp khắp các tác nhân, job và dịch vụ. Nếu đội ngũ của bạn vẫn đang kết nối trực tiếp với tài khoản nhà cung cấp, hãy bắt đầu với quy trình API AI hợp nhất rồi ánh xạ các quy tắc dự phòng dành riêng cho OCR theo sổ tay chiến lược dự phòng mô hình.
Trang web công khai hiện tại của Flatkey định vị sản phẩm xoay quanh một khóa, một số dư, mức sử dụng mô hình và công cụ, thanh toán theo lần gọi thành công, một sổ cái dùng chung, và một thư mục mô hình công khai với trạng thái khả dụng theo thời gian thực, giá, hỗ trợ endpoint và các trang chi tiết mô hình. Với các quy trình OCR, điều đó khiến gateway trở nên phù hợp nhất như một control plane: xác thực các tuyến đa phương thức hoặc có khả năng xử lý tài liệu đang khả dụng, xác định những khối lượng công việc nào có thể dùng chúng, và xem xét chi phí cũng như lỗi theo từng tuyến ở một nơi.
Đừng coi bất kỳ catalog gateway nào là sự thay thế cho bài kiểm thử chất lượng OCR của riêng bạn. Hãy coi nó là nơi các tuyến đã được phê duyệt, dữ liệu sử dụng, chính sách dự phòng và kiểm soát chi phí trở nên dễ vận hành hơn. Khi bạn sẵn sàng so sánh kinh tế của các tuyến, hãy dùng bề mặt giá của Flatkey hiện tại thay vì các tên mô hình lỗi thời trong những ghi chú triển khai cũ.
Danh sách kiểm tra khi ra mắt
Trước khi đưa điều phối mô hình OCR vào sản xuất, hãy xác nhận các mục sau:
- Mỗi lớp tài liệu đều có một tuyến mặc định và một lớp dự phòng được phép.
- Mỗi tuyến đều có chi phí chuẩn hóa trên mỗi trang được chấp nhận hoặc mỗi tài liệu có cấu trúc được chấp nhận.
- Mỗi quy trình có cấu trúc đều có các cổng chất lượng ở cấp trường.
- Giới hạn trang đồng bộ và bất đồng bộ được kiểm thử với tệp thực, không suy đoán từ ví dụ.
- Hành vi quota và throttling được thể hiện trong các bài kiểm thử tải.
- Tài liệu bị hạn chế chỉ có thể dùng các tuyến đã được phê duyệt.
- Các job thất bại ghi lại lý do vì sao fallback xảy ra và đầu ra có được chấp nhận hay không.
- Khối tài chính có thể truy vết chi tiêu theo tuyến, khối lượng công việc, tenant và lý do fallback.
- Sản phẩm có một quy trình xem xét thủ công cho các lỗi không tương đương.
Điều phối mô hình OCR hoạt động tốt khi việc vận hành nó trở nên đơn giản: phần việc rẻ vẫn rẻ, phần việc có cấu trúc dùng đúng mô hình, và fallback không bao giờ thay đổi hợp đồng tài liệu mà không bị phát hiện.
FAQ
Điều phối mô hình OCR là gì?
Điều phối mô hình OCR là lớp chính sách gửi từng job tài liệu đến một tuyến OCR hoặc document AI dựa trên loại tài liệu, đầu ra yêu cầu, chi phí, yêu cầu chất lượng và các ràng buộc dự phòng.
Các nhóm nên so sánh chi phí API OCR như thế nào?
Hãy so sánh chi phí OCR API theo đầu ra được chấp nhận. Với OCR thuần, đó thường là chi phí trên mỗi trang được chấp nhận. Với hóa đơn, biểu mẫu, hợp đồng và ID, đó thường là chi phí trên mỗi tài liệu có cấu trúc được chấp nhận sau các lần thử lại và các lượt xem xét bị từ chối.
Khi nào dự phòng trở nên không an toàn với OCR?
Fallback trở nên không an toàn khi tuyến dự phòng không thể chấp nhận cùng kiểu tệp, số trang, chính sách dữ liệu hoặc hợp đồng đầu ra. Một tuyến OCR chỉ tạo văn bản thuần không phải là fallback an toàn cho một quy trình yêu cầu các trường hóa đơn có cấu trúc.
Một mô hình OCR có nên xử lý mọi loại tài liệu không?
Thông thường là không. OCR đơn giản, trích xuất bố cục, trích xuất có cấu trúc, PDF số lượng lớn và tài liệu bị hạn chế có các yêu cầu khác nhau về chi phí, chất lượng và kiểm soát.
Flatkey giúp gì cho việc điều phối mô hình OCR?
Flatkey có thể giúp các nhóm vận hành việc điều phối mô hình OCR thông qua một khóa, một mức cân bằng, kiểm tra tính sẵn sàng của mô hình, khả năng hiển thị mức sử dụng và rà soát ở cấp tuyến. Các nhóm vẫn cần tự chạy các bài kiểm thử chất lượng tài liệu của mình trước khi lưu lượng sản xuất được chuyển sang.


