
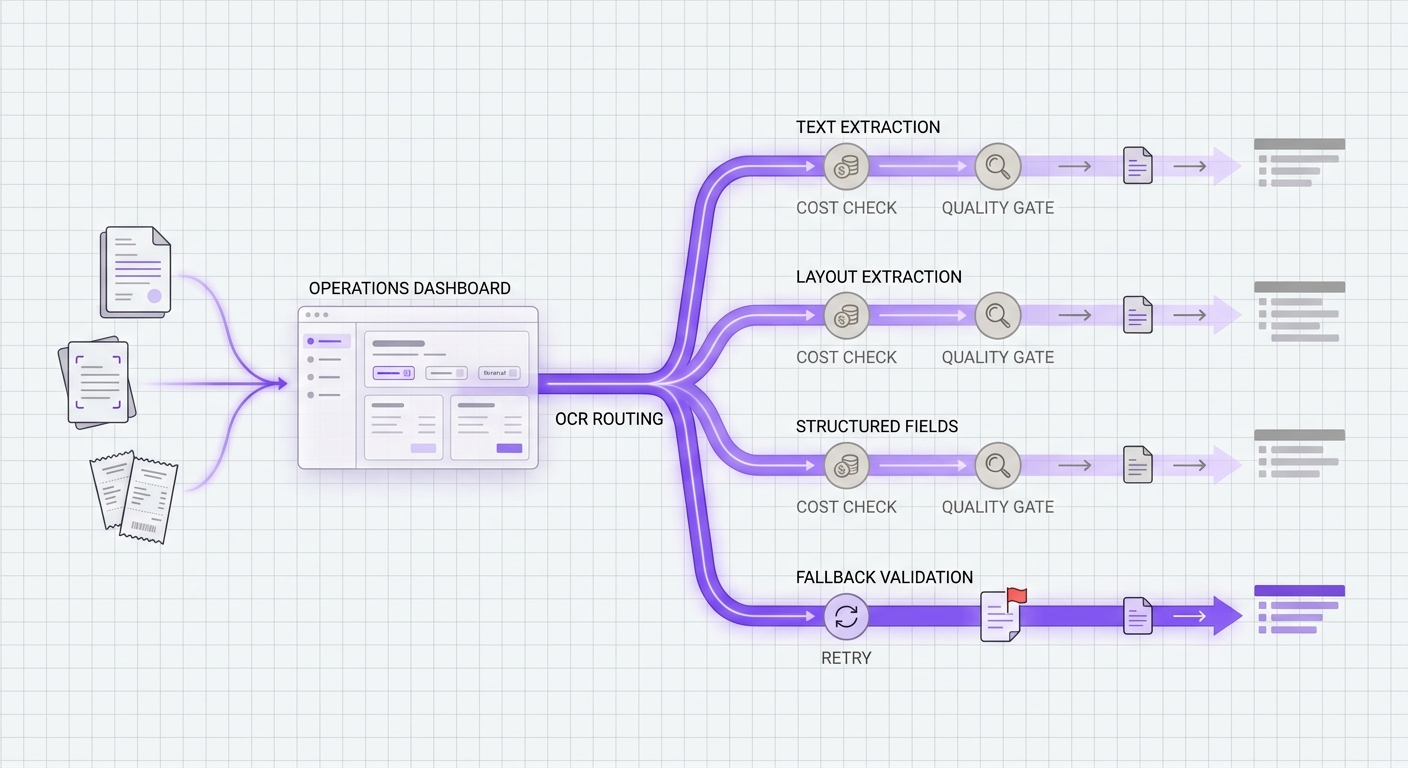
Jika Anda sedang merencanakan routing model OCR, bagian yang berisiko bukanlah menemukan model OCR yang bisa membaca teks dari hasil pemindaian. Bagian yang berisiko adalah memutuskan rute mana yang harus menangani gambar sederhana, rute mana yang harus menangani PDF multi-halaman, rute mana yang harus mengekstrak field terstruktur, dan fallback mana yang diizinkan menyentuh kelas dokumen yang sama ketika rute pertama gagal.
Itulah sebabnya routing model OCR harus dimulai dengan kebijakan beban kerja, bukan papan peringkat vendor. Jalur OCR teks yang murah bisa menjadi pilihan yang salah untuk faktur. Ekstraktor terstruktur berkualitas tinggi bisa menjadi boros untuk teks arsip massal. Sebuah fallback bisa terlihat andal sampai diam-diam mengabaikan tabel, melampaui batas halaman, atau menggandakan biaya akibat badai percobaan ulang.
Panduan ini memberi tim media, produk, dan engineering cara praktis untuk menyeimbangkan biaya ekstraksi teks, kualitas, dan pemeriksaan fallback sebelum mereka menstandarkan lalu lintas dokumen. Panduan ini memperlakukan routing API OCR AI dan routing model AI dokumen sebagai keputusan operasional, bukan latihan benchmark satu kali.
Jawaban Singkat
Kebijakan routing model OCR yang paling aman memisahkan pekerjaan dokumen ke dalam empat kelas:
| Kelas rute | Gunakan untuk | Keputusan utama | Aturan fallback |
|---|---|---|---|
| OCR teks biasa | Screenshot, catatan hasil scan, teks gambar sederhana, arsip yang dapat dicari | Biaya terendah yang disetujui per halaman yang diterima | Fallback hanya ke rute lain yang mempertahankan kelengkapan teks dan cakupan bahasa |
| OCR yang sadar tata letak | PDF, kuitansi, laporan, katalog, ekspor slide | Urutan baca, tabel, paragraf, dan kualitas chunk downstream | Fallback hanya ketika kualitas tata letak tetap dapat diterima |
| Ekstraksi terstruktur | Faktur, formulir pajak, kontrak, ID, klaim, aplikasi | Akurasi field dan stabilitas skema | Fallback hanya ke rute yang dapat mengembalikan field wajib yang sama |
| Dokumen terbatas | File yang diatur regulasi atau sensitif terhadap kontrak | Penanganan data, retensi, wilayah, dan persetujuan vendor | Fallback hanya di dalam set provider yang sama yang disetujui |
Ini adalah inti dari routing model OCR: pilih rute yang sesuai dengan dokumen dan bentuk output, lalu izinkan fallback hanya ketika cadangan dapat memenuhi kebutuhan biaya, kualitas, dan kontrol yang sama.
Mengapa Biaya Ekstraksi Teks Mudah Disalahpahami
Biaya API OCR jarang berupa satu angka yang jelas. Provider dapat membanderol OCR dasar, analisis tata letak, formulir, tabel, kueri, ekstraksi kustom, atau pemrosesan batch secara berbeda. Beberapa halaman ditagih per halaman. Beberapa alur kerja membayar lebih mahal ketika halaman yang sama membutuhkan field terstruktur. Beberapa batas mendorong traffic dari panggilan sinkron ke job asinkron.
Sebelum membandingkan rute OCR, normalisasikan setiap kandidat ke unit operasional yang sama:
| Metrik | Mengapa ini termasuk dalam tabel routing |
|---|---|
| Biaya per halaman yang diterima | Harga halaman mentah saja tidak cukup jika suatu rute menghasilkan lebih banyak output yang ditolak atau pengulangan. |
| Biaya per dokumen terstruktur yang diterima | Faktur dan formulir harus diukur berdasarkan output field yang dapat digunakan, bukan hanya teks OCR. |
| Batas halaman/file sinkron | Rute yang tidak dapat menerima bentuk file tersebut bukan fallback yang valid. |
| Batas job asinkron | PDF besar dan batch arsip memerlukan routing yang sadar antrean. |
| Tingkat fitur | Formulir, tabel, kueri, tanda tangan, dan tata letak dapat mengubah harga efektif. |
| Perilaku kuota dan throttle | Rute yang murah pada volume rendah dapat gagal saat beban batch. |
Halaman harga resmi menunjukkan mengapa normalisasi unit itu penting. Harga Amazon Textract mencantumkan API dan fitur terpisah untuk Detect Document Text, Analyze Document, Analyze Expense, Analyze ID, dan Analyze Lending. Contohnya menunjukkan Detect Document Text pada $0,0015 per halaman untuk satu juta halaman pertama di US West (Oregon), sementara contoh Analyze Document untuk formulir dan tabel menggabungkan $0,015 per halaman tabel dan $0,05 per halaman formulir. Harga Google Document AI mencantumkan Enterprise Document OCR, OCR add-on, Layout Parser, Custom Extractor, dan Form Parser sebagai permukaan berharga terpisah. Azure Document Intelligence menyatakan bahwa penagihan dihitung bulanan berdasarkan jenis model dan halaman yang dianalisis, dan halaman batas layanan-nya mengaitkan perilaku routing dengan ukuran file, jumlah halaman, dan batas transaksi per detik.
Pelajaran untuk routing model OCR sederhana: jangan bandingkan harga utama penyedia sampai workload, bentuk output, unit penagihan, dan kebijakan retry sudah dinormalisasi.
Bangun Tabel Rute Sebelum Anda Mengaudit Model
Tim sering menjalankan beberapa dokumen uji melalui beberapa model OCR dan memilih yang "terlihat paling baik." Itu bisa berhasil untuk demo, tetapi tidak menghasilkan kebijakan routing yang tahan lama.
Bangun tabel rute terlebih dahulu. Untuk routing model AI dokumen, tabel ini adalah kontrak yang mencegah OCR sederhana, ekstraksi tata letak, dan ekstraksi terstruktur menyatu menjadi satu rute default. Jika Anda sudah melacak kualitas routing di gateway, padukan tabel ini dengan skor metrik API routing AI:
| Beban kerja | Contoh input | Output yang diperlukan | Perilaku rute default | Kondisi penolakan |
|---|---|---|---|---|
| OCR arsip yang dapat dicari | PDF hasil pemindaian, tangkapan layar, laporan lama | Teks biasa dengan urutan baca yang dapat diterima | Rute berbiaya terendah yang disetujui | Halaman hilang, bahasa salah, urutan rusak |
| Ingesti kuitansi atau faktur | Kuitansi, faktur, dokumen pembayaran | Bidang, total, tanggal, item baris | Rute ekstraksi terstruktur | Bidang yang diperlukan hilang atau keyakinan rendah |
| Pemahaman katalog atau laporan | Katalog produk, laporan padat, deck slide | Teks dan tabel yang sadar tata letak | Rute tata letak dengan pemeriksaan tabel | Tabel tergabung, kolom hilang, urutan bagian rusak |
| Tinjauan ID atau aplikasi | ID, aplikasi, formulir onboarding | Bidang spesifik plus jejak audit | Rute terbatas yang disetujui | Penyedia belum disetujui, retensi tidak diketahui, ketidaksesuaian bidang |
| Migrasi batch | PDF besar atau arsip gambar | Cakupan halaman lengkap | Rute async dengan ruang kepala batas halaman | Pekerjaan terlalu besar, throttling, penyelesaian parsial |
Setelah tabel ini ada, evaluasi model menjadi lebih berguna. Anda tidak lagi bertanya "Model OCR mana yang terbaik?" Anda bertanya "Rute mana yang dapat diterima untuk kelas dokumen ini pada biaya dan risiko fallback ini?" Itulah perbedaan praktis antara demo dan routing AI OCR API yang dapat bertahan dalam lalu lintas produksi.
Quality Gate Harus Sesuai Dengan Output, Bukan Demo
Kualitas OCR membutuhkan gate yang berbeda untuk beban kerja yang berbeda.
Untuk OCR teks biasa, ukur:
- Cakupan halaman.
- Kelangkapan karakter dan kata.
- Urutan baca.
- Toleransi bahasa dan tulisan tangan.
- Proporsi halaman yang memerlukan peninjauan manusia.
Untuk OCR yang sadar tata letak, ukur:
- Pengelompokan paragraf.
- Hierarki judul.
- Batas tabel.
- Urutan kolom.
- Apakah kualitas pencarian, pengambilan, atau UI peninjauan downstream membaik.
Untuk ekstraksi terstruktur, ukur:
- Presisi bidang yang diperlukan.
- Recall bidang yang diperlukan.
- Stabilitas normalisasi untuk tanggal, jumlah, nama, dan ID.
- Kalibrasi keyakinan.
- Kesesuaian skema di seluruh rute primer dan fallback.
Di sinilah banyak proyek routing model OCR gagal. Fallback yang mengembalikan teks biasa tidak setara dengan ekstraktor faktur terstruktur. Rute yang mempertahankan sebagian besar kata tetapi kehilangan batas tabel masih dapat merusak alur kerja pengambilan atau peninjauan. Model berakurasi tinggi yang tidak dapat menangani jumlah halaman yang sama bukanlah fallback yang aman untuk PDF batch.
Pemeriksaan Fallback Adalah Kebutuhan Produk
Fallback tidak boleh berarti "coba penyedia OCR lain." Itu harus berarti "coba rute lain yang disetujui yang dapat memenuhi kontrak beban kerja yang sama."
Gunakan daftar periksa ini sebelum sebuah rute dapat menjadi fallback:
| Pemeriksaan fallback | Kondisi lolos |
|---|---|
| Kelas dokumen yang sama | Fallback menerima jenis file, jumlah halaman, dan ukuran yang sama. |
| Kontrak output yang sama | Fallback mengembalikan teks, tata letak, atau field yang diperlukan yang sama. |
| Kontrol data yang sama | Fallback memenuhi aturan retensi, wilayah, dan kontrak pelanggan yang sama. |
| Observabilitas yang sama | Fallback mencatat rute, biaya, latensi, error, confidence, dan alasan penolakan. |
| Biaya retry terbatas | Anggaran retry dan fallback dibatasi per job, tenant, dan batch. |
| Jalur review manual | Kegagalan yang tidak ekuivalen masuk ke review, bukan degradasi diam-diam. |
Amazon Textract adalah contoh yang berguna mengapa kelayakan fallback harus mencakup batasan dokumen: batasan dokumen-nya menyebutkan bahwa operasi PDF dan TIFF sinkron dibatasi hingga satu halaman, sedangkan operasi PDF dan TIFF asinkron mengizinkan hingga 3.000 halaman. batas layanan Azure Document Intelligence mendokumentasikan batas default 15 TPS pada transaksi analyze tier Standard, ukuran dokumen maksimum 500 MB, dan batas analisis 2.000 halaman. kuota Google Document AI mendokumentasikan kuota processor, batas request online, dan kuota halaman per menit untuk versi generative processor.
Batasan-batasan tersebut bukan kasus pinggiran. Batasan itu yang menentukan apakah sebuah fallback valid.
Pohon Keputusan Routing Model OCR yang Praktis
Gunakan pohon keputusan ini saat sebuah job dokumen baru masuk ke pipeline:
- Klasifikasikan dokumen sebelum memanggil rute OCR.
- Tentukan apakah output memerlukan teks biasa, tata letak, atau field terstruktur.
- Singkirkan rute yang gagal memenuhi persyaratan retensi, wilayah, kontrak, jenis file, jumlah halaman, atau kuota.
- Perkirakan biaya per output yang diterima, bukan hanya biaya per halaman mentah.
- Jalankan rute utama.
- Terapkan quality gate khusus workload.
- Retry hanya untuk error sementara atau kegagalan idempotent yang aman.
- Lakukan fallback hanya dalam kelas rute yang sama.
- Kirim kegagalan yang tidak ekuivalen ke review atau antrean batch.
- Catat keputusan rute, biaya, confidence, alasan fallback, dan status akhir diterima/ditolak.
Berikut kebijakan routing dalam bentuk ringkas:
document_job:
  classify:
    inputs: [file_type, page_count, document_type, customer_tier, data_region]
  exclude:
    - route_not_approved_for_data_policy
    - route_page_limit_below_job_size
    - route_missing_required_output_contract
  choose_primary:
    optimize_for: cost_per_accepted_output
    guardrails: [quality_gate, latency_budget, quota_headroom]
  fallback:
    allowed_only_when:
      - transient_error
      - same_route_class
      - same_output_contract
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log: [route, model, cost, latency, confidence, error_class, fallback_reason]
Kebijakan ini lebih penting daripada daftar model. Model OCR baru dapat ditambahkan nanti tanpa menulis ulang alur kerja dokumen.
Di Mana Flatkey Cocok dalam Routing Model OCR
Flatkey berguna dalam routing model OCR ketika tim menginginkan satu lapisan operasional untuk akses model, visibilitas pengeluaran, dan peninjauan rute, alih-alih menyebarkan kunci penyedia di antara agen, job, dan layanan. Jika tim Anda masih menghubungkan akun penyedia secara langsung, mulailah dengan alur kerja API AI terpadu lalu petakan aturan fallback khusus OCR terhadap playbook strategi fallback model.
Situs publik Flatkey saat ini memposisikan produk di sekitar satu kunci, satu saldo, penggunaan model dan tool, penagihan berdasarkan panggilan yang berhasil, buku besar bersama, dan direktori model publik dengan ketersediaan langsung, harga, dukungan endpoint, dan halaman detail model. Untuk alur kerja OCR, itu menjadikan gateway paling relevan sebagai control plane: memvalidasi rute multimodal atau yang mampu memproses dokumen yang tersedia, menentukan beban kerja mana yang dapat menggunakannya, dan meninjau biaya serta kegagalan di tingkat rute di satu tempat.
Jangan anggap katalog gateway mana pun sebagai pengganti pengujian kualitas OCR Anda sendiri. Perlakukan itu sebagai tempat di mana rute yang disetujui, data penggunaan, kebijakan fallback, dan kontrol biaya menjadi lebih mudah dioperasikan. Saat Anda siap membandingkan ekonomi rute, gunakan permukaan harga Flatkey saat ini, bukan nama model usang dari catatan implementasi lama.
Checklist peluncuran
Sebelum memindahkan routing model OCR ke produksi, pastikan item-item berikut:
- Setiap kelas dokumen memiliki rute default dan kelas fallback yang diizinkan.
- Setiap rute memiliki biaya terstandardisasi per halaman yang diterima atau dokumen terstruktur yang diterima.
- Setiap alur kerja terstruktur memiliki quality gate di tingkat field.
- Batas halaman sync dan async diuji dengan file nyata, bukan diasumsikan dari contoh.
- Perilaku kuota dan throttling direpresentasikan dalam load test.
- Dokumen terbatas hanya dapat menggunakan rute yang disetujui.
- Job yang gagal mencatat alasan fallback terjadi dan apakah output diterima.
- Keuangan dapat melacak pengeluaran berdasarkan rute, beban kerja, tenant, dan alasan fallback.
- Produk memiliki jalur review manual untuk kegagalan yang tidak ekuivalen.
Routing model OCR bekerja ketika operasinya terasa membosankan: pekerjaan murah tetap murah, pekerjaan terstruktur mendapatkan model yang tepat, dan fallback tidak pernah mengubah kontrak dokumen tanpa disadari.
FAQ
Apa itu routing model OCR?
Routing model OCR adalah lapisan kebijakan yang mengirim setiap job dokumen ke rute OCR atau document AI berdasarkan jenis dokumen, output yang diperlukan, biaya, persyaratan kualitas, dan batasan fallback.
Bagaimana tim sebaiknya membandingkan biaya OCR API?
Bandingkan biaya OCR API berdasarkan output yang diterima. Untuk OCR biasa, itu biasanya biaya per halaman yang diterima. Untuk invoice, formulir, kontrak, dan ID, itu biasanya biaya per dokumen terstruktur yang diterima setelah retry dan penolakan review.
Kapan fallback menjadi tidak aman untuk OCR?
Fallback menjadi tidak aman ketika rute cadangan tidak dapat menerima bentuk file, jumlah halaman, kebijakan data, atau kontrak output yang sama. Rute OCR teks biasa bukan fallback yang aman untuk alur kerja yang memerlukan field invoice terstruktur.
Apakah satu model OCR harus menangani setiap jenis dokumen?
Biasanya tidak. OCR sederhana, ekstraksi layout, ekstraksi terstruktur, PDF batch besar, dan dokumen terbatas memiliki kebutuhan biaya, kualitas, dan kontrol yang berbeda.
Bagaimana Flatkey membantu dengan perutean model OCR?
Flatkey dapat membantu tim menjalankan perutean model OCR melalui satu kunci, satu keseimbangan, pemeriksaan ketersediaan model, visibilitas penggunaan, dan tinjauan di tingkat rute. Tim tetap perlu menjalankan pengujian kualitas dokumen mereka sendiri sebelum lalu lintas produksi dipindahkan.


