
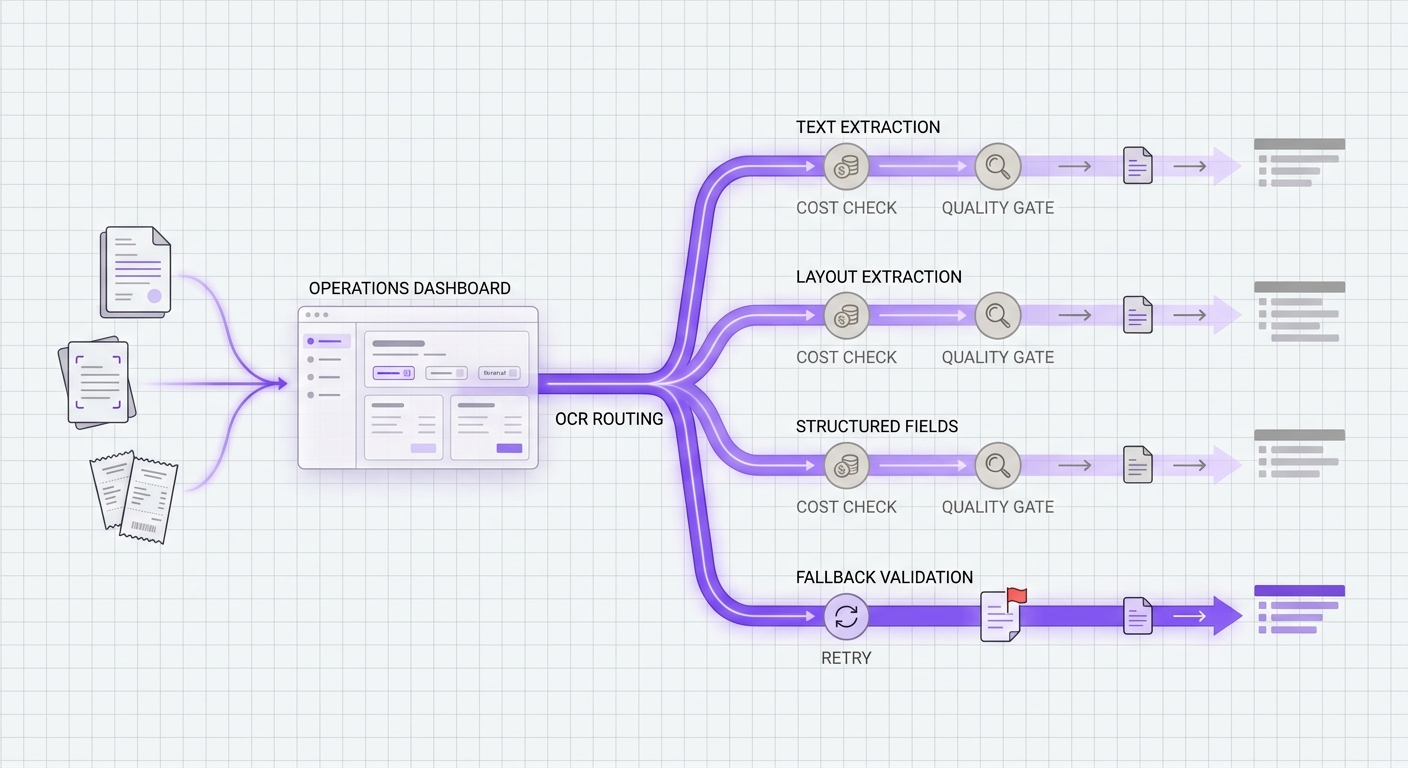
Si está planificando el enrutamiento de modelos OCR, la parte arriesgada no es encontrar un modelo OCR que pueda leer texto de un escaneo. La parte arriesgada es decidir qué ruta debe encargarse de las imágenes simples, qué ruta debe encargarse de los PDF de varias páginas, qué ruta debe extraer campos estructurados y qué respaldo puede tocar la misma clase de documento cuando la primera ruta falla.
Por eso el enrutamiento de modelos OCR debería comenzar con la política de carga de trabajo, no con un ranking de proveedores. Una ruta barata de OCR de texto puede ser la opción equivocada para facturas. Un extractor estructurado de alta calidad puede ser un desperdicio para texto de archivo masivo. Un respaldo puede parecer fiable hasta que silenciosamente omite tablas, supera los límites de páginas o duplica el costo de una tormenta de reintentos.
Esta guía ofrece a los equipos de medios, producto e ingeniería una forma práctica de equilibrar el costo de extracción de texto, la calidad y las comprobaciones de respaldo antes de estandarizar el tráfico documental. Trata el enrutamiento de la API OCR de IA y el enrutamiento de modelos de IA documental como decisiones operativas, no como ejercicios puntuales de benchmarking.
La respuesta rápida
La política de enrutamiento de modelos OCR más segura separa los trabajos de documentos en cuatro clases:
| Route class | Use it for | Primary decision | Fallback rule |
|---|---|---|---|
| Plain text OCR | Screenshots, scanned notes, simple image text, searchable archives | Lowest approved cost per accepted page | Fallback only to another route that preserves text completeness and language coverage |
| Layout-aware OCR | PDFs, receipts, reports, catalogs, slide exports | Reading order, tables, paragraphs, and downstream chunk quality | Fallback only when layout quality remains acceptable |
| Structured extraction | Invoices, tax forms, contracts, IDs, claims, applications | Field accuracy and schema stability | Fallback only to a route that can return the same required fields |
| Restricted documents | Regulated or contract-sensitive files | Data handling, retention, region, and vendor approval | Fallback only inside the same approved provider set |
Este es el núcleo del enrutamiento de modelos OCR: elija la ruta que se ajuste al documento y a la forma de salida, y luego permita el respaldo solo cuando la alternativa pueda satisfacer los mismos requisitos de costo, calidad y control.
Por qué es fácil malinterpretar el costo de extracción de texto
El costo de la API OCR rara vez es una cifra única y clara. Los proveedores pueden fijar precios distintos para el OCR básico, el análisis de diseño, formularios, tablas, consultas, extracción personalizada o procesamiento por lotes. Algunas páginas se facturan por página. Algunos flujos de trabajo pagan más cuando la misma página necesita campos estructurados. Algunos límites trasladan el tráfico de una llamada síncrona a un trabajo asíncrono.
Antes de comparar rutas OCR, normalice cada candidato a la misma unidad operativa:
| Métrica | Por qué pertenece a la tabla de enrutamiento |
|---|---|
| Costo por página aceptada | El precio bruto por página no es suficiente si una ruta genera más salidas rechazadas o reintentos. |
| Costo por documento estructurado aceptado | Las facturas y los formularios deben medirse por la salida de campos utilizable, no solo por el texto OCR. |
| Límites síncronos de página/archivo | Una ruta que no puede aceptar la forma del archivo no es un respaldo válido. |
| Límites asíncronos de trabajos | Los PDFs grandes y los lotes de archivos necesitan un enrutamiento consciente de la cola. |
| Nivel de funciones | Los formularios, las tablas, las consultas, las firmas y el diseño pueden cambiar el precio efectivo. |
| Comportamiento de cuota y limitación | Una ruta que es barata con poco volumen puede fallar bajo carga por lotes. |
Las páginas oficiales de precios muestran por qué la normalización de unidades importa. precios de Amazon Textract enumera APIs y funciones separadas para Detect Document Text, Analyze Document, Analyze Expense, Analyze ID y Analyze Lending. Sus ejemplos muestran Detect Document Text a $0.0015 por página para los primeros un millón de páginas en US West (Oregón), mientras que un ejemplo de Analyze Document para formularios y tablas combina $0.015 por página de tabla y $0.05 por página de formulario. precios de Google Document AI enumera Enterprise Document OCR, OCR add-ons, Layout Parser, Custom Extractor y Form Parser como superficies con precios separados. Azure Document Intelligence dice que la facturación se calcula mensualmente según el tipo de modelo y las páginas analizadas, y su página de límites del servicio vincula el comportamiento de enrutamiento al tamaño del archivo, el número de páginas y los límites de transacciones por segundo.
La lección para el enrutamiento de modelos OCR es simple: no compares los precios destacados de los proveedores hasta que la carga de trabajo, la forma de la salida, la unidad de facturación y la política de reintentos estén normalizadas.
Construye la tabla de rutas antes de comparar modelos
Los equipos suelen ejecutar unos pocos documentos de prueba a través de varios modelos OCR y elegir el que "se ve mejor". Eso puede funcionar para una demostración, pero no produce una política de enrutamiento duradera.
Construye primero la tabla de rutas. Para el enrutamiento de modelos de IA documental, esta tabla es el contrato que evita que el OCR simple, la extracción de diseño y la extracción estructurada se colapsen en una sola ruta predeterminada. Si ya haces seguimiento de la calidad del enrutamiento en una pasarela, combina esta tabla con una tarjeta de puntuación de métricas de API de enrutamiento de IA:
| Carga de trabajo | Ejemplo de entrada | Resultado requerido | Comportamiento de la ruta predeterminada | Condición de rechazo |
|---|---|---|---|---|
| OCR para archivo con búsqueda | PDF escaneados, capturas de pantalla, informes heredados | Texto plano con un orden de lectura aceptable | Ruta aprobada de menor costo | Páginas faltantes, idioma incorrecto, orden roto |
| Ingesta de recibos o facturas | Recibos, facturas, documentos de pago | Campos, totales, fechas, partidas | Ruta de extracción estructurada | Falta un campo obligatorio o baja confianza |
| Comprensión de catálogos o informes | Catálogos de productos, informes densos, presentaciones | Texto y tablas con conocimiento del diseño | Ruta con diseño y comprobaciones de tablas | Tablas fusionadas, columnas perdidas, orden de secciones roto |
| Revisión de identificaciones o solicitudes | Identificaciones, solicitudes, formularios de incorporación | Campos específicos más trazabilidad de auditoría | Ruta restringida aprobada | Proveedor no autorizado, retención desconocida, discrepancia de campos |
| Migración por lotes | PDF grandes o archivos de imágenes | Cobertura completa de páginas | Ruta asíncrona con margen de capacidad por página | Trabajo demasiado grande, limitación de velocidad, finalización parcial |
Una vez que existe esta tabla, la evaluación del modelo se vuelve más útil. Ya no estás preguntando "¿Qué modelo OCR es mejor?" Estás preguntando "¿Qué ruta es aceptable para esta clase exacta de documento con este costo y este riesgo de respaldo?" Esa es la diferencia práctica entre una demostración y un enrutamiento de API de OCR con IA que puede sobrevivir al tráfico de producción.
Los controles de calidad deben coincidir con el resultado, no con la demostración
La calidad de OCR necesita diferentes controles para distintas cargas de trabajo.
Para OCR de texto plano, mide:
- Cobertura de páginas.
- Completitud de caracteres y palabras.
- Orden de lectura.
- Tolerancia al idioma y a la escritura manual.
- La proporción de páginas que requieren revisión humana.
Para OCR con conocimiento del diseño, mide:
- Agrupación de párrafos.
- Jerarquía de encabezados.
- Rangos de tablas.
- Orden de columnas.
- Si mejora la calidad de la búsqueda, la recuperación o la interfaz de revisión posterior.
Para la extracción estructurada, mide:
- Precisión de los campos obligatorios.
- Recobrado de los campos obligatorios.
- Estabilidad de normalización para fechas, importes, nombres e identificaciones.
- Calibración de la confianza.
- Compatibilidad del esquema entre las rutas principal y de respaldo.
Aquí es donde fracasan muchos proyectos de enrutamiento de modelos OCR. Un respaldo que devuelve texto plano no es equivalente a un extractor estructurado de facturas. Una ruta que conserva la mayoría de las palabras pero pierde los límites de las tablas aún puede romper los flujos de trabajo de recuperación o revisión. Un modelo de alta precisión que no puede manejar la misma cantidad de páginas no es un respaldo seguro para PDF por lotes.
Las comprobaciones de respaldo son un requisito de producto
Respaldo no debería significar "probar con otro proveedor de OCR". Debería significar "probar con otra ruta aprobada que pueda cumplir el mismo contrato de carga de trabajo".
Usa esta lista de verificación antes de que una ruta pueda convertirse en respaldo:
| Comprobación de respaldo | Condición de aprobación |
|---|---|
| Misma clase de documento | El respaldo acepta el mismo tipo de archivo, recuento de páginas y tamaño. |
| Mismo contrato de salida | El respaldo devuelve el mismo texto, diseño o campos requeridos. |
| Mismos controles de datos | El respaldo cumple las mismas reglas de retención, región y contrato con el cliente. |
| Misma observabilidad | El respaldo registra ruta, costo, latencia, errores, confianza y motivo del rechazo. |
| Costo de reintento acotado | Los presupuestos de reintento y respaldo están limitados por trabajo, tenant y lote. |
| Ruta de revisión manual | Los fallos no equivalentes pasan a revisión en lugar de una degradación silenciosa. |
Amazon Textract es un ejemplo útil de por qué la elegibilidad para respaldo debe incluir límites de documentos: sus límites de documento indican que las operaciones síncronas de PDF y TIFF están limitadas a una página, mientras que las operaciones asíncronas de PDF y TIFF permiten hasta 3.000 páginas. Los límites del servicio Azure Document Intelligence documentan un límite predeterminado de 15 TPS en transacciones de análisis del nivel Standard, un tamaño máximo de documento de 500 MB y un límite de análisis de 2.000 páginas. Las cuotas de Google Document AI documentan cuotas de procesadores, límites de solicitudes en línea y cuotas de páginas por minuto para versiones generativas de procesadores.
Esas restricciones no son casos extremos. Deciden si un respaldo es válido.
Árbol práctico de decisión para el enrutamiento de modelos OCR
Use este árbol de decisión cuando un nuevo trabajo de documento entre en la canalización:
- Clasifique el documento antes de llamar a una ruta OCR.
- Decida si la salida necesita texto plano, diseño o campos estructurados.
- Excluya las rutas que no cumplan los requisitos de retención, región, contrato, tipo de archivo, recuento de páginas o cuota.
- Estime el costo por salida aceptada, no solo el costo por página en bruto.
- Ejecute la ruta principal.
- Aplique controles de calidad específicos para la carga de trabajo.
- Vuelva a intentar solo para errores transitorios o fallos idempotentes seguros.
- Haga el respaldo solo dentro de la misma clase de ruta.
- Envía los fallos no equivalentes a revisión o a una cola por lotes.
- Registre la decisión de la ruta, el costo, la confianza, el motivo del respaldo y el estado final aceptado/rechazado.
Esta es la política de enrutamiento en una forma compacta:
document_job:
  classify:
    inputs: [file_type, page_count, document_type, customer_tier, data_region]
  exclude:
    - route_not_approved_for_data_policy
    - route_page_limit_below_job_size
    - route_missing_required_output_contract
  choose_primary:
    optimize_for: cost_per_accepted_output
    guardrails: [quality_gate, latency_budget, quota_headroom]
  fallback:
    allowed_only_when:
      - transient_error
      - same_route_class
      - same_output_contract
      - retry_budget_remaining
    otherwise: manual_review
  observe:
    log: [route, model, cost, latency, confidence, error_class, fallback_reason]
La política importa más que la lista de modelos. Los nuevos modelos OCR pueden añadirse más adelante sin reescribir el flujo de trabajo de documentos.
Dónde encaja Flatkey en el enrutamiento de modelos OCR
Flatkey es útil en el enrutamiento de modelos OCR cuando el equipo quiere una sola capa operativa para el acceso a modelos, la visibilidad del gasto y la revisión de rutas, en lugar de dispersar claves de proveedores entre agentes, trabajos y servicios. Si tu equipo todavía está conectando cuentas directas de proveedores, empieza con el flujo de trabajo de API de IA unificada y luego asigna las reglas de fallback específicas de OCR frente al playbook de estrategia de fallback de modelos.
El sitio público actual de Flatkey posiciona el producto en torno a una clave, un balance, el uso de modelos y herramientas, la facturación por llamadas exitosas, un libro mayor compartido y un directorio de modelos público con disponibilidad en vivo, precios, compatibilidad con endpoints y páginas de detalle de los modelos. Para los flujos de trabajo de OCR, eso hace que la pasarela sea más relevante como plano de control: validar las rutas multimodales o con capacidad de documentos disponibles, definir qué cargas de trabajo pueden usarlas y revisar el costo y los fallos a nivel de ruta en un solo lugar.
No trates ningún catálogo de pasarela como sustituto de tu propia prueba de calidad de OCR. Trátalo como el lugar donde las rutas aprobadas, los datos de uso, la política de fallback y los controles de costos se vuelven más fáciles de operar. Cuando estés listo para comparar la economía de las rutas, usa la superficie actual de precios de Flatkey en lugar de nombres de modelos obsoletos de notas de implementación antiguas.
Lista de comprobación de lanzamiento
Antes de llevar el enrutamiento de modelos OCR a producción, confirma estos elementos:
- Cada clase de documento tiene una ruta predeterminada y una clase de fallback permitida.
- Cada ruta tiene un costo normalizado por página aceptada o documento estructurado aceptado.
- Cada flujo de trabajo estructurado tiene controles de calidad a nivel de campo.
- Los límites de páginas síncronas y asíncronas se prueban con archivos reales, no se asumen a partir de ejemplos.
- El comportamiento de cuotas y limitación de solicitudes está representado en las pruebas de carga.
- Los documentos restringidos solo pueden usar rutas aprobadas.
- Los trabajos fallidos registran por qué ocurrió el fallback y si el resultado fue aceptado.
- Finanzas puede rastrear el gasto por ruta, carga de trabajo, inquilino y motivo del fallback.
- Producto tiene una ruta de revisión manual para fallos no equivalentes.
El enrutamiento de modelos OCR funciona cuando operarlo es aburrido: el trabajo barato sigue siendo barato, el trabajo estructurado obtiene el modelo correcto y el fallback nunca cambia el contrato del documento sin que se note.
Preguntas frecuentes
¿Qué es el enrutamiento de modelos OCR?
El enrutamiento de modelos OCR es la capa de políticas que envía cada trabajo de documento a una ruta de OCR o de IA documental según el tipo de documento, el resultado requerido, el costo, los requisitos de calidad y las restricciones de fallback.
¿Cómo deberían comparar los equipos el costo de la API de OCR?
Compara el costo de la API de OCR por resultado aceptado. Para OCR simple, normalmente eso es el costo por página aceptada. Para facturas, formularios, contratos y documentos de identidad, normalmente es el costo por documento estructurado aceptado después de reintentos y rechazos de revisión.
¿Cuándo se vuelve inseguro el fallback para OCR?
El fallback se vuelve inseguro cuando la ruta de respaldo no puede aceptar la misma forma de archivo, cantidad de páginas, política de datos o contrato de salida. Una ruta de OCR de texto plano no es un fallback seguro para un flujo de trabajo que requiere campos estructurados de factura.
¿Debería un solo modelo OCR manejar todos los tipos de documentos?
Normalmente no. El OCR simple, la extracción de diseño, la extracción estructurada, los PDF de lotes grandes y los documentos restringidos tienen diferentes requisitos de costo, calidad y control.
¿Cómo ayuda Flatkey con el enrutamiento de modelos OCR?
Flatkey puede ayudar a los equipos a operar el enrutamiento de modelos OCR mediante una clave, un balance, comprobaciones de disponibilidad de modelos, visibilidad del uso y revisión a nivel de ruta. Los equipos aún necesitan ejecutar sus propias pruebas de calidad de documentos antes de que el tráfico de producción se traslade.


