Crear un clúster de GPU de Kubernetes no es lo mismo que conectar GPU a unos cuantos nodos de trabajo. Para el entrenamiento y la inferencia de IA, Kubernetes debe exponer los aceleradores de forma segura, colocar los trabajos en los nodos correctos, poner en cola la capacidad escasa, mantener los conjuntos de datos y los pesos de los modelos lo suficientemente cerca del cómputo y explicar a los operadores por qué falló una ejecución costosa.
La regla práctica: cree el clúster de GPU de Kubernetes más pequeño que valide la carga de trabajo y amplíelo solo después de que el planificador, los controladores, la red, el almacenamiento, la observabilidad y el modelo de costos hayan superado las pruebas de aceptación. Un clúster que no puede explicar el tiempo en cola, la utilización de la GPU, el tiempo de restauración de puntos de control y las causas de fallos aún no es infraestructura de producción.
Esta guía explica la arquitectura y el modelo operativo de un clúster de GPU de Kubernetes utilizado para el entrenamiento y la inferencia de IA. Abarca el diseño de nodos, la exposición de GPU, las colas, las API de cargas de trabajo, la observabilidad, un práctico diagrama de clúster de GPU de Kubernetes, herramientas de gestión y las preguntas que debe plantear a los proveedores antes de alquilar o reservar capacidad.
Si el producto solo necesita salidas de modelos, compare primero una API de modelos o una ruta de inferencia gestionada. Si necesita pesos personalizados, control de ubicación, servicio privado, entrenamiento distribuido o propiedad de benchmarks repetibles, un clúster de GPU de Kubernetes puede ser el plano de control adecuado.
Respuesta rápida sobre clústeres de GPU de Kubernetes
Un clúster de GPU de Kubernetes de producción tiene seis capas:
| Capa | De qué se encarga | Qué verificar antes de producción |
|---|---|---|
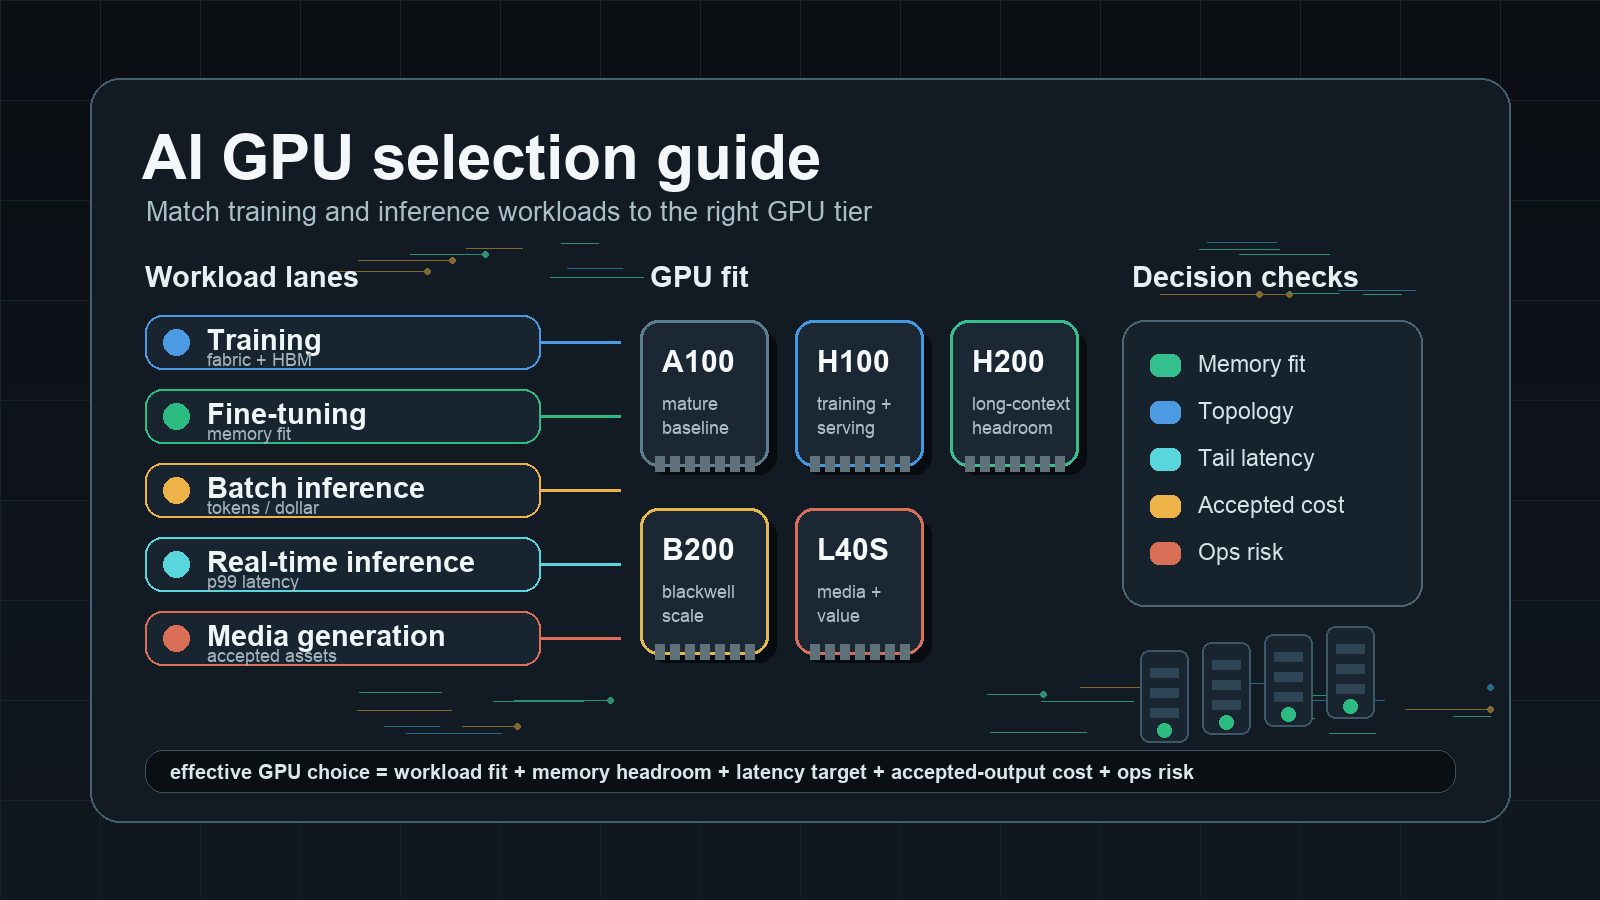
| Nodos de GPU | Modelo de GPU, memoria de GPU, CPU/RAM, NVMe local, NIC, imágenes de nodo, controladores, tiempo de ejecución de contenedores | La configuración del nodo se ajusta a la carga de trabajo de entrenamiento o inferencia, no solo a la SKU de GPU anunciada. |
| Exposición de GPU | Plugin de dispositivos, GPU Operator, asignación dinámica de recursos, política de MIG o uso compartido | Los pods solicitan aceleradores de forma predecible y no pueden consumir accidentalmente dispositivos incorrectos. |
| Planificación y colas | Planificador de Kubernetes, Kueue, Volcano, Ray, Kubeflow, operadores personalizados | Los trabajos esperan de forma justa, la política de expulsión es explícita y los equipos pueden explicar el tiempo en cola. |
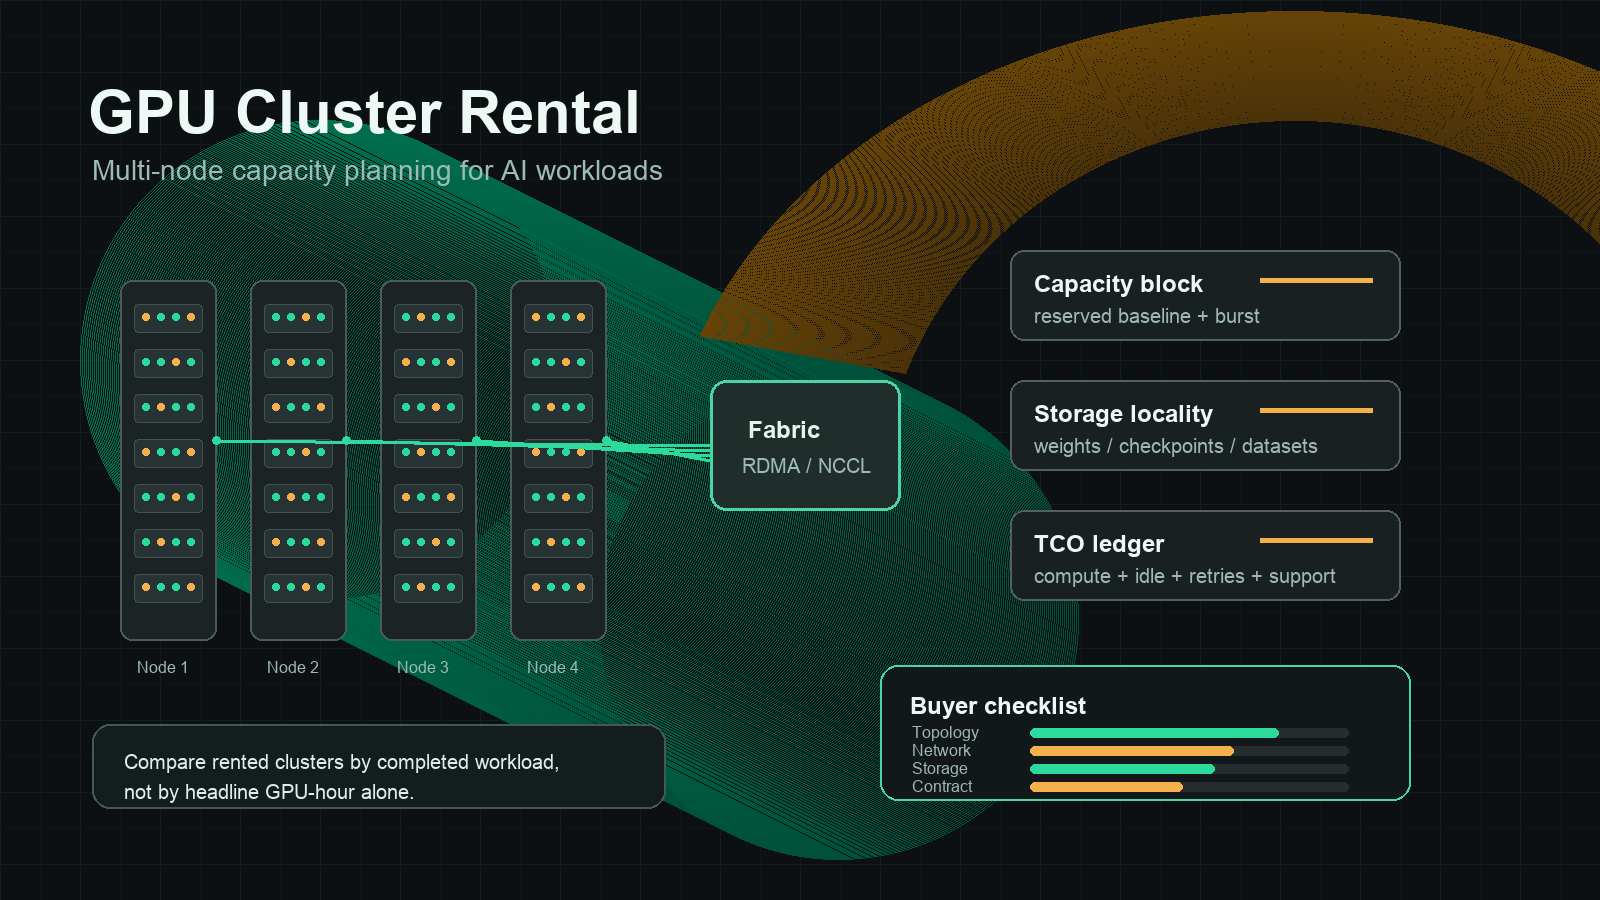
| Red y almacenamiento | NVLink/NVSwitch dentro de los nodos, InfiniBand/RoCE/EFA o Ethernet entre nodos, almacenamiento de objetos, sistema de archivos compartido, ruta de puntos de control | Los trabajos distribuidos escalan y se recuperan sin dejar las GPU sin trabajo. |
| Observabilidad | DCGM, Prometheus, registros, eventos, trazas, métricas de cola, etiquetas de costos | Los operadores pueden ver la utilización, la memoria, la energía, los fallos, el propietario y el gasto por carga de trabajo. |
| Seguridad y gobernanza | RBAC, espacios de nombres, cuotas, política de imágenes, secretos, política de red, registros de auditoría | El acceso multiinquilino está controlado antes de que el clúster se convierta en infraestructura compartida. |
La pregunta clave de diseño no es "¿Puede Kubernetes ejecutar GPU?". Puede hacerlo, con el plugin de dispositivos y la configuración de nodos adecuados. La pregunta más difícil es si su clúster de GPU de Kubernetes para infraestructura de IA puede mantener las GPU productivas con datos reales, usuarios reales, fallos reales y restricciones presupuestarias reales.
Diagrama de clúster de GPU de Kubernetes
Use este diagrama de clúster de GPU de Kubernetes como modelo de revisión antes de elegir herramientas:
                 developers / CI / notebooks / API traffic
                                  |
                                  v
        +--------------------------------------------------+
        | Kubernetes control plane                         |
        | API server, scheduler, RBAC, admission, secrets   |
        +--------------------------------------------------+
                                  |
                 +----------------+----------------+
                 |                                 |
                 v                                 v
        +------------------+              +------------------+
        | queue layer      |              | platform add-ons  |
        | Kueue / Volcano  |              | GPU Operator,     |
        | quotas, cohorts, |              | device plugin,    |
        | resource flavors |              | DCGM exporter     |
        +------------------+              +------------------+
                 |                                 |
                 +----------------+----------------+
                                  |
                                  v
        +--------------------------------------------------+
        | GPU worker node pools                            |
        | H100/H200/B200/A100/L40S/etc., CPU, RAM, NVMe,   |
        | NICs, CUDA/runtime, labels, taints, topology     |
        +--------------------------------------------------+
                 |                 |                 |
                 v                 v                 v
        training jobs       inference services       batch jobs
        PyTorch/JAX         vLLM/SGLang/Triton       Ray/Kubeflow
                 \                 |                 /
                  \                |                /
                   v               v               v
        +--------------------------------------------------+
        | network and data path                            |
        | high-speed fabric, object storage, shared FS,     |
        | model cache, checkpoints, logs, metrics, backups |
        +--------------------------------------------------+
Este diagrama es intencionadamente simple. Una arquitectura de clúster de GPU de Kubernetes real añadirá balanceadores de carga, registros privados, límites de malla de servicios, IAM, almacenes de artefactos, seguimiento de experimentos y exportaciones de facturación. La función del diagrama es forzar una conversación: ¿qué capa es responsable de cada modo de fallo?
Paso 1: decidir si Kubernetes es el plano de control de GPU adecuado
Kubernetes es una buena opción cuando su plataforma de IA necesita despliegue nativo de contenedores, automatización basada en API, espacios de nombres multiinquilino, endpoints de servicio, controles de políticas e integración con la observabilidad nativa de la nube existente.
Normalmente es adecuado para:
- Servicios de inferencia en línea que necesitan despliegues graduales, límites de escalado automático, enrutamiento y comprobaciones del estado del servicio.
- Cargas de trabajo de inferencia por lotes o de embeddings que se ejecutan como Jobs, cargas de trabajo de Ray u operadores personalizados.
- Cargas de trabajo de ajuste fino y entrenamiento en las que los equipos quieren infraestructura compartida en lugar de máquinas GPU individuales.
- Plataformas mixtas en las que notebooks, trabajos de entrenamiento, serving de modelos y servicios de soporte comparten el mismo modelo operativo.
- Equipos que ya ejecutan Kubernetes y pueden ampliar los sistemas existentes de identidad, CI/CD, registro, registro de logs y políticas.
Kubernetes puede ser una mala primera opción cuando el equipo solo necesita acceso ocasional para investigación, trabajos por lotes puntuales de estilo HPC o entrenamiento sencillo controlado mediante SSH. En esos casos, Slurm, un servicio de entrenamiento administrado, un entorno de notebooks alojado o el alquiler directo de GPU pueden generar trabajo útil más rápido.
Antes de crear un clúster de GPU de Kubernetes, defina el límite de la carga de trabajo:
| Pregunta | Por qué es importante |
|---|---|
| ¿La carga de trabajo es de entrenamiento, inferencia por lotes, inferencia en línea, notebooks o mixta? | La respuesta cambia los requisitos de programación, almacenamiento, red y tiempo de actividad. |
| ¿El trabajo necesita una GPU completa, una partición MIG o acceso compartido en el tiempo? | El uso compartido de GPU cambia el aislamiento, la contabilidad y la previsibilidad del rendimiento. |
| ¿La carga de trabajo es de un solo nodo o de varios nodos? | El entrenamiento multinodo requiere pruebas de red y ubicación, no solo disponibilidad de GPU. |
| ¿Qué tamaño tienen los conjuntos de datos, los checkpoints y los pesos del modelo? | El movimiento de datos puede dominar el coste de las GPU. |
| ¿Cuál es el denominador de negocio? | Use ejecución de entrenamiento completada, salida de inferencia aceptada, trabajo de generación de medios o solicitud de cliente, no solo horas de GPU sin procesar. |
Para un diseño de sistema más amplio, vincule este plan de implementación con su revisión de la arquitectura de clúster de GPU: la computación, la red, el almacenamiento y el plano de control deben diseñarse conjuntamente.
Paso 2: diseñar grupos de nodos GPU en torno a los perfiles de las cargas de trabajo
Un clúster de GPU de Kubernetes debe tener grupos de nodos deliberadamente definidos, no una mezcla aleatoria de máquinas aceleradoras.
Para cada grupo de nodos, especifique:
- Modelo de GPU y tamaño de memoria.
- GPU por nodo.
- Detalles de topología PCIe, SXM, NVLink, NVSwitch u otros cuando sean relevantes.
- Modelo de CPU, número de CPU, RAM y distribución NUMA.
- Tamaño y rendimiento de NVMe local.
- Número de NIC, velocidad de NIC y tipo de fabric.
- Imagen del SO, kernel, controlador, CUDA, tiempo de ejecución de contenedores y proceso de aplicación de parches.
- Etiquetas de Kubernetes, taints, tolerations y etiquetas de topología.
- Si las cargas de trabajo usan GPU completas, MIG, time-slicing u otro modo de uso compartido.
Mantenga separadas las necesidades de entrenamiento e inferencia, salvo que exista una razón sólida para combinarlas. El entrenamiento puede priorizar el rendimiento de all-reduce, el ancho de banda de los checkpoints y la programación en grupo. La inferencia en línea puede priorizar más el tiempo de arranque en frío, la localidad de la caché del modelo, la latencia de cola y la seguridad de los despliegues graduales.
Un patrón útil para nombrar grupos de nodos es:
gpu-pool:
  accelerator: h100-80gb
  topology: 8gpu-sxm-nvlink
  fabric: infiniband
  workload: distributed-training
  sharing: full-gpu
Esas etiquetas no son solo documentación. Se convierten en selectores de programación, dimensiones de cuota, etiquetas de costes y contexto de depuración.
Paso 3: exponer las GPU con el mecanismo de Kubernetes adecuado
Kubernetes programa las GPU mediante mecanismos de recursos especializados. La base habitual es un plugin de dispositivo del proveedor que anuncia recursos de GPU al kubelet para que los pods puedan solicitarlos como recursos extendidos. Kubernetes documenta el modelo de solicitud y las restricciones de selección de nodos en su guía de programación de GPU. El plugin de dispositivo de Kubernetes de NVIDIA es la ruta estándar para las GPU de NVIDIA, y el NVIDIA GPU Operator empaqueta varios componentes operativos, incluidos la gestión de controladores y del tiempo de ejecución, el despliegue del plugin de dispositivo, la gestión de MIG y la telemetría de GPU.
Para muchos equipos, la primera ruta de producción es:
node image + kernel prerequisites
  -> NVIDIA driver and container runtime
  -> NVIDIA GPU Operator
  -> Kubernetes device plugin
  -> DCGM exporter metrics
  -> workload namespaces and quotas
Asignación dinámica de recursos de Kubernetes también es importante para los equipos que evalúan un modelo más completo de asignación de dispositivos. DRA está diseñado en torno a reclamaciones de recursos y clases de dispositivos, lo cual puede ser útil cuando las solicitudes simples de recursos extendidos no expresan suficientes requisitos de ubicación o específicos del dispositivo. Trátelo como una elección deliberada de plataforma: el controlador, la versión de Kubernetes, la API de carga de trabajo y la estrategia de observabilidad deben probarse conjuntamente.
La decisión práctica es:
| Necesidad | Mecanismo de Kubernetes que se debe evaluar |
|---|---|
| Programación básica de pods con GPU completa | Plugin de dispositivo y recursos extendidos del tipo nvidia.com/gpu. |
| Gestión del ciclo de vida de las GPU NVIDIA | NVIDIA GPU Operator. |
| Telemetría de GPU | Exportador DCGM más Prometheus/Grafana o su pila de observabilidad. |
| Reclamaciones de dispositivos más expresivas | Asignación dinámica de recursos de Kubernetes. |
| Particionamiento de GPU | MIG cuando sea compatible, con advertencias explícitas sobre aislamiento y rendimiento. |
| Acceso de desarrollo compartido en el tiempo | Segmentación temporal o política de plataforma, solo después de que las reglas de aislamiento y cuotas estén claras. |
No oculte esta capa a los equipos de aplicaciones. Deben saber si un pod recibe un acelerador completo, una partición MIG o un dispositivo compartido en el tiempo, porque cambian los supuestos de rendimiento y depuración.
Paso 4: añada una capa de colas antes de que los equipos compitan por las GPU
El programador predeterminado de Kubernetes no constituye por sí solo una cola de IA multiinquilino completa. Los equipos de IA suelen necesitar admisión de cargas de trabajo, reparto justo, cuotas, políticas de expulsión y visibilidad sobre por qué los trabajos están esperando.
Kueue es el proyecto nativo de Kubernetes que se debe evaluar cuando las colas para lotes e IA/ML son importantes. Sus conceptos básicos incluyen cargas de trabajo, colas locales, colas de clúster, cohortes y variantes de recursos. Esto permite a los equipos de plataforma modelar grupos de GPU escasos y decidir qué trabajos se admiten cuando hay recursos disponibles.
Volcano es otra opción de programación por lotes de Kubernetes para cargas de trabajo de IA, macrodatos y estilo HPC. Su programador de grupos utiliza una condición de mínimo de pods de todo o nada, que resulta útil evaluar para trabajos distribuidos que, de otro modo, desperdiciarían GPU asignadas parcialmente mientras esperan a los pares.
Para una infraestructura de IA de clúster de GPU de Kubernetes, defina la política de colas por escrito:
| Política | Decisión que se debe tomar |
|---|---|
| Admisión | ¿Qué trabajos pueden entrar en la cola y qué metadatos se requieren? |
| Reparto justo | ¿Cómo se dividen las GPU entre equipos, proyectos o entornos? |
| Prioridad | ¿Qué trabajos de inferencia de producción o de entrenamiento críticos para un lanzamiento pueden adelantarse en la cola? |
| Expulsión | ¿Se pueden desalojar trabajos y cómo se exigen puntos de control antes del desalojo? |
| Variantes de recursos | ¿Qué grupos de GPU son intercambiables y cuáles no? |
| Relleno | ¿Pueden ejecutarse trabajos más pequeños mientras espera una ejecución distribuida grande? |
| Visibilidad | ¿Pueden los usuarios ver la posición en la cola y los motivos de denegación sin preguntar a los ingenieros de plataforma? |
La política de colas es un mecanismo de control de costes. Sin ella, el equipo más insistente puede consumir la capacidad más cara mientras los trabajos más pequeños esperan o se trasladan a infraestructura paralela no gestionada.
Paso 5: elija API de cargas de trabajo para entrenamiento e inferencia
Un clúster de GPU de Kubernetes es más útil cuando los equipos de aplicaciones pueden enviar cargas de trabajo sin tener que escribir manualmente especificaciones de pods de bajo nivel cada vez.
Para el entrenamiento, evalúe:
- Jobs nativos de Kubernetes para ejecuciones sencillas de un solo nodo.
- Kubeflow Trainer para flujos de trabajo de entrenamiento distribuido entre distintos frameworks.
- Ray y KubeRay para patrones de Python distribuido, inferencia por lotes y servicio.
- Integración con Volcano o Kueue cuando se necesiten programación de grupos o admisión en cola.
- Operadores personalizados solo cuando la plataforma cuente con patrones internos estables que las herramientas genéricas no cubran.
Para la inferencia, evalúe:
- Deployments o StatefulSets para servicios sencillos.
- Contenedores de servicio vLLM, SGLang, Triton o TensorRT-LLM según el modelo y los objetivos de rendimiento.
- KServe u otra capa de servicio de modelos cuando los equipos necesiten abstracciones del ciclo de vida de los modelos.
- Reglas de escalado horizontal y vertical basadas en la profundidad de la cola, la latencia, la memoria de GPU y la combinación de solicitudes.
- Grupos de nodos separados para tráfico de producción sensible a la latencia y cargas de trabajo por lotes.
Mantenga la API de carga de trabajo simple al principio. Una plantilla de Job limpia con etiquetas, solicitudes de recursos, montajes de almacenamiento y exportación de registros es mejor que una plataforma compleja que nadie pueda depurar.
Paso 6: valide la ruta de red y almacenamiento
La diferencia entre una demostración funcional y una infraestructura de IA de clúster de GPU de Kubernetes de producción suele aparecer en las pruebas de red y almacenamiento.
Para el entrenamiento distribuido, valide:
- Ubicación entre nodos.
- Comportamiento de reducción total de NCCL en todos los nodos previstos.
- Errores de la estructura, retransmisiones, congestión y variación entre nodos.
- Versiones de controlador, CUDA, NCCL e imagen de contenedor.
- Rendimiento después de instalar la imagen de contenedor de producción, no solo con una imagen de referencia limpia.
Para el almacenamiento, valide:
- Tiempo de preparación del conjunto de datos.
- Descarga de los pesos del modelo y calentamiento de la caché.
- Frecuencia y duración de la escritura de puntos de control.
- Tiempo de restauración después de un fallo de nodo o pod.
- Comportamiento del sistema de archivos compartido con trabajos simultáneos.
- Región del almacenamiento de objetos, salida de datos y reglas de ciclo de vida.
Una prueba de aceptación mínima tiene este aspecto:
1. Submit a queued training job with the production container.
2. Pull the real dataset sample and base model weights.
3. Run a multi-node communication benchmark if the workload is distributed.
4. Train or fine-tune for a fixed window.
5. Write a checkpoint, delete a pod, and restore from checkpoint.
6. Export GPU, network, storage, queue, and cost labels.
7. Compare useful work against the model/API or GPU rental baseline.
Esta prueba debe ejecutarse antes de realizar reservas prolongadas o compromisos de alto coste. Es más barato descubrir una red deficiente o una ruta lenta para puntos de control durante una prueba comparativa que durante una ventana de lanzamiento.
Herramientas de gestión de clústeres de GPU de Kubernetes
La expresión herramientas de gestión de clústeres de GPU de Kubernetes abarca varios trabajos distintos. No compre ni instale herramientas antes de definir el trabajo que realizan.
| Necesidad de gestión | Herramientas o proyectos que evaluar | Cómo se ve un buen resultado |
|---|---|---|
| Ciclo de vida de GPU | NVIDIA GPU Operator, device plugin, automatización de imágenes de nodo | Los controladores, el tiempo de ejecución, la exposición de dispositivos y la telemetría son reproducibles en todos los nodos. |
| Encolado | Kueue, Volcano, patrones de envío de trabajos de Ray | Los usuarios ven claramente los estados admitido, pendiente, en ejecución, fallido y completado. |
| Flujos de trabajo de entrenamiento | Kubeflow Training Operator, Ray, Jobs nativos | Los trabajos distribuidos son reproducibles y no requieren YAML de pod a medida cada vez. |
| Servicio de inferencia | vLLM, SGLang, Triton, KServe, Deployments | Las implementaciones, las comprobaciones de estado, la latencia y el comportamiento de la caché de modelos son visibles. |
| Observabilidad | Exportador de DCGM, Prometheus, Grafana, registros, trazas, eventos de Kubernetes | Las métricas de GPU se vinculan con etiquetas de trabajo, equipo, modelo y coste. |
| Políticas | RBAC, ResourceQuota, LimitRange, controles de admisión, política de imágenes, política de red | El acceso multiinquilino está restringido sin bloquear el desarrollo normal. |
| Asignación de costes | Etiquetas de espacio de nombres, etiquetas de carga de trabajo, exportación de uso, panel de facturación | Finanzas puede asignar el gasto al equipo, entorno, modelo y resultado aceptado. |
Evite una plataforma que solo informe de horas de GPU asignadas. Una gestión útil muestra por qué las GPU estaban inactivas, qué trabajos fallidos consumieron capacidad y si los resultados de inferencia o los hitos de entrenamiento justificaron el gasto.
Preguntas sobre el clúster de GPU de Kubernetes de CoreWeave
Algunos equipos buscan un coreweave kubernetes gpu cluster porque quieren acceso nativo de Kubernetes a la capacidad de GPU en la nube en lugar de máquinas virtuales genéricas. Considere esa consulta modificada por el proveedor como una pauta de diligencia debida: para CoreWeave o cualquier proveedor de nube de GPU similar, verifique el modelo exacto de acceso a Kubernetes, los controles del grupo de nodos, la compatibilidad con operadores, las exportaciones de cuotas y el límite de soporte antes de comprometer cargas de trabajo de producción.
Aplique la misma diligencia debida a cualquier proveedor:
| Pregunta | Por qué importa |
|---|---|
| ¿Qué SKU de GPU y configuraciones de nodo están realmente disponibles en la región solicitada? | El inventario de marketing y la capacidad asignable no son lo mismo. |
| ¿Los nodos son homogéneos dentro de la reserva o el grupo? | Los nodos mixtos pueden romper las suposiciones de rendimiento. |
| ¿Qué red se utiliza entre los nodos de GPU? | El entrenamiento multinodo depende de la ubicación y del comportamiento de la red. |
| ¿Quién gestiona las actualizaciones de controladores, CUDA y Kubernetes? | Los límites de actualización afectan al tiempo de inactividad y la reproducibilidad. |
| ¿Puede ejecutar GPU Operator, Kueue, Volcano, Ray o los operadores que necesita? | Kubernetes gestionado sigue necesitando compatibilidad de plataforma. |
| ¿Cómo se exponen las cuotas, las exportaciones de uso y las etiquetas? | Los equipos de finanzas y plataforma necesitan atribución de costes. |
| ¿Cuál es la vía de soporte durante ejecuciones distribuidas fallidas? | Necesita registros, identidad del nodo y escalamiento antes de producción. |
| ¿Cuál es la vía de salida para los datos, los pesos del modelo y los puntos de control? | El coste de migración forma parte de la decisión de arquitectura. |
El Kubernetes del proveedor no elimina la necesidad de pruebas de aceptación. Cambia qué capas opera directamente y qué capas verifica mediante evidencia de nivel de servicio.
Lista de verificación de seguridad y multiinquilinato
Los clústeres de GPU suelen convertirse rápidamente en infraestructura compartida. La seguridad debe diseñarse antes de que el segundo equipo empiece a usar el clúster.
Controles mínimos:
- Un espacio de nombres por equipo, entorno o límite de carga de trabajo.
- RBAC vinculado a tu proveedor de identidad.
- ResourceQuota y LimitRange para GPU, CPU, memoria y almacenamiento.
- Política explícita para pods privilegiados, montajes del host, redes del host y acceso a dispositivos.
- Gestión y rotación de secretos.
- Política de registro privado de imágenes, firma, análisis o comprobaciones de admisión.
- Política de red para salida, acceso a conjuntos de datos y límites de servicios.
- Registros de auditoría para envío de trabajos, acceso a secretos, uso de imágenes y acciones administrativas.
- Reglas de limpieza de datos para NVMe local, volúmenes temporales, puntos de control, registros y trabajos fallidos.
Si el clúster maneja datos de clientes o pesos de modelos propietarios, trata los nodos de trabajo como infraestructura sensible. Un pod con acceso a GPU también puede tener acceso a datos de alto valor, artefactos de modelos y credenciales.
Observabilidad y modelo de costes
Un kubernetes gpu cluster de producción necesita tres perspectivas al mismo tiempo:
- Perspectiva de plataforma: estado de los nodos, estado de las GPU, red, almacenamiento, estado de las colas y eventos de Kubernetes.
- Perspectiva de carga de trabajo: propietario del trabajo, imagen, modelo, conjunto de datos, tiempo de ejecución, número de reintentos, motivo de salida y calidad de salida.
- Perspectiva financiera: tiempo de GPU asignado, tiempo útil de GPU, tiempo inactivo, coste de trabajos fallidos y coste por unidad aceptada.
Supervisa al menos:
- Utilización de GPU, memoria de GPU, energía, temperatura y eventos de error.
- Etiquetas de pod, trabajo, espacio de nombres, grupo de nodos, modelo y equipo.
- Tiempo de espera en cola y motivo de admisión.
- Rendimiento del entrenamiento, duración del punto de control y tiempo de restauración.
- Latencia de inferencia, rendimiento, tamaño de lote, tasa de aciertos de caché y tasa de errores.
- Rendimiento del almacenamiento y tiempo de transferencia al almacén de objetos.
- Fallos de nodos, expulsiones, apropiaciones y reintentos.
A continuación, normaliza el coste:
effective_kubernetes_gpu_cluster_cost =
  (compute + network + storage + support + idle + failed_runs + operations)
  / accepted_workload_units
El denominador debe ajustarse al negocio: ejecuciones de entrenamiento completadas, salidas de modelos aceptadas, trabajos de generación de medios, lotes de indexación o solicitudes de clientes. Para un marco de costes más profundo, utiliza la hoja de trabajo de TCO del clúster de GPU y compara con nube de GPU frente a API de modelos antes de ampliar el clúster.
Lista de verificación de implementación
Utiliza esto como orden de creación para la primera fase de producción:
| Fase | Entregable | Condición de aprobación |
|---|---|---|
| Resumen de la carga de trabajo | Especificación de carga de trabajo de una página | El equipo acuerda el modelo, el framework, los datos, la escala, el SLA y el denominador de coste. |
| Grupo de nodos | Especificación y etiquetas de nodos GPU | La configuración del nodo, la topología, el controlador, el tiempo de ejecución y la política de actualización están documentados. |
| Exposición de GPU | Plugin de dispositivos u GPU Operator instalado | Los pods pueden solicitar GPU y las métricas de DCGM son visibles. |
| Colas | Kueue, Volcano o política de programación documentada | Los usuarios pueden enviar trabajos y ver el estado de cola/admisión. |
| Almacenamiento | Rutas de conjuntos de datos, caché de modelos, puntos de control y registros | La prueba de restauración se supera después de un fallo forzado de pod o nodo. |
| Red | Prueba de la estructura de red y prueba de tráfico de producción | La prueba comparativa distribuida o la ruta de inferencia cumple el umbral de la carga de trabajo. |
| Seguridad | RBAC, espacios de nombres, cuotas, secretos, política de imágenes | Un equipo nuevo puede incorporarse sin acceso de administrador del clúster. |
| Observabilidad | Paneles y exportación de uso | Los operadores pueden responder quién usó qué GPU y por qué fallaron los trabajos. |
| Aceptación | Ejecución de carga de trabajo de extremo a extremo | La salida útil supera o justifica la referencia de modelo/API o alquiler. |
No escales de 8 GPU a 80 GPU hasta que esta lista de verificación sea rutinaria. Ese es el objetivo: envío de trabajos repetible, asignación predecible, recuperación ante fallos conocida, coste visible y propiedad clara.
Errores comunes
- Comprar capacidad de GPU antes de demostrar el movimiento de datos y la recuperación de puntos de control.
- Tratar el plugin de dispositivos como si fuera toda la plataforma.
- Mezclar el entrenamiento y la inferencia de producción en el mismo grupo de nodos sin reglas de prioridad y aislamiento.
- Permitir que cada equipo escriba especificaciones de pod únicas sin etiquetas comunes.
- Hacer seguimiento del tiempo de GPU asignado, pero no del trabajo útil.
- Omitir la política de colas hasta que el clúster ya esté sobrecargado.
- Suponer que Kubernetes gestionado equivale a infraestructura de IA gestionada.
- Ejecutar pruebas comparativas con una imagen limpia y producción con una imagen diferente.
- Olvidar una ruta de salida para conjuntos de datos, pesos, puntos de control y registros.
Estos errores son caros porque consumen un tiempo de GPU escaso sin producir trabajo aceptado.
Preguntas frecuentes
¿Qué es un clúster de GPU de Kubernetes?
Un clúster de GPU de Kubernetes es un clúster de Kubernetes con nodos de trabajo capaces de usar GPU, exposición de dispositivos, política de programación, almacenamiento, redes y observabilidad configurados para que los pods y los trabajos puedan utilizar aceleradores para entrenamiento, inferencia, procesamiento por lotes o cargas de trabajo de investigación.
¿Necesito NVIDIA GPU Operator?
No siempre, pero muchas plataformas de GPU de Kubernetes basadas en NVIDIA lo evalúan porque agrupa los componentes de controlador, tiempo de ejecución, plugin de dispositivos, MIG y telemetría en un flujo de trabajo gestionado por un operador. Algunos proveedores gestionados se encargan de partes de esta pila por ti, así que confirma el límite de responsabilidades antes de instalarlo por tu cuenta.
¿Es necesario Kueue para un clúster de GPU de Kubernetes?
Kueue no es necesario para todos los clústeres, pero vale la pena evaluarlo cuando la capacidad de GPU escasa se comparte entre equipos o trabajos de IA por lotes. Sin una capa de colas, los usuarios suelen tener poca visibilidad sobre por qué los trabajos esperan o por qué se deniegan las cuotas.
¿Puede Kubernetes ejecutar entrenamiento multinodo?
Sí, pero el entrenamiento multinodo requiere más que la programación de GPU. Necesita ubicación, validación de red de alta velocidad, contenedores compatibles, creación de puntos de control y, a menudo, comportamiento de colas o programación por grupos. Pruebe el grupo de nodos exacto y la imagen de producción antes de comprometer una gran capacidad.
¿Deberían la inferencia y el entrenamiento compartir el mismo clúster de GPU?
Pueden hacerlo, pero solo con grupos de nodos, reglas de prioridad, cuotas y aislamiento claros. La inferencia de producción suele tener requisitos de latencia y disponibilidad que entran en conflicto con los grandes trabajos de entrenamiento. Comience por separado, a menos que pueda demostrar que la política compartida funciona bajo carga.
¿Cuándo debería usar una API de modelo en lugar de un clúster de GPU de Kubernetes?
Use primero una API de modelo cuando solo necesite resultados del modelo, su combinación de modelos cambie con frecuencia, la utilización sea baja o su equipo no esté preparado para operar controladores de GPU, colas, almacenamiento, supervisión e incidentes. Cree un clúster cuando el control, la privacidad, los pesos personalizados o la economía de las cargas de trabajo justifiquen la carga operativa.
Referencias oficiales
- Kubernetes: Programar GPU
- Kubernetes: Complementos de dispositivos
- Kubernetes: Asignación dinámica de recursos
- Kubernetes: Asignación de Pods a nodos
- NVIDIA GPU Operator
- NVIDIA: Instalar GPU Operator
- NVIDIA: Instalar DCGM Exporter
- Conceptos de Kueue
- Programación por grupos de Volcano
- Descripción general de Kubeflow Trainer
Conclusión final
Vale la pena crear un clúster de GPU de Kubernetes cuando Kubernetes proporciona a su infraestructura de IA un mejor control sobre la ubicación, la repetibilidad, la seguridad, la observabilidad y el coste que máquinas de GPU ad hoc o API administradas. Comience con una carga de trabajo acotada, pruebe el grupo de nodos, exponga las GPU correctamente, añada colas antes de que comience la contención y mida la producción útil en lugar de la asignación bruta de GPU.
Cuando el clúster no pueda superar una opción más sencilla de alquiler de GPU o de modelo/API en trabajo aceptado, no lo amplíe. Cuando pueda hacerlo, Kubernetes se convierte en el plano de control que transforma aceleradores escasos en una plataforma de IA compartida.