
Blog de flatkey.ai
Ideas, notas de producto y guías de implementación para equipos que crean sobre APIs de IA.
Arquitectura de pasarelas de IA
Últimos artículos en Arquitectura de pasarelas de IA.
Leer másMigración de URL base y SDK
Últimos artículos en Migración de URL base y SDK.
Leer másCostes, facturación y operaciones
Últimos artículos en Costes, facturación y operaciones.
Leer másControles empresariales y confianza
Últimos artículos en Controles empresariales y confianza.
Leer másComparativas de pasarelas
Últimos artículos en Comparativas de pasarelas.
Leer másGuías de modelos y modalidades
Últimos artículos en Guías de modelos y modalidades.
Leer másFiabilidad y enrutamiento
Últimos artículos en Fiabilidad y enrutamiento.
Leer másIntegraciones de herramientas
Últimos artículos en Integraciones de herramientas.
Leer más
Notas internas de la consola
Notas internas
API proxy CLI: acceso, precios, integración y guía de producción
Descubre qué hace una API proxy CLI, cómo funcionan el acceso y los costes de CLIProxyAPI, cómo probarla de forma segura y cuándo una puerta de enlace gestionada es adecuada para producción.

API de generación de video con IA: acceso, precios, integración y guía de producción
Guía práctica para elegir, calcular precios, integrar y operar una API de generación de video con IA mediante trabajos asíncronos y controles de costos medibles.

Significado de la inferencia de IA: guía de arquitectura, rendimiento y despliegue en la nube
Qué significa la inferencia de IA: cómo un modelo entrenado convierte nuevas entradas en respuestas de producción, con las métricas y los pasos de despliegue de GPU en la nube que importan.

Auditoría de seguridad de IA: plan práctico de pruebas, lista de evidencias y plantilla de informe para aplicaciones con LLM
Una auditoría de seguridad de IA comprueba qué hace realmente tu aplicación con LLM, más allá de lo que afirma el proveedor. Esta guía incluye una plantilla de alcance, 12 pruebas vinculadas a OWASP con entradas, controles esperados, evidencias y medidas correctivas, un entorno de pruebas seguro, criterios de gravedad y una plantilla de informe.
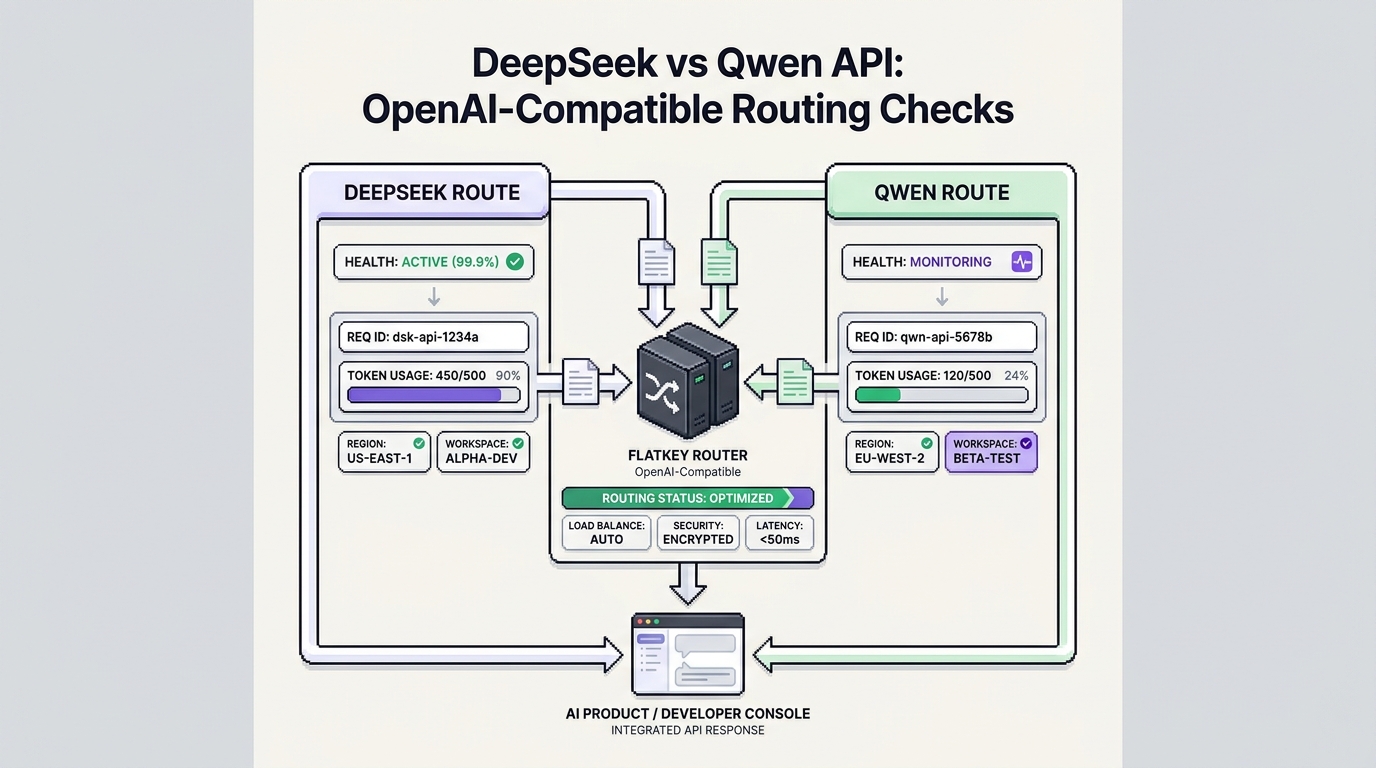
Grok vs Gemini (octubre de 2026): ¿qué IA deberías usar?
Elige Gemini si quieres el plan con mejor relación calidad-precio, integración con Google, herramientas de vídeo y una API con contexto de 1M de tokens; elige Grok si vives en X, quieres publicaciones de X en tiempo real o ya pagarías X Premium. Comparamos planes, tareas y API con precios a 25 de octubre de 2026.

¿Se puede ejecutar Kimi K3 en local? Guía de hardware, GGUF y vLLM (2026)
Kimi K3 puede ejecutarse en local, pero el GGUF de 1 bit más pequeño necesita unos 610 GB de RAM más VRAM. Requisitos exactos de hardware, comandos de llama.cpp y vLLM, condiciones de licencia y comparación de costes con GPU alquiladas y APIs.

Primeros pasos con la API de Flatkey esta semana
Notas de incorporación de Northline Analytics
Errores comunes de LiteLLM: tiempos de espera, alertas de presupuesto y fallos de proveedores
Guía práctica para solucionar problemas de LiteLLM: tiempos de espera, controles y alertas de presupuesto, configuración de modelos, fallos de proveedores, reintentos y alternativas.
Descarga y jerarquización de caché KV para servir LLM con contexto largo
Guía sobre descarga y jerarquización de caché KV para servir LLM con contexto largo mediante vLLM y TensorRT-LLM.
Crea un clúster de GPU de Kubernetes para entrenamiento e inferencia de IA
Guía práctica para crear un clúster de GPU de Kubernetes destinado al entrenamiento y la inferencia de IA, con pools de nodos GPU, plugins de dispositivos, GPU Operator, colas, almacenamiento, observabilidad, seguridad, controles de costos y evaluación de proveedores.
Kimi K3 vs GPT 5.6 Sol: precios, contexto y qué API probar
Una comparación verificada con fuentes de Kimi K3, GPT-5.6 Sol y GPT-5.6 Terra para desarrolladores que eligen una API para producción.
Precio de la GPU H200: precios, factores de coste y guía de compra
Compare los costes de la tarjeta H200 NVL, servidores y alquiler en la nube, así como los factores de TCO clave antes de comprar o reservar capacidad.

GPU H200: arquitectura, rendimiento y guía de implementación en la nube
Guía práctica de H200 para elegir un factor de forma, dimensionar la memoria y la red, implementar en infraestructura en la nube y validar la latencia, el rendimiento, el estado y el coste por trabajo completado.
Precio de la GPU H100: precios, factores de coste y guía de compra
Guía de precios de la GPU H100 para comparar una oferta PCIe de 32.200 $, referencias de alquiler en la nube, formatos y el TCO tras una cotización on-premise.

Servidor GPU: guía de arquitectura, rendimiento y despliegue en la nube
Elige y despliega un servidor GPU en la nube con un enfoque centrado en la carga de trabajo para arquitectura, pruebas de rendimiento y preparación para producción.
Genspark AI Agent Builder API Custom: acceso, precios, integración y guía de producción
Guía práctica sobre el acceso a Genspark Custom Agent, precios, conectores y la arquitectura de producción adecuada cuando tu app necesita una API documentada.
API LLM gratuita: límites, costes y concesiones en producción
Una guía práctica sobre niveles gratuitos de API LLM, créditos, límites de velocidad, costes operativos ocultos y los controles de producción que debes añadir antes de que los usuarios dependan de una ruta.
Crea más rápido con una sola pasarela de IA.
Usa flatkey.ai para gestionar modelos, claves, facturación y observabilidad desde una plataforma API.
Empezar