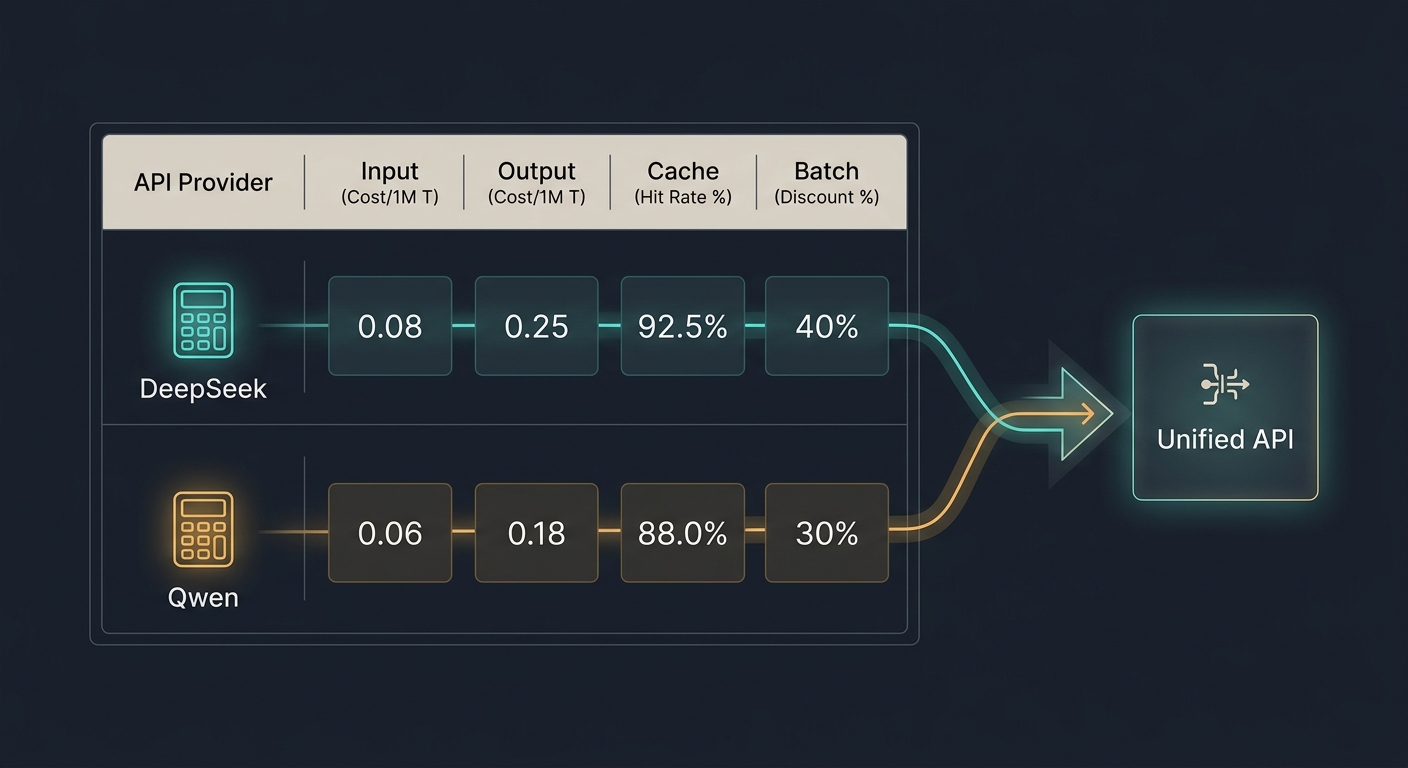
予算に敏感な製品で DeepSeek API と Qwen API のどちらを選ぶかを考えるなら、まず単一の見出しトークン価格から始めないでください。まずはワークロードの形から見ましょう。
有用な DeepSeek API vs Qwen API for Cost-Sensitive Workflows: 2026 Cost Guide は、少なくとも6つの要素を比較する必要があります。入力トークン、出力トークン、キャッシュヒット、キャッシュミス、バッチ適格性、そして後からルートを変更する際の運用コストです。
このガイドは、2026年9月23日時点のファーストパーティ提供元ドキュメントを確認したうえで作成されています。トロフィー向けベンチマークではなく、承認されたタスク1件あたりの信頼できる最小コストを必要とする個人開発者や小規模AIプロダクトチーム向けに書かれています。
要点は次のとおりです。
- 単純で大量のチャット、非同期バッチジョブ、または Qwen のバッチ推論や暗黙的/明示的なキャッシュルールを使えるワークフローでは、まず Qwen を選びます。
- グローバルにシンプルな OpenAI 形式のエンドポイント、明示的なピーク/オフピークのトークン行、キャッシュヒット/ミスの自動計上、あるいは DeepSeek Flash の品質で既に製品要件を満たせる場合は、まず DeepSeek を選びます。
- 想定されるトークン削減が小さく、プロバイダ設定、再試行挙動、分断された残高、または移行作業によって割引分が相殺される可能性がある場合は、ルーターと使用台帳を使います。
コスト重視ワークフロー向け DeepSeek API vs Qwen API:判断表
| ワークフローのパターン | 現在のコスト संकेत | 最初に試すモデルファミリー | 判断が変わりうる要因 |
|---|---|---|---|
| 短い非キャッシュ会話 | Qwen Flash 系の行は、一覧価格ベースの計算で低くなる場合がある | Qwen | 出力長、リージョン、正確な Qwen スナップショット、品質合格率 |
| 非同期評価またはラベリング | Qwen のバッチ推論では、成功したリクエストがリアルタイム推論の50%で課金される | Qwen | バッチ適格性、ターンアラウンド時間の許容度、バッチでは未対応のキャッシュ割引 |
| 長いコンテキストの繰り返し | 両プロバイダにキャッシュ機構がある。DeepSeek はヒット/ミス行を直接公開し、Qwen には明示的および暗黙的なキャッシュモードがある | 両方をテスト | 実際のキャッシュヒット率、キャッシュ作成オーバーヘッド、プロバイダ固有のキャッシュフィールド |
| 推論重視の出力 | Qwen Plus、Qwen Max、DeepSeek Flash、DeepSeek Pro のどれが品質基準を満たすかで勝者が決まる | デフォルトの勝者なし | thinking トークン、再試行、回答長、受理率 |
| シンプルな直接セットアップ | DeepSeek は1つの OpenAI 形式ベースURLを公開している。Qwen のセットアップはリージョン/ワークスペース固有 | DeepSeek | データリージョン要件、調達、既存の Alibaba Cloud 利用状況 |
| 頻繁なモデル切り替え | トークン削減は、統合と課金のオーバーヘッドで失われる可能性がある | 共有ルーティングレイヤー | モデルの利用可否、ロールバック計画、統合ログ |
この表は品質ランキングではありません。コストのトリアージツールです。正しい比較は 承認されたタスク1件あたりのコスト であり、100万入力トークンあたりのコストではありません。
2026年7月の価格ウォッチ以降に変わった点
このURLに対する前回の Flatkey 価格ウォッチでは、DeepSeek V4 Flash と V4 Pro を基準にし、Qwen Flash を恒常的な低コストの Qwen 行として扱っていました。現在の提供元ページでは、比較はより нюアンスのあるものになっています。
DeepSeek は現在、API ユーザーにモデル名として deepseek-flash を使うよう案内しています。ドキュメントによると、deepseek-v4-flash のような旧名称も引き続き受け付けられますが、リクエストは DeepSeek-V4.1-Flash によって処理され、Flash 料金で課金されます。DeepSeek はピーク時とオフピーク時の価格も公開しているため、週末やピーク UTC 時間帯外に稼働するワークフローは、ピーク時間帯に稼働するワークフローとは異なるコスト特性になる場合があります。
Alibaba Cloud Model Studio では現在、モデルバージョンやデプロイ地域をまたいで複数の Qwen Flash ファミリーの行が公開されており、qwen3.8-flash、qwen3.7-flash、qwen-flash などが含まれます。同じページでは地域ごとの価格とデプロイ対象範囲も分けて表示されているため、承認判断に必要なのは単一の Qwen 価格だけではありません。正確なモデル ID と地域が重要です。
2026 年のコストガイドとしては、まず次の点が重要です。プロバイダーを比較する前に、正確なモデル ID、地域、キャッシュルール、実行モードで正規化すること。
現在の一次情報ベースの価格スナップショット
以下の価格はすべて、2026 年 9 月 23 日時点で一次情報のドキュメントに記載されていた、100 万トークンあたりの公表リスト価格です。契約価格として扱わないでください。トラフィックを移す前に、プロバイダーページと自分のアカウントを確認してください。
DeepSeek API の価格行
DeepSeek の価格ページには、deepseek-flash と deepseek-v4-pro が掲載されており、どちらもコンテキスト長は 1M、最大出力は 384K です。
| Model | Cache-hit input, off-peak | Cache-miss input, off-peak | Output, off-peak | Cache-hit input, peak | Cache-miss input, peak | Output, peak |
|---|---|---|---|---|---|---|
deepseek-flash | $0.003 | $0.15 | $0.60 | $0.006 | $0.30 | $1.20 |
deepseek-v4-pro | $0.022 | $0.66 | $1.98 | $0.044 | $1.32 | $3.96 |
DeepSeek はさらに以下も公開しています。
- OpenAI 形式のベース URL:
https://api.deepseek.com - Anthropic 形式のベース URL:
https://api.deepseek.com/anthropic - 自動コンテキストキャッシング
- usage における
prompt_cache_hit_tokensとprompt_cache_miss_tokens - 月曜から金曜の 01:00-04:00 および 06:00-10:00 UTC、ただし中国の祝日を除くピーク時間
実務上の利点は明確さです。どの入力トークンが割引対象だったのかを推測することなく、cache-hit input、cache-miss input、output をそれぞれ個別に計算できます。
Qwen API の価格行
Alibaba Cloud Model Studio の価格ページには、多数の Qwen の行が掲載されています。コストに敏感なテキストワークフローで特に重要な Flash ファミリーの行には、以下が含まれます:
| モデル行 | 価格例のシグナル | 重要な理由 |
|---|---|---|
qwen3.8-flash | 1つの表示上の国際行では $0.15 の入力と $0.47 の出力が含まれる。ほかの地域では異なる数値が表示される | より新しい Flash ファミリー。地域と正確なルートを確認すること |
qwen3.7-flash | 1つの表示上の国際行では $0.030 の入力と $0.130 の出力が含まれる。ほかの地域では異なる数値が表示される | 品質が十分なら、しばしば非常に低い価格候補になる |
qwen-flash | 1つの表示上の国際行では $0.05 の入力と $0.40 の出力が含まれる。ほかの地域では異なる場合がある | シンプルで低コストなタスク向けの堅実なベースライン行 |
qwen-plus | 1つの表示行では $0.40 の入力と $1.20 の出力が含まれる | Flash の品質が十分でない場合に有用 |
qwen3.7-plus | 1つの表示行では $0.40 の入力と $1.60 の出力が含まれる | より難しい推論や生成タスクに有用 |
qwen3.8-max / qwen3.7-max | 入力・出力価格がかなり高い行が含まれる | Plus/Flash が品質要件を満たさない場合にのみ試す |
Qwen は以下も公開しています:
- OpenAI 互換のチャットインターフェース
- リージョン/ワークスペース固有のベースURL
- エンドポイントのリージョンと一致している必要がある API キー
- 対応モデル向けのバッチ推論。成功したリクエストはリアルタイム推論価格の 50% で利用可能
- 明示的および暗黙的なコンテキストキャッシュモード。usage にはキャッシュヒットのトークン項目が含まれる
実務上の利点は、割引の適用余地が広いことです。ワークロードを非同期で実行できる場合、または Qwen のキャッシュを安定してヒットできる場合、Qwen の実効価格は単純なリアルタイム行より大幅に低くなる可能性があります。
3 つのワークロード計算
これらの例は請求形状のみを比較しています。同等の品質、レイテンシ、信頼性、または安全性の挙動を主張するものではありません。
シナリオ 1: 短い未キャッシュのチャット
前提:
- 10,000 リクエスト
- 1 リクエストあたり 1,000 入力トークン
- 1 リクエストあたり 500 出力トークン
- キャッシュヒットなし
- バッチモードなし
| ルート | 計算 | 推定リスト価格のトークンコスト |
|---|---|---|
qwen-flash の例行 | 1,000万入力を $0.05 で + 500万出力を $0.40 で | $2.50 |
qwen3.8-flash の例行 | 1,000万入力を $0.15 で + 500万出力を $0.47 で | $3.85 |
deepseek-flash、オフピーク | 1,000万のキャッシュミス入力を $0.15 で + 500万出力を $0.60 で | $4.50 |
deepseek-flash、ピーク | 1,000万のキャッシュミス入力を $0.30 で + 500万出力を $1.20 で | $9.00 |
短い未キャッシュのチャットでは、Qwen が最初のコスト候補です。DeepSeek は、品質合格率が高い、再試行が少なくて済む、または生のトークン差より運用のシンプルさが重要な場合には、依然として有利になり得ます。
シナリオ 2: 繰り返しの長いコンテキスト
前提:
- 10,000 件のリクエスト
- リクエストごとに 10,000 の入力トークン
- リクエストごとに 1,000 の出力トークン
- ウォームアップ後、入力トークンの 90% がキャッシュにヒット
- バッチモードなし
| ルート | キャッシュの前提 | 推定リスト価格のトークンコスト |
|---|---|---|
deepseek-flash、オフピーク | ヒット入力 90M を $0.003、ミス入力 10M を $0.15、出力 10M を $0.60 | $7.77 |
deepseek-flash、ピーク | ヒット入力 90M を $0.006、ミス入力 10M を $0.30、出力 10M を $1.20 | $15.54 |
qwen-flash の例、20% の暗黙キャッシュ入力あり | キャッシュ済み入力 90M を $0.01、通常入力 10M を $0.05、出力 10M を $0.40 | $5.40 |
ここで従来の経験則は通用しなくなることがあります。DeepSeek はキャッシュヒットとキャッシュミスの行を非常に明確に示していますが、Qwen の現在のキャッシュドキュメントでは、多くの暗黙キャッシュ対応モデルがキャッシュ済み入力を通常入力の一定割合で課金するとされている一方で、モデル固有の例外もあると記載されています。ワークロードがキャッシュ節約に依存するなら、スプレッドシートだけでどちらのプロバイダーも承認しないでください。API レスポンスから実際のキャッシュヒットトークンを記録してください。
シナリオ 3: バッチ可能な評価
シナリオ 1 と同じ短いチャット形式を想定しますが、ジョブは非同期のバッチ処理を待て、対応している Qwen のバッチモデルを使用します。
| ルート | 計算 | 推定リスト価格のトークンコスト |
|---|---|---|
qwen-flash のリアルタイム例 | シナリオ 1 と同じ | $2.50 |
qwen-flash のバッチ対象 | 成功したリアルタイムリクエストのトークンコストの 50% | $1.25 |
deepseek-flash、オフピークのリアルタイム | シナリオ 1 と同じ | $4.50 |
評価セット、夜間のデータラベリング、オフラインのエンリッチメント、回帰テストでは、通常まず確認すべきコスト経路は Qwen のバッチ推論です。トレードオフはレイテンシと運用方法です。バッチジョブには JSONL 入力、ファイルごとに 1 つのモデル、ポーリング、結果ファイルの処理、承認チェックが必要です。
インディーハッカーが使うべき計算式
モデルを切り替える前に、次を使ってください:
accepted task cost =
  cache_miss_input_tokens * cache_miss_input_rate
  + cache_hit_input_tokens * cache_hit_input_rate
  + output_tokens * output_rate
  - verified_batch_discount
  + retry_tokens
  + fallback_tokens
  + migration_operating_cost
----------------------------------------------------
  accepted_tasks
次に、候補となる各ルートについて、以下の項目を追跡します:
| 項目 | 重要な理由 |
|---|---|
| 正確なモデルID | 可変エイリアスと日付付きスナップショットでは挙動が異なる場合がある |
| リージョンとエンドポイント | Qwen API キーはリージョンに紐づくため、エンドポイントの不一致が認証失敗を招くことがある |
| 実行モード | リアルタイム、バッチ、キャッシュ、ルーターのフォールバックでは課金前提が異なる |
| 入力トークン | 長いプロンプトではキャッシュとプロンプトの切り詰めが重要になる |
| 出力トークン | 出力は生成および推論コストの大半を占めることが多い |
| キャッシュヒットトークン | キャッシュの前提は、ログで確認できるまでは節約にはならない |
| リトライ回数 | 安価なモデルでもリトライが多ければ、かえって高くつくことがある |
| 受け入れタスク率 | 品質失敗は隠れコストである |
| 実行時刻 | DeepSeek のピーク/オフピーク料金は同じジョブのコストを変える可能性がある |
| 移行作業 | SDK、エンドポイント、リージョン、ログ、ロールバックの作業には実際のコストがある |
コストに影響する API セットアップの違い
DeepSeek のセットアップは運用上シンプルです。OpenAI 互換の呼び出しでは、ベース URL は https://api.deepseek.com で、現在のモデル名には deepseek-flash や deepseek-v4-pro などがあります。多くの小規模チームにとって、このシンプルさは重要です。なぜなら、セットアップ時間もコストだからです。
Qwen のセットアップには、より多くの選択肢があります。Model Studio は OpenAI 互換の呼び出しをサポートしていますが、ベース URL はリージョンやワークスペースによって異なります。ドキュメントでは、API キーは作成されたリージョンに紐づけられ、あるリージョンのキーは別のリージョンのエンドポイントでは失敗する可能性があると説明しています。これは致命的な問題ではありませんが、コスト比較には含めるべきです。
小規模なプロダクトを運用している場合、隠れた作業はしばしば次のようになります:
- リージョン対応の Qwen ベース URL を追加する。
- 正しいリージョンで API キーを作成する。
- そのリージョンで正確な Qwen のモデル ID をテストする。
- そのモデルでバッチ推論がサポートされているか確認する。
- 明示的または暗黙的なキャッシュが適用されるか確認する。
- 使用状況フィールドがキャッシュ済みトークンを報告するか確認する。
- ルートが品質またはレイテンシの基準を満たさない場合に備えて、ロールバックルーティングを追加する。
そのため、コスト重視のチームであっても、1 つのキーで使えるルーターは有用です。Flatkey は、チームに 1 つの OpenAI 互換エントリポイント、1 つの残高、1 つの請求書、モデル探索、プロバイダー横断の使用状況確認を提供します。本番前にはモデルの利用可否と価格を確認する必要がありますが、課金とリクエストの証跡が 1 か所に集まるため、運用面の比較はより明確になります。
DeepSeek がより良いコスト選択となる場合
DeepSeek が最初のテストとしてより適しているのは、次のような場合です:
- シンプルな単一のプロバイダーエンドポイントを使いたい。
- ワークロードをオフピーク時間帯に実行できる。
- プロンプトに繰り返しのプレフィックスがあり、DeepSeek のキャッシュヒットトークンが安定して表示される。
deepseek-flashの品質でタスクに十分対応できる。- 同じ料金表内で、キャッシュヒット、キャッシュミス、出力の価格行が明確に示されている必要がある。
- チームがリージョン/ワークスペースのキー管理を避けたい。
重要な注意点は出力コストです。DeepSeek Flash は入力キャッシュヒットが多いと非常に魅力的ですが、長い回答では依然として出力料金が発生します。モデルが冗長な回答を生成したり、再試行が必要になったりすると、定価ベースの節約は消えてしまう可能性があります。
Qwen がより良いコスト選択となる場合
Qwen は、次の条件では最初に試す候補としてより適しています。
- 必要なリージョンで低コストの Flash 系の行を使える。
- ワークロードをバッチ推論で実行できる。
- プロンプトで暗黙的または明示的なキャッシュを使える。
- すでに Alibaba Cloud を利用している、または特定の Qwen モデルファミリーが必要である。
- 品質/コストのトレードオフに対応する、より幅広い Qwen スナップショットが必要である。
- リージョンに紐づくエンドポイントと API キーの運用を扱える。
注意点は複雑さです。Qwen には多くの行、リージョン、モデルバージョン、キャッシュ例外があります。必要なのは、単に表から価格を写すことではなく、保存されたルートのレビューです。
30分でできるルートレビューのテンプレート
本番トラフィックを変更する前に、これをコピーしてください。
decision_date: 2026-09-23
workflow: ""
current_route:
  provider: ""
  model_id: ""
  region: ""
  endpoint: ""
candidate_routes:
  - provider: deepseek
    model_id: deepseek-flash
    execution_mode: realtime
    pricing_checked_url: https://api-docs.deepseek.com/quick_start/pricing
    cache_fields_to_log:
      - prompt_cache_hit_tokens
      - prompt_cache_miss_tokens
  - provider: qwen
    model_id: ""
    region: ""
    execution_mode: realtime_or_batch
    pricing_checked_url: https://docs.modelstudio.console.alibabacloud.com/en/model-studio/model-pricing
    cache_fields_to_log:
      - cached_tokens
acceptance_gate:
  sample_size: 100
  minimum_quality_pass_rate: ""
  maximum_retry_rate: ""
  maximum_p95_latency: ""
  maximum_cost_per_accepted_task: ""
rollback:
  owner: ""
  fallback_model_id: ""
  spend_limit: ""
  review_date: ""
実践的な推奨
コストに敏感な個人向けワークフローの多くでは、次の順序で始めてください。
- 必要なリージョンで利用可能な、最も安い Qwen Flash 系の行をテストする。
- ワークロードが非同期なら、Qwen のバッチ推論をテストする。
- プロンプトに繰り返しのコンテキストがある場合は、Qwen のキャッシュ項目と DeepSeek のキャッシュ項目を並べて測定する。
- 単純なセットアップや DeepSeek の品質が重要な場合は、閑散時間帯に
deepseek-flashをテストする。 - より安価なルートが受け入れテストに失敗した後でのみ、Plus、Max、または DeepSeek Pro を使う。
- 切り替え、フォールバック、または請求の証跡が運用コストの一部になる場合は、共有ゲートウェイ経由でルーティングする。
入力トークンあたりで最も安いルートを承認してはいけません。品質、再試行、キャッシュ、バッチ、ロールバックの証拠を記録したうえで、承認済みタスクあたりで最も安いルートを承認してください。
よくある質問
2026年に DeepSeek は Qwen より安いですか?
一概には言えません。現在の例では、Qwen はキャッシュなしの単純なチャットやバッチ化可能な作業で優位なことが多い一方、DeepSeek は単純な直接セットアップ、明示的なキャッシュ会計、閑散時間帯のトラフィック、そして deepseek-flash が少ない再試行で品質基準を満たすワークロードで依然として魅力的です。
Qwen のバッチ推論は常に安いですか?
いいえ。Qwen のバッチ推論は、対応モデルでは成功したリクエストをリアルタイム推論の 50% で課金できますが、バッチジョブは非同期であり、一部のプロモーションやキャッシュ割引の対象外です。レイテンシに حساسな製品呼び出しではなく、オフラインジョブに使ってください。
DeepSeek Pro と Qwen Flash を比較すべきですか?
両方が同じ品質ゲートを通過する場合に限ります。コストガイドでは、タスクを満たす最も安いモデルを比較してください。Qwen Flash が失敗し DeepSeek Flash が通過するなら、一覧上で安い Qwen の行は無関係です。
キャッシュは節約を保証しますか?
いいえ。DeepSeek は、キャッシュヒットはキャッシュ済みの接頭辞ユニットの一致に依存し、保証されないと述べています。Qwen のドキュメントでも、暗黙的なキャッシュヒット確率は保証されず、usage フィールドを通じて確認する必要があるとされています。キャッシュによる節約は、約束された節約ではなく、測定された節約として扱ってください。
Flatkey はどこに当てはまるのか?
Flatkey は、モデルの切り替え自体がコストになったときに有用です。1つの OpenAI 互換ルート、1つの残高、1つの請求書、そして usage ログがあれば、DeepSeek、Qwen、その他のモデルルートを、各プロバイダにキーや請求の証跡を分散させることなく比較できます。
最終回答
DeepSeek API vs Qwen API for Cost-Sensitive Workflows: 2026 Cost Guide の正しい結論は、「DeepSeek のほうが安い」でも「Qwen のほうが安い」でもありません。それは次のとおりです。
シンプルで低コスト、キャッシュ可能、かつバッチ処理しやすいワークフローでは、まず Qwen を使ってください。セットアップの簡単さ、オフピークのスケジューリング、直接的なキャッシュヒット計上、あるいは DeepSeek Flash の品質によって、受理タスクあたりのコストが下がる場合は、まず DeepSeek を使ってください。モデルの切り替え、ログ記録、請求の証明にかかるコストがトークン価格と同じくらい重要になってきたら、Flatkey を使ってください。