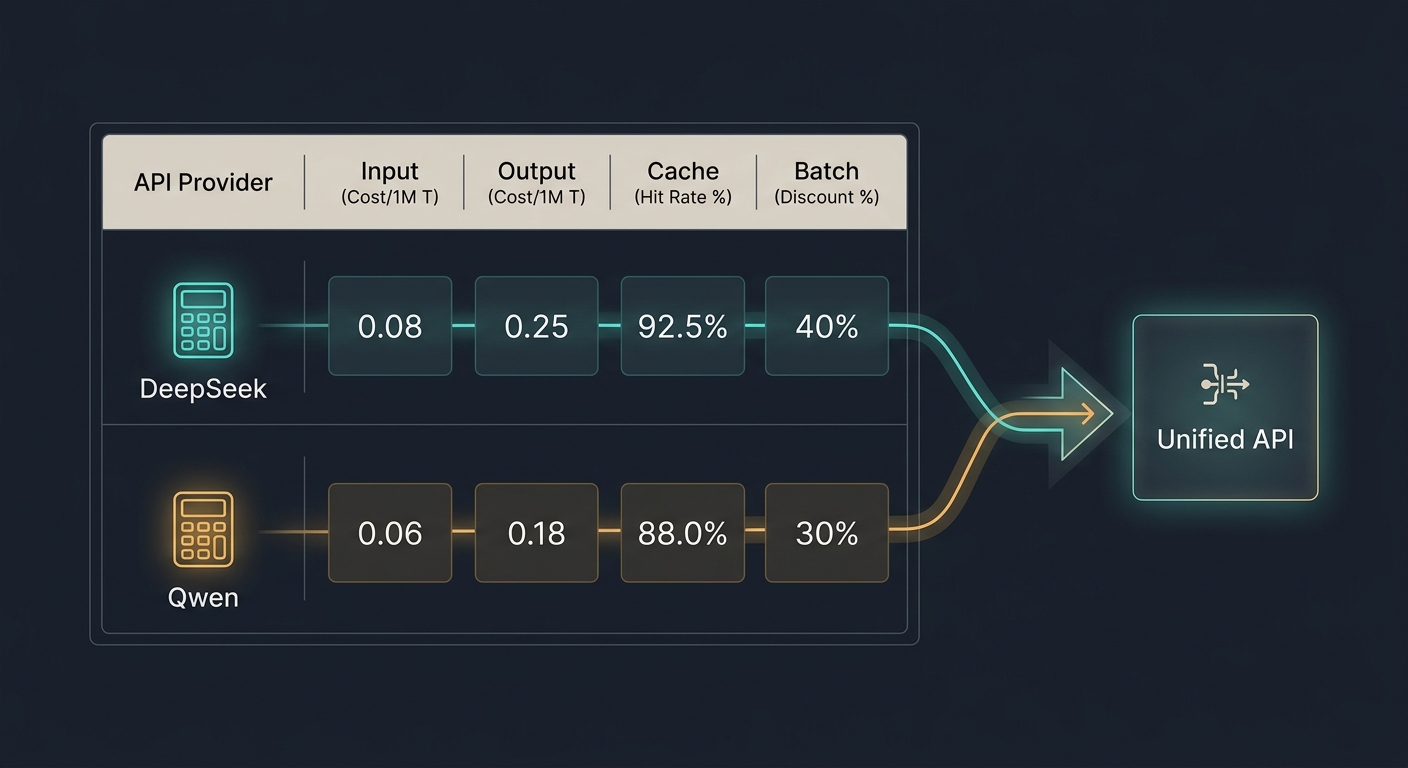
Nếu bạn đang lựa chọn giữa DeepSeek API và Qwen API cho một sản phẩm nhạy cảm về ngân sách, đừng bắt đầu bằng một mức giá token nổi bật duy nhất. Hãy bắt đầu từ hình dạng của khối lượng công việc của bạn.
Một DeepSeek API vs Qwen API cho quy trình làm việc nhạy cảm về chi phí: Hướng dẫn chi phí 2026 hữu ích phải so sánh ít nhất sáu điều: token đầu vào, token đầu ra, lần cache trúng, lần cache trượt, khả năng đủ điều kiện batch, và chi phí vận hành khi phải đổi tuyến sau này.
Hướng dẫn này đã được kiểm tra đối chiếu với tài liệu chính thức của nhà cung cấp vào ngày 23 tháng 9, 2026. Nó được viết cho các indie hacker và các nhóm sản phẩm AI nhỏ cần chi phí thấp nhất có thể tin cậy trên mỗi tác vụ được chấp nhận, chứ không phải một benchmark để khoe thành tích.
Tóm tắt ngắn gọn:
- Chọn Qwen trước cho chat đơn giản khối lượng lớn, các job batch bất đồng bộ, và các quy trình có thể dùng suy luận batch của Qwen hoặc các quy tắc cache ngầm/hiện.
- Chọn DeepSeek trước khi bạn muốn một endpoint định dạng OpenAI toàn cầu đơn giản hơn, các dòng token peak/off-peak tách bạch, việc hạch toán cache-hit và cache-miss rõ ràng, hoặc chất lượng DeepSeek Flash đã đủ tốt cho sản phẩm của bạn.
- Hãy dùng một bộ định tuyến và sổ theo dõi sử dụng khi mức tiết kiệm token dự kiến đủ nhỏ đến mức việc thiết lập nhà cung cấp, hành vi thử lại, số dư bị phân mảnh, hoặc công sức di chuyển có thể xóa sạch khoản giảm giá.
DeepSeek API vs Qwen API cho các quy trình nhạy cảm về chi phí: bảng quyết định
| Mẫu quy trình | Tín hiệu chi phí hiện tại | Dòng model đầu tiên nên thử | Điều có thể làm thay đổi câu trả lời |
|---|---|---|---|
| Chat ngắn không dùng cache | Các dòng thuộc họ Qwen Flash có thể thấp hơn theo phép tính giá niêm yết | Qwen | Độ dài đầu ra, khu vực, snapshot Qwen chính xác, tỷ lệ đạt chất lượng |
| Đánh giá hoặc gắn nhãn bất đồng bộ | Qwen batch inference tính phí các yêu cầu thành công ở mức 50% so với suy luận thời gian thực | Qwen | Khả năng đủ điều kiện batch, mức chấp nhận độ trễ hoàn thành, chiết khấu cache không được hỗ trợ trong batch |
| Ngữ cảnh dài lặp lại | Cả hai nhà cung cấp đều có cơ chế cache; DeepSeek hiển thị trực tiếp các dòng hit/miss, Qwen có chế độ cache hiện và ngầm | Thử cả hai | Tỷ lệ cache-hit thực tế, chi phí tạo cache, các trường cache đặc thù theo nhà cung cấp |
| Đầu ra thiên về suy luận | Nhà thắng phụ thuộc vào việc Qwen Plus, Qwen Max, DeepSeek Flash, hay DeepSeek Pro đạt ngưỡng chất lượng hay không | Không có người thắng mặc định | Thinking tokens, số lần thử lại, độ dài câu trả lời, tỷ lệ chấp nhận |
| Thiết lập trực tiếp đơn giản | DeepSeek công bố một base URL duy nhất theo định dạng OpenAI; thiết lập Qwen phụ thuộc vào khu vực/workspace | DeepSeek | Nhu cầu về vùng dữ liệu, mua sắm/procurement, dấu chân Alibaba Cloud hiện có |
| Thường xuyên chuyển model | Tiết kiệm token có thể bị mất do chi phí tích hợp và thanh toán | Lớp định tuyến chung | Tính sẵn có của model, kế hoạch rollback, log hợp nhất |
Bảng đó không phải là xếp hạng chất lượng. Nó là một công cụ phân loại chi phí. So sánh đúng là chi phí trên mỗi tác vụ được chấp nhận, chứ không phải chi phí trên mỗi một triệu token đầu vào.
Điều gì đã thay đổi kể từ đợt theo dõi giá tháng 7 năm 2026
Đợt theo dõi giá Flatkey trước đó cho URL này dùng DeepSeek V4 Flash và V4 Pro làm đường cơ sở và coi Qwen Flash là dòng Qwen bền vững có chi phí thấp. Các trang hiện tại của nhà cung cấp khiến phép so sánh trở nên tinh tế hơn.
DeepSeek hiện yêu cầu người dùng API dùng deepseek-flash làm tên mô hình. Tài liệu của họ nói rằng các tên cũ như deepseek-v4-flash vẫn được chấp nhận, nhưng yêu cầu sẽ được phục vụ bởi DeepSeek-V4.1-Flash và tính phí theo giá Flash. DeepSeek cũng công bố giá giờ cao điểm và giờ thấp điểm, vì vậy một quy trình chạy vào cuối tuần hoặc ngoài các khung UTC cao điểm có thể có cấu trúc chi phí khác với một quy trình chạy trong giờ cao điểm.
Alibaba Cloud Model Studio hiện hiển thị nhiều hàng thuộc họ Qwen Flash trên các phiên bản mô hình và khu vực triển khai, bao gồm qwen3.8-flash, qwen3.7-flash và qwen-flash. Cùng trang này cũng tách riêng giá theo khu vực và phạm vi triển khai, nên một mức giá Qwen đơn lẻ là chưa đủ để phê duyệt. Mã mô hình và khu vực chính xác là yếu tố quan trọng.
Đối với hướng dẫn chi phí 2026, điều đó có nghĩa là chỉ dẫn đầu tiên rất đơn giản: chuẩn hóa theo đúng mã mô hình, khu vực, quy tắc cache và chế độ thực thi trước khi so sánh các nhà cung cấp.
Ảnh chụp nhanh giá từ bên thứ nhất hiện tại
Tất cả mức giá dưới đây là giá niêm yết công khai trên một triệu token như được thấy trong tài liệu chính thức của bên thứ nhất vào ngày 23 tháng 9 năm 2026. Đừng xem chúng như một hợp đồng. Hãy kiểm tra trang của nhà cung cấp và tài khoản của bạn trước khi chuyển lưu lượng.
Các dòng giá của DeepSeek API
Trang giá của DeepSeek liệt kê deepseek-flash và deepseek-v4-pro, cả hai đều có độ dài ngữ cảnh 1M và đầu ra tối đa 384K.
| Mô hình | Input trúng cache, ngoài giờ cao điểm | Input không trúng cache, ngoài giờ cao điểm | Output, ngoài giờ cao điểm | Input trúng cache, giờ cao điểm | Input không trúng cache, giờ cao điểm | Output, giờ cao điểm |
|---|---|---|---|---|---|---|
deepseek-flash | $0.003 | $0.15 | $0.60 | $0.006 | $0.30 | $1.20 |
deepseek-v4-pro | $0.022 | $0.66 | $1.98 | $0.044 | $1.32 | $3.96 |
DeepSeek cũng công bố:
- URL gốc theo định dạng OpenAI:
https://api.deepseek.com - URL gốc theo định dạng Anthropic:
https://api.deepseek.com/anthropic - tự động lưu cache ngữ cảnh
prompt_cache_hit_tokensvàprompt_cache_miss_tokenstrong phần usage- giờ cao điểm từ 01:00-04:00 và 06:00-10:00 UTC, từ thứ Hai đến thứ Sáu, không bao gồm các ngày lễ công cộng của Trung Quốc
Lợi thế thực tế là sự rõ ràng. Bạn có thể tính riêng input trúng cache, input không trúng cache và output mà không cần đoán token đầu vào nào được giảm giá.
Các dòng giá của Qwen API
Trang giá của Alibaba Cloud Model Studio liệt kê nhiều hàng Qwen. Các hàng thuộc họ Flash liên quan nhất cho các quy trình xử lý văn bản nhạy cảm về chi phí gồm:
| Dòng mô hình | Tín hiệu giá niêm yết ví dụ | Vì sao điều này quan trọng |
|---|---|---|
qwen3.8-flash | Các dòng bao gồm $0.15 cho đầu vào và $0.47 cho đầu ra trong một dòng quốc tế hiển thị; các khu vực khác có thể có số khác | Họ Flash mới hơn; hãy xác minh khu vực và tuyến cụ thể |
qwen3.7-flash | Các dòng bao gồm $0.030 cho đầu vào và $0.130 cho đầu ra trong một dòng quốc tế hiển thị; các khu vực khác có thể có số khác | Thường là một ứng viên có giá niêm yết rất thấp nếu chất lượng đủ dùng |
qwen-flash | Các dòng bao gồm $0.05 cho đầu vào và $0.40 cho đầu ra trong một dòng quốc tế hiển thị; các khu vực khác có thể khác nhau | Dòng nền tảng bền vững cho các tác vụ đơn giản, chi phí thấp |
qwen-plus | Các dòng bao gồm $0.40 cho đầu vào và $1.20 cho đầu ra trong một dòng hiển thị | Hữu ích khi chất lượng của Flash là chưa đủ |
qwen3.7-plus | Các dòng bao gồm $0.40 cho đầu vào và $1.60 cho đầu ra trong một dòng hiển thị | Hữu ích cho các tác vụ suy luận hoặc sinh nội dung khó hơn |
qwen3.8-max / qwen3.7-max | Các dòng bao gồm mức giá đầu vào và đầu ra cao hơn đáng kể | Chỉ thử khi Plus/Flash không đạt ngưỡng chất lượng |
Qwen cũng công bố:
- Giao diện chat tương thích OpenAI
- các base URL theo khu vực/workspace
- API key phải khớp với khu vực endpoint
- suy luận theo lô cho các mô hình được hỗ trợ với giá bằng 50% giá suy luận thời gian thực đối với các yêu cầu thành công
- chế độ cache ngữ cảnh rõ ràng và ngầm định, với các trường token cache-hit trong usage
Lợi thế thực tế là không gian giảm giá. Nếu khối lượng công việc của bạn có thể chạy không đồng bộ hoặc có thể tận dụng cache của Qwen một cách đáng tin cậy, giá hiệu dụng của Qwen có thể thấp hơn nhiều so với dòng thời gian thực đơn giản.
Ba phép tính cho khối lượng công việc
Các ví dụ này chỉ so sánh hình dạng tính phí. Chúng không khẳng định chất lượng, độ trễ, độ tin cậy hay hành vi an toàn là tương đương.
Kịch bản 1: chat ngắn không dùng cache
Giả sử:
- 10,000 yêu cầu
- 1,000 token đầu vào cho mỗi yêu cầu
- 500 token đầu ra cho mỗi yêu cầu
- không có cache hit
- không có chế độ batch
| Tuyến | Tính toán | Chi phí token theo giá niêm yết ước tính |
|---|---|---|
Dòng ví dụ qwen-flash | 10M đầu vào với $0.05 + 5M đầu ra với $0.40 | $2.50 |
Dòng ví dụ qwen3.8-flash | 10M đầu vào với $0.15 + 5M đầu ra với $0.47 | $3.85 |
deepseek-flash, ngoài giờ cao điểm | 10M đầu vào không cache hit với $0.15 + 5M đầu ra với $0.60 | $4.50 |
deepseek-flash, giờ cao điểm | 10M đầu vào không cache hit với $0.30 + 5M đầu ra với $1.20 | $9.00 |
Với chat ngắn không dùng cache, Qwen là ứng viên chi phí đầu tiên. DeepSeek vẫn có thể thắng nếu tỷ lệ đạt chất lượng của nó cao hơn, cần ít lần thử lại hơn, hoặc sự đơn giản trong vận hành quan trọng hơn chênh lệch token thô.
Kịch bản 2: ngữ cảnh dài lặp lại
Giả sử:
- 10.000 yêu cầu
- 10.000 token đầu vào mỗi yêu cầu
- 1.000 token đầu ra mỗi yêu cầu
- 90% token đầu vào được đưa vào cache sau giai đoạn làm nóng
- không có chế độ batch
| Route | Giả định cache | Chi phí token ước tính theo giá niêm yết |
|---|---|---|
deepseek-flash, ngoài giờ cao điểm | 90M token đầu vào trúng cache ở mức $0.003, 10M token đầu vào trượt cache ở mức $0.15, 10M token đầu ra ở mức $0.60 | $7.77 |
deepseek-flash, giờ cao điểm | 90M token đầu vào trúng cache ở mức $0.006, 10M token đầu vào trượt cache ở mức $0.30, 10M token đầu ra ở mức $1.20 | $15.54 |
hàng ví dụ qwen-flash với 20% token đầu vào có cache ngầm | 90M token đầu vào đã cache ở mức $0.01, 10M token đầu vào thông thường ở mức $0.05, 10M token đầu ra ở mức $0.40 | $5.40 |
Đây là lúc quy tắc kinh nghiệm cũ có thể không còn đúng. DeepSeek công bố rất rõ các dòng token đầu vào trúng cache và trượt cache, nhưng tài liệu cache hiện tại của Qwen cho biết nhiều mô hình cache ngầm tính phí token đầu vào đã cache theo một tỷ lệ phần trăm của token đầu vào thông thường, đồng thời cũng nêu các ngoại lệ theo từng mô hình. Nếu khối lượng công việc của bạn phụ thuộc vào tiết kiệm cache, đừng phê duyệt bất kỳ nhà cung cấp nào chỉ từ bảng tính. Hãy ghi lại số token trúng cache thực tế từ phản hồi API.
Kịch bản 3: đánh giá có thể batch
Giả sử cùng dạng hội thoại ngắn như trong Kịch bản 1, nhưng tác vụ có thể chờ xử lý batch không đồng bộ và sử dụng một mô hình batch Qwen được hỗ trợ.
| Route | Tính toán | Chi phí token ước tính theo giá niêm yết |
|---|---|---|
hàng ví dụ thời gian thực qwen-flash | Giống Kịch bản 1 | $2.50 |
qwen-flash đủ điều kiện batch | 50% chi phí token của yêu cầu thời gian thực thành công | $1.25 |
deepseek-flash, thời gian thực ngoài giờ cao điểm | Giống Kịch bản 1 | $4.50 |
Đối với bộ đánh giá, gắn nhãn dữ liệu qua đêm, làm giàu dữ liệu ngoại tuyến và kiểm thử hồi quy, suy luận batch của Qwen thường là lộ trình chi phí đầu tiên cần xác minh. Đổi lại là độ trễ và cơ chế vận hành: job batch cần đầu vào JSONL, một mô hình duy nhất cho mỗi tệp, cơ chế polling, xử lý tệp kết quả và các bước kiểm tra chấp nhận.
Bộ tính toán mà các indie hacker nên dùng
Hãy dùng công thức này trước khi chuyển mô hình:
chi phí cho một tác vụ đã chấp nhận =
  cache_miss_input_tokens * cache_miss_input_rate
  + cache_hit_input_tokens * cache_hit_input_rate
  + output_tokens * output_rate
  - verified_batch_discount
  + retry_tokens
  + fallback_tokens
  + migration_operating_cost
----------------------------------------------------
  accepted_tasks
Sau đó theo dõi các trường sau cho từng route ứng viên:
| Trường | Tại sao điều này quan trọng |
|---|---|
| ID mô hình chính xác | Các bí danh động và ảnh chụp theo ngày có thể hoạt động khác nhau |
| Khu vực và điểm cuối | API key của Qwen bị ràng buộc theo khu vực; điểm cuối không khớp có thể gây lỗi xác thực |
| Chế độ thực thi | Thời gian thực, batch, cache và cơ chế dự phòng của router dùng các giả định tính phí khác nhau |
| Token đầu vào | Prompt dài khiến cache và việc rút gọn prompt trở nên quan trọng |
| Token đầu ra | Đầu ra thường chiếm phần lớn chi phí tạo sinh và suy luận |
| Token trúng cache | Các giả định về cache chưa phải là tiết kiệm cho đến khi log chứng minh điều đó |
| Số lần thử lại | Một mô hình rẻ hơn nhưng phải thử lại nhiều hơn có thể tốn kém hơn |
| Tỷ lệ tác vụ được chấp nhận | Thất bại về chất lượng là chi phí ẩn |
| Thời điểm thực thi | Tỷ lệ giờ cao điểm/ngoài giờ cao điểm của DeepSeek có thể làm thay đổi chi phí của cùng một công việc |
| Công việc di chuyển | Công việc SDK, điểm cuối, khu vực, ghi log và rollback đều có chi phí thực |
Khác biệt trong thiết lập API ảnh hưởng đến chi phí
Thiết lập DeepSeek khá đơn giản về mặt vận hành. Với các lệnh gọi tương thích OpenAI, base URL là https://api.deepseek.com, với các tên mô hình hiện tại như deepseek-flash và deepseek-v4-pro. Với nhiều đội nhóm nhỏ, sự đơn giản này rất quan trọng vì thời gian thiết lập cũng là chi phí.
Thiết lập Qwen có nhiều lựa chọn hơn. Model Studio hỗ trợ các lệnh gọi tương thích OpenAI, nhưng base URL thay đổi theo khu vực và workspace. Tài liệu nêu rằng API key bị ràng buộc với khu vực nơi chúng được tạo, và một key từ khu vực này có thể không hoạt động với điểm cuối của khu vực khác. Điều đó không phải là trở ngại lớn, nhưng nó cần được tính vào so sánh chi phí.
Nếu bạn đang vận hành một sản phẩm nhỏ, phần việc ẩn thường trông như sau:
- Thêm base URL của Qwen có nhận biết khu vực.
- Tạo API key ở đúng khu vực.
- Kiểm tra ID mô hình Qwen chính xác ở khu vực đó.
- Xác nhận liệu batch inference có được hỗ trợ cho mô hình đó hay không.
- Xác nhận liệu cache rõ ràng hay ngầm định có được áp dụng hay không.
- Xác nhận các trường usage có báo cáo token đã được cache hay không.
- Thêm định tuyến rollback nếu route không đạt các ngưỡng chất lượng hoặc độ trễ.
Đó là lý do một bộ định tuyến dùng chung một key có thể hữu ích ngay cả với một đội ưu tiên chi phí. Flatkey cung cấp cho các đội một điểm vào tương thích OpenAI, một số dư, một hóa đơn, khả năng khám phá mô hình và xem xét mức sử dụng trên nhiều nhà cung cấp. Bạn vẫn cần xác minh tính khả dụng của mô hình và giá trước khi đưa vào sản xuất, nhưng phép so sánh vận hành trở nên rõ ràng hơn vì bằng chứng về tính phí và yêu cầu được lưu ở một nơi.
Khi DeepSeek là lựa chọn chi phí tốt hơn
DeepSeek là bài kiểm tra đầu tiên tốt hơn khi:
- Bạn muốn một điểm cuối nhà cung cấp trực tiếp, đơn giản.
- Khối lượng công việc của bạn có thể chạy trong các khung giờ ngoài cao điểm.
- Prompt có các tiền tố lặp lại và token trúng cache của DeepSeek xuất hiện đáng tin cậy.
- Chất lượng của
deepseek-flashlà đủ cho tác vụ. - Bạn cần các dòng giá cache-hit, cache-miss và output rõ ràng trong cùng một bảng giá.
- Đội của bạn muốn tránh quản lý key theo khu vực/workspace.
Cảnh báo quan trọng là chi phí đầu ra. DeepSeek Flash có thể rất hấp dẫn khi tỷ lệ trúng cache đầu vào cao, nhưng câu trả lời dài vẫn phải trả theo mức giá đầu ra. Nếu mô hình tạo câu trả lời dài dòng hoặc cần thử lại, khoản tiết kiệm theo giá niêm yết có thể biến mất.
Khi Qwen là lựa chọn chi phí tốt hơn
Qwen là lựa chọn thử nghiệm đầu tiên tốt hơn khi:
- Bạn có thể dùng hàng Flash-family chi phí thấp ở khu vực bạn cần.
- Khối lượng công việc của bạn có thể chạy qua suy luận theo lô.
- Prompt của bạn có thể dùng cache ngầm định hoặc tường minh.
- Bạn đã dùng Alibaba Cloud hoặc cần các họ mô hình Qwen cụ thể.
- Bạn cần một bộ snapshot Qwen rộng hơn để đánh đổi giữa chất lượng/chi phí.
- Bạn có thể xử lý các thao tác endpoint và API-key theo từng khu vực.
Cảnh báo là sự phức tạp. Qwen có nhiều hàng, nhiều khu vực, nhiều phiên bản mô hình và các ngoại lệ cache. Bạn cần một bản rà soát tuyến đã lưu, không chỉ là một mức giá sao chép từ bảng.
Mẫu rà soát tuyến trong 30 phút
Sao chép phần này trước khi thay đổi lưu lượng production:
decision_date: 2026-09-23
workflow: ""
current_route:
  provider: ""
  model_id: ""
  region: ""
  endpoint: ""
candidate_routes:
  - provider: deepseek
    model_id: deepseek-flash
    execution_mode: realtime
    pricing_checked_url: https://api-docs.deepseek.com/quick_start/pricing
    cache_fields_to_log:
      - prompt_cache_hit_tokens
      - prompt_cache_miss_tokens
  - provider: qwen
    model_id: ""
    region: ""
    execution_mode: realtime_or_batch
    pricing_checked_url: https://docs.modelstudio.console.alibabacloud.com/en/model-studio/model-pricing
    cache_fields_to_log:
      - cached_tokens
acceptance_gate:
  sample_size: 100
  minimum_quality_pass_rate: ""
  maximum_retry_rate: ""
  maximum_p95_latency: ""
  maximum_cost_per_accepted_task: ""
rollback:
  owner: ""
  fallback_model_id: ""
  spend_limit: ""
  review_date: ""
Khuyến nghị thực tế
Với hầu hết các quy trình làm việc độc lập nhạy cảm về chi phí, hãy bắt đầu theo thứ tự này:
- Kiểm tra hàng Flash-family của Qwen rẻ nhất có sẵn ở khu vực bạn yêu cầu.
- Nếu khối lượng công việc là bất đồng bộ, hãy kiểm tra suy luận theo lô của Qwen.
- Nếu prompt có ngữ cảnh lặp lại, hãy đo các trường cache của Qwen và các trường cache của DeepSeek song song với nhau.
- Kiểm tra
deepseek-flashtrong các khung giờ thấp điểm nếu việc thiết lập đơn giản hoặc chất lượng DeepSeek là quan trọng. - Chỉ dùng Plus, Max, hoặc DeepSeek Pro sau khi tuyến rẻ hơn không vượt qua bài kiểm tra chấp nhận.
- Đi qua một gateway dùng chung khi việc chuyển đổi, cơ chế dự phòng, hoặc bằng chứng thanh toán trở thành một phần của chi phí vận hành.
Đừng phê duyệt tuyến có giá rẻ nhất trên mỗi token đầu vào. Hãy phê duyệt tuyến rẻ nhất trên mỗi tác vụ được chấp nhận sau khi đã ghi lại bằng chứng về chất lượng, số lần thử lại, cache, batch, và rollback.
Câu hỏi thường gặp
DeepSeek có rẻ hơn Qwen vào năm 2026 không?
Không phải lúc nào cũng vậy. Trong các ví dụ hiện tại, Qwen thường thắng ở chat đơn giản không dùng cache và các công việc có thể xử lý theo lô, trong khi DeepSeek vẫn hấp dẫn nhờ thiết lập trực tiếp đơn giản, hạch toán cache tường minh, lưu lượng ngoài giờ cao điểm, và các khối lượng công việc mà deepseek-flash vượt qua chất lượng với ít lần thử lại hơn.
Suy luận theo lô của Qwen có luôn rẻ hơn không?
Không. Suy luận theo lô của Qwen có thể tính phí các yêu cầu thành công ở mức 50% so với suy luận thời gian thực đối với các mô hình được hỗ trợ, nhưng các job theo lô là bất đồng bộ và không đủ điều kiện cho một số chương trình khuyến mãi hoặc giảm giá cache. Hãy dùng nó cho các job offline, không phải các lệnh gọi sản phẩm nhạy cảm với độ trễ.
Tôi có nên so sánh DeepSeek Pro với Qwen Flash không?
Chỉ khi cả hai cùng vượt qua cùng một ngưỡng chất lượng. Với một hướng dẫn chi phí, hãy so sánh mô hình rẻ nhất đáp ứng được tác vụ. Nếu Qwen Flash thất bại nhưng DeepSeek Flash vượt qua, thì hàng Qwen rẻ hơn được liệt kê là không liên quan.
Cache có đảm bảo tiết kiệm không?
Không. DeepSeek cho biết các lần cache hit phụ thuộc vào việc khớp với các đơn vị tiền tố đã được lưu trong cache và không được đảm bảo. Tài liệu của Qwen cũng nói rằng xác suất cache hit ngầm định không được đảm bảo và phải được xác minh thông qua các trường sử dụng. Hãy xem tiết kiệm từ cache là mức tiết kiệm được đo lường, không phải mức tiết kiệm được hứa hẹn.
Flatkey phù hợp ở đâu?
Flatkey hữu ích khi bản thân việc chuyển đổi mô hình đã trở thành một chi phí. Với một tuyến tương thích OpenAI, một số dư, một hóa đơn và nhật ký sử dụng, bạn có thể so sánh DeepSeek, Qwen và các tuyến mô hình khác mà không phải phân tán khóa và bằng chứng thanh toán giữa nhiều nhà cung cấp.
Câu trả lời cuối cùng
Kết luận đúng cho DeepSeek API vs Qwen API cho quy trình làm việc nhạy cảm về chi phí: Hướng dẫn chi phí 2026 không phải là "DeepSeek rẻ hơn" hay "Qwen rẻ hơn." Mà là:
Hãy dùng Qwen trước cho các quy trình làm việc đơn giản, chi phí thấp, có thể cache và có thể chạy theo lô. Hãy dùng DeepSeek trước khi thiết lập đơn giản, lập lịch ngoài giờ cao điểm, ghi nhận cache-hit trực tiếp, hoặc chất lượng DeepSeek Flash mang lại cho bạn chi phí trên mỗi tác vụ được chấp nhận thấp hơn. Hãy dùng Flatkey khi chi phí chuyển đổi, ghi nhật ký và bằng chứng thanh toán bắt đầu quan trọng ngang với giá token.