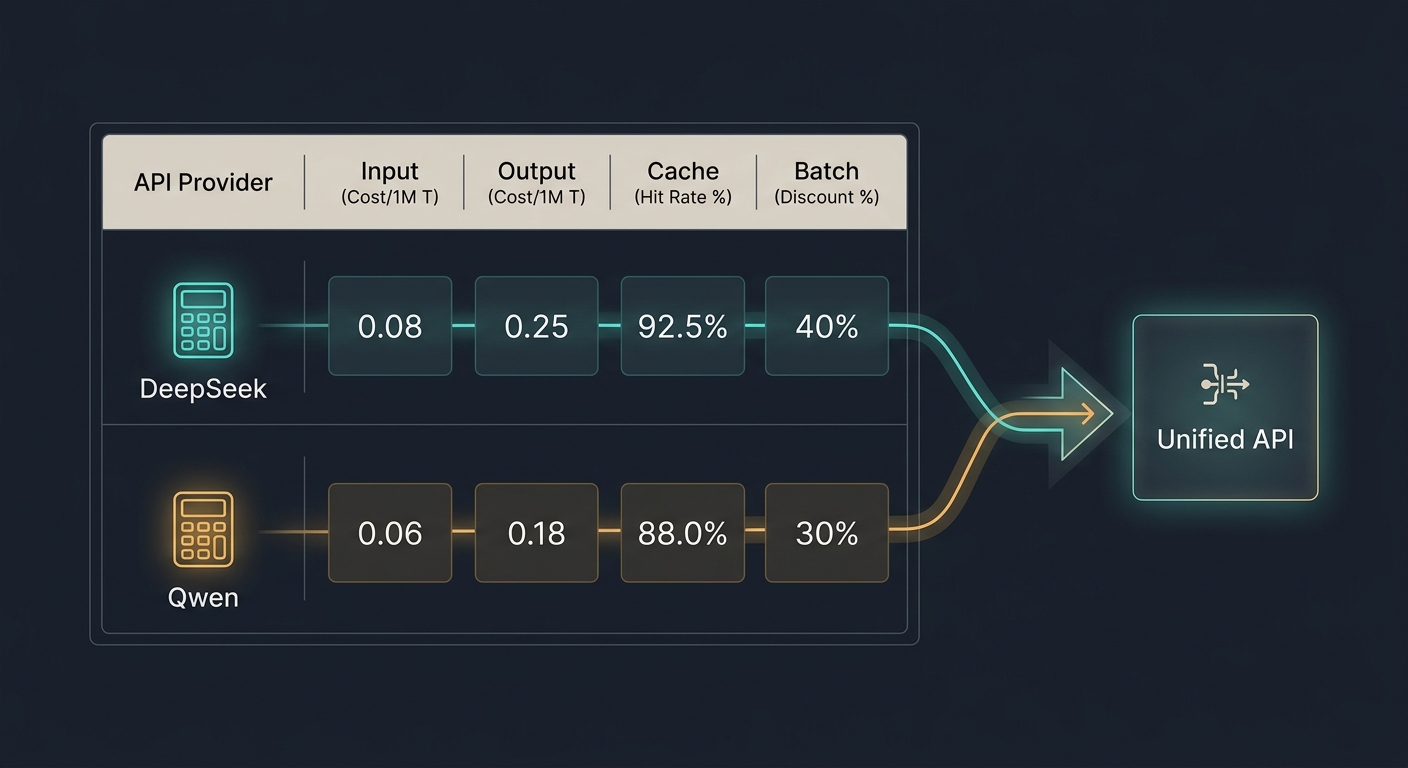
Jika Anda memilih antara DeepSeek API dan Qwen API untuk produk yang sensitif terhadap anggaran, jangan mulai dari satu harga token utama. Mulailah dari bentuk beban kerja Anda.
DeepSeek API vs Qwen API untuk Workflow Sensitif Biaya: Panduan Biaya 2026 yang berguna harus membandingkan setidaknya enam hal: token input, token output, cache hits, cache misses, kelayakan batch, dan biaya operasional untuk mengubah rute nanti.
Panduan ini telah diperiksa terhadap dokumentasi resmi penyedia pada 23 September 2026. Ini ditulis untuk indie hacker dan tim produk AI kecil yang membutuhkan biaya terendah yang andal per tugas yang diterima, bukan benchmark untuk pamer.
Versi singkatnya:
- Pilih Qwen terlebih dahulu untuk chat sederhana bervolume tinggi, pekerjaan batch asinkron, dan workflow yang dapat menggunakan inference batch Qwen atau aturan cache implisit/eksplisit.
- Pilih DeepSeek terlebih dahulu ketika Anda menginginkan endpoint format OpenAI global yang lebih sederhana, baris token peak/off-peak yang eksplisit, pencatatan cache-hit dan cache-miss otomatis, atau kualitas DeepSeek Flash sudah cukup baik untuk produk Anda.
- Gunakan router dan ledger penggunaan ketika penghematan token yang diharapkan cukup kecil sehingga setup penyedia, perilaku retry, saldo yang terfragmentasi, atau pekerjaan migrasi bisa menghapus diskon tersebut.
DeepSeek API vs Qwen API untuk workflow sensitif biaya: tabel keputusan
| Pola workflow | Sinyal biaya saat ini | Keluarga model pertama yang diuji | Apa yang dapat mengubah jawabannya |
|---|---|---|---|
| Chat pendek tanpa cache | Baris keluarga Qwen Flash bisa lebih rendah pada perhitungan harga daftar | Qwen | Panjang output, wilayah, snapshot Qwen yang tepat, tingkat kelulusan kualitas |
| Evaluasi atau pelabelan asinkron | Inference batch Qwen menagih request yang berhasil sebesar 50% dari inference real-time | Qwen | Kelayakan batch, toleransi waktu penyelesaian, diskon cache yang tidak didukung dalam batch |
| Context panjang berulang | Kedua penyedia memiliki mekanisme cache; DeepSeek menampilkan baris hit/miss secara langsung, Qwen memiliki mode cache eksplisit dan implisit | Uji keduanya | Tingkat cache-hit aktual, overhead pembuatan cache, field cache khusus penyedia |
| Output yang banyak reasoning | Pemenang bergantung pada apakah Qwen Plus, Qwen Max, DeepSeek Flash, atau DeepSeek Pro memenuhi standar kualitas | Tidak ada pemenang default | Thinking tokens, retry, panjang jawaban, tingkat penerimaan |
| Setup langsung yang sederhana | DeepSeek menerbitkan satu base URL format OpenAI; setup Qwen spesifik per region/workspace | DeepSeek | Kebutuhan region data, pengadaan, jejak Alibaba Cloud yang sudah ada |
| Sering berpindah model | Penghematan token dapat hilang karena overhead integrasi dan penagihan | Lapisan routing bersama | Ketersediaan model, rencana rollback, log terpadu |
Tabel itu bukan peringkat kualitas. Itu adalah alat triase biaya. Perbandingan yang tepat adalah biaya per tugas yang diterima, bukan biaya per satu juta token input.
Apa yang berubah sejak pemantauan harga Juli 2026
Pemantauan harga Flatkey sebelumnya untuk URL ini menggunakan DeepSeek V4 Flash dan V4 Pro sebagai baseline dan menganggap Qwen Flash sebagai baris Qwen biaya rendah yang tahan lama. Halaman penyedia saat ini membuat perbandingannya lebih bernuansa.
DeepSeek sekarang memberi tahu pengguna API untuk menggunakan deepseek-flash sebagai nama model. Dokumentasinya menyebutkan bahwa nama lama seperti deepseek-v4-flash masih diterima, tetapi permintaan disajikan oleh DeepSeek-V4.1-Flash dan ditagihkan dengan harga Flash. DeepSeek juga mempublikasikan harga puncak dan luar puncak, sehingga workflow yang berjalan pada akhir pekan atau di luar jendela UTC puncak dapat memiliki profil biaya yang berbeda dari workflow yang berjalan selama jam puncak.
Alibaba Cloud Model Studio sekarang menampilkan beberapa baris keluarga Qwen Flash di berbagai versi model dan region deployment, termasuk qwen3.8-flash, qwen3.7-flash, dan qwen-flash. Halaman yang sama juga memisahkan harga regional dan cakupan deployment, jadi satu harga Qwen saja tidak cukup untuk persetujuan. ID model dan region yang tepat sangat penting.
Untuk panduan biaya 2026, itu berarti instruksi pertama sederhana: normalisasikan berdasarkan ID model yang tepat, region, aturan cache, dan mode eksekusi sebelum membandingkan penyedia.
Snapshot harga first-party saat ini
Semua harga di bawah ini adalah harga daftar publik per satu juta token sebagaimana terlihat dalam dokumentasi first-party pada 23 September 2026. Jangan menganggapnya sebagai kontrak. Periksa halaman penyedia dan akun Anda sebelum memindahkan traffic.
Baris harga API DeepSeek
Halaman harga DeepSeek mencantumkan deepseek-flash dan deepseek-v4-pro, keduanya dengan panjang konteks 1M dan output maksimum 384K.
| Model | Input cache-hit, luar puncak | Input cache-miss, luar puncak | Output, luar puncak | Input cache-hit, puncak | Input cache-miss, puncak | Output, puncak |
|---|---|---|---|---|---|---|
deepseek-flash | $0.003 | $0.15 | $0.60 | $0.006 | $0.30 | $1.20 |
deepseek-v4-pro | $0.022 | $0.66 | $1.98 | $0.044 | $1.32 | $3.96 |
DeepSeek juga mempublikasikan:
- Base URL format OpenAI:
https://api.deepseek.com - Base URL format Anthropic:
https://api.deepseek.com/anthropic - context caching otomatis
prompt_cache_hit_tokensdanprompt_cache_miss_tokensdalam usage- jam puncak dari 01:00-04:00 dan 06:00-10:00 UTC, Senin hingga Jumat, tidak termasuk hari libur nasional Tiongkok
Keuntungan praktisnya adalah kejelasan. Anda dapat menghitung input cache-hit, input cache-miss, dan output secara terpisah tanpa menebak token input mana yang didiskon.
Baris harga API Qwen
Halaman harga Alibaba Cloud Model Studio mencantumkan banyak baris Qwen. Baris keluarga Flash yang paling relevan untuk workflow teks sensitif biaya meliputi:
| Baris model | Contoh sinyal harga daftar | Mengapa ini penting |
|---|---|---|
qwen3.8-flash | Baris mencantumkan $0.15 untuk input dan $0.47 untuk output dalam satu baris internasional yang terlihat; wilayah lain menampilkan angka berbeda | Keluarga Flash yang lebih baru; verifikasi wilayah dan rute yang tepat |
qwen3.7-flash | Baris mencantumkan $0.030 untuk input dan $0.130 untuk output dalam satu baris internasional yang terlihat; wilayah lain menampilkan angka berbeda | Sering menjadi kandidat dengan harga daftar yang sangat rendah jika kualitasnya cukup |
qwen-flash | Baris mencantumkan $0.05 untuk input dan $0.40 untuk output dalam satu baris internasional yang terlihat; wilayah lain dapat berbeda | Baris dasar yang tahan lama untuk tugas sederhana berbiaya rendah |
qwen-plus | Baris mencantumkan $0.40 untuk input dan $1.20 untuk output dalam satu baris yang terlihat | Berguna ketika kualitas Flash belum cukup |
qwen3.7-plus | Baris mencantumkan $0.40 untuk input dan $1.60 untuk output dalam satu baris yang terlihat | Berguna untuk tugas penalaran atau pembuatan yang lebih sulit |
qwen3.8-max / qwen3.7-max | Baris mencantumkan harga input dan output yang jauh lebih tinggi | Uji hanya ketika Plus/Flash gagal memenuhi batas kualitas |
Qwen juga menyediakan:
- antarmuka chat yang kompatibel dengan OpenAI
- base URL spesifik wilayah/workspace
- API key yang harus cocok dengan wilayah endpoint
- inference batch untuk model yang didukung dengan harga 50% dari harga inference real-time untuk permintaan yang berhasil
- mode cache konteks eksplisit dan implisit, dengan field token cache-hit dalam usage
Keunggulan praktisnya adalah ruang diskon. Jika workload Anda dapat dijalankan secara asinkron atau dapat dengan andal mengenai cache Qwen, harga efektif Qwen bisa jauh lebih rendah daripada baris real-time sederhana.
Tiga perhitungan beban kerja
Contoh-contoh ini hanya membandingkan bentuk penagihan. Contoh ini tidak mengklaim kualitas, latensi, keandalan, atau perilaku keamanan yang setara.
Skenario 1: chat singkat tanpa cache
Asumsikan:
- 10.000 permintaan
- 1.000 token input per permintaan
- 500 token output per permintaan
- tidak ada cache hit
- tidak ada mode batch
| Rute | Perhitungan | Estimasi biaya token harga daftar |
|---|---|---|
qwen-flash contoh baris | 10M input pada $0.05 + 5M output pada $0.40 | $2.50 |
qwen3.8-flash contoh baris | 10M input pada $0.15 + 5M output pada $0.47 | $3.85 |
deepseek-flash, off-peak | 10M input yang cache-miss pada $0.15 + 5M output pada $0.60 | $4.50 |
deepseek-flash, peak | 10M input yang cache-miss pada $0.30 + 5M output pada $1.20 | $9.00 |
Untuk chat pendek tanpa cache, Qwen adalah kandidat biaya pertama. DeepSeek tetap bisa menang jika tingkat kelulusan kualitasnya lebih tinggi, memerlukan lebih sedikit percobaan ulang, atau kesederhanaan operasional lebih penting daripada selisih token mentah.
Skenario 2: konteks panjang berulang
Asumsikan:
- 10.000 permintaan
- 10.000 token input per permintaan
- 1.000 token output per permintaan
- 90% token input mencapai cache setelah pemanasan
- tanpa mode batch
| Rute | Asumsi cache | Estimasi biaya token harga daftar |
|---|---|---|
deepseek-flash, di luar jam sibuk | 90M hit input pada $0.003, 10M miss input pada $0.15, 10M output pada $0.60 | $7.77 |
deepseek-flash, jam sibuk | 90M hit input pada $0.006, 10M miss input pada $0.30, 10M output pada $1.20 | $15.54 |
Baris contoh qwen-flash dengan 20% input cache implisit | 90M input tersimpan di cache pada $0.01, 10M input normal pada $0.05, 10M output pada $0.40 | $5.40 |
Di sinilah aturan praktis lama bisa gagal. DeepSeek menampilkan baris hit cache dan miss cache yang sangat jelas, tetapi dokumentasi cache Qwen saat ini menyebutkan bahwa banyak model cache implisit menagih input yang di-cache sebagai persentase dari input normal, sambil juga mencatat pengecualian khusus model. Jika workload Anda bergantung pada penghematan cache, jangan menyetujui salah satu penyedia hanya dari spreadsheet. Catat token cache-hit yang sebenarnya dari respons API.
Skenario 3: evaluasi yang bisa dibatch
Asumsikan bentuk chat singkat yang sama seperti Skenario 1, tetapi pekerjaan dapat menunggu pemrosesan batch asinkron dan menggunakan model batch Qwen yang didukung.
| Rute | Perhitungan | Estimasi biaya token harga daftar |
|---|---|---|
Baris contoh real-time qwen-flash | Sama seperti Skenario 1 | $2.50 |
qwen-flash memenuhi syarat batch | 50% dari biaya token permintaan real-time yang berhasil | $1.25 |
deepseek-flash, real-time di luar jam sibuk | Sama seperti Skenario 1 | $4.50 |
Untuk set evaluasi, pelabelan data malam hari, enrichment offline, dan pengujian regresi, inferensi batch Qwen biasanya adalah jalur biaya pertama yang perlu diverifikasi. Konsekuensinya adalah latensi dan mekanisme: pekerjaan batch membutuhkan input JSONL, satu model per file, polling, penanganan file hasil, dan pemeriksaan penerimaan.
Kalkulator yang harus digunakan indie hacker
Gunakan ini sebelum berpindah model:
accepted task cost =
  cache_miss_input_tokens * cache_miss_input_rate
  + cache_hit_input_tokens * cache_hit_input_rate
  + output_tokens * output_rate
  - verified_batch_discount
  + retry_tokens
  + fallback_tokens
  + migration_operating_cost
----------------------------------------------------
  accepted_tasks
Lalu lacak field berikut untuk setiap rute kandidat:
| Bidang | Mengapa ini penting |
|---|---|
| ID model yang tepat | Alias yang berubah-ubah dan snapshot bertanggal dapat berperilaku berbeda |
| Wilayah dan endpoint | Kunci API Qwen terikat pada wilayah; ketidaksesuaian endpoint dapat menyebabkan kegagalan autentikasi |
| Mode eksekusi | Real-time, batch, cache, dan fallback router menggunakan asumsi penagihan yang berbeda |
| Token input | Prompt panjang membuat cache dan pemangkasan prompt menjadi penting |
| Token output | Output sering mendominasi biaya generasi dan penalaran |
| Token cache-hit | Asumsi cache belum menjadi penghematan sampai log membuktikannya |
| Jumlah retry | Model yang lebih murah tetapi lebih sering retry bisa berbiaya lebih tinggi |
| Tingkat task yang diterima | Kegagalan kualitas adalah biaya tersembunyi |
| Waktu eksekusi | Tarif puncak/off-peak DeepSeek dapat mengubah biaya pekerjaan yang sama |
| Pekerjaan migrasi | Pekerjaan SDK, endpoint, wilayah, logging, dan rollback memiliki biaya nyata |
Perbedaan setup API yang memengaruhi biaya
Setup DeepSeek secara operasional sederhana. Untuk panggilan yang kompatibel dengan OpenAI, base URL-nya adalah https://api.deepseek.com, dengan nama model saat ini seperti deepseek-flash dan deepseek-v4-pro. Bagi banyak tim kecil, kesederhanaan ini penting karena waktu setup juga merupakan biaya.
Setup Qwen memiliki lebih banyak pilihan. Model Studio mendukung panggilan yang kompatibel dengan OpenAI, tetapi base URL-nya bervariasi menurut wilayah dan workspace. Dokumentasi menyatakan bahwa kunci API terikat pada wilayah tempat kunci tersebut dibuat, dan kunci dari satu wilayah dapat gagal saat digunakan ke endpoint wilayah lain. Ini bukan penghalang, tetapi perlu dimasukkan dalam perbandingan biaya.
Jika Anda menjalankan produk kecil, pekerjaan tersembunyi sering kali terlihat seperti ini:
- Menambahkan base URL Qwen yang sadar wilayah.
- Membuat kunci API di wilayah yang benar.
- Menguji ID model Qwen yang tepat di wilayah tersebut.
- Memastikan apakah batch inference didukung untuk model itu.
- Memastikan apakah cache eksplisit atau implisit berlaku.
- Memastikan field penggunaan melaporkan token yang di-cache.
- Menambahkan routing rollback jika rute gagal melewati gate kualitas atau latensi.
Itulah sebabnya router dengan satu kunci bisa berguna bahkan untuk tim yang mengutamakan biaya. Flatkey memberi tim satu titik masuk yang kompatibel dengan OpenAI, satu saldo, satu invoice, penemuan model, dan peninjauan penggunaan lintas provider. Anda tetap perlu memverifikasi ketersediaan model dan harga sebelum produksi, tetapi perbandingan operasional menjadi lebih rapi karena bukti penagihan dan permintaan berada di satu tempat.
Kapan DeepSeek menjadi pilihan biaya yang lebih baik
DeepSeek adalah uji awal yang lebih baik ketika:
- Anda menginginkan satu endpoint provider langsung yang sederhana.
- Workload Anda dapat dijalankan selama jendela off-peak.
- Prompt memiliki prefix berulang dan token cache-hit DeepSeek muncul secara andal.
- Kualitas
deepseek-flashsudah cukup untuk tugas tersebut. - Anda membutuhkan baris harga cache-hit, cache-miss, dan output yang jelas dalam tabel harga yang sama.
- Tim Anda lebih suka menghindari manajemen kunci wilayah/workspace.
Peringatan pentingnya adalah biaya output. DeepSeek Flash bisa sangat menarik ketika cache-hit input tinggi, tetapi jawaban yang panjang tetap dikenakan tarif output. Jika model menghasilkan jawaban yang bertele-tele atau perlu retry, penghematan dari harga daftar bisa hilang.
Kapan Qwen menjadi pilihan biaya yang lebih baik
Qwen adalah uji pertama yang lebih baik ketika:
- Anda dapat menggunakan baris keluarga Flash berbiaya rendah di wilayah yang Anda butuhkan.
- Workload Anda dapat dijalankan melalui batch inference.
- Prompt Anda dapat menggunakan cache implisit atau eksplisit.
- Anda sudah menggunakan Alibaba Cloud atau membutuhkan keluarga model Qwen tertentu.
- Anda memerlukan set snapshot Qwen yang lebih luas untuk trade-off kualitas/biaya.
- Anda dapat menangani operasi endpoint dan API key yang terikat wilayah.
Peringatannya adalah kompleksitas. Qwen memiliki banyak baris, wilayah, versi model, dan pengecualian cache. Anda memerlukan tinjauan rute yang disimpan, bukan hanya harga yang disalin dari tabel.
Template tinjauan rute 30 menit
Salin ini sebelum mengubah traffic produksi:
decision_date: 2026-09-23
workflow: ""
current_route:
  provider: ""
  model_id: ""
  region: ""
  endpoint: ""
candidate_routes:
  - provider: deepseek
    model_id: deepseek-flash
    execution_mode: realtime
    pricing_checked_url: https://api-docs.deepseek.com/quick_start/pricing
    cache_fields_to_log:
      - prompt_cache_hit_tokens
      - prompt_cache_miss_tokens
  - provider: qwen
    model_id: ""
    region: ""
    execution_mode: realtime_or_batch
    pricing_checked_url: https://docs.modelstudio.console.alibabacloud.com/en/model-studio/model-pricing
    cache_fields_to_log:
      - cached_tokens
acceptance_gate:
  sample_size: 100
  minimum_quality_pass_rate: ""
  maximum_retry_rate: ""
  maximum_p95_latency: ""
  maximum_cost_per_accepted_task: ""
rollback:
  owner: ""
  fallback_model_id: ""
  spend_limit: ""
  review_date: ""
Rekomendasi praktis
Untuk sebagian besar workflow indie yang sensitif biaya, mulailah dengan urutan ini:
- Uji baris Qwen Flash-family termurah yang tersedia di wilayah yang Anda perlukan.
- Jika workload bersifat async, uji Qwen batch inference.
- Jika prompt memiliki konteks berulang, ukur field cache Qwen dan field cache DeepSeek secara berdampingan.
- Uji
deepseek-flashselama jam off-peak jika setup yang sederhana atau kualitas DeepSeek penting. - Gunakan Plus, Max, atau DeepSeek Pro hanya setelah rute yang lebih murah gagal lolos acceptance test.
- Rutekan melalui shared gateway saat switching, fallback, atau bukti billing menjadi bagian dari biaya operasional.
Jangan menyetujui rute yang paling murah per token input. Setujui rute yang paling murah per tugas yang diterima setelah bukti kualitas, retry, cache, batch, dan rollback dicatat.
Pertanyaan umum
Apakah DeepSeek lebih murah daripada Qwen pada 2026?
Tidak secara universal. Dalam contoh saat ini, Qwen sering menang pada chat sederhana tanpa cache dan pekerjaan yang bisa di-batch, sementara DeepSeek tetap menarik untuk setup langsung yang sederhana, pencatatan cache eksplisit, traffic off-peak, dan workload di mana deepseek-flash lolos kualitas dengan retry yang lebih sedikit.
Apakah Qwen batch inference selalu lebih murah?
Tidak. Qwen batch inference dapat menagih request yang berhasil sebesar 50% dari real-time inference untuk model yang didukung, tetapi job batch bersifat asinkron dan tidak memenuhi syarat untuk beberapa promosi atau diskon cache. Gunakan untuk job offline, bukan panggilan produk yang sensitif terhadap latensi.
Haruskah saya membandingkan DeepSeek Pro dengan Qwen Flash?
Hanya jika keduanya lolos quality gate yang sama. Untuk panduan biaya, bandingkan model termurah yang memenuhi tugas. Jika Qwen Flash gagal tetapi DeepSeek Flash lolos, baris Qwen yang tercantum lebih murah menjadi tidak relevan.
Apakah caching menjamin penghematan?
Tidak. DeepSeek mengatakan cache hit bergantung pada kecocokan unit prefix yang di-cache dan tidak dijamin. Dokumentasi Qwen juga menyatakan probabilitas cache hit implisit tidak dijamin dan harus diverifikasi melalui field usage. Anggap penghematan cache sebagai penghematan yang terukur, bukan penghematan yang dijanjikan.
Di mana Flatkey cocok?
Flatkey berguna setelah pergantian model itu sendiri menjadi biaya. Dengan satu rute yang kompatibel dengan OpenAI, satu saldo, satu invoice, dan log penggunaan, Anda dapat membandingkan DeepSeek, Qwen, dan rute model lain tanpa menyebarkan kunci dan bukti penagihan di berbagai penyedia.
Jawaban akhir
Kesimpulan yang tepat untuk DeepSeek API vs Qwen API untuk Workflow Sensitif Biaya: Panduan Biaya 2026 bukanlah "DeepSeek lebih murah" atau "Qwen lebih murah." Melainkan:
Gunakan Qwen terlebih dahulu untuk workflow sederhana yang berbiaya rendah, dapat di-cache, dan dapat dibatch. Gunakan DeepSeek terlebih dahulu saat penyiapan sederhana, penjadwalan di luar jam sibuk, pencatatan cache-hit langsung, atau kualitas DeepSeek Flash memberi Anda biaya task yang diterima lebih rendah. Gunakan Flatkey ketika biaya pergantian, logging, dan bukti penagihan mulai sama pentingnya dengan harga token.