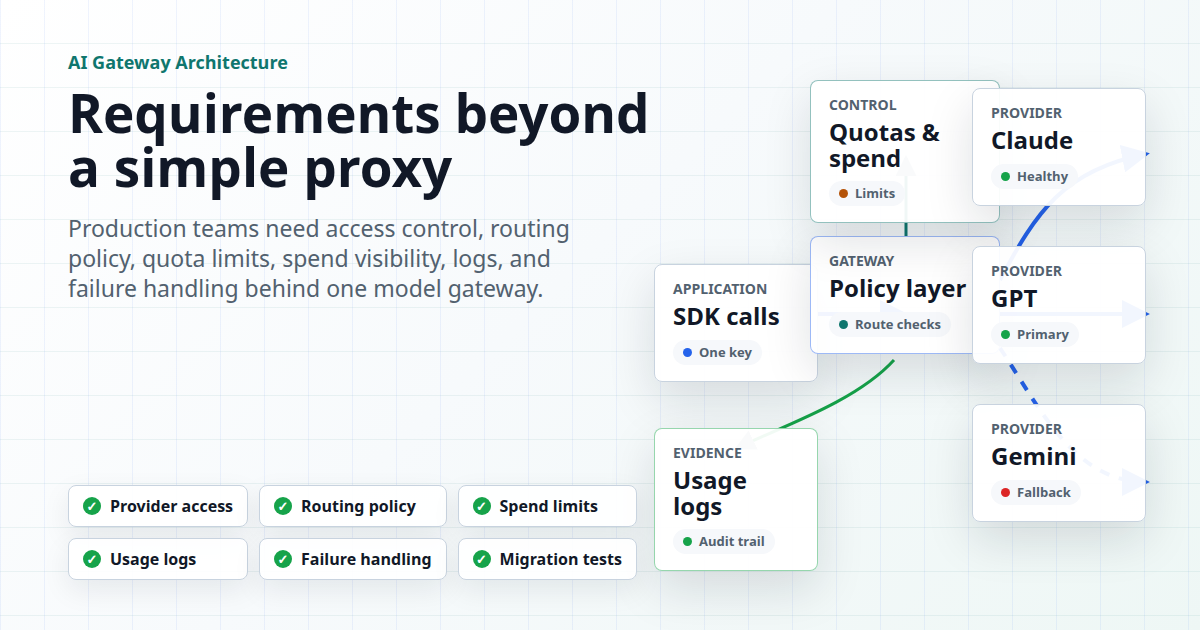
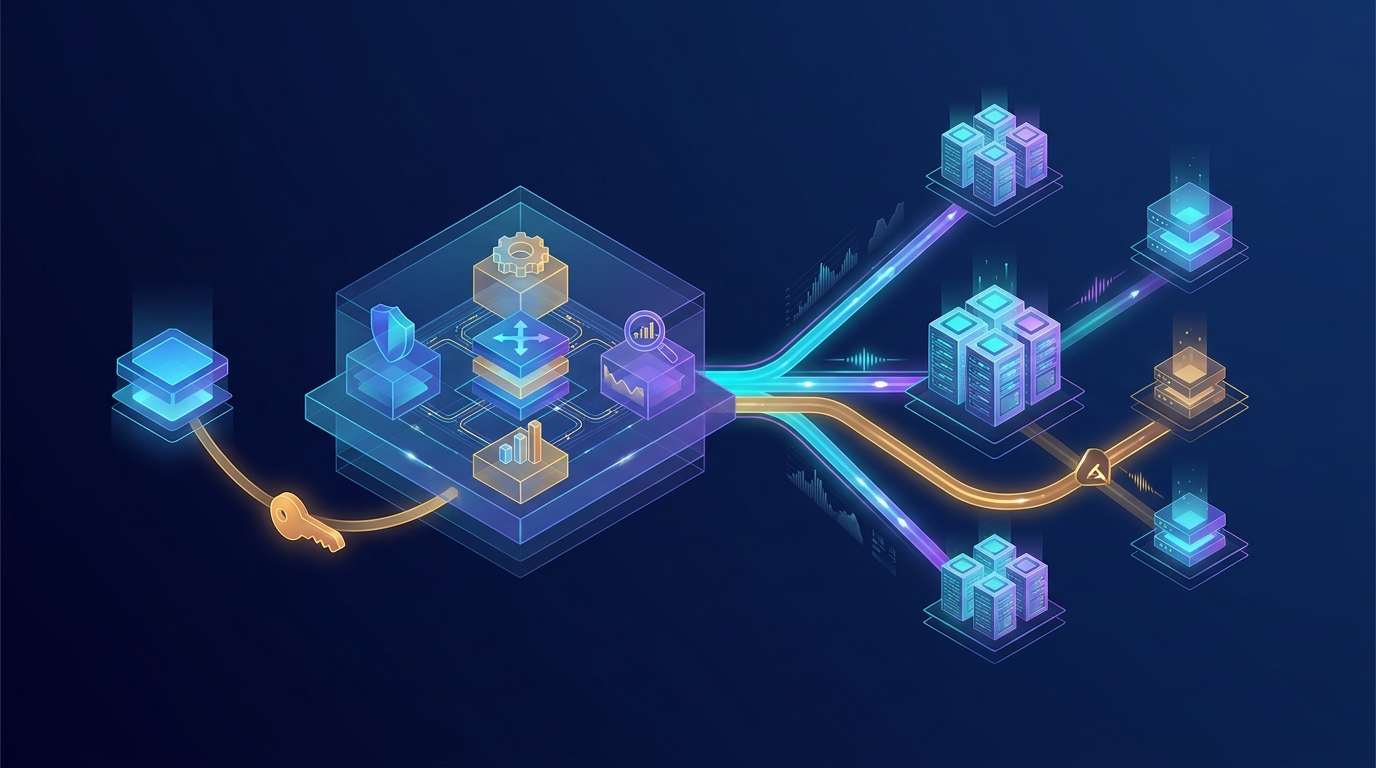
Un proxy inverse et une passerelle API peuvent occuper la même position dans un diagramme de réseau : tous deux reçoivent une requête client avant un backend. La différence réside dans le rôle que vous attendez de cette couche. Un proxy inverse constitue une porte d’entrée utile pour le transfert, la répartition de charge, la terminaison TLS et la protection de l’origine. Une passerelle API traite la requête comme une opération d’API et peut ajouter la gestion des identités, l’autorisation, des quotas, des politiques de routage, l’observabilité et un contrat développeur géré. Aucun de ces termes ne garantit à lui seul une fonctionnalité ; vérifiez le produit et la configuration que vous déployez réellement.
Pour une application d’IA, cette distinction devient concrète lorsque plusieurs modèles, équipes, identifiants et factures convergent vers un même point de terminaison. Ce guide compare le proxy inverse et la passerelle API sur le chemin des requêtes, indique dans quels cas l’un suffit, et fournit une liste de contrôle d’évaluation pour un routeur de modèles compatible avec OpenAI.
La réponse courte
Utilisez un proxy inverse lorsque vous devez exposer en toute sécurité un ou quelques services backend et que votre application gère déjà l’authentification API, la politique d’utilisation et la facturation. Envisagez une passerelle API lorsque plusieurs clients ou services ont besoin d’un contrat API commun avec un contrôle d’accès appliqué de façon centralisée, des politiques de débit ou de budget, du routage, des journaux et une responsabilité opérationnelle. Vous pouvez également placer une passerelle API derrière un proxy inverse ou un CDN ; ces composants ne s’excluent pas mutuellement.
Le guide du proxy inverse NGINX décrit le transfert des requêtes vers des serveurs upstream et l’utilisation du proxy pour l’équilibrage de charge. La présentation d’Amazon API Gateway décrit une porte d’entrée d’API gérée avec gestion du trafic, autorisation, surveillance et gestion des versions d’API. Il s’agit d’exemples de capacités, et non d’une affirmation selon laquelle tous les proxys inverses n’offrent pas de fonctionnalités de politique ou que chaque passerelle les active par défaut.
| Question | Proxy inverse | Passerelle API |
|---|---|---|
| Quel est le rôle principal ? | Recevoir et transférer le trafic vers une origine ou un pool upstream. | Publier et exploiter un contrat API devant les backends. |
| Comment un itinéraire est-il choisi ? | Généralement selon l’hôte, le chemin et la configuration upstream. | L’opération API, l’identité, la politique et l’itinéraire backend configuré peuvent tous entrer en ligne de compte. |
| Qui gère l’authentification ? | Souvent l’application ou une couche d’authentification configurée séparément. | Peut être appliquée au niveau de la passerelle, selon le mécanisme configuré. |
| Comment visualiser l’utilisation ? | Journaux d’accès et métriques du proxy. | Métriques, journaux, quotas et parfois enregistrements de facturation au niveau de l’API ou de la clé. |
| Quel est le travail opérationnel ? | Configuration du proxy, TLS, état de santé des upstreams, mise à l’échelle et journalisation. | Définitions d’API, clés ou identités, politiques, quotas, journaux, versions et réponse aux incidents. |
Suivre une requête à travers chaque conception
Supposons qu’un produit envoie une requête de conversation à un backend de service de modèles.
Avec un proxy inverse, le client se connecte à un nom d’hôte public. Le proxy termine TLS, sélectionne un upstream dans un pool configuré, transfère la requête HTTP et renvoie la réponse. Il peut réessayer ou équilibrer le trafic s’il est configuré pour cela. Le backend ou un autre composant décide toujours si l’utilisateur est autorisé, quel modèle il peut appeler, combien il peut dépenser et comment l’utilisation est attribuée à une équipe.
Avec une passerelle API, le même nom d’hôte public peut en outre identifier l’appelant, vérifier une politique, choisir un itinéraire approuvé, appliquer un objectif de débit et émettre des enregistrements au niveau de la requête. Le backend exécute toujours l’inférence, et la passerelle doit toujours être correctement configurée. Par exemple, AWS documente la limitation du débit avec des paramètres de débit et de rafale, tout en précisant que les quotas sont des objectifs fournis au mieux plutôt que des plafonds absolus. Considérez les termes marketing tels que « limitation de débit » comme un comportement vérifiable, et non comme une garantie automatique.
Il existe un chevauchement. NGINX peut être configuré avec des mécanismes supplémentaires d’authentification et de limitation de débit, et une passerelle API utilise souvent en interne des mécanismes de proxy inverse. Le choix porte donc moins sur la question de savoir si les paquets peuvent être transférés que sur l’endroit où votre équipe souhaite définir, appliquer, observer et gérer la politique API.
Où se place un équilibreur de charge
Un équilibreur de charge choisit parmi les instances backend afin de maintenir un service disponible et de répartir le travail. Il peut fonctionner au niveau de la couche transport ou applicative. Un proxy inverse assure couramment l’équilibrage de charge, mais un équilibreur de charge seul ne vous indique pas quelle clé API appartient à un client ni si un modèle est approuvé pour une équipe. Une passerelle API peut inclure l’équilibrage de charge ou le déléguer à un service upstream.
Utilisez ce test rapide : si le remplacement du composant supprimerait uniquement la distribution du trafic et la gestion TLS, vous évaluez principalement une couche de proxy ou d’équilibrage de charge. S’il supprimait également la politique relative aux appelants, les itinéraires de modèles, les quotas, les preuves d’utilisation et un contrat API, vous évaluez des responsabilités de passerelle.
Pourquoi les API de modèles rendent l’écart visible
Le trafic web ordinaire et le trafic de modèles partagent HTTP, mais les requêtes de modèles
soulèvent des questions opérationnelles supplémentaires. Une seule requête peut diffuser des données en continu pendant une longue
durée, utiliser de nombreux tokens d’entrée et de sortie, appeler des outils ou générer une
image. Deux itinéraires de modèles peuvent avoir des formes de requête, une latence,
une disponibilité et des unités de coût différentes. Un 200 du proxy ne suffit pas
à expliquer si le client a reçu une réponse utile ou quel
modèle a été facturé.
Une évaluation de passerelle API d’IA devrait donc enregistrer au minimum :
- Identité : quelle clé, équipe ou quel service a initié la requête ; si les identifiants peuvent être renouvelés indépendamment.
- Routage : alias de modèle demandé, famille de points de terminaison, route réelle et ce qui se passe lorsqu’elle est indisponible.
- Résultat : statut HTTP, erreur du fournisseur ou du modèle, annulation, délai d’expiration, nouvelle tentative et réponse finale acceptée.
- Utilisation : unités d’entrée et de sortie, événements facturables et source de coût utilisée pour cette route.
- Contrôle : modèles autorisés, périmètre du budget ou du quota, moment de l’application et personne responsable des exceptions.
Un proxy inverse peut transmettre ces champs, mais il ne crée pas un modèle d’utilisation et de facturation partagé simplement en acheminant des octets. Vous pouvez construire cette couche vous-même. La question est de savoir si votre équipe souhaite assumer cette mise en œuvre et son exploitation continue.
Trois modèles de déploiement
1. Proxy inverse devant un service de modèle unique
C’est un bon point de départ pour un service privé avec un seul modèle, une application de confiance et des politiques gérées dans l’application. Conservez au proxy la responsabilité de l’entrée, de TLS, de la disponibilité de l’amont et de la journalisation élémentaire des requêtes. Conservez les secrets côté serveur. Définissez des délais d’expiration qui respectent le streaming et les longues requêtes d’inférence, et testez l’annulation afin que les flux abandonnés ne consomment pas des ressources indéfiniment.
Le mode de défaillance consiste à laisser le proxy devenir une collection non documentée d’alias de modèles, de clés par équipe, de nouvelles tentatives, de règles de dépenses et d’en-têtes ponctuels. Si ces fonctionnalités s’accumulent, documentez le contrat et testez-le comme une passerelle.
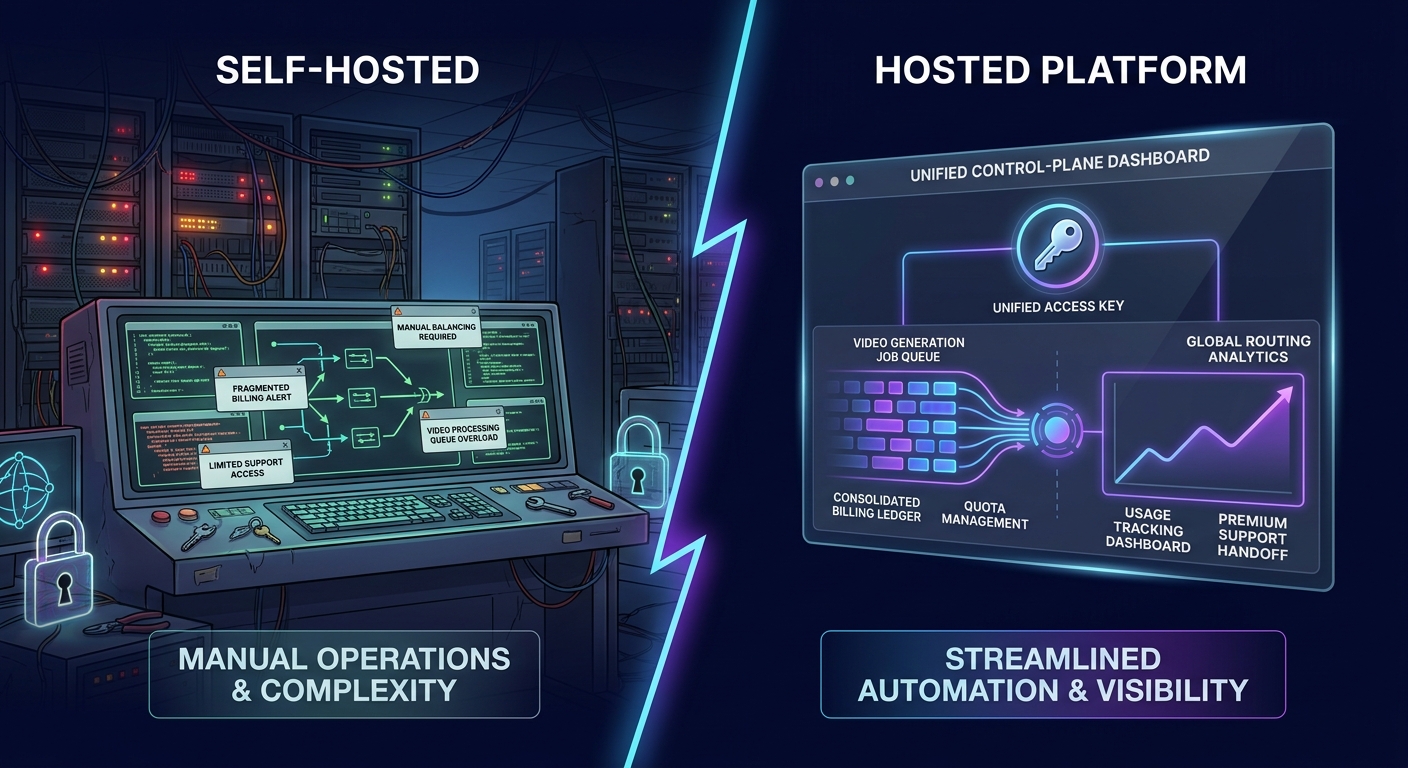
2. Passerelle API auto-exploitée ou routeur de modèles
Choisissez cette option lorsque l’équipe plateforme a besoin de politiques personnalisées, d’un positionnement réseau, de la propriété des comptes en amont ou d’un contrôle approfondi des journaux et du routage. Prévoyez le stockage des identifiants, les besoins en base de données ou en état, les mises à niveau, la surveillance, les sauvegardes, les contrôles contre les abus et un responsable d’astreinte. Un point de terminaison compatible OpenAI réduit le travail de migration des clients, mais il ne supprime pas la charge d’exploitation de la passerelle.
Pour une comparaison distincte entre achat et développement, consultez notre guide sur les passerelles d’IA gérées et les proxys LLM auto-hébergés. Ce guide traite de la propriété et des coûts ; la présente comparaison porte sur les responsabilités réseau et API.
3. Passerelle API d’IA gérée, éventuellement derrière votre proxy edge
Ce modèle est pertinent lorsque les équipes ont besoin d’une couche unique d’accès aux modèles sans exploiter elles-mêmes le service de passerelle. La documentation de Flatkey décrit un routeur compatible OpenAI, l’accès aux modèles, les contrôles des clés et de l’utilisation, ainsi que la visibilité sur la facturation. Une équipe peut conserver son propre edge ou backend d’application tout en utilisant Flatkey comme API de modèle en amont. Confirmez les alias de modèles du compte actuel, la prise en charge des points de terminaison, les limites, la tarification et le comportement des politiques avant la mise en production.
L’URL de base est https://router.flatkey.ai/v1 pour la
route compatible OpenAI décrite dans le guide de démarrage
rapide Flatkey. Placez la clé Flatkey dans l’environnement backend, et non dans le
navigateur. Exécutez une petite requête, inspectez Usage & Logs, puis testez
le streaming, les outils, les erreurs et le repli avec la route de modèle exacte que vous
prévoyez d’utiliser.
Un test de migration qui révèle les véritables différences
Choisissez une requête représentative de la production et rejouez-la via les chemins candidats. Conservez fixes le prompt, la révision du modèle, la limite de sortie, le délai d’expiration du client et la charge proposée. Enregistrez la configuration et les résultats, plutôt que de comparer la latence dans le meilleur des cas d’un proxy avec le démarrage à froid d’une passerelle ou un modèle sans rapport.
| Vérification | Éléments à enregistrer | Défaillance importante |
|---|---|---|
| Authentification | Clé de l’appelant, autorisation, procédure de renouvellement | La mauvaise équipe peut appeler un modèle ou une clé révoquée fonctionne encore. |
| Routage | Modèle demandé et servi, forme du point de terminaison | Un repli modifie silencieusement les capacités ou le coût. |
| Streaming | Premier jeton, réponse complète, annulation | Le proxy met le flux en tampon ou laisse le travail s’exécuter après l’annulation. |
| Limites | Débit soutenu, pic, budget, fenêtre de réinitialisation | La surcharge atteint le modèle ou un quota bloque un trafic sain. |
| Observabilité | ID de requête, statut, utilisation, coût, latence | Vous ne pouvez pas expliquer un frais ou une requête échouée. |
| Récupération | Délai d’expiration, erreur en amont, plafond de nouvelles tentatives | Une seule requête se propage en nouvelles tentatives facturables sans limite. |
Mesurez ensuite le coût par réponse acceptée, la latence p95, le taux d’erreur et l’effort opérationnel. Une faible surcharge de proxy est précieuse, mais elle ne remplace pas les politiques ou les preuves d’utilisation manquantes. Une passerelle riche en fonctionnalités est utile uniquement lorsque ses contrôles correspondent à la charge de travail et sont effectivement activés.
Questions fréquentes
Une passerelle API est-elle simplement un proxy inverse ?
Une passerelle API achemine généralement le trafic, elle inclut donc un comportement de proxy. Le terme implique également des responsabilités au niveau de l’API, telles que l’identité de l’appelant, les politiques, le routage, la surveillance et la gestion du cycle de vie. Les capacités réelles varient selon le produit et la configuration.
NGINX peut-il être une passerelle API ?
NGINX peut servir de couche de transfert pour le trafic API et être configuré avec des contrôles de type passerelle. Vérifiez les fonctionnalités précises d’authentification, de quotas, de journalisation et de routage dont vous avez besoin, puis déterminez qui les maintient. Le seul nom d’un produit ne prouve pas la politique déployée.
Une passerelle API remplace-t-elle un répartiteur de charge ?
Pas nécessairement. Une passerelle peut sélectionner un pool en amont tandis qu’un autre répartiteur de charge gère la distribution au niveau des instances. Tracez le chemin réel des requêtes et identifiez quelle couche est responsable des vérifications d’état, des nouvelles tentatives, de TLS et des politiques.
Quand un simple proxy inverse est-il suffisant pour une API d’IA ?
Lorsqu’un seul backend de confiance gère l’autorisation, la sélection des modèles, le comptage de l’utilisation et la facturation, un proxy inverse peut suffire pour l’entrée du trafic. Réexaminez la conception dès que plusieurs équipes, modèles, clients externes ou politiques de dépenses nécessitent une frontière commune.
La décision pratique consiste à attribuer chaque responsabilité à un composant nommé. Si votre diagramme ne peut pas montrer où l’identité, le routage, l’utilisation et le coût sont déterminés, ajouter un autre proxy ne corrigera pas le contrat manquant.