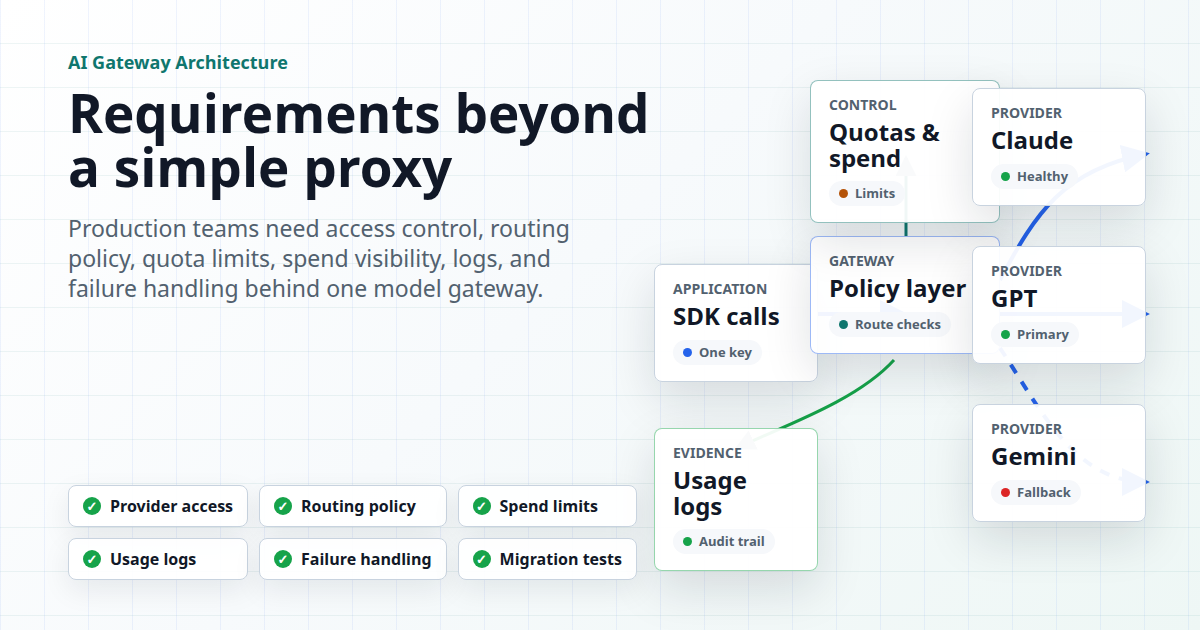
Um proxy reverso e um gateway de API podem ocupar a mesma posição em um diagrama de rede: ambos recebem uma solicitação do cliente antes de um backend. A diferença está na função que você espera que essa camada desempenhe. Um proxy reverso é uma porta de entrada útil para encaminhamento, distribuição de carga, terminação de TLS e proteção da origem. Um gateway de API trata a solicitação como uma operação de API e pode adicionar identidade, autorização, cotas, política de rotas, observabilidade e um contrato de desenvolvedor gerenciado. Nenhum dos rótulos garante um recurso por si só; verifique o produto e a configuração que você realmente implanta.
Para uma aplicação de IA, essa distinção se torna prática quando vários modelos, equipes, credenciais e faturas se encontram em um único endpoint. Este guia compara proxy reverso vs gateway de API no caminho da solicitação, mostra quando um deles é suficiente e oferece uma lista de verificação de avaliação para um roteador de modelos compatível com OpenAI.
A resposta curta
Use um proxy reverso quando precisar expor com segurança um ou alguns serviços de backend e sua aplicação já for responsável pela autenticação da API, política de uso e faturamento. Considere um gateway de API quando vários clientes ou serviços precisarem de um contrato de API comum com acesso aplicado centralmente, política de taxa ou orçamento, roteamento, logs e responsabilidade operacional. Você também pode colocar um gateway de API atrás de um proxy reverso ou CDN; esses componentes não são mutuamente exclusivos.
O guia de proxy reverso do NGINX descreve o encaminhamento de solicitações para servidores a montante e o uso do proxy para balanceamento de carga. A visão geral do Amazon API Gateway descreve uma porta de entrada de API gerenciada com gerenciamento de tráfego, autorização, monitoramento e gerenciamento de versões de API. Esses são exemplos de capacidades, não uma afirmação de que todo proxy reverso não possui recursos de política ou que todo gateway os habilita por padrão.
| Pergunta | Proxy reverso | Gateway de API |
|---|---|---|
| Qual é a função principal? | Receber e encaminhar tráfego para uma origem ou pool a montante. | Publicar e operar um contrato de API na frente dos backends. |
| Como uma rota é escolhida? | Normalmente por configuração de host, caminho e upstream. | A operação de API, a identidade, a política e a rota de backend configurada podem todas ser relevantes. |
| Quem é responsável pela autenticação? | Frequentemente a aplicação ou uma camada de autenticação configurada separadamente. | Pode ser aplicada no gateway, sujeita ao mecanismo configurado. |
| Como você visualiza o uso? | Logs de acesso e métricas do proxy. | Métricas, logs, cotas e, às vezes, registros de faturamento no nível da API ou da chave. |
| Qual é o trabalho operacional? | Configuração do proxy, TLS, integridade dos upstreams, escalonamento e logging. | Definições de API, chaves ou identidades, política, cotas, logs, versões e resposta a incidentes. |
Acompanhe uma solicitação em cada arquitetura
Suponha que um produto envie uma solicitação de chat para um backend que serve modelos.
Com um proxy reverso, o cliente se conecta a um nome de host público. O proxy termina o TLS, seleciona um upstream de um pool configurado, encaminha a solicitação HTTP e retorna a resposta. Ele pode repetir a tentativa ou balancear o tráfego se estiver configurado para isso. O backend ou outro componente ainda decide se o usuário está autorizado, qual modelo pode chamar, quanto pode gastar e como o uso é atribuído a uma equipe.
Com um gateway de API, o mesmo nome de host público pode, adicionalmente, identificar o chamador, verificar uma política, escolher uma rota aprovada, aplicar uma meta de taxa e emitir registros no nível da solicitação. O backend ainda executa a inferência, e o gateway ainda precisa da configuração correta. Por exemplo, a AWS documenta a limitação de solicitações com configurações de taxa e de pico, observando que as cotas são metas de melhor esforço, e não limites absolutos. Trate termos de marketing como “limite de taxa” como um comportamento testável, não como uma garantia automática.
Há sobreposição. O NGINX pode ser configurado com autenticação e limitação de taxa adicionais, e um gateway de API frequentemente usa mecanismos de proxy reverso internamente. Portanto, a escolha diz menos respeito a se os pacotes podem ser encaminhados e mais a onde sua equipe deseja definir, aplicar, observar e assumir a responsabilidade pela política de API.
Onde um balanceador de carga se encaixa
Um balanceador de carga escolhe entre instâncias de backend para manter um serviço disponível e distribuir o trabalho. Ele pode operar na camada de transporte ou de aplicação. Um proxy reverso geralmente realiza o balanceamento de carga, mas um balanceador de carga por si só não informa qual chave de API pertence a um cliente ou se um modelo está aprovado para uma equipe. Um gateway de API pode incluir balanceamento de carga ou delegá-lo a um serviço upstream.
Use este teste rápido: se substituir o componente remover apenas a distribuição de tráfego e o tratamento de TLS, você está avaliando principalmente uma camada de proxy ou balanceamento de carga. Se também remover a política do chamador, as rotas de modelos, as cotas, as evidências de uso e um contrato de API, você está avaliando responsabilidades de gateway.
Por que as APIs de modelos tornam a diferença visível
O tráfego web comum e o tráfego de modelos compartilham HTTP, mas as solicitações
de modelos trazem questões operacionais adicionais. Uma única solicitação pode fazer
streaming por muito tempo, usar muitos tokens de entrada e saída, chamar ferramentas ou
gerar uma imagem. Duas rotas de modelos podem ter diferentes formatos de solicitação,
latência, disponibilidade e unidades de custo. Um 200 do proxy não é
suficiente para explicar se o cliente recebeu uma resposta útil ou qual modelo foi
cobrado.
Portanto, uma avaliação de gateway de API de IA deve registrar pelo menos:
- Identidade: qual chave, equipe ou serviço iniciou a solicitação; se as credenciais podem ser rotacionadas de forma independente.
- Rota: alias de modelo solicitado, família de endpoints, rota real e o que acontece quando ela não está disponível.
- Resultado: status HTTP, erro do provedor ou do modelo, cancelamento, tempo limite, nova tentativa e resposta final aceita.
- Uso: unidades de entrada e saída, eventos faturáveis e a fonte de custo usada para essa rota.
- Controle: modelos permitidos, escopo de orçamento ou cota, momento da aplicação e a pessoa responsável pelas exceções.
Um proxy reverso pode encaminhar esses campos, mas não cria um modelo acordado de uso e faturamento apenas ao encaminhar bytes. Você pode criar essa camada por conta própria. A questão é se sua equipe quer assumir a responsabilidade por essa implementação e por sua operação contínua.
Três padrões de implantação
1. Proxy reverso na frente de um serviço de modelo
Este é um bom ponto de partida para um serviço privado com um modelo, uma aplicação confiável e políticas tratadas na aplicação. Mantenha o proxy responsável pela entrada, TLS, saúde do upstream e registro básico de solicitações. Mantenha os segredos no servidor. Defina tempos limite que respeitem o streaming e as solicitações de inferência longas e teste o cancelamento para que streams abandonados não consumam recursos indefinidamente.
O modo de falha é deixar que o proxy se torne uma coleção não documentada de aliases de modelos, chaves por equipe, novas tentativas, regras de gastos e cabeçalhos pontuais. Se esses recursos se acumularem, documente o contrato e teste-o como um gateway.
2. Gateway de API gerenciado pela própria equipe ou roteador de modelos
Escolha esta opção quando a equipe de plataforma precisar de políticas personalizadas, posicionamento na rede, propriedade das contas upstream ou controle profundo sobre logs e roteamento. Reserve orçamento para armazenamento de credenciais, requisitos de banco de dados ou estado, atualizações, monitoramento, backups, controles de abuso e um responsável de plantão. Um endpoint compatível com OpenAI reduz o trabalho de migração dos clientes, mas não elimina a carga operacional do gateway.
Para uma comparação separada entre comprar e desenvolver, consulte nosso guia sobre gateway de IA gerenciado versus proxy LLM auto-hospedado. Esse guia aborda propriedade e custo; a comparação atual trata das responsabilidades de rede e API.
3. Gateway de API de IA gerenciado, opcionalmente atrás do seu proxy de borda
Esse padrão faz sentido quando as equipes precisam de uma camada única de acesso a modelos sem operar o serviço de gateway por conta própria. A documentação da Flatkey descreve um roteador compatível com OpenAI, acesso a modelos, controles de chaves e uso e visibilidade de faturamento. Uma equipe pode manter sua própria borda ou backend de aplicação enquanto usa a Flatkey como a API de modelos upstream. Confirme os aliases de modelos, suporte a endpoints, limites, preços e comportamento de políticas da conta atual antes da mudança para produção.
A URL base é https://router.flatkey.ai/v1 para a
rota compatível com OpenAI descrita no guia rápido
da Flatkey. Coloque a chave da Flatkey no ambiente do backend, não no
navegador. Execute uma pequena solicitação, inspecione Uso & Logs e, em seguida, teste
streaming, ferramentas, erros e fallback com a rota exata de modelo que
pretende usar.
Um teste de migração que revela as diferenças reais
Escolha uma solicitação representativa de produção e reproduza-a pelos caminhos candidatos. Mantenha fixos o prompt, a revisão do modelo, o limite de saída, o tempo limite do cliente e a carga oferecida. Registre a configuração e os resultados, em vez de comparar a latência no melhor cenário de um proxy com a inicialização a frio de um gateway ou com um modelo não relacionado.
| Verificação | O que registrar | Falha relevante |
|---|---|---|
| Autenticação | Chave do chamador, permissão, caminho de rotação | A equipe errada pode chamar um modelo ou uma chave revogada ainda funciona. |
| Roteamento | Modelo solicitado e servido, formato do endpoint | Um fallback altera silenciosamente a capacidade ou o custo. |
| Streaming | Primeiro token, resposta completa, cancelamento | O proxy armazena o stream em buffer ou deixa o trabalho em execução após o cancelamento. |
| Limites | Taxa sustentada, pico, orçamento, janela de redefinição | A sobrecarga chega ao modelo ou uma cota bloqueia tráfego saudável. |
| Observabilidade | ID da solicitação, status, uso, custo, latência | Você não consegue explicar uma cobrança ou uma solicitação com falha. |
| Recuperação | Tempo limite, erro upstream, limite de novas tentativas | Uma única solicitação se ramifica em novas tentativas faturáveis ilimitadas. |
Em seguida, meça o custo por resposta aceita, a latência p95, a taxa de erros e o esforço operacional. Uma baixa sobrecarga do proxy é valiosa, mas não substitui políticas ou evidências de uso ausentes. Um gateway rico em recursos é valioso apenas quando seus controles correspondem à carga de trabalho e estão realmente habilitados.
Perguntas frequentes
Um gateway de API é apenas um proxy reverso?
Um gateway de API geralmente encaminha tráfego, portanto inclui comportamento de proxy. O termo também implica responsabilidades no nível da API, como identidade do chamador, políticas, roteamento, monitoramento e gerenciamento do ciclo de vida. As capacidades reais variam conforme o produto e a configuração.
O NGINX pode ser um gateway de API?
O NGINX pode servir como a camada de encaminhamento para o tráfego de API e pode ser configurado com controles semelhantes aos de um gateway. Verifique os recursos exatos de autenticação, cota, registro em log e rotas de que você precisa e, em seguida, considere quem os mantém. Um nome de produto, por si só, não comprova a política implementada.
Um gateway de API substitui um balanceador de carga?
Não necessariamente. Um gateway pode selecionar um pool upstream enquanto outro balanceador de carga lida com a distribuição no nível das instâncias. Desenhe o caminho real da solicitação e identifique qual camada é responsável pelas verificações de integridade, tentativas, TLS e políticas.
Quando um proxy reverso simples é suficiente para uma API de IA?
Quando um único backend confiável é responsável pela autorização, seleção de modelo, medição de uso e faturamento, um proxy reverso pode ser suficiente para a entrada de tráfego. Reveja o projeto assim que várias equipes, modelos, clientes externos ou políticas de gastos precisarem de um limite comum.
A decisão prática é atribuir cada responsabilidade a um componente nomeado. Se o seu diagrama não consegue mostrar onde identidade, rota, uso e custo são decididos, adicionar outra caixa de proxy não corrigirá o contrato ausente.