Un proxy inverso y un gateway de API pueden ocupar la misma posición en un diagrama de red: ambos reciben una solicitud de cliente antes de que lo haga un backend. La diferencia es la función que se espera que realice esa capa. Un proxy inverso es una puerta de entrada útil para el reenvío, la distribución de carga, la terminación de TLS y la protección del origen. Un gateway de API trata la solicitud como una operación de API y puede añadir identidad, autorización, cuotas, políticas de enrutamiento, observabilidad y un contrato de desarrollador gestionado. Ninguna etiqueta garantiza una característica por sí sola; revise el producto y la configuración que realmente implementa.
Para una aplicación de IA, esa distinción se vuelve práctica cuando varios modelos, equipos, credenciales y facturas convergen en un único endpoint. Esta guía compara proxy inverso vs gateway de API en la ruta de la solicitud, muestra cuándo uno es suficiente y ofrece una lista de verificación de evaluación para un enrutador de modelos compatible con OpenAI.
La respuesta corta
Use un proxy inverso cuando necesite exponer de forma segura uno o unos pocos servicios backend y su aplicación ya se encargue de la autenticación de API, las políticas de uso y la facturación. Considere un gateway de API cuando varios clientes o servicios necesiten un contrato de API común con acceso aplicado de forma centralizada, políticas de tasa o presupuesto, enrutamiento, registros y responsabilidad operativa. También puede colocar un gateway de API detrás de un proxy inverso o CDN; estos componentes no son mutuamente excluyentes.
La guía de proxy inverso de NGINX describe el reenvío de solicitudes a servidores upstream y el uso del proxy para el equilibrio de carga. La descripción general de Amazon API Gateway describe una puerta de entrada de API gestionada con gestión de tráfico, autorización, monitorización y gestión de versiones de API. Estos son ejemplos de capacidades, no una afirmación de que todo proxy inverso carezca de funciones de políticas o que todo gateway las habilite de forma predeterminada.
| Pregunta | Proxy inverso | Gateway de API |
|---|---|---|
| ¿Cuál es la función principal? | Recibir y reenviar tráfico a un origen o grupo upstream. | Publicar y operar un contrato de API delante de los backends. |
| ¿Cómo se elige una ruta? | Normalmente mediante la configuración de host, ruta y upstream. | La operación de API, la identidad, la política y la ruta de backend configurada pueden tener importancia. |
| ¿Quién se encarga de la autenticación? | A menudo la aplicación o una capa de autenticación configurada por separado. | Puede aplicarse en el gateway, según el mecanismo que se haya configurado. |
| ¿Cómo se visualiza el uso? | Registros de acceso y métricas del proxy. | Métricas, registros, cuotas y, en ocasiones, registros de facturación a nivel de API o clave. |
| ¿Cuál es el trabajo operativo? | Configuración del proxy, TLS, estado de los upstreams, escalado y registro. | Definiciones de API, claves o identidades, políticas, cuotas, registros, versiones y respuesta a incidentes. |
Siga una solicitud a través de cada diseño
Suponga que un producto envía una solicitud de chat a un backend que sirve modelos.
Con un proxy inverso, el cliente se conecta a un nombre de host público. El proxy termina TLS, selecciona un upstream de un grupo configurado, reenvía la solicitud HTTP y devuelve la respuesta. Puede reintentar o equilibrar el tráfico si está configurado para hacerlo. El backend u otro componente aún decide si el usuario está autorizado, qué modelo puede llamar, cuánto puede gastar y cómo se atribuye el uso a un equipo.
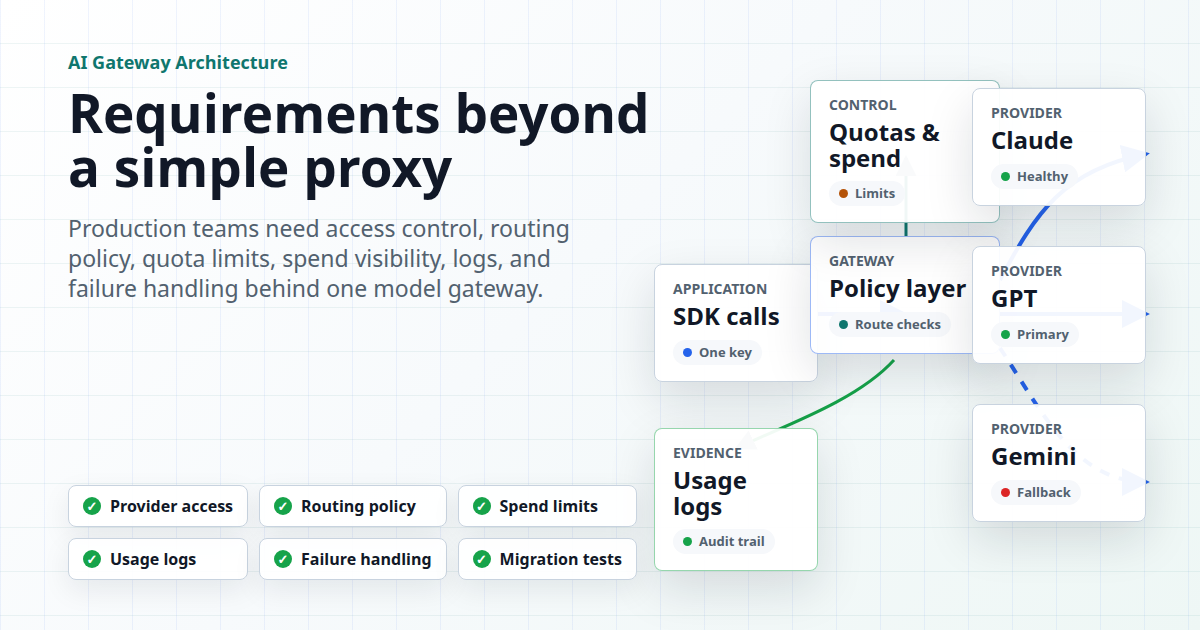
Con un gateway de API, el mismo nombre de host público puede además identificar al solicitante, comprobar una política, elegir una ruta aprobada, aplicar un objetivo de tasa y emitir registros a nivel de solicitud. El backend sigue ejecutando la inferencia, y el gateway sigue necesitando una configuración correcta. Por ejemplo, AWS documenta la limitación de velocidad con configuraciones de tasa y ráfaga, al tiempo que señala que las cuotas son objetivos de máximo esfuerzo y no límites absolutos. Trate las palabras de marketing como «límite de tasa» como un comportamiento comprobable, no como una garantía automática.
Hay solapamiento. NGINX se puede configurar con autenticación adicional y limitación de tasa, y un gateway de API suele utilizar internamente mecanismos de proxy inverso. Por tanto, la elección tiene menos que ver con si se pueden reenviar paquetes y más con dónde quiere su equipo definir, aplicar, observar y asumir la responsabilidad de las políticas de API.
Dónde encaja un balanceador de carga
Un balanceador de carga elige entre instancias de backend para mantener un servicio disponible y distribuir el trabajo. Puede operar en una capa de transporte o de aplicación. Un proxy inverso suele realizar equilibrio de carga, pero un balanceador de carga por sí solo no le indica qué clave de API pertenece a un cliente ni si un modelo está aprobado para un equipo. Un gateway de API puede incluir equilibrio de carga o delegarlo en un servicio upstream.
Use esta prueba rápida: si reemplazar el componente eliminaría únicamente la distribución de tráfico y el manejo de TLS, está evaluando principalmente una capa de proxy o equilibrio de carga. Si también eliminaría las políticas del solicitante, las rutas de modelos, las cuotas, la evidencia de uso y un contrato de API, está evaluando responsabilidades de gateway.
Por qué las API de modelos hacen visible la diferencia
El tráfico web convencional y el tráfico de modelos comparten HTTP, pero las solicitudes de modelos
tienen cuestiones operativas adicionales. Una sola solicitud puede transmitir datos durante mucho
tiempo, usar muchos tokens de entrada y salida, llamar herramientas o generar una
imagen. Dos rutas de modelos pueden tener diferentes formas de solicitud, latencia,
disponibilidad y unidades de coste. Un 200 del proxy no es
suficiente para explicar si el cliente recibió una respuesta útil o qué
modelo se cobró.
Por lo tanto, una evaluación de gateway de API de IA debe registrar como mínimo:
- Identidad: qué clave, equipo o servicio inició la solicitud; si las credenciales pueden rotarse de forma independiente.
- Ruta: alias de modelo solicitado, familia de endpoints, ruta real y qué ocurre cuando no está disponible.
- Resultado: estado HTTP, error del proveedor o del modelo, cancelación, tiempo de espera, reintento y respuesta final aceptada.
- Uso: unidades de entrada y salida, eventos facturables y la fuente de costes utilizada para esa ruta.
- Control: modelos permitidos, ámbito de presupuesto o cuota, momento de aplicación y la persona responsable de las excepciones.
Un proxy inverso puede transmitir estos campos, pero no crea un modelo acordado de uso y facturación simplemente reenviando bytes. Puede construir esa capa usted mismo. La cuestión es si su equipo quiere asumir esa implementación y su operación continua.
Tres patrones de implementación
1. Proxy inverso delante de un servicio de modelo
Este es un buen punto de partida para un servicio privado con un modelo, una aplicación de confianza y políticas gestionadas en la aplicación. Mantenga el proxy responsable del tráfico entrante, TLS, la disponibilidad del upstream y el registro básico de solicitudes. Mantenga los secretos en el servidor. Defina tiempos de espera que respeten el streaming y las solicitudes de inferencia largas, y pruebe la cancelación para que los streams abandonados no consuman recursos indefinidamente.
El modo de fallo consiste en permitir que el proxy se convierta en una colección no documentada de alias de modelos, claves por equipo, reintentos, reglas de gasto y cabeceras puntuales. Si esas funciones se acumulan, documente el contrato y pruébelo como un gateway.
2. Gateway de API autogestionado o enrutador de modelos
Elija esta opción cuando el equipo de plataforma necesite políticas personalizadas, ubicación en la red, propiedad de las cuentas upstream o un control profundo sobre los registros y el enrutamiento. Presupueste el almacenamiento de credenciales, los requisitos de base de datos o estado, actualizaciones, monitorización, copias de seguridad, controles contra abusos y una persona responsable de guardia. Un endpoint compatible con OpenAI reduce el trabajo de migración de clientes, pero no elimina la carga operativa del gateway.
Para una comparación independiente entre comprar y desarrollar, consulte nuestra guía sobre gateway de IA gestionado frente a proxy LLM autohospedado. Esa guía analiza la propiedad y el coste; la presente comparación trata sobre las responsabilidades de red y API.
3. Gateway de API de IA gestionado, opcionalmente detrás de su proxy perimetral
Este patrón tiene sentido cuando los equipos necesitan una capa única de acceso a modelos sin operar ellos mismos el servicio de gateway. La documentación de Flatkey describe un enrutador compatible con OpenAI, acceso a modelos, controles de claves y uso, y visibilidad de facturación. Un equipo puede mantener su propio perímetro o backend de aplicación mientras utiliza Flatkey como API de modelos upstream. Confirme los alias de modelo, la compatibilidad de endpoints, los límites, los precios y el comportamiento de las políticas de la cuenta actual antes de la puesta en producción.
La URL base es https://router.flatkey.ai/v1 para la
ruta compatible con OpenAI descrita en la guía rápida de
Flatkey. Coloque la clave de Flatkey en el entorno del backend, no en el
navegador. Ejecute una solicitud pequeña, revise Uso y registros y, a continuación, pruebe
el streaming, las herramientas, los errores y el fallback con la ruta exacta del modelo que
pretende utilizar.
Una prueba de migración que revela las diferencias reales
Elija una solicitud con características de producción y reprodúzcala a través de las rutas candidatas. Mantenga fijos el prompt, la revisión del modelo, el límite de salida, el tiempo de espera del cliente y la carga ofrecida. Registre la configuración y los resultados, en lugar de comparar la latencia en el mejor caso de un proxy con el arranque en frío de un gateway o con un modelo no relacionado.
| Comprobación | Qué registrar | Fallo relevante |
|---|---|---|
| Autenticación | Clave del solicitante, permiso, ruta de rotación | Un equipo incorrecto puede llamar a un modelo o una clave revocada sigue funcionando. |
| Enrutamiento | Modelo solicitado y servido, formato del endpoint | Un fallback cambia silenciosamente la capacidad o el coste. |
| Streaming | Primer token, respuesta completa, cancelación | El proxy almacena el stream en búfer o deja trabajo ejecutándose después de la cancelación. |
| Límites | Tasa sostenida, ráfaga, presupuesto, ventana de restablecimiento | La sobrecarga llega al modelo o una cuota bloquea tráfico saludable. |
| Observabilidad | ID de solicitud, estado, uso, coste, latencia | No puede explicar un cargo o una solicitud fallida. |
| Recuperación | Tiempo de espera, error upstream, límite de reintentos | Una sola solicitud se ramifica en reintentos facturables sin límite. |
A continuación, mida el coste por respuesta aceptada, la latencia p95, la tasa de errores y el esfuerzo operativo. Una baja sobrecarga del proxy es valiosa, pero no sustituye las políticas o las evidencias de uso que faltan. Un gateway con muchas funciones es valioso solo cuando sus controles se ajustan a la carga de trabajo y están realmente habilitados.
Preguntas frecuentes
¿Un gateway de API es solo un proxy inverso?
Un gateway de API normalmente reenvía tráfico, por lo que incluye comportamiento de proxy. El término también implica responsabilidades de nivel de API, como identidad del solicitante, políticas, enrutamiento, monitorización y gestión del ciclo de vida. Las capacidades reales varían según el producto y la configuración.
¿Puede NGINX ser un gateway de API?
NGINX puede servir como capa de reenvío para el tráfico de API y puede configurarse con controles similares a los de un gateway. Verifique las funciones exactas de autenticación, cuotas, registro y rutas que necesita, y luego tenga en cuenta quién las mantiene. El nombre de un producto por sí solo no demuestra la política implementada.
¿Un gateway de API sustituye a un balanceador de carga?
No necesariamente. Un gateway puede seleccionar un grupo upstream mientras otro balanceador de carga se encarga de la distribución a nivel de instancia. Trace la ruta real de la solicitud e identifique qué capa gestiona las comprobaciones de estado, los reintentos, TLS y las políticas.
¿Cuándo basta un proxy inverso simple para una API de IA?
Cuando un único backend de confianza se encarga de la autorización, la selección de modelos, la medición del uso y la facturación, un proxy inverso puede ser suficiente para la entrada. Revise el diseño en cuanto varios equipos, modelos, clientes externos o políticas de gasto necesiten un límite común.
La decisión práctica consiste en asignar cada responsabilidad a un componente identificado. Si su diagrama no puede mostrar dónde se deciden la identidad, la ruta, el uso y el coste, añadir otra capa de proxy no solucionará el contrato que falta.