Triển khai song song chuyên gia vLLM cho DeepSeek và các mô hình MoE khác
Song song chuyên gia vLLM là chế độ triển khai cần dùng khi các lớp chuyên gia của một mô hình MoE nên được phân tách trên nhiều GPU thay vì được xử lý như một nhóm song song tensor lớn. Trong vLLM hiện tại, tùy chọn bật là --enable-expert-parallel. Bạn xác định kích thước song song chuyên gia gián tiếp thông qua các thiết lập song song tensor (TP) và song song dữ liệu (DP): tài liệu vLLM nêu EP_SIZE = TP_SIZE × DP_SIZE.
Chi tiết này rất quan trọng. Nhiều tài liệu vận hành tìm một “cờ kích thước song song chuyên gia vLLM” riêng biệt, rồi cố ép dùng một cờ không thuộc bản dựng đã ghim của họ. Hãy bắt đầu với tùy chọn được hỗ trợ, kiểm tra vllm serve --help trong đúng image bạn sẽ triển khai, và đưa ra lựa chọn TP/DP dựa trên kế hoạch năng lực đã được đo lường.
Cẩm nang này trình bày một lộ trình an toàn từ triển khai DeepSeek MoE trên một nút đến song song chuyên gia vLLM đa nút, bao gồm lựa chọn backend, cân bằng tải chuyên gia, kiểm thử chấp nhận và cô lập lỗi. Nội dung này dành cho các kỹ sư hạ tầng ML và AI, không phải cho bản demo bằng một lệnh.
Lưu ý về phiên bản: Các kernel MoE, phần phụ thuộc và bề mặt CLI của vLLM thay đổi nhanh chóng. Hành vi và các lệnh được ghi lại bên dưới đã được kiểm tra đối chiếu với tài liệu vLLM chính thức vào ngày 16 tháng 10 năm 2026. Hãy ghim image vLLM và xác minh các cờ theo đúng phiên bản đã ghim trước khi triển khai sản xuất.
Câu trả lời ngắn gọn
| Câu hỏi | Câu trả lời thực tế |
|---|---|
| Điều gì bật song song chuyên gia vLLM? | Thêm --enable-expert-parallel vào một triển khai MoE được hỗ trợ. |
| Kích thước EP được chọn như thế nào? | Trong tài liệu song song chuyên gia vLLM hiện tại, nó được tính là TP × DP; hãy đặt --tensor-parallel-size và --data-parallel-size, không dùng cờ kích thước EP được phỏng đoán. |
| Điều gì thay đổi? | Các lớp chuyên gia MoE được phân mảnh trên các rank EP; các lớp attention vẫn tuân theo hành vi TP/DP được ghi trong tài liệu. |
| Khi nào nên sử dụng? | Khi một mô hình MoE, cấu trúc liên kết GPU, fabric truyền thông và lưu lượng yêu cầu biện minh cho việc phân phối công việc chuyên gia. Đây không phải là công tắc tăng tốc chung cho các mô hình dense. |
| Nên bắt đầu từ đâu? | Một nút, bản sửa đổi mô hình cố định, vết lưu lượng cố định và một đường cơ sở không sử dụng EP. |
Hướng dẫn triển khai song song chuyên gia vLLM chính thức là nguồn tham chiếu cho tính năng này. Hướng dẫn mô tả song song chuyên gia là việc phân phối các chuyên gia MoE trên nhiều GPU, thường kết hợp với song song dữ liệu.
Song song chuyên gia vLLM thực sự thay đổi điều gì
Một mô hình MoE định tuyến mỗi token đến một tập con nhỏ trong số nhiều mạng chuyên gia. Không có song song chuyên gia, hành vi MoE được ghi trong tài liệu của vLLM tạo thành một nhóm song song tensor trên DP × TP. Với --enable-expert-parallel, các lớp chuyên gia thay vào đó sử dụng song song chuyên gia, trong khi các lớp attention duy trì hành vi TP/DP riêng.
Để minh họa bằng một cấu trúc liên kết cụ thể, xét TP=2 và DP=4:
| Thành phần | Hành vi song song khi bật EP |
|---|---|
| Các lớp chuyên gia | Một nhóm EP trải trên 8 rank; các chuyên gia được phân phối trên các GPU đó. |
| Các lớp attention | Các nhóm song song tensor gồm 2 GPU trong mỗi nhóm trong số 4 nhóm DP. |
| Kích thước EP hiệu dụng | 2 × 4 = 8. |
Đây là lý do song song chuyên gia vLLM không thay thế cho việc quyết định cách các yếu tố như attention, dung lượng bộ nhớ đệm KV, đồng thời yêu cầu và cấu trúc liên kết mạng kết hợp với nhau. Nó là một phần của thiết kế phục vụ phân tán.
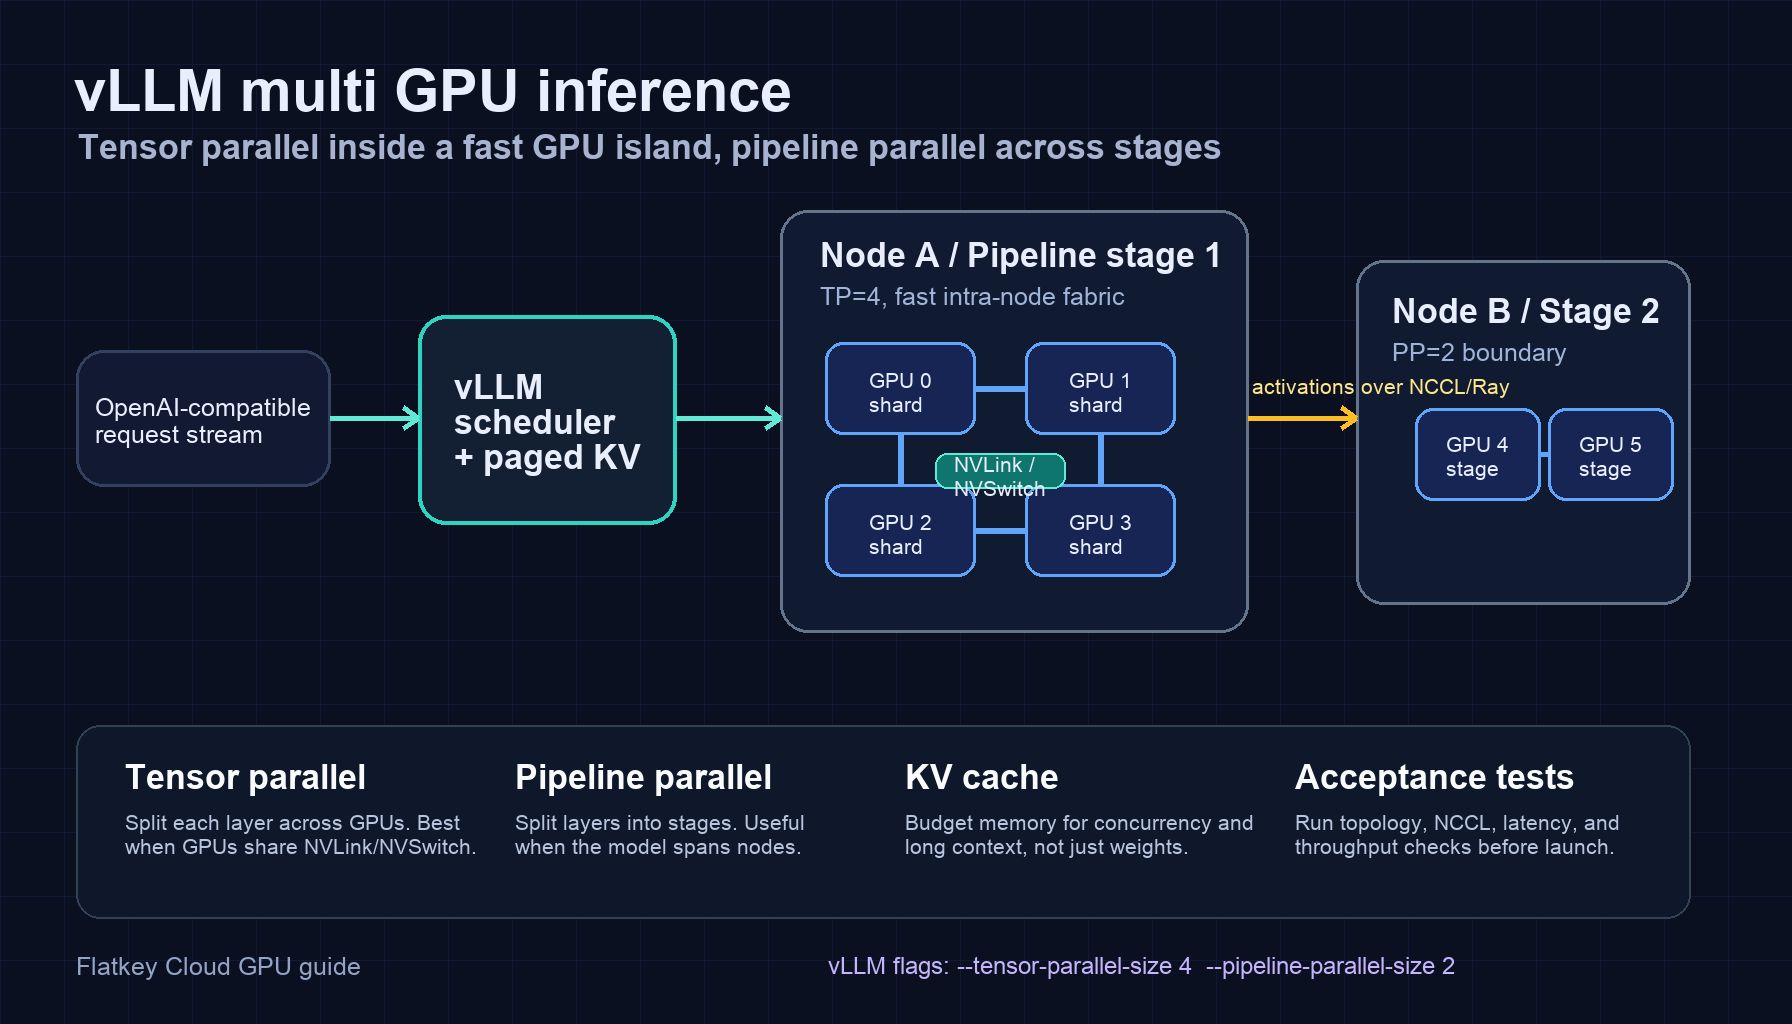
Để có phần nhập môn rộng hơn về mô hình đa GPU nào phù hợp với một khối lượng công việc, xem suy luận đa GPU vLLM: thiết lập song song tensor và pipeline.
Cờ song song chuyên gia vLLM và câu hỏi về “cờ kích thước”
Tài liệu công khai hiện tại đưa ra cờ kích hoạt chuẩn:
--enable-expert-parallel
Tài liệu cũng nêu rằng kích thước song song chuyên gia được tính từ kích thước song song tensor và song song dữ liệu:
EP_SIZE = TP_SIZE × DP_SIZE
Vì vậy, mẫu trong tài liệu triển khai song song chuyên gia vLLM là:
vllm serve <MODEL> --tensor-parallel-size <TP> --data-parallel-size <DP> --enable-expert-parallel
Đừng sao chép tùy chọn --expert-parallel-size riêng biệt từ một issue cũ, một wrapper nội bộ hoặc một ngăn xếp phục vụ khác rồi cho rằng nó áp dụng cho bản dựng vLLM của bạn. Hãy xem câu hỏi “kích thước EP của tôi là bao nhiêu?” như một câu hỏi về cấu trúc liên kết:
- Chọn số GPU và số nút sẵn có cho một nhóm phục vụ.
- Chọn TP cho việc phân mảnh lớp attention và hành vi mô hình cục bộ.
- Chọn DP cho năng lực engine độc lập và phân phối yêu cầu.
- Bật EP cho các lớp MoE.
- Xác nhận cấu trúc liên kết tiến trình đã tính trong nhật ký khởi động và chạy kiểm thử tải.
Tài liệu tham chiếu CLI serve của vLLM là nguồn thẩm quyền cuối cùng về các cờ trong một bản phát hành cụ thể.
Trước khi triển khai: cổng kiểm tra mức độ sẵn sàng
Hãy thực hiện các kiểm tra này trước khi quy lỗi cho song song chuyên gia về vấn đề khởi động hoặc thông lượng.
| Cổng kiểm tra | Cần xác minh | Tại sao điều này quan trọng |
|---|---|---|
| Phiên bản | Cố định container vLLM, ngăn xếp CUDA và phiên bản mô hình trên mọi worker. | Image không đồng nhất hoặc wheel không khớp có thể biến vấn đề topology thành lỗi kernel khó xác định. |
| Mức độ phù hợp của mô hình | Tính đến trọng số mô hình, KV cache, workspace thời gian chạy và mọi expert dự phòng trước khi chọn số lượng GPU. | EP không loại bỏ nhu cầu lập kế hoạch bộ nhớ. |
| Phụ thuộc | Tuân thủ các điều kiện tiên quyết hiện tại của EP-kernel vLLM, bao gồm DeepEP và DeepGEMM ở những nơi tài liệu yêu cầu. | Tài liệu về expert parallel nêu rõ đây là các điều kiện tiên quyết. |
| Fabric | Xác minh topology GPU trên một node và xác minh giao tiếp GPU liên node trước yêu cầu production đầu tiên. | EP bổ sung giao tiếp vào mỗi lượt forward của MoE. |
| Mạng điều khiển | Chỉ định rõ địa chỉ node chính, khả năng truy cập cổng và lựa chọn NIC. | Data plane lành mạnh không giúp ích gì khi quá trình khám phá control plane trỏ đến sai giao diện. |
| Đường cơ sở | Ghi nhận độ trễ, thông lượng, tỷ lệ lỗi và dung lượng bộ nhớ GPU còn lại khi không dùng EP. | Bạn cần một câu trả lời có thể so sánh cho câu hỏi “EP có giúp ích không?” |
Về khía cạnh bộ nhớ của bước kiểm tra này, hãy sử dụng hướng dẫn yêu cầu bộ nhớ GPU cho LLM để lập bảng tính dung lượng trước khi đặt trước một cụm lớn hơn.
Giữ thử nghiệm đầu tiên đơn giản
Sử dụng một phiên bản mô hình, một tokenizer đã biết, một tổ hợp yêu cầu, một phạm vi đồng thời và một tập cờ khởi chạy cố định. Tránh thay đổi lượng tử hóa, cài đặt cache, phần cứng và backend all-to-all trong cùng một bài kiểm tra. Một đường cơ sở rõ ràng giúp xác định liệu vLLM expert parallel có thay đổi thông lượng hữu ích hay chỉ chuyển điểm nghẽn sang nơi khác.
Triển khai DeepSeek MoE trên một node
Hướng dẫn vLLM hiện tại sử dụng DeepSeek-V3-0324 làm ví dụ một node với TP một chiều, DP tám chiều và EP được bật:
vllm serve deepseek-ai/DeepSeek-V3-0324 --tensor-parallel-size 1 --data-parallel-size 8 --enable-expert-parallel
Tài liệu giải thích tác động dự kiến: trọng số attention được sao chép giữa các rank DP, trong khi trọng số expert được phân chia giữa các GPU. Tài liệu dùng một node H200 hoặc H20 tám GPU làm topology ví dụ và khuyến nghị các nhóm có phần cứng khác xác thực mức độ phù hợp của riêng mình thay vì coi ví dụ này là cam kết định cỡ áp dụng chung.
Hãy dùng lệnh đó làm điểm khởi đầu về topology, không phải để sao chép-dán cấu hình production. Trước khi mở một endpoint:
- Xác nhận máy chủ đạt trạng thái sẵn sàng khỏe mạnh mà không có fallback ẩn sang đường dẫn kernel khác.
- Chạy kiểm tra tính đúng đắn với các prompt đã biết và hành vi schema hoặc gọi công cụ dự kiến.
- Tạo một tải ổn định nhỏ, sau đó là một đợt tăng tải và một mẫu ngữ cảnh dài.
- So sánh thời gian đến token đầu tiên p50 và p99, độ trễ giữa các token, thông lượng đầu ra, dung lượng bộ nhớ còn lại và lỗi với đường cơ sở không dùng EP.
- Lưu lệnh khởi chạy, image digest, phiên bản mô hình, phiên bản driver và ảnh chụp metrics cùng với kết quả benchmark.
Nếu bạn vẫn đang xây dựng lớp API xung quanh, hướng dẫn triển khai vLLM này trình bày riêng về đường dẫn máy chủ tương thích OpenAI so với quyết định song song hóa MoE.
Chọn backend all-to-all theo workload, không theo thói quen
vLLM cung cấp --all2all-backend cho giao tiếp expert parallel. Hướng dẫn chính thức hiện mô tả một lựa chọn mặc định đa dụng cùng các chế độ DeepEP chuyên biệt. Hãy ghép backend với lưu lượng mà bạn thực sự đã đo lường.
| Backend | Mức độ phù hợp được tài liệu hóa | Hàm ý triển khai |
|---|---|---|
allgather_reducescatter |
Triển khai EP + DP đa dụng | Một cấu hình đối chứng hợp lý trước khi tinh chỉnh chuyên biệt. |
deepep_high_throughput |
Workload đa node, chủ yếu là prefill | Đánh giá khi prompt dài và thông lượng tổng thể chi phối mục tiêu dịch vụ. |
deepep_low_latency |
Workload đa node, chủ yếu là decode | Đánh giá khi độ trễ token được tạo quan trọng hơn thông lượng prefill tối đa. |
| Các chế độ FlashInfer NVLink | Hệ thống dành riêng cho MNNVL / NVLink | Chỉ sử dụng khi phần cứng và tài liệu vLLM hiện tại đáp ứng các yêu cầu của backend. |
Mục tiêu không phải là chọn nhãn trông nhanh nhất. Mục tiêu là kiểm tra từng backend một với tổ hợp độ dài prompt, mức đồng thời, fabric và SLO của bạn. Hãy đo tác động lên độ trễ đuôi cũng như số token mỗi giây.
vLLM expert parallel đa node: mẫu hai node
Đối với triển khai đa node, tài liệu vLLM sử dụng một node chính xử lý lưu lượng API và một node worker --headless phụ. Phần sau là dạng tham số hóa của mẫu được tài liệu hóa đó. Thay địa chỉ và số lượng bằng các giá trị phù hợp với cụm mà bạn thực sự đã kiểm tra.
Trên node chính:
export GLOO_SOCKET_IFNAME=eth0
vllm serve deepseek-ai/DeepSeek-V3-0324 --all2all-backend deepep_low_latency --tensor-parallel-size 1 --enable-expert-parallel --data-parallel-size 16 --data-parallel-size-local 8 --data-parallel-address <PRIMARY_NODE_IP> --data-parallel-rpc-port 13345 --api-server-count 8
Trên node thứ hai:
export GLOO_SOCKET_IFNAME=eth0
vllm serve deepseek-ai/DeepSeek-V3-0324 --all2all-backend deepep_low_latency --tensor-parallel-size 1 --enable-expert-parallel --data-parallel-size 16 --data-parallel-size-local 8 --data-parallel-start-rank 8 --data-parallel-address <PRIMARY_NODE_IP> --data-parallel-rpc-port 13345 --headless
Các con số rất quan trọng:
--data-parallel-sizelà kích thước DP tổng trên toàn bộ nhóm phục vụ.--data-parallel-size-locallà số hạng DP được khởi chạy trên nút đó.--data-parallel-start-ranklà kích thước DP cục bộ tích lũy của các nút trước đó.- Nút phụ chạy ở chế độ không đầu cuối vì nút chính xử lý các yêu cầu của máy khách.
Đối với các cụm InfiniBand, hướng dẫn vLLM hiện tại nêu rõ GLOO_SOCKET_IFNAME=eth0 để duy trì việc khám phá nhóm phân tán trên giao diện điều khiển Ethernet đã chọn. Điều này không thay thế cho việc xác thực NCCL và giao tiếp GPU-đến-GPU giữa các nút.
Danh sách kiểm tra nghiệm thu đa nút
Trước khi gửi lưu lượng khách hàng đến một nhóm song song chuyên gia vLLM đa nút, hãy chứng minh tất cả các điều sau:
- Mọi worker đều phân giải cùng một phiên bản mô hình và khởi động với rank dự kiến.
- Nút chính có thể truy cập địa chỉ và cổng RPC đã cấu hình từ mọi peer.
- Nhóm phân tán khởi tạo lặp lại được sau khi khởi động lại sạch.
- Một yêu cầu hoàn tất ở mức đồng thời thấp, sau đó dưới một trace duy trì liên tục.
- Một tập hợp yêu cầu được cố ý phân lệch không gây treo âm thầm hoặc sụt giảm độ trễ đuôi.
- Khởi động lại một worker thử nghiệm tạo ra tín hiệu lỗi có thể quan sát và xử lý được, thay vì các yêu cầu bị xếp hàng vô thời hạn.
hướng dẫn khắc phục sự cố phân tán của vLLM khuyến nghị xác minh giao tiếp GPU liên nút và cung cấp các biến môi trường giao tiếp cho mọi nút. Nếu sử dụng Ray, tài liệu cũng nêu việc giữ cấu hình IP máy chủ của vLLM và Ray đồng bộ với nhau.
Chỉ thêm cân bằng tải song song chuyên gia sau khi quan sát thấy mất cân bằng
Định tuyến MoE không phải lúc nào cũng được phân phối đều trong môi trường sản xuất. Bộ cân bằng tải song song chuyên gia (EPLB) của vLLM thu thập dữ liệu tải và định kỳ phân phối lại ánh xạ chuyên gia trên các rank EP. Tính năng này được bật bằng --enable-eplb.
vllm serve Qwen/Qwen3-30B-A3B --enable-expert-parallel --enable-eplb --eplb-config '{"window_size":1000,"step_interval":3000,"num_redundant_experts":2,"log_balancedness":true}'
Hãy bắt đầu không dùng EPLB trừ khi bạn có bằng chứng về các chuyên gia quá tải, khối lượng công việc không đồng đều theo rank hoặc độ trễ đuôi kéo dài tương quan với độ lệch định tuyến. EPLB có thể sử dụng các chuyên gia dự phòng, và các bản sao chuyên gia bổ sung đó tiêu tốn bộ nhớ GPU. Hãy xem đây là một tối ưu hóa có chi phí dung lượng, không phải một cờ song song chuyên gia vLLM bắt buộc.
Đối với thử nghiệm ban đầu:
- Ghi lại mức sử dụng theo rank và độ trễ yêu cầu khi không có EPLB.
- Bật ghi nhật ký mức độ cân bằng trong một cửa sổ được kiểm soát.
- Thêm mức dự phòng nhỏ nhất phù hợp với ngân sách bộ nhớ.
- So sánh độ trễ đuôi, thông lượng, phần bộ nhớ còn lại và mức gián đoạn tái cân bằng dưới cùng một trace.
- Chuẩn bị sẵn lệnh rollback và cấu hình triển khai không dùng EPLB.
Kế hoạch benchmark trả lời đúng câu hỏi
Đừng coi việc triển khai EP thành công chỉ vì tiến trình khởi động. Hãy sử dụng cùng phiên bản mô hình, prompt, giới hạn đầu ra, mức đồng thời, lượng tử hóa, cài đặt bộ nhớ đệm và phân bổ phần cứng cho mọi lần so sánh.
| Kiểm thử | Điều được bộc lộ | Tín hiệu quyết định |
|---|---|---|
| Giải mã prompt ngắn, đồng thời cao | Hành vi collective và hàng đợi phía giải mã | Độ trễ giữa các token p99 và thông lượng token được tạo |
| Prefill prompt dài | Chi phí prefill và all-to-all | Thời gian đến token đầu tiên p99 và thông lượng prefill tổng hợp |
| Trace lệch chuyên gia | Liệu một tập nhỏ chuyên gia có tạo ra các rank quá tải hay không | Mất cân bằng rank, tăng trưởng hàng đợi và lý do sử dụng EPLB |
| Kiểm thử dung lượng ngữ cảnh dài | Phần bộ nhớ còn lại dưới áp lực bộ nhớ đệm thực tế | Tỷ lệ OOM, lỗi tiếp nhận và mức đồng thời an toàn |
| Diễn tập khởi động lại / phân vùng | Hành vi vận hành khi peer gặp lỗi hoặc cổng bị chặn | Thời gian phát hiện, khả năng hiển thị lỗi và đường khôi phục |
Ghi nhận nhiều hơn thông lượng trung bình. Một triển khai cải thiện giá trị trung bình nhưng làm hỏng độ trễ p99 hoặc khiến việc khôi phục trở nên khó thấy rõ không phải là một thắng lợi sản xuất rõ ràng.
Khắc phục sự cố khi triển khai song song chuyên gia vLLM
| Triệu chứng | Nhóm nguyên nhân có khả năng xảy ra | Hành động đầu tiên |
|---|---|---|
Đối số --expert-parallel-size không xác định |
Runbook và vLLM đã cài đặt không khớp nhau | Chạy vllm serve --help, ghim bản dựng và sử dụng cấu hình TP/DP được ghi nhận cho bản dựng đó. |
| Khởi động thất bại quanh kernel EP hoặc backend all-to-all | Thiếu hoặc không tương thích dependency EP / container stack | Kiểm tra lại các điều kiện tiên quyết EP hiện tại và image container thay vì thay đổi nhiều cờ khởi chạy cùng lúc. |
| Worker đa nút bị treo trong quá trình khởi tạo | Địa chỉ control plane, cổng, NIC hoặc cấu hình process group | Xác minh khả năng kết nối, các interface đã chọn, phép tính rank và giao tiếp phân tán trước khi tinh chỉnh kernel. |
| Yêu cầu đầu tiên bị treo sau khi worker hiển thị sẵn sàng | Giao tiếp GPU liên nút không ổn định | Chạy các kiểm tra giao tiếp của nhà cung cấp/vLLM, sau đó kiểm tra cấu hình NCCL và interface. |
| Thông lượng không cải thiện | Hỗn hợp lưu lượng, fabric, hành vi batch hoặc cấu hình phía attention vẫn là nút thắt | So sánh với baseline theo độ dài prompt và mức độ đồng thời; chỉ thay đổi một biến topology mỗi lần. |
| Hết bộ nhớ sau khi bật EPLB | Bộ nhớ dành cho expert dự phòng đã tiêu thụ biên an toàn | Giảm mức dự phòng hoặc dành thêm headroom bộ nhớ; lặp lại kiểm thử năng lực. |
| Một rank liên tục chậm hơn | Độ lệch định tuyến expert hoặc hiệu năng host/fabric không đồng đều | Trước tiên đo tải ở cấp rank; chỉ cân nhắc EPLB nếu bằng chứng ủng hộ điều đó. |
Thói quen quan trọng là chẩn đoán trong phạm vi hẹp. Giữ cố định mô hình, image, dấu vết lưu lượng và topology trong khi thay đổi một yếu tố. Điều đó biến báo cáo mơ hồ “EP chậm” thành một quan sát có thể hành động.
Trình tự triển khai production
- Thiết lập baseline. Chạy mô hình MoE mục tiêu mà không có EP và lưu lại các chỉ số, log và manifest khởi chạy.
- Bật EP trên một nút. Sử dụng
--enable-expert-parallelvới topology TP/DP được lựa chọn rõ ràng. - Xác minh chất lượng và năng lực. Kiểm tra hành vi đầu ra, headroom bộ nhớ, độ trễ p50/p99 và thông lượng duy trì.
- Chọn backend theo hình dạng lưu lượng. Chỉ so sánh backend tổng quát với backend chuyên dụng phù hợp khi dùng cùng một trace.
- Chỉ thêm EPLB khi có bằng chứng. Sử dụng dữ liệu độ cân bằng và headroom bộ nhớ để biện minh cho các expert dự phòng.
- Mở rộng sang đa nút. Xác minh việc phân bổ rank, mạng control và giao tiếp GPU liên nút trước khi tăng lưu lượng.
- Thực hiện diễn tập sự cố. Kiểm tra khởi động lại, mất cổng và worker không khỏe trước khi lưu lượng production phát hiện khoảng trống đó thay bạn.
- Ghim và lập tài liệu. Lưu các phiên bản, cờ khởi chạy, topology, chỉ số và các bước rollback cùng với deployment.
Khi nào không nên tự lưu trữ tầng phục vụ MoE
vLLM expert parallel là khoản đầu tư phù hợp khi quyền kiểm soát việc đặt mô hình, đường dẫn dữ liệu, đặt trước phần cứng và hành vi phục vụ là một phần của yêu cầu sản phẩm. Đây là lựa chọn không phù hợp khi nhóm chủ yếu cần truy cập mô hình và không thể tự đảm trách việc sử dụng GPU, mạng phân tán, kiểm thử nâng cấp và khôi phục khi trực vận hành.
Trước khi đặt trước một cụm lớn hơn, hãy so sánh mô hình vận hành với phương án API được quản lý trong GPU cloud so với model API: khi nào tự lưu trữ thực sự tiết kiệm tiền. Đáp án phù hợp có thể là hybrid: tự lưu trữ khối lượng công việc cần kiểm soát hạ tầng và sử dụng tầng API cho phần còn lại.
Câu hỏi thường gặp
Có phải --enable-expert-parallel sẽ bật vLLM expert parallel không?
Có. CLI vLLM hiện tại ghi nhận --enable-expert-parallel là sử dụng expert parallelism thay vì tensor parallelism cho các lớp MoE.
Cờ kích thước vLLM expert parallel là gì?
Đối với quy trình triển khai hiện được ghi nhận, kích thước EP được suy ra từ --tensor-parallel-size và --data-parallel-size: EP_SIZE = TP × DP. Hãy xác minh chính xác bề mặt CLI trong bản phát hành vLLM đã ghim của bạn thay vì giả định có một cờ kích thước riêng.
Expert parallel có thay thế tensor parallelism ở mọi nơi không?
Không. EP thay đổi chiến lược cho lớp expert MoE. Hành vi của lớp attention vẫn phụ thuộc vào các giá trị TP và DP bạn chọn.
Mọi deployment DeepSeek có nên bật EPLB không?
Không. Trước tiên, hãy chứng minh tình trạng mất cân bằng tải expert dưới lưu lượng đại diện và xác nhận rằng chi phí bộ nhớ của expert dự phòng phù hợp với cụm. EPLB là một tối ưu hóa, không phải yêu cầu mặc định.
Tôi nên dùng backend all-to-all nào?
Hãy bắt đầu từ hướng dẫn vLLM hiện tại, sau đó kiểm thử backend phù hợp với hình dạng workload của bạn: một lựa chọn đa dụng để có khả năng tương thích rộng, chế độ DeepEP thông lượng cao cho lưu lượng thiên về prefill hoặc chế độ DeepEP độ trễ thấp cho lưu lượng thiên về decode.
Tài liệu tham khảo
- Tài liệu Triển khai song song chuyên gia vLLM
- Tài liệu Triển khai song song dữ liệu vLLM
- Tài liệu tham khảo CLI vLLM serve
- Khắc phục sự cố triển khai phân tán vLLM
Bước tiếp theo: sử dụng lệnh một nút làm môi trường xác thực có kiểm soát, ghi lại đường cơ sở và chỉ đưa vào triển khai topology thực sự cải thiện SLO mà bạn quan tâm. Đó là cách song song chuyên gia vLLM trở thành một quyết định cho môi trường production, thay vì một cờ mà bạn hy vọng sẽ nhanh hơn.