
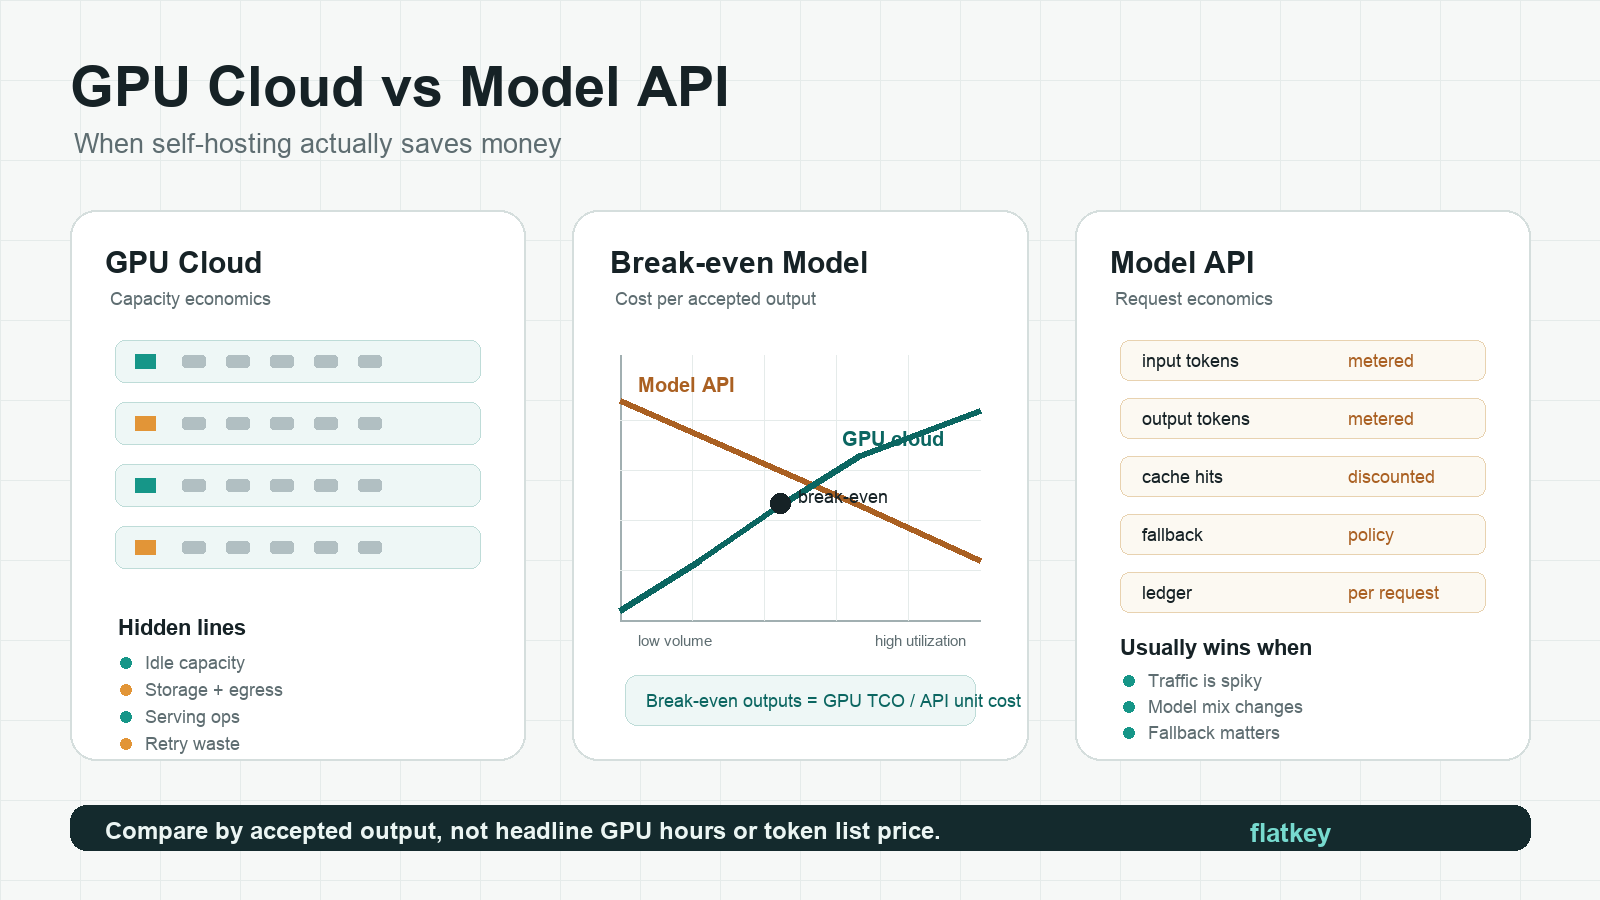
La plupart des équipes posent la question GPU cloud vs API de modèle trop tard. Elles louent des GPU, déploient une pile de serving, ajustent le batching, embauchent du support plateforme, puis seulement ensuite comparent la facture à celle d’une API de modèle gérée. À ce stade, la comparaison est déjà biaisée en faveur de la voie dans laquelle elles ont investi des efforts.
La meilleure question est plus simple : avez-vous besoin de contrôler la couche GPU, ou avez-vous besoin de sorties de modèle fiables au coût accepté le plus bas ?
Pour les équipes IA d’entreprise, le GPU cloud commence à faire économiser de l’argent lorsque vous avez une demande soutenue, un choix de modèle stable, une utilisation utile élevée, et l’équipe d’ingénierie pour faire tourner l’inférence. Une API de modèle est généralement moins chère lorsque le trafic est irrégulier, que le choix du modèle change souvent, que les retries et le basculement comptent plus que le contrôle du matériel, ou que vous avez besoin de modèles de pointe qui ne peuvent pas être auto-hébergés.
Règle pratique de Flatkey : comparez GPU cloud vs API de modèle par coût par sortie acceptée, et non pas uniquement par tarif horaire du GPU ou prix catalogue des tokens.
GPU cloud vs API de modèle : réponse rapide
Utilisez ce tableau avant de créer un tableur.
| Situation | Commencer généralement avec | Pourquoi |
|---|---|---|
| Produit en phase initiale, prompts changeants, demande incertaine | API de modèle | Vous évitez les GPU inactifs pendant que vous apprenez le trafic, la qualité et l’adéquation du modèle. |
| Inférence batch à fort volume sur un seul modèle ouvert stable | GPU cloud | Une utilisation soutenue peut amortir la pile de serving. |
| Chat orienté client avec pics imprévisibles | API de modèle ou hybride | L’autoscaling, le fallback et l’absence de capacité inactive comptent souvent plus que le prix unitaire brut. |
| Poids propriétaires, kernels personnalisés, strict data locality | GPU cloud | Le besoin métier est le contrôle, pas seulement le coût. |
| Routage multi-fournisseurs de modèles, modèles de pointe ou changements fréquents de modèle | API de modèle | Vous évitez de reconstruire l’infrastructure de serving à chaque changement de modèle. |
| Charge de travail stable à long terme avec utilisation prouvée | GPU cloud réservé, cluster GPU dédié ou GPU en colocation | L’engagement peut réduire le coût effectif de capacité une fois la demande confirmée. |
Le reste de ce guide fournit un modèle réutilisable pour comparer GPU cloud vs API de modèle sans masquer le temps d’inactivité, les retries, les opérations ou les filtres de qualité.
L’unité de coût qui compte vraiment
Ne comparez pas :
- le tarif horaire du GPU vs le prix par token.
- une estimation cloud vs un benchmark dans le meilleur des cas.
- le prix catalogue d’une API de modèle vs un cluster auto-hébergé pleinement utilisé.
Comparez plutôt l’un de ces dénominateurs :
| Charge de travail | Meilleur dénominateur |
|---|---|
| Chat LLM ou agents | Coût par réponse acceptée, tâche acceptée ou token de sortie accepté |
| Classification ou extraction batch | Coût par enregistrement accepté |
| Génération de code | Coût par patch accepté ou tâche de codage terminée |
| Génération d’images | Coût par image acceptée après filtres de qualité |
| Génération de vidéo | Coût par seconde acceptée ou clip accepté |
| Fine-tuning ou entraînement | Coût par exécution terminée |
Pour la plupart des équipes d’inférence :
effective_unit_cost =
  all_in_monthly_cost
  / accepted_outputs_after_retries_quality_filters_and_failures
C’est ici que de nombreuses comparaisons GPU cloud vs API de modèle basculent. Un endpoint auto-hébergé peut afficher un excellent débit en benchmark et pourtant perdre si l’utilisation est faible, si le modèle échoue aux contrôles qualité, ou si les ingénieurs passent trop de temps à maintenir la pile en bonne santé.
Modèle de coût d’une API de modèle
Une API de modèle paraît simple parce que la facturation est généralement mesurée par requête, token, image, seconde de vidéo ou appel d’outil. Mais un modèle équitable d’API de modèle nécessite plus que le prix unitaire publié.
Utilisez ce modèle :
monthly_model_api_cost =
  input_token_cost
  + cached_input_or_context_cost
  + output_token_cost
  + tool_or_media_cost
  + retry_and_fallback_cost
  + gateway_or_router_cost
  + observability_and_finops_cost
Puis normalisez :
model_api_cost_per_accepted_output =
  monthly_model_api_cost
  / accepted_outputs
Ce qu’il faut prendre en compte :
| Ligne de coût | À vérifier |
|---|---|
| Tokens d’entrée et de sortie | Page officielle de tarification du fournisseur, ID du modèle, fenêtre de contexte, plafond de sortie et date de vérification. |
| Entrée mise en cache | Si le fournisseur prend en charge le cache de prompts ou les remises sur cache hit, et si votre charge de travail réutilise réellement le contexte. |
| Tarification batch | Si le traitement batch ou asynchrone correspond à votre exigence de latence. |
| Retries | Retries liés aux limites de débit, erreurs transitoires, échecs des contrôles qualité et requêtes de fallback. |
| Couche routeur/gateway | Tout frais de gateway, registre d’utilisation, allowlist de modèles, budget de sous-clés ou workflow de facturation. |
| Opérations | Intégration, monitoring, gestion du statut du fournisseur et réconciliation financière. |
Utilisez les pages sources officielles pour les chiffres actuels, et non des tableaux de tarifs copiés. Commencez avec tarification de l’API OpenAI, tarification d’Anthropic, tarification de l’API Google Gemini, et la page de tarification actuelle de votre gateway ou routeur.
Pour Flatkey, du côté de l’API de modèle, tout repose sur une seule clé, un seul solde et un seul registre d’utilisation pour les modèles et outils officiels. Cela compte lorsque le vrai problème de coût n’est pas un simple appel de modèle, mais des clés dispersées, plusieurs factures, des contrôles budgétaires par équipe et des solutions de repli entre fournisseurs.
Modèle de coût du cloud GPU
Le cloud GPU ne se limite pas au prix horaire du GPU. Une API de modèle auto-hébergée en production implique des coûts de capacité, de logiciel de service, de stockage, de réseau, de supervision, de maintien de la disponibilité et de capacité idle.
Utilisez ce modèle :
monthly_gpu_cloud_cost =
  gpu_compute_hours
  + storage_and_snapshot_cost
  + bandwidth_and_egress_cost
  + load_balancing_and_network_cost
  + serving_stack_cost
  + observability_and_logging_cost
  + platform_engineering_cost
  + support_plan_or_managed_service_cost
  + idle_capacity_cost
  + retry_failure_and_redeployment_waste
Puis normalisez :
self_hosted_cost_per_accepted_output =
  monthly_gpu_cloud_cost
  / accepted_outputs
Ce qu’il faut prendre en compte :
| Ligne de coût | Pourquoi elle change la réponse |
|---|---|
| Modèle GPU et mémoire | Les GPU H100, H200, B200, A100, L40S et de la classe RTX ont des courbes différentes de mémoire, de débit, d’offre et de prix. |
| Mode produit | À la demande, spot, réservé, marketplace, GPU serverless, cluster dédié et bare metal présentent des profils de fiabilité différents. |
| Utilisation | Un endpoint auto-hébergé moins cher perd rapidement si le GPU reste inactif. |
| Stack de service | vLLM, SGLang, TensorRT-LLM, NIM ou des serveurs personnalisés nécessitent un véritable support opérationnel. |
| Stockage et chargement du modèle | De gros poids, des snapshots, des volumes et des chargements répétés peuvent devenir significatifs. |
| Réseau | L’egress, les liaisons privées, les IP publiques et l’équilibrage de charge peuvent modifier l’économie unitaire. |
| Défaillances | Les erreurs de mémoire insuffisante, les préemptions, les mauvais conteneurs et les démarrages à froid augmentent le coût par sortie acceptée. |
Utilisez les pages actuelles des fournisseurs comme points de repère : tarification AWS EC2, instances AWS P5, tarification des GPU Google Cloud, tarification RunPod, Lambda GPU Cloud et tarification Vast.ai.
Traitez chaque prix GPU comme horodaté. L’offre du marketplace, la disponibilité régionale et les devis engagés peuvent évoluer plus vite que l’article que vous lisez.
La formule de seuil de rentabilité
C’est à ce moment que la décision entre cloud GPU et API de modèle devient une décision de niveau finance plutôt qu’une opinion.
Le modèle de seuil de rentabilité le plus simple est :
break_even_outputs =
  monthly_gpu_cloud_cost
  / model_api_cost_per_accepted_output
Si votre charge de travail produit plus de sorties acceptées que break_even_outputs, l’auto-hébergement peut permettre d’économiser. Si elle en produit moins, une API de modèle est probablement moins chère.
Vous pouvez aussi exprimer la même idée en utilisation :
required_utilization =
  monthly_gpu_cloud_cost
  / equivalent_model_api_cost_at_expected_volume
Cette formule n’est utile que si la charge de travail est stable. Si le volume, le modèle, la longueur de contexte ou l’objectif de qualité changent chaque mois, le côté API de modèle a une valeur de flexibilité qu’une formule d’utilisation ne capture pas.
Exemple chiffré : pourquoi le prix horaire du GPU peut induire en erreur
Supposons qu’une équipe doive décider si elle doit auto-héberger un modèle ouvert stable.
| Entrée | Valeur d’exemple |
|---|---|
| Coût GPU cloud tout compris | 24 000 $ par mois |
| Volume de sorties acceptées | 30 millions de sorties acceptées par mois |
| Coût auto-hébergé par sortie acceptée | 0,0008 $ |
| Coût de l’API de modèle par sortie acceptée | 0,0012 $ |
| Coût mensuel de l’API de modèle au même volume | 36 000 $ |
| Économies apparentes de l’auto-hébergement | 12 000 $ par mois |
Dans ce cas de base, le cloud GPU semble permettre d’économiser.
Maintenant, mettons les hypothèses sous tension.
| Changement | Effet |
|---|---|
| L’utilisation utile baisse de 35 % | Le coût unitaire auto-hébergé augmente, car le pool fixe de GPU effectue moins de travail accepté. |
| Le taux de retry ou d’échec qualité double | Les deux approches deviennent plus coûteuses, mais l’auto-hébergement absorbe aussi du gaspillage de capacité. |
| Le produit passe à un modèle plus grand | Les GPU existants peuvent nécessiter du sharding, plus de mémoire ou une nouvelle stack de service. |
| La demande devient irrégulière | L’API de modèle peut s’adapter à la demande ; le pool de GPU doit être dimensionné pour les pics ou accepter des files d’attente. |
Si le scénario défavorable efface les économies, l’auto-hébergement n’est pas réellement moins cher. C’est un pari sur la capacité.
Quand le cloud GPU permet réellement d’économiser
Le cloud GPU peut permettre d’économiser lorsque la plupart de ces conditions sont vraies :
- Vous avez une demande soutenue, pas des pics occasionnels.
- La famille de modèles est stable pendant des mois, pas des jours.
- Le modèle est open-weight ou autrement disponible pour un auto-hébergement.
- La charge de travail présente une utilisation utile élevée après les files d’attente et les échecs.
- Les objectifs de latence peuvent être atteints avec votre pile de service.
- Vous pouvez exécuter vLLM, SGLang, TensorRT-LLM, NIM, ou une autre pile de manière fiable.
- L’équipe peut surveiller l’utilisation des GPU, la pression mémoire, la latence p95/p99, le taux d’erreur et l’amplification des réessais.
- Vous avez un plan pour le chargement des modèles, le préchauffage du cache, l’automatisation de l’arrêt et la sécurité des déploiements.
- Le devis inclut le stockage, l’egress, le support et les hypothèses de disponibilité.
- La finance est à l’aise pour financer la capacité avant l’arrivée de chaque requête.
Ce cas est courant pour l’inférence batch à grand volume, les pipelines d’extraction internes, les bots d’assistance stables, les modèles ouverts spécifiques à un domaine, et les charges de travail où des poids personnalisés ou la proximité des données sont importants.
Pour une planification plus approfondie côté GPU, utilisez les guides de Flatkey sur les prix de location des GPU, le meilleur GPU pour l’inférence LLM, la location de clusters GPU et le TCO d’un cluster GPU.
Quand les API de modèle restent moins chères
Les API de modèle restent généralement moins chères lorsque ces conditions sont réunies :
- Le trafic est en rafales, saisonnier ou encore inconnu.
- L’application a besoin de plusieurs modèles de pointe.
- Le modèle évolue plus vite que votre plan d’infrastructure.
- L’équipe a davantage besoin de mécanismes de repli, de gestion des limites de débit, de factures, de journaux d’utilisation et de contrôles budgétaires que de contrôle matériel.
- Vous ne pouvez pas maintenir les GPU suffisamment occupés pour compenser le temps d’inactivité.
- Vous ne disposez pas d’une équipe plateforme prête à opérer la couche de service.
- La charge de travail inclut des modèles fermés, de la génération multimodale, des capacités propriétaires de fournisseur ou des lancements de modèles en évolution rapide.
- Les achats veulent une attribution par requête plutôt qu’une facture d’infrastructure mutualisée.
C’est là que la comparaison GPU cloud vs API de modèle ne concerne pas seulement le prix. Une API de modèle peut réduire le temps d’intégration, la complexité des achats et la surface d’incident.
Flatkey s’inscrit dans ce versant de la décision lorsque les équipes veulent un seul chemin compatible OpenAI pour de nombreux modèles officiels, un seul solde prépayé, une seule facture, des budgets par sous-clé, des listes d’autorisation de modèles, des enregistrements d’utilisation au niveau des requêtes et un basculement entre canaux amont. Consultez les guides associés sur la comparaison des prix des modèles d’IA, la comparaison des prix des API d’IA, la tarification des passerelles IA et la gestion des dépenses des API d’IA.
L’hybride est souvent la vraie réponse
De nombreuses équipes IA en entreprise ne devraient pas imposer une réponse universelle. Un modèle hybride est souvent plus défendable :
| Segment de charge de travail | Meilleur défaut |
|---|---|
| Inférence stable à fort volume sur open-weight | GPU cloud |
| Raisonnement ou code avec modèle de pointe | API de modèle |
| Tâches batch pouvant attendre en file | GPU cloud, spot ou capacité réservée |
| Pics orientés client | API de modèle ou débordement hybride |
| Poids propriétaires | GPU cloud |
| Exploration de modèles | API de modèle |
| Déploiement réglementé avec contrôle de l’infrastructure | GPU cloud dédié, cloud GPU privé, colocation ou sur site |
Le schéma hybride est le suivant :
- Acheminez les charges de travail inconnues et variables via des API de modèle.
- Benchmarkez les charges de travail stables sur le GPU cloud.
- Ne migrez vers l’auto-hébergement que les charges de travail dont le volume et la stabilité du modèle sont avérés.
- Conservez une solution de repli via API de modèle pour le débordement, les mises à niveau de modèle et la diversité des fournisseurs.
Cette approche évite l’erreur la plus coûteuse : acheter de la capacité GPU pour une charge de travail qui change ensuite de forme.
Plan de benchmark avant de basculer
Faites passer le même trafic par les deux chemins pendant au moins une fenêtre représentative.
| Métrique | Chemin GPU cloud | Chemin API de modèle |
|---|---|---|
| Sorties acceptées | ||
| Jetons d’entrée ou enregistrements | ||
| Jetons de sortie ou résultats | ||
| Latence p50 / p95 / p99 | ||
| Temps jusqu’au premier jeton | ||
| Taux d’erreur | ||
| Taux de réessai | ||
| Taux de rejet qualité | ||
| Capacité inactive | N/A | |
| Heures de travail | ||
| Stockage et egress | ||
| Coût total | ||
| Coût par sortie acceptée |
Puis demandez :
- Le GPU cloud reste-t-il gagnant après le temps d’inactivité ?
- Le reste-t-il après le temps du personnel ?
- Le reste-t-il après les réessais et les filtres de qualité ?
- Le reste-t-il si le modèle change ?
- Le reste-t-il si le trafic chute de 30 % ?
- Le reste-t-il si la latence p95 doit s’améliorer ?
Si la réponse est oui dans le scénario défavorable, l’auto-hébergement mérite un vrai parcours d’achat.
Checklist d’achat
Pour le GPU cloud :
- Quel GPU exact, quelle quantité de mémoire, quel CPU, quelle RAM, quel disque, quelle interconnexion et quelle bande passante réseau sont inclus ?
- La capacité est-elle à la demande, au spot, sur marketplace, en cloud sécurisé, réservée, dédiée ou bare metal ?
- Quels coûts de stockage, de snapshot, d’egress, d’adresse IP publique, de load balancer, de support et d’observabilité sont exclus ?
- Que se passe-t-il en cas de défaillance de l’hôte, de préemption, de maintenance ou de pénurie de capacité ?
- Le fournisseur peut-il exécuter votre benchmark réel avant engagement ?
- Quelle est la durée minimale, la trajectoire de montée en charge et le coût de sortie ?
Pour les API de modèle :
- Quels IDs de modèle exacts, fenêtres de contexte, plafonds de sortie et unités de tarification sont utilisés ?
- Les hits de cache, les jobs batch, les unités image/vidéo et les appels d’outils sont-ils facturés séparément ?
- Quelles sont les limites de débit et les options de repli ?
- Comment sont comptés les retries, les appels au fournisseur ayant échoué et les rejets liés à la qualité ?
- La finance peut-elle exporter l’utilisation par équipe, clé, modèle, environnement et client ?
- Quelles conditions de conservation des données, de conformité et de SLA s’appliquent ?
Liste de vérification des sources
Utilisez ces pages officielles comme points de départ pour les entrées actuelles :
| Type de source | Pages à vérifier |
|---|---|
| Tarification des API de modèle | Tarification de l’API OpenAI, Tarification Anthropic, Tarification de l’API Google Gemini |
| Tarification du cloud GPU | Tarification AWS EC2, Instances AWS P5, Tarification des GPU Google Cloud, Tarification RunPod, Cloud GPU Lambda, Tarification Vast.ai |
| Frameworks de serving | Serveur vLLM compatible OpenAI, Documentation SGLang |
| Spécifications GPU | NVIDIA H100, NVIDIA H200, NVIDIA DGX B200 |
| Structure FinOps | FinOps FOCUS |
| Contexte de coût Flatkey | Tarification Flatkey, Flatkey Compute, Index des prix de Flatkey Compute |
Questions fréquemment posées
Le cloud GPU est-il toujours moins cher qu’une API de modèle ?
Non. Le cloud GPU n’est moins cher que lorsque le niveau d’utilisation utile est suffisamment élevé pour compenser la capacité inutilisée, le stockage, l’egress, les opérations de serving, le gaspillage lié aux retries et le temps du personnel. Une API de modèle peut être moins chère pour des charges de travail irrégulières ou changeantes, même lorsque le prix par token semble plus élevé.
Quand l’auto-hébergement d’un LLM permet-il d’économiser ?
L’auto-hébergement permet d’économiser lorsque le modèle est stable, que le volume est élevé, que l’utilisation est prévisible, que l’équipe peut exploiter la pile de serving et que le coût total du cloud GPU par sortie acceptée est inférieur au coût de l’API de modèle dans des hypothèses défavorables.
Comment comparer la tarification du cloud GPU et celle des API de modèle ?
Comparez le coût par sortie acceptée. Incluez les tokens, les heures GPU, le stockage, la bande passante, le temps d’inactivité, les retries, le taux d’échec, les filtres de qualité, le temps d’ingénierie, le support et les opérations financières. Ne comparez pas seulement le prix horaire du GPU au prix catalogue des tokens.
Quel est le plus gros coût caché de l’inférence sur cloud GPU ?
Les plus gros coûts cachés sont généralement la capacité inutilisée, les opérations d’ingénierie, le stockage et l’egress, les déploiements échoués, les retries liés à des erreurs de mémoire insuffisante et les changements de serving insuffisamment testés. Ces coûts n’apparaissent pas dans le tarif horaire GPU mis en avant.
Quel est le plus gros coût caché des API de modèle ?
Les plus gros coûts cachés sont généralement les retries, les appels de repli, les prompts longs, le contexte non mis en cache, les réponses lourdes en sortie, les appels d’outils ou de médias, la dispersion des comptes fournisseurs et une attribution d’usage faible. Un registre au niveau des requêtes aide à mettre en évidence ces coûts.
Les équipes IA d’entreprise devraient-elles utiliser une architecture hybride ?
Souvent, oui. Utilisez les API de modèle pour l’exploration, les modèles de pointe, les pics de charge et le repli. Ne déplacez vers le cloud GPU que les charges de travail stables à fort volume, après qu’un benchmark a prouvé un coût inférieur par sortie acceptée. Conservez la voie API pour le dépassement de capacité et les changements de modèle.
Conclusion
Cloud GPU vs API de modèle n’est pas une décision philosophique. Cloud GPU vs API de modèle est une décision d’économie de charge de travail.
Choisissez le cloud GPU lorsque vous pouvez maintenir la capacité occupée, que le modèle est stable et que le contrôle du matériel crée un véritable avantage. Choisissez une API de modèle lorsque la flexibilité, l’accès multi-fournisseurs, des changements de modèle plus rapides et une gouvernance par requête valent plus que les économies théoriques sur le matériel.
La voie la plus sûre est progressive : commencez avec l’API de modèle, benchmarkez la charge de travail, déplacez vers le cloud GPU uniquement les segments stables lorsque le calcul du seuil de rentabilité résiste aux scénarios défavorables, et conservez un itinéraire API pour le repli et les futurs changements de modèle.
Si vous comparez le cloud GPU à l’API de modèle pour une charge de travail d’IA en production, Flatkey peut vous aider du côté API avec une seule clé, un seul solde, des routes de modèle officielles, des journaux d’utilisation, des budgets et des factures, pendant que votre équipe démontre quelles charges de travail méritent réellement une capacité GPU dédiée.


