
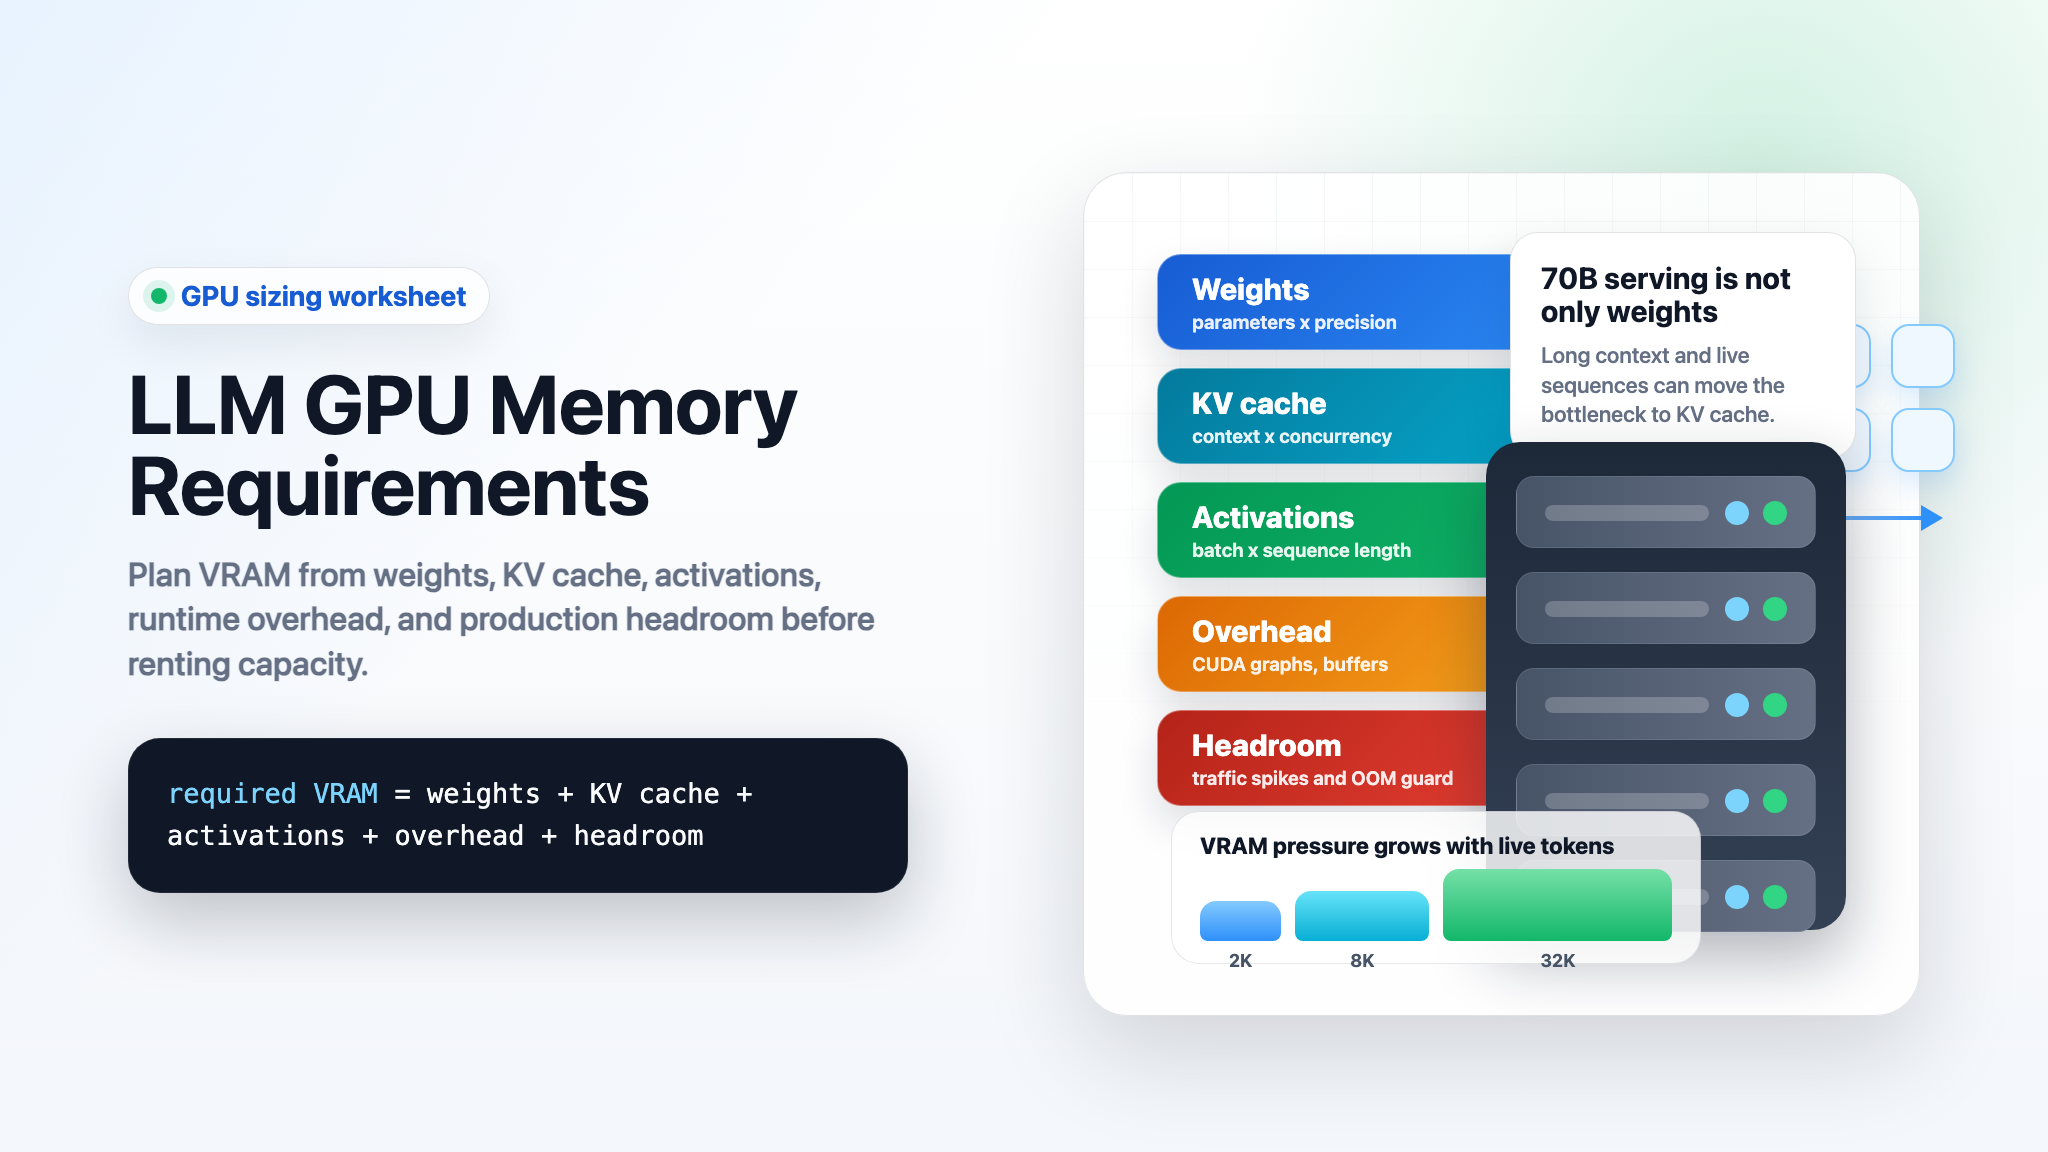
Les exigences de mémoire GPU pour les LLM ne se résument pas à « la taille du modèle plus un peu d’espace ». Un job de service ou d’entraînement comporte plusieurs compartiments mémoire distincts : poids du modèle, cache KV, activations, espaces de travail du framework, graphes CUDA, tampons temporaires et marge opérationnelle.
La règle rapide de planification est la suivante :
required VRAM =
  model weights
+ KV cache for live tokens
+ activation and workspace memory
+ training state, if training or full fine-tuning
+ allocator and safety headroom
C’est pourquoi deux équipes peuvent exécuter le même modèle 70B sur la même classe de GPU et obtenir des résultats différents. L’une utilise de courtes invites, un flux unique, un cache KV en FP8 et un batching prudent. L’autre utilise un contexte long, de nombreuses requêtes simultanées, la capture de graphes CUDA et un réglage élevé de gpu_memory_utilization. Le premier job tient. Le second échoue avec des erreurs de manque de mémoire ou dégrade la latence en déportant le travail ailleurs.
Ce guide fournit une feuille de calcul pratique pour les llm gpu memory requirements en inférence, en service vLLM, en fine-tuning et en entraînement. Utilisez-le avant de louer un GPU, de choisir une capacité H100 plutôt que H200 ou B200, ou de décider si une API de modèle est plus simple que l’exploitation de votre propre point de terminaison GPU.
Réponse rapide sur les exigences de mémoire GPU des LLM
Pour l’inférence, commencez par les poids, puis dimensionnez le cache KV en fonction de la longueur du contexte et de la concurrence. Pour l’entraînement, les poids ne sont que le début ; les états de l’optimiseur, les gradients et les activations enregistrées dominent le plan mémoire.
| Charge de travail | Ce qui domine généralement la VRAM | Règle de planification rapide |
|---|---|---|
| Inférence à requête unique | Poids | parameters x bytes_per_weight, puis ajoutez le cache KV pour l’invite et les jetons générés. |
| Inférence à haut débit | Cache KV et marge du planificateur | Dimensionnez selon concurrent sequences x tokens per sequence, et pas seulement selon le nombre de paramètres du modèle. |
| Service à contexte long | Cache KV | Doubler la longueur du contexte double approximativement la mémoire du cache KV pour le même modèle et le même batch. |
| Fine-tuning complet | États de l’optimiseur, gradients, activations | AdamW en précision mixte peut nécessiter plusieurs fois la mémoire des poids du modèle avant même les activations. |
| Entraînement LoRA ou d’adaptateurs | Poids de base plus activations et état de l’adaptateur | Beaucoup plus petit que le fine-tuning complet, mais la longueur du contexte et la taille du batch restent importantes. |
| Pré-entraînement | État d’entraînement plus activations plus surcharge distribuée | Planifiez à partir d’une exécution de framework mesurée ; les formules ne sont qu’une première approximation. |
Si vous n’avez besoin que des sorties du modèle, comparez d’abord un service direct sur GPU à une base de référence d’API de modèle. Les GPU directs sont pertinents lorsque vous avez besoin de poids personnalisés, d’un contrôle du placement, d’une politique d’exécution privée ou d’une charge de travail moins coûteuse une fois l’utilisation mesurée. Si vous avez surtout besoin de réponses API fiables, une offre de modèle gérée peut éviter des semaines de dimensionnement GPU, de mise en file d’attente et de travail d’exploitation.
Feuille de calcul des exigences de mémoire GPU des LLM
Utilisez cette feuille de calcul avant de choisir une instance.
| Compartiment | Formule ou vérification | Remarques |
|---|---|---|
| Poids | parameter_count x weight_bytes |
BF16/FP16 utilisent environ 2 octets par paramètre. INT8 utilise environ 1 octet. Le 4 bits utilise environ 0,5 octet avant les métadonnées de quantification. |
| Cache KV | active_tokens x layers x kv_heads x head_dim x 2 x kv_bytes |
Le 2 correspond aux clés et aux valeurs. L’attention groupée par requêtes réduit kv_heads par rapport à l’attention multi-têtes complète. |
| Activations | Inférence : généralement modeste. Entraînement : dépend du batch, de la longueur de séquence, de la taille cachée, des couches et des choix de checkpointing. | La taxonomie mémoire des modèles de Hugging Face met en avant les poids, les états de l’optimiseur, les gradients, les activations enregistrées, les tampons temporaires et la mémoire spécifique aux fonctionnalités pour l’entraînement. |
| Réserve du framework de service | vLLM, TensorRT-LLM, SGLang, PyTorch, graphes CUDA, kernels d’attention, files de planification | vLLM expose des contrôles mémoire tels que gpu_memory_utilization, kv_cache_memory_bytes, kv_cache_dtype, max_model_len et max_num_seqs. |
| Marge de sécurité | 10-20 % en production, davantage lors des premiers benchmarks | Réservez de la place pour la fragmentation de l’allocateur, les pics de trafic, les invites plus longues, les rechargements du modèle et les agents d’observabilité. |
L’erreur la plus courante consiste à faire tenir les poids et à oublier les jetons actifs. Pour une estimation des exigences de mémoire GPU pour l’inférence LLM, le cache KV peut faire la différence entre un endpoint stable et une boucle d’OOM.
Étape 1 : calculer la mémoire des poids du modèle
Les poids sont la partie la plus simple des exigences de mémoire GPU pour les charges de travail LLM.
weight_memory_gib = parameters x bytes_per_parameter / 1024^3
| Taille du modèle | Poids BF16 / FP16 | Poids INT8 | Poids 4 bits avant métadonnées |
|---|---|---|---|
| 7B | ~13.0 GiB | ~6.5 GiB | ~3.3 GiB |
| 13B | ~24.2 GiB | ~12.1 GiB | ~6.1 GiB |
| 34B | ~63.3 GiB | ~31.7 GiB | ~15.8 GiB |
| 70B | ~130.4 GiB | ~65.2 GiB | ~32.6 GiB |
| 405B | ~754.4 GiB | ~377.2 GiB | ~188.6 GiB |
Ce tableau constitue une borne inférieure. Les déploiements réels ajoutent des échelles de quantification, des tampons non liés aux paramètres, l’état du tokenizer/runtime, des espaces de travail temporaires et une surcharge de service.
Pour une estimation de la mémoire GPU vLLM pour un modèle 70B, les poids BF16/FP16 à eux seuls dépassent déjà un seul H100 de 80 Go. Un seul H200 dispose de 141 Go de HBM3e selon la page H200 de NVIDIA, donc les poids peuvent théoriquement tenir, mais le cache KV restant et la marge d’exécution peuvent encore imposer un contexte plus court, une concurrence plus faible, une quantification du cache KV ou un parallélisme tensoriel. NVIDIA indique H100 SXM à 80 Go, H200 à 141 Go et DGX B200 comme huit GPU Blackwell avec 1 440 Go de HBM3e au total, ce qui équivaut en pratique à 180 Go par GPU B200 dans ce système.
Étape 2 : calculer la mémoire du cache KV pour les exigences de mémoire GPU des LLM
Le cache KV est la mémoire utilisée pour stocker les clés et les valeurs d’attention des jetons déjà traités. Il permet au modèle de générer sans recalculer le préfixe complet à chaque fois.
Pour l’inférence d’un transformeur decoder-only :
kv_cache_bytes =
  active_tokens
x num_layers
x num_kv_heads
x head_dim
x 2
x bytes_per_kv_element
Où :
| Variable | Signification |
|---|---|
active_tokens |
Somme des jetons d’invite et des jetons générés actuellement présents dans le cache sur l’ensemble des requêtes actives. |
num_layers |
Nombre de couches du transformeur. |
num_kv_heads |
Têtes KV, pas toujours les têtes d’attention. L’attention à requêtes groupées peut rendre ce nombre beaucoup plus faible. |
head_dim |
Dimension par tête. |
2 |
Tenseurs de clés et de valeurs. |
bytes_per_kv_element |
2 pour BF16/FP16, 1 pour FP8, moins pour les modes de cache à plus faible précision pris en charge. |
À titre d’exemple, une configuration de type Llama 70B avec 80 couches, 8 têtes KV et une dimension de tête de 128 utilise :
80 x 8 x 128 x 2 x 2 bytes = 327,680 bytes per token
Soit environ 0,3125 Mio par jeton actif dans un cache KV BF16/FP16.
| Contexte actif par séquence | Cache KV approximatif pour une séquence | Cache KV approximatif pour 16 séquences actives |
|---|---|---|
| 2 048 jetons | ~0,6 Gio | ~10,0 Gio |
| 4 096 jetons | ~1,3 Gio | ~20,0 Gio |
| 8 192 jetons | ~2,5 Gio | ~40,0 Gio |
| 16 384 jetons | ~5,0 Gio | ~80,0 Gio |
| 32 768 jetons | ~10,0 Gio | ~160,0 Gio |
Le nombre exact varie selon l’architecture du modèle. Un modèle avec davantage de têtes KV utilise plus de mémoire KV. Un modèle avec attention multi-requête ou à requêtes groupées peut utiliser beaucoup moins de mémoire KV qu’un design d’attention multi-têtes complet.
vLLM documente plusieurs paramètres importants ici : --gpu-memory-utilization contrôle la fraction de la mémoire GPU utilisée par l’exécuteur du modèle, --kv-cache-memory-bytes peut dimensionner explicitement le cache KV, --kv-cache-dtype peut sélectionner la précision du cache, et le guide d’économie de mémoire recommande de réduire max_model_len et max_num_seqs lorsque la mémoire est limitée. vLLM documente également le cache KV FP8 comme un moyen de réduire l’empreinte du cache KV et de prendre en charge un contexte plus long ou un débit plus élevé, avec toutefois une validation de précision toujours nécessaire.
Étape 3 : ajouter les activations et la surcharge d’exécution
Pour l’inférence, la mémoire des activations est généralement plus faible que celle des poids et du cache KV, mais elle n’est pas nulle. Le préremplissage, les CUDA graphs, les kernels d’attention, les tampons temporaires, les processeurs multimodaux, le décodage spéculatif et la planification par lots peuvent réserver de la mémoire supplémentaire.
Pour l’entraînement, la mémoire des activations devient un terme de premier ordre. L’anatomie de la mémoire des modèles de Hugging Face liste les composants mémoire d’entraînement comme les poids du modèle, les états de l’optimiseur, les gradients, les activations de passage avant conservées pour le calcul du gradient, les tampons temporaires et la mémoire spécifique aux fonctionnalités. Elle note également que la mémoire des activations dépend de la longueur de séquence, de la taille cachée et de la taille de lot.
Une répartition utile pour la planification est :
| Scénario | Positionnement vis-à-vis des activations et de la surcharge |
|---|---|
| Inférence simple, batch 1 | Conserver au moins 10 % de marge après les poids et le cache KV. |
| Service vLLM avec CUDA graphs et batching | Commencer avec 15 à 20 % de marge, puis ajuster gpu_memory_utilization, max_model_len et max_num_seqs. |
| Service à long contexte | Considérer le cache KV comme la variable principale et réserver davantage de marge pour les pics de préremplissage. |
| Fine-tuning | Mesurer une petite exécution à la longueur de séquence cible avant de passer à l’échelle ; les activations peuvent dominer à mesure que le batch et le contexte augmentent. |
| Modèles multimodaux | Ajouter la mémoire du cache du processeur et des entrées média ; le guide d’économie de mémoire de vLLM mentionne le cache multimodal et des contrôles de limite d’entrée. |
Ne faites pas tourner la production à 99 % de mémoire simplement parce qu’une requête de test tient. Cela ne laisse aucune place pour des invites plus longues, des rechargements à chaud, la capture de CUDA graph, le comportement de l’allocateur ou un mix de trafic différent de celui du benchmark.
Étape 4 : estimer la mémoire d’entraînement et de fine-tuning
La mémoire d’entraînement est plus importante parce que le GPU doit contenir davantage que les poids du passage avant.
Pour un fine-tuning complet avec précision mixte et AdamW, l’anatomie de la mémoire de Hugging Face fournit une répartition pratique : l’entraînement en précision mixte peut conserver des copies des poids en FP32 et FP16/BF16, les états de l’optimiseur AdamW, les gradients, les activations sauvegardées, les tampons temporaires et la mémoire spécifique aux fonctionnalités. La même page résume une configuration AdamW en précision mixte typique à 18 octets par paramètre de modèle, plus la mémoire des activations.
Cela signifie :
| Taille du modèle | 18 octets par paramètre avant les activations |
|---|---|
| 7B | ~117 Gio |
| 13B | ~218 Gio |
| 34B | ~570 Gio |
| 70B | ~1,173 Gio |
C’est pourquoi les requêtes gpu memory requirements LLM training nécessitent une réponse différente de celle des requêtes d’inférence. Un modèle 70B qui peut être servi avec du parallélisme tensoriel et un cache KV quantifié n’est pas automatiquement praticable pour un fine-tuning complet sur un petit nombre de GPU.
Les moyens de réduire la mémoire d’entraînement incluent :
| Technique | Ce qu’elle réduit | Compromis |
|---|---|---|
| LoRA / QLoRA | Mémoire des paramètres entraînables et de l’optimiseur | Ce n’est pas la même chose qu’un fine-tuning complet ; il faut toujours la mémoire du modèle de base et des activations. |
| Activation checkpointing | Mémoire des activations sauvegardées | Davantage de recalcul et un débit d’entraînement plus faible. |
| ZeRO / FSDP / parallélisme tensoriel | Mémoire par GPU de l’optimiseur, des gradients, des paramètres ou du calcul | Complexité distribuée accrue et sensibilité à la communication. |
| Longueur de séquence plus courte | Mémoire des activations et de l’attention | Peut réduire la qualité de la tâche si la charge de travail nécessite un long contexte. |
| Micro-batch plus petit | Mémoire des activations | Peut nécessiter une accumulation de gradients pour préserver la taille effective du batch. |
Pour l’entraînement complet, les formules vous amènent à une première configuration de cluster. Elles ne remplacent pas une exécution mesurée du framework.
Étape 5 : relier les exigences de mémoire GPU des LLM aux tailles courantes de mémoire GPU
Utilisez la capacité mémoire GPU comme une contrainte, et non comme seul critère d’achat. La bande passante mémoire, la topologie NVLink, le réseau, le stockage, la planification et l’utilisation peuvent compter autant que la VRAM brute.
| Classe de GPU | Référence de mémoire publique | Ce que cela signifie généralement pour les exigences de mémoire GPU des LLM |
|---|---|---|
| H100 SXM | 80 GB HBM3 | Choix par défaut solide pour le service de modèles 7B-34B et de nombreuses tâches de fine-tuning. Le 70B en BF16 nécessite généralement du parallélisme tensoriel ou de la quantification. |
| H100 NVL | 94 GB par GPU, 188 GB par paire sur la page H100 de NVIDIA | Conçu pour une inférence LLM plus grande dans des racks d’entreprise contraints en énergie ; il faut tout de même valider la topologie et le SKU du fournisseur. |
| H200 | 141 GB HBM3e | Plus à l’aise pour les poids de grands modèles et les contextes plus longs que le H100, mais le service de 70B à forte concurrence peut encore être limité par le cache KV. |
| B200 dans DGX B200 | 1,440 GB au total sur 8 GPU | Grand pool mémoire pour les systèmes d’entraînement et d’inférence d’entreprise, avec des exigences opérationnelles qui dépassent la simple spécification d’un GPU. |
Si votre feuille de calcul indique qu’un seul H200 « tient tout juste » un modèle 70B, ce n’est pas un plan de déploiement. C’est un signal pour tester ces paramètres :
| Paramètre | Pourquoi il compte |
|---|---|
max_model_len |
Fixe une borne supérieure au contexte et donc au cache KV. |
max_num_seqs |
Fixe une borne supérieure aux séquences concurrentes et à la pression sur le planificateur. |
kv_cache_dtype |
Peut réduire la mémoire du cache KV, mais nécessite des contrôles de qualité. |
| Taille du parallélisme tensoriel | Répartit le travail du modèle sur plusieurs GPU ; modifie aussi les besoins en communication. |
| Format de quantification | Réduit la taille des poids et parfois du cache KV ; peut affecter la qualité et la prise en charge des kernels. |
| Latence p95 cible | Des réglages à plus haut débit peuvent nuire à la latence même lorsque la mémoire est suffisante. |
Pour les détails de sélection matérielle, utilisez cette feuille de calcul en parallèle avec les guides Flatkey sur le meilleur GPU pour l’inférence LLM, H200 vs H100 et B200 vs H200.
Exemple : dimensionnement de l’inférence 70B dans vLLM
Voici une manière prudente de raisonner sur les vllm gpu memory requirements 70b model vram avant de louer de la capacité.
Supposons :
| Entrée | Valeur |
|---|---|
| Poids du modèle | 70B paramètres |
| Précision des poids | BF16 / FP16 |
| Mémoire des poids | ~130.4 Gio |
| Forme du cache KV | 80 couches, 8 têtes KV, dimension de tête 128 |
| Précision KV | BF16 / FP16 |
| KV par jeton actif | ~0.3125 Mio |
Comparez ensuite quelques configurations de service :
| Cible de service | Cache KV approximatif | Pourquoi c’est important |
|---|---|---|
| 1 séquence active, 4K tokens | ~1,3 GiB | Les poids dominent. Un seul GPU à grande mémoire peut ne convenir qu’avec une faible marge. |
| 8 séquences actives, 4K tokens | ~10,0 GiB | Nécessite une vraie marge au-delà des poids. |
| 16 séquences actives, 8K tokens | ~40,0 GiB | Un plan sur un seul GPU est généralement fragile, sauf si les poids ou le cache KV sont quantifiés. |
| 16 séquences actives, 16K tokens | ~80,0 GiB | Le cache KV à lui seul représente à peu près la mémoire d’un H100 SXM. |
En pratique, un plan vLLM pour un modèle 70B se répartit généralement dans l’un de ces cas :
| Cas | Adéquation |
|---|---|
| Poids BF16, faible concurrence, contexte plus court | Une mémoire de classe H200 peut fonctionner après vérification de la surcharge. |
| Poids BF16, concurrence en production | Utilisez le parallélisme tensoriel et vérifiez le réseau / la topologie. |
| Poids quantifiés, cache KV BF16/FP16 | Bon premier benchmark lorsque la qualité autorise la quantification des poids. |
| Poids quantifiés plus cache KV FP8 | Peut débloquer un contexte plus long ou plus de concurrence, mais nécessite une validation de la précision et de la latence. |
| Aucune exigence de contrôle matériel | Comparez un itinéraire d’API de modèle avant de vous engager dans des opérations GPU. |
C’est la réponse pratique à la question des exigences de mémoire GPU pour le service des LLM : le nombre de paramètres vous dit si le modèle peut se charger ; le cache KV et la réserve d’exécution vous disent s’il peut servir un trafic utile.
Pourquoi la longueur du contexte change la réponse
Un contexte long est coûteux parce que le cache croît avec les tokens actifs. Si vous doublez le contexte de 8K à 16K, le cache KV double approximativement pour le même modèle, la même précision et la même concurrence. Si vous doublez la concurrence au même contexte, le cache KV double à nouveau à peu près.
Pour les équipes qui comparent des plans llm hardware requirements gpu memory, cela crée un schéma de dimensionnement simple :
plus d’utilisateurs x des prompts plus longs x plus de tokens de sortie = plus de cache KV
Avant de louer un GPU plus grand, demandez-vous si le produit a réellement besoin du contexte maximal pour chaque requête. De nombreux systèmes peuvent router :
| Type de requête | Politique d’économie de mémoire |
|---|---|
| Chat court ou extraction | Plafond de contexte plus petit, concurrence plus élevée. |
| Analyse de long document | Plafond de contexte plus grand, pool de concurrence plus faible. |
| Tâches par lot | File d’attente selon le budget de tokens, pas seulement selon le nombre de requêtes. |
| Charges de travail premium | Pool dédié avec contexte maximal explicite et objectif p95. |
C’est souvent moins coûteux et plus stable que d’exécuter un seul énorme point de terminaison avec un seul paramètre mémoire global.
Ce qu’il faut mesurer dans le premier benchmark
Exécutez un benchmark qui ressemble au trafic de production, pas à un seul prompt du chemin heureux.
| Métrique | Pourquoi elle doit figurer dans le premier benchmark |
|---|---|
| VRAM allouée et réservée au pic | Détecte la marge de l’allocateur et du framework, pas seulement les calculs de tenseurs. |
| Latence de préremplissage | Les prompts longs sollicitent la bande passante mémoire et les noyaux d’attention. |
| Tokens de décodage par seconde | Montre le débit de génération à l’état स्थable. |
| Latence p95 et p99 | Évite qu’une configuration optimisée pour le débit nuise aux utilisateurs. |
| Taux d’OOM | Suit les échecs mémoire sous un mix de trafic réel. |
| Utilisation du cache KV | Explique si le goulot d’étranglement est le contexte / la concurrence ou les poids. |
| Coût des sorties acceptées | Relie le coût de location du GPU aux complétions réellement utilisables, pas aux tokens bruts. |
Pour les déploiements multi-nœuds, associez cela aux listes de contrôle GPU cluster architecture et GPU cluster TCO. Un modèle compatible avec la mémoire peut malgré tout être coûteux si le réseau, le stockage, la mise en file d’attente ou l’utilisation sont faibles.
Erreurs courantes
| Erreur | Meilleure approche |
|---|---|
| Dimensionner uniquement à partir du nombre de paramètres | Ajoutez le cache KV, les activations, la réserve du framework et une marge de sécurité. |
| Considérer qu’un « fit once » est prêt pour la production | Testez le contexte cible, la concurrence, la longueur de sortie et le comportement de relance. |
| Ignorer la précision du cache KV | Validez FP8 ou d’autres formats de cache lorsque la mémoire est le goulot d’étranglement. |
| Utiliser le nom de GPU du fournisseur sans SKU exact | Confirmez la capacité mémoire, l’interconnexion, la politique MIG, la pile de pilotes et le partage éventuel des GPU. |
| Supposer que la mémoire d’entraînement équivaut à la mémoire d’inférence | L’entraînement ajoute les états de l’optimiseur, les gradients, les activations sauvegardées et la surcharge distribuée. |
Définir gpu_memory_utilization de manière trop agressive |
Laissez une réserve suffisante pour les graphes CUDA, les tampons, les pics de trafic et le comportement de l’allocateur. |
Guide de décision : louer des GPU ou utiliser une API de modèle ?
La capacité GPU directe est la bonne direction lorsque vous avez besoin d’un ou plusieurs des éléments suivants :
| Choisissez des GPU directs lorsque... | Choisissez une API de modèle de référence lorsque... |
|---|---|
| Vous servez des poids personnalisés ou des fine-tunes privés. | Vous utilisez des modèles hébergés courants et avez בעיקר besoin de sorties fiables. |
| Vous avez besoin de contrôle sur l’emplacement, l’isolation ou l’exécution. | Vous ne voulez pas gérer les files d’attente, l’autoscaling, les images, les pilotes et les pannes GPU. |
| Votre utilisation mesurée est suffisamment élevée pour surpasser l’économie des API. | Le trafic est par à-coups, précoce ou difficile à prévoir. |
| Vous pouvez prendre en charge le benchmarking et la réponse aux incidents. | Votre équipe préfère consacrer le temps d’ingénierie à la logique produit. |
Flatkey est utile comme voie de référence lorsque le contrôle matériel n’est pas l’exigence du produit. Il offre aux équipes un point d’équilibre entre les modèles officiels et les outils, afin que vous puissiez comparer le coût de location du GPU au coût de sortie de l’API du modèle avant de vous engager dans un cluster de longue durée. Si le benchmark prouve que les GPU directs gagnent, utilisez la feuille de calcul mémoire ci-dessus pour louer la configuration la plus petite et fiable plutôt que la plus grande et impressionnante.
Questions fréquemment posées
De combien de mémoire GPU un LLM de 70B a-t-il besoin ?
Les poids BF16 ou FP16 pour un modèle de 70B nécessitent environ 130 GiB avant le cache KV et la surcharge d’exécution. Les poids INT8 représentent environ 65 GiB avant les métadonnées. Les poids 4 bits représentent environ 33 GiB avant les métadonnées de quantification. Pour l’inférence en production, ajoutez le cache KV pour le contexte et la concurrence, la réserve du framework de service et une marge de sécurité.
Pourquoi un modèle se charge-t-il mais échoue-t-il sous trafic ?
Le test de chargement peut ne couvrir que les poids. Le trafic réel ajoute le cache KV pour les invites actives et les jetons générés, la surcharge de batch, les tampons temporaires et les réserves du framework. Des invites plus longues et davantage de séquences concurrentes peuvent faire basculer le même modèle en OOM.
Qu’est-ce qui affecte le plus les besoins en mémoire GPU pour l’inférence LLM ?
Les variables les plus importantes sont la taille du modèle, la précision des poids, la longueur du contexte, les séquences concurrentes, la précision du cache KV et les paramètres du framework de service. Pour un service à long contexte, le cache KV devient souvent le goulot d’étranglement.
Qu’est-ce qui affecte les besoins matériels d’un LLM en mémoire GPU pour l’entraînement ?
L’entraînement ajoute les états de l’optimiseur, les gradients, les activations sauvegardées, les tampons temporaires et la surcharge du framework distribué. La taille du batch, la longueur de séquence, le checkpointing des activations, le choix de l’optimiseur et la stratégie de sharding peuvent modifier considérablement le nombre de GPU.
vLLM réduit-il les besoins en mémoire GPU ?
vLLM offre des contrôles mémoire utiles et une gestion efficace du cache KV, mais il ne supprime pas le budget mémoire sous-jacent. Vous avez toujours besoin de suffisamment de VRAM pour les poids, le cache KV, les activations, la réserve d’exécution et une marge. Ses contrôles mémoire vous aident à choisir le compromis entre longueur de contexte, concurrence, précision et débit.
Le cache KV FP8 peut-il résoudre la pression mémoire des longs contextes ?
Il peut réduire l’empreinte du cache KV, et vLLM documente la prise en charge du cache KV FP8. Considérez-le comme un réglage de benchmark, pas comme un interrupteur gratuit : validez la qualité des sorties, la latence, les chemins matériels/logiciels pris en charge et le comportement en cas d’échec avant de l’utiliser en production.
Liste de contrôle finale
Avant de louer de la capacité, répondez à ces questions :
- Quelle taille de modèle et quelle précision des poids servez-vous ?
- Quelle est la longueur de contexte maximale que les utilisateurs peuvent réellement envoyer ?
- Combien de séquences concurrentes doivent tenir au chargement p95 ?
- Quelle longueur de sortie réservez-vous pour la génération ?
- Le cache KV est-il en BF16/FP16, en FP8 ou dans un autre format pris en charge ?
- Quelle marge reste-t-il après les poids et le cache KV ?
- Utilisez-vous le parallélisme tensoriel, la quantification, LoRA, FSDP ou ZeRO ?
- Quel SKU GPU exact, quelle capacité mémoire et quelle topologie le fournisseur allouera-t-il ?
- Quels seuils d’OOM, de latence et de coût par sortie acceptée définissent le succès ?
- Si vous n’avez pas besoin de contrôle matériel, quel est le coût de référence de l’API du modèle ?
La meilleure estimation des llm gpu memory requirements est celle qui survit à un benchmark représentatif de la production. Utilisez la feuille de calcul pour écarter rapidement les configurations GPU impossibles, puis validez la liste courte avec des longueurs de contexte réelles, une concurrence réelle et suffisamment de marge pour rester en ligne.
Sources
- Arguments du moteur vLLM :
gpu_memory_utilization,kv_cache_memory_bytes,kv_cache_dtypeet contrôles de cache associés : https://docs.vllm.ai/en/latest/configuration/engine_args.html - Guide vLLM de conservation de la mémoire : parallélisme tensoriel, quantification, longueur de contexte, taille de batch, mémoire CUDA graph et contrôles de mémoire multimodaux : https://docs.vllm.ai/en/latest/configuration/conserving_memory/
- Guide vLLM du cache KV quantifié : options de cache KV FP8 et compromis : https://docs.vllm.ai/en/latest/features/quantization/quantized_kvcache.html
- Anatomie de la mémoire des modèles Hugging Face Transformers : segments de mémoire d’entraînement, états de l’optimiseur, gradients, activations et notes sur la mémoire en précision mixte : https://huggingface.co/docs/transformers/v4.57.1/en/model_memory_anatomy
- Page produit NVIDIA H100 : mémoire H100, bande passante, H100 NVL et positionnement LLM : https://www.nvidia.com/en-us/data-center/h100/
- Page produit NVIDIA H200 : 141 GB de HBM3e et bande passante mémoire : https://www.nvidia.com/en-us/data-center/h200/
- Page produit NVIDIA DGX B200 : huit GPU B200 et 1 440 GB de HBM3e au total : https://www.nvidia.com/en-us/data-center/dgx-b200/


