
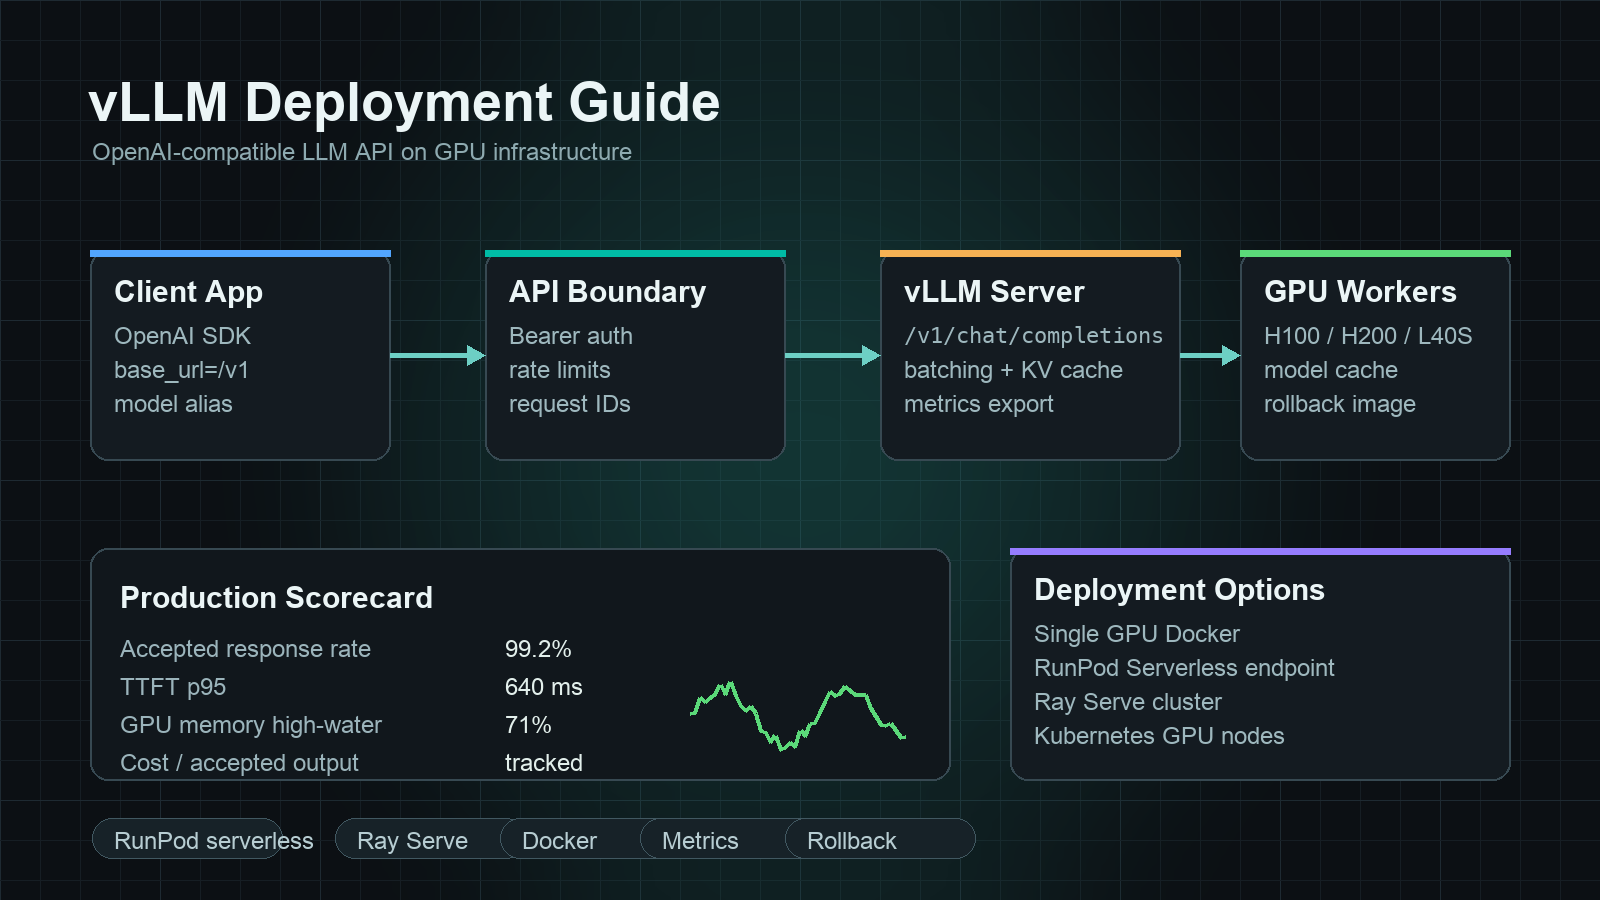
Un guide de déploiement vLLM doit répondre à une question pratique : comment transformer une capacité GPU en une API LLM compatible OpenAI que les équipes applicatives peuvent appeler, observer, restaurer en arrière-plan et comparer aux APIs de modèles managés ?
La réponse courte est de commencer avec un modèle, une configuration GPU, une route compatible OpenAI et un plan de mesure. vLLM peut exposer des endpoints familiers comme /v1/models, /v1/chat/completions et d’autres endpoints de style OpenAI, mais un déploiement de production ne se limite pas à la première commande vllm serve. Vous avez besoin d’une image de conteneur, d’un cache de modèle, d’une frontière d’authentification, de vérifications de santé, de métriques, de limites de requêtes, d’un test de charge et d’un tableau de bord du coût par sortie acceptée.
Ce guide de déploiement vLLM fournit aux développeurs IA et aux équipes plateforme un chemin de déploiement allant d’un serveur GPU unique à RunPod Serverless, Ray Serve et des modèles de production de type Kubernetes. Il explique aussi quand une API de modèle ou un routeur comme Flatkey peut être plus simple que de gérer soi-même la couche de service GPU.
Guide rapide de déploiement vLLM
Utilisez cette séquence avant d’ajouter de la complexité d’orchestration.
| Étape | Décision | Valeur par défaut pratique |
|---|---|---|
| 1. Choisir le modèle | Choisissez un modèle pris en charge et une révision exacte | Commencez par le plus petit modèle qui prouve le contrat d’API, puis montez en puissance |
| 2. Choisir le GPU | Vérifiez l’adéquation mémoire avant d’optimiser le débit | Utilisez la même classe de GPU en test et en production |
| 3. Démarrer vLLM | Exposez une API compatible OpenAI | Utilisez d’abord vllm serve, puis conteneurisez |
| 4. Verrouiller les limites de requêtes | Encadrez la longueur du contexte, la concurrence et la taille de sortie | Protégez le GPU contre des prompts sans limite |
| 5. Ajouter l’authentification et les contrôles réseau | N’exposez pas directement un worker GPU brut | Placez une passerelle, un ingress ou un endpoint privé devant |
| 6. Mesurer la sortie acceptée | Suivez les réponses réussies, la latence, les réessais et le coût | Comparez au coût par sortie acceptée des APIs de modèles |
| 7. Ajouter des mécanismes de déploiement progressif | Canary, restauration et alias de modèles versionnés | Conservez la stabilité du code client pendant les changements de service |
L’objectif n’est pas de tout auto-héberger. L’objectif est de savoir quand vLLM auto-hébergé vaut la surface opérationnelle.
Ce que vLLM vous apporte
vLLM est un moteur open source d’inférence et de service pour les grands modèles de langage. Sa documentation couvre le service compatible OpenAI, le déploiement Docker, les métriques, le cache de préfixe, la quantification, le décodage spéculatif, le parallélisme et les architectures de modèles prises en charge. Ces éléments font de vLLM un choix par défaut solide lorsque vous souhaitez servir des modèles à poids ouverts derrière un contrat d’API familier.
La propriété utile en production est la frontière d’API. Si votre application appelle déjà un client compatible OpenAI, un endpoint vLLM peut réduire le travail de réécriture applicative. La couche de service peut changer, les poids du modèle peuvent changer et l’hôte GPU peut bouger, tandis que le code client envoie toujours des requêtes de chat-completion vers une seule URL de base.
Cela ne supprime pas le travail de plateforme. Cela déplace le travail difficile de l’intégration applicative vers les opérations d’inférence : allocation GPU, chargement du modèle, batching, observabilité, limites de débit, réponse aux incidents et gestion des coûts.
Déploiement vLLM sur un seul GPU
Commencez en local ou sur un GPU cloud unique avant d’ajouter du serverless, Ray ou Kubernetes.
pip install vllm

vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Testez ensuite l’endpoint compatible OpenAI.
curl http://localhost:8000/v1/models
Utilisez une requête de chat qui ressemble à celle que votre application enverra réellement.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [
      {"role": "user", "content": "Rédige une checklist de déploiement en trois points."}
    ],
    "temperature": 0.2,
    "max_tokens": 300
  }'
Ce premier déploiement n’est pas en production. Il répond à quatre questions :
- Le modèle se charge-t-il sur le GPU sélectionné ?
- Votre client comprend-il la forme de la réponse ?
- Le streaming, l’appel d’outils ou la sortie structurée fonctionnent-ils pour votre requête spécifique ?
- Quels sont les ordres de grandeur du temps jusqu’au premier token et de la latence de bout en bout ?
Gardez ce premier test simple. N’optimisez pas le batching, la quantification ou le parallélisme tant que l’endpoint de base ne fonctionne pas.
Déploiement Docker pour un serveur GPU reproductible
Pour un serveur reproductible, utilisez le chemin Docker officiel de vLLM ou une image conteneur épinglée dans votre propre registre. Les contrôles de production importants ne se limitent pas au tag de l’image. Ils concernent aussi la pile de pilotes, la compatibilité CUDA, le cache du modèle, le montage de volume, le port réseau et les options du processus.
Exemple de forme :
docker run --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env HUGGING_FACE_HUB_TOKEN=$HUGGING_FACE_HUB_TOKEN \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Avant d’utiliser ce modèle en production, figez les versions :
- Le tag de l’image vLLM.
- Le pilote NVIDIA et le runtime conteneur.
- La pile CUDA, si elle est gérée séparément.
- La révision du modèle ou le hash de commit.
- Le comportement du tokenizer et du modèle de chat.
- Le mode de quantification, s’il est utilisé.
Un guide de déploiement de vLLM est incomplet s’il se contente de dire « lancez Docker ». Le runbook doit aussi préciser le comportement au redémarrage, la journalisation, le préchauffage du cache du modèle, les sondes de readiness et un chemin de retour à l’image et à la révision du modèle précédentes.
Rendez le point de terminaison compatible OpenAI, mais pas non authentifié
vLLM peut parler une API compatible OpenAI, mais votre worker vLLM brut ne devrait généralement pas constituer la frontière publique d’Internet. Placez quelque chose devant lui :
- Un point de terminaison VPC privé pour les services internes.
- Une passerelle API avec validation du bearer token.
- Un maillage de services ou un contrôleur d’ingress avec mTLS.
- Un proxy léger au niveau de l’application qui impose des alias de modèle, des identifiants de requête et des budgets par équipe.
- Une couche de routage lorsque vous avez besoin d’un repli vers des API de modèles managées.
Utilisez des URL de base spécifiques à l’environnement :
VLLM_BASE_URL_DEV=http://localhost:8000/v1
VLLM_BASE_URL_STAGING=https://staging-inference.example.com/v1
VLLM_BASE_URL_PROD=https://inference.example.com/v1
Conservez ensuite le client applicatif réversible :
from openai import OpenAI

client = OpenAI(
    api_key="not-used-by-raw-vllm",
    base_url="https://inference.example.com/v1",
)

response = client.chat.completions.create(
    model="llama-3-1-8b-instruct",
    messages=[{"role": "user", "content": "Résume le plan de déploiement."}],
)
Si, plus tard, vous acheminez certaines requêtes vers la couche d’API de modèle compatible OpenAI de Flatkey, le même schéma de client reste utile : changez l’URL de base, la clé API et l’alias de modèle tout en gardant le contrat applicatif stable.
Paramètres de production à décider avant le trafic
Les indicateurs de déploiement dépendent du modèle, du GPU et de la charge de travail, mais chaque équipe devrait décider de ces contrôles avant le trafic de production :
| Contrôle | Pourquoi c’est important |
|---|---|
| Longueur maximale du modèle | Empêche quelques longues invites de consommer toute la mémoire du cache KV |
| Nombre maximal de jetons de sortie | Évite que des générations incontrôlées monopolisent la capacité de décodage |
| Limite de concurrence | Protège la latence p95 et p99 en cas de trafic en rafale |
| Timeout de requête | Empêche les requêtes bloquées de masquer une surcharge |
| Politique de file d’attente | Détermine si la demande excédentaire attend, échoue rapidement ou bascule vers un repli |
| Alias de modèle | Permet aux clients d’utiliser un nom stable pendant que la révision servie change |
| Frontière d’authentification | Empêche qu’un point de terminaison GPU coûteux devienne un proxy ouvert |
| Politique de journalisation | Équilibre le débogage avec les exigences de conservation des données et de confidentialité |
| Export des métriques | Rend observables la latence, les erreurs, le comportement du cache et le débit |
Ne copiez pas les indicateurs d’une autre équipe. Copiez leur méthode de mesure.
Métriques pour les déploiements de production vLLM
Suivez les métriques à trois niveaux.
| Niveau | Métriques à suivre |
|---|---|
| Niveau API | Nombre de requêtes, taux de réponses acceptées, taux de 4xx/5xx, taux de timeout, taux de retry |
| Niveau service | Temps jusqu’au premier jeton, latence entre les jetons, latence de bout en bout, attente en file, jetons par seconde |
| Niveau GPU | Utilisation du GPU, utilisation de la mémoire, événements OOM, temps de chargement du modèle, nombre de redémarrages |
Ajoutez ensuite la métrique financière :
coût par sortie acceptée =
  (location GPU + stockage + bande passante + retries + temps opérateur)
  / réponses acceptées qui passent les contrôles qualité
Cela maintient le guide de déploiement de vLLM lié à l’économie de production. Un point de terminaison plus rapide n’est pas moins coûteux s’il échoue plus souvent, nécessite davantage d’intervention manuelle ou reste inactif la majeure partie de la journée.
Pour un contexte plus large sur les coûts, comparez votre point de terminaison mesuré avec les prix de location des GPU, le meilleur GPU pour l’inférence LLM, cloud GPU vs API de modèle et le TCO d’un cluster GPU.
Guide de déploiement vLLM serverless RunPod
Un guide de déploiement vLLM serverless RunPod a un modèle d’exploitation différent de celui d’une VM GPU longue durée. Vous empaquetez un handler ou un conteneur, définissez le point de terminaison serverless et laissez la plateforme faire évoluer les workers en fonction des requêtes. Cela peut être utile lorsque le trafic est irrégulier ou lorsque vous souhaitez une surface d’exécution GPU managée sans posséder tous les détails du cycle de vie des VM.
Utilisez RunPod Serverless lorsque :
- Vous voulez une exécution GPU de type point de terminaison sans gérer d’hôtes persistants.
- Le trafic est suffisamment en rafales pour qu’une capacité GPU toujours active reste inutilisée.
- Le comportement de cold start et de chargement du modèle est acceptable pour la charge de travail.
- Votre application peut tolérer le modèle de requête asynchrone ou spécifique au point de terminaison de la plateforme.
- Vous pouvez tester la concurrence, la mise en file d’attente et le comportement des timeouts avant le lancement.
Faites preuve de prudence avec le serverless pour le chat sensible à la latence. Les grands modèles peuvent avoir un cold start et un temps de chargement significatifs. Mesurez la latence du premier jeton après des périodes d’inactivité, et pas seulement pendant un benchmark à chaud.
Pour un guide de déploiement vLLM sur un point de terminaison serverless RunPod, votre test d’acceptation devrait inclure :
| Vérification | Pourquoi c’est important |
|---|---|
| Temps de chargement de l’image du conteneur | Les images volumineuses peuvent dominer les démarrages à froid |
| Téléchargement des poids du modèle ou montage du volume | Des téléchargements répétés peuvent annuler les économies du serverless |
| Nombre maximal de workers | Évite des dépenses imprévues pendant les pics |
| Délai d’attente de la file | Définit le comportement d’échec visible par l’utilisateur |
| Politique de workers chauds | Modifie la latence et le coût à l’inactivité |
| Forme de la requête et de la réponse | Confirme que les clients compatibles OpenAI peuvent être adaptés proprement |
Si votre requête de recherche exacte est runpod serverless endpoints vllm deployment guide, traitez « endpoints » comme un sujet d’exploitation : construisez l’endpoint, mais testez aussi les démarrages à froid, la mise à l’échelle des workers, les limites de requêtes et le retour en arrière.
Guide de déploiement Ray Serve vLLM
Un guide de déploiement Ray Serve vLLM est utile lorsque le déploiement n’est plus seulement un modèle sur un worker. Ray Serve peut aider les équipes à construire une application de service qui compose des déploiements, met à l’échelle des réplicas et s’exécute sur un cluster Ray. C’est précieux lorsque vous avez besoin d’une logique de service au niveau Python autour du modèle, d’un routage personnalisé, d’applications multi-modèles ou d’un cluster déjà standardisé sur Ray.
Utilisez Ray Serve lorsque :
- Vous exécutez déjà Ray pour l’infrastructure ML.
- Vous avez besoin de plusieurs déploiements dans un même graphe de service.
- Vous voulez un routage au niveau de l’application autour d’un ou plusieurs moteurs vLLM.
- Vous avez besoin d’un chemin du test local vers un cluster Ray.
- Votre équipe plateforme peut exploiter Ray, pas seulement vLLM.
Le compromis, c’est la surface opérationnelle. Ray apporte de la puissance d’orchestration, mais ajoute aussi les opérations du cluster Ray, le comportement d’autoscaling, les considérations de stockage d’objets, les journaux, les tableaux de bord et un autre chemin de mise à niveau. Pour un seul modèle derrière un seul endpoint, un déploiement vLLM direct peut être plus simple.
Modèle de déploiement Kubernetes
Kubernetes est un bon choix lorsque votre organisation exploite déjà des nœuds GPU, l’ingress, les secrets, les métriques et les politiques de déploiement dans Kubernetes. Ce n’est pas automatiquement le premier déploiement adéquat pour une petite équipe.
La liste de contrôle Kubernetes :
| Zone | Liste de contrôle |
|---|---|
| Planification GPU | Labels de nœuds, taints, demandes de ressources, pilote de périphérique et isolation GPU |
| Stockage du modèle | Volume persistant, synchronisation vers un object storage ou stratégie d’image intégrée |
| Démarrage | Réchauffement du cache du modèle et probe de readiness réaliste |
| Santé | Probe de liveness qui ne tue pas les chargements de modèle lents mais sains |
| Déploiement | Déploiement canary ou blue-green avec retour en arrière rapide |
| Autoscaling | Mise à l’échelle selon la file, la latence ou les métriques GPU, pas seulement selon le CPU |
| Réseau | Interne uniquement par défaut ; ingress public uniquement via des contrôles d’authentification |
| Observabilité | Latence par route, taux d’erreur, mémoire GPU et attribution des coûts |
Si votre plateforme n’a pas déjà une maturité Kubernetes GPU, commencez d’abord avec un hôte GPU ou un endpoint géré. Kubernetes devrait réduire le risque opérationnel, pas transformer un simple endpoint en projet de cluster.
Plan de test de charge pour un déploiement vLLM
Ne testez pas la charge avec une seule invite. Créez un ensemble de requêtes représentatif.
Utilisez au moins trois traces :
- Chat court : invite courte, sortie courte, forte concurrence.
- RAG à long contexte : invite longue, sortie moyenne, modèle de système et de récupération répété.
- Agent ou boucle d’outils : schéma répété, sortie structurée, annulation, relances et contexte multi-tours.
Enregistrez :
| Métrique | Cible |
|---|---|
| Requêtes acceptées par minute | Mesure le débit utile |
| Temps jusqu’au premier token p50/p95/p99 | Montre la latence interactive |
| Latence de bout en bout p50/p95/p99 | Montre le temps de tâche visible par l’utilisateur |
| Taux d’erreur et de timeout | Montre la fiabilité sous charge |
| Latence ajustée aux retries | Montre l’expérience réelle après les échecs |
| Pic de mémoire GPU | Montre la marge de sécurité |
| Coût par sortie acceptée | Montre l’économie |
Exécutez deux benchmarks :
- Exécution par défaut : réglage minimal, pour connaître le délai de mise en production.
- Exécution optimisée : batching, cache, quantification et limites de requêtes ajustés, pour connaître le plafond.
Si l’exécution optimisée est plus rapide mais fragile, ne la déployez pas comme défaut. Déployez la configuration que votre équipe d’astreinte peut expliquer.
Quand ne pas déployer vLLM vous-même
L’auto-hébergement est précieux lorsque vous avez besoin du contrôle du matériel, de poids personnalisés, d’une stricte proximité des données ou d’une forte utilisation soutenue sur une charge de travail stable. Il est moins intéressant lorsque le trafic est incertain, que le choix du modèle change souvent, que des modèles propriétaires de pointe sont requis ou que l’équipe manque de capacité pour l’exploitation de l’inférence.
Choisissez d’abord une API de modèle gérée ou un routeur lorsque :
- Vous testez encore la qualité du modèle.
- Vous avez besoin de changements fréquents de modèle.
- Le trafic est irrégulier ou difficile à prévoir.
- Le repli entre fournisseurs compte plus que le contrôle du GPU.
- Vous avez besoin d’un registre d’utilisation, de budgets, de factures et d’une gouvernance d’équipe avant le réglage du GPU.
Flatkey s’intègre à cette couche lorsque les charges de travail côté API ont besoin d’une clé, d’un solde, d’une facture, d’historiques d’utilisation et d’un accès aux routes officielles des modèles. Si une charge de travail s’avère ensuite suffisamment stable pour un service GPU dédié, continuez à comparer le point de terminaison vLLM auto-hébergé avec comparaison des prix des modèles d’IA, comparaison des prix des API d’IA et votre coût GPU mesuré par sortie acceptée.
Modèle de runbook de déploiement
Copiez ceci avant le lancement.
Service:
  Owner:
  On-call:
  Model alias:
  Served model revision:
  vLLM version:
  Container image:
  GPU type and count:
  Base URL:

Request policy:
  Max model length:
  Max output tokens:
  Max concurrency:
  Queue timeout:
  Request timeout:
  Auth method:

Observability:
  Metrics dashboard:
  Log location:
  Trace/request ID field:
  Alert thresholds:

Rollout:
  Canary percentage:
  Rollback image:
  Rollback model revision:
  Fallback route:

Cost:
  GPU cost source:
  Storage/bandwidth assumptions:
  Accepted-output denominator:
  Weekly cost review owner:
Ce modèle compte plus qu’une première commande parfaite. Un guide de déploiement vLLM qui ne peut pas être remis à l’équipe d’astreinte reste un prototype.
Questions fréquemment posées
Est-ce du contenu de guide de déploiement vLLM si j’utilise un point de terminaison GPU géré ?
Oui. Si vLLM est le moteur de service et que vous décidez comment l’exposer, le mettre à l’échelle, l’observer et le sécuriser, cela relève toujours d’un guide de déploiement vLLM. Les détails opérationnels diffèrent entre une VM brute, RunPod Serverless, Ray Serve et Kubernetes, mais les tests d’acceptation sont similaires : contrat du point de terminaison, latence, erreurs, concurrence, retour arrière et coût par sortie acceptée.
Dois-je utiliser RunPod Serverless ou une VM GPU persistante pour vLLM ?
Utilisez RunPod Serverless lorsque la gestion des pics et les opérations de point de terminaison géré comptent plus qu’une latence toujours chaude. Utilisez une VM GPU persistante lorsque vous avez besoin de performances à chaud prévisibles, d’un contrôle direct de l’hôte ou d’un chemin de débogage plus simple. Testez les deux si la latence et l’utilisation déterminent la décision.
Quand Ray Serve a-t-il du sens avec vLLM ?
Ray Serve a du sens lorsque vLLM fait partie d’une application de service plus large, surtout si vous exploitez déjà Ray. Pour un seul modèle derrière un seul point de terminaison, le service direct avec vLLM peut être plus simple à exécuter.
vLLM peut-il remplacer l’API OpenAI ?
vLLM peut exposer une interface compatible OpenAI pour les modèles auto-hébergés pris en charge, mais cela ne rend pas les modèles à poids ouverts identiques aux API propriétaires de pointe. Traitez-le comme un contrat de point de terminaison et une option de service, puis validez la qualité du modèle, la latence et le coût opérationnel par rapport à votre charge de travail.
Que dois-je mesurer en premier ?
Mesurez le taux de réponse acceptée, le temps jusqu’au premier jeton, la latence p95 et p99, le taux de timeout, la pression mémoire GPU et le coût par sortie acceptée. Les jetons bruts par seconde sont utiles, mais ils ne suffisent pas pour les décisions de production.
Quelle est la place de Flatkey avec vLLM ?
Utilisez vLLM lorsque vous devez posséder la couche de service GPU. Utilisez Flatkey lorsque vous voulez une couche d’API de modèle unique compatible OpenAI, une facturation unifiée, des historiques d’utilisation et une gouvernance sur les routes et outils de modèles officiels. De nombreuses équipes utiliseront les deux : vLLM pour les charges de travail auto-hébergées stables et Flatkey pour les modèles de pointe, le fallback, les expérimentations et la gouvernance côté API.
Liste de contrôle finale
Avant le lancement, votre guide de déploiement vLLM devrait produire ces éléments :
- Une révision de modèle et une version de conteneur épinglées.
- Une URL de base compatible OpenAI testée.
- Une frontière d’authentification et réseau.
- Des limites de requêtes pour le contexte, la sortie, le timeout et la concurrence.
- Des métriques pour la latence, les erreurs, la mise en file d’attente, le débit et la mémoire GPU.
- Un chemin de retour arrière et l’image précédente connue comme bonne.
- Une feuille de calcul du coût par sortie acceptée.
- Un dossier de décision expliquant pourquoi vLLM auto-hébergé est préférable à une API de modèle gérée pour cette charge de travail.
Si ces éléments existent, vous ne faites pas que faire fonctionner vLLM. Vous exploitez une API LLM sur des GPU.
Sources officielles à garder ouvertes
- Documentation du serveur compatible OpenAI de vLLM
- Documentation de déploiement Docker de vLLM
- Documentation des métriques de production de vLLM
- Documentation Ray Serve LLM
- Documentation des points de terminaison RunPod Serverless
- Documentation NVIDIA Container Toolkit
- Flatkey Compute
- Tarifs Flatkey


