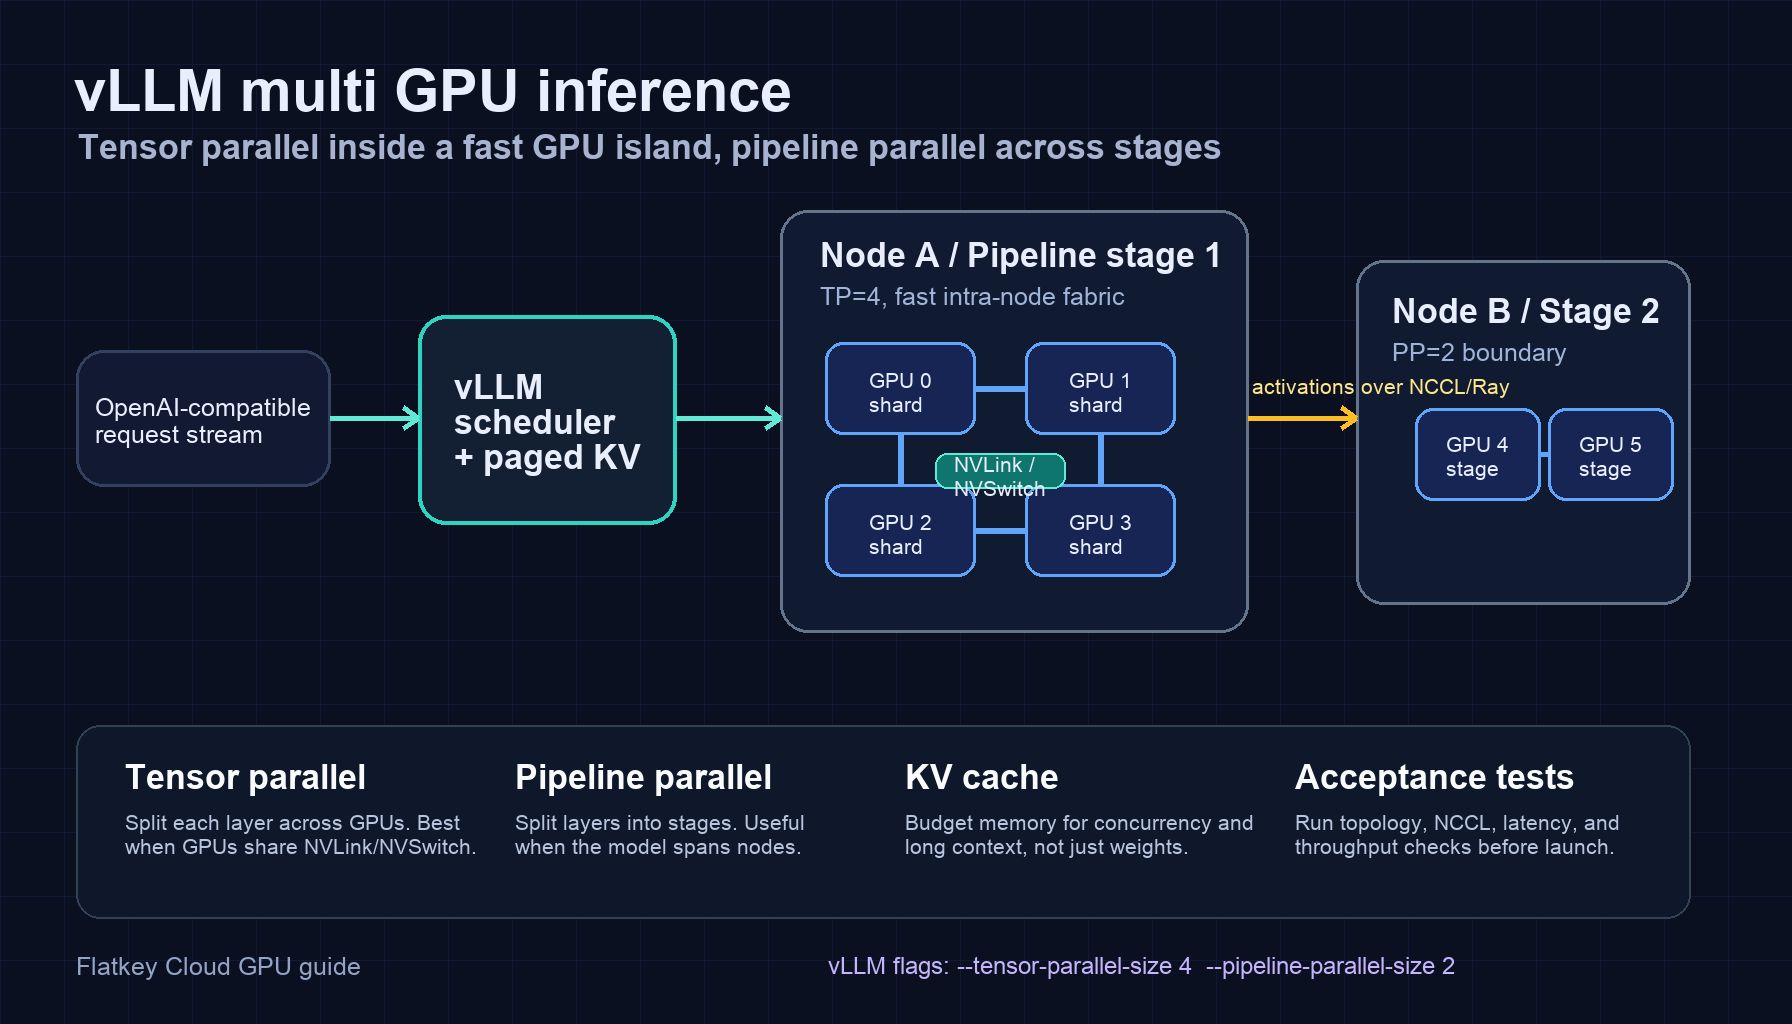
Penerapan vLLM Expert Parallel untuk DeepSeek dan Model MoE Lainnya
vLLM expert parallel adalah mode penerapan yang digunakan ketika lapisan pakar model MoE perlu dibagi di seluruh GPU, alih-alih ditangani sebagai satu grup tensor-paralel besar. Dalam vLLM saat ini, sakelarnya adalah --enable-expert-parallel. Anda menentukan ukuran paralelisme pakar secara tidak langsung melalui pengaturan tensor-paralel (TP) dan data-paralel (DP): dokumentasi vLLM menyatakan EP_SIZE = TP_SIZE × DP_SIZE.
Detail itu penting. Banyak runbook mencari “flag ukuran vLLM expert parallel” terpisah, lalu mencoba memaksakan flag yang bukan bagian dari build yang mereka pin. Mulailah dengan sakelar yang didukung, periksa vllm serve --help pada image persis yang akan Anda terapkan, dan buat pilihan TP/DP berdasarkan rencana kapasitas yang terukur.
Playbook ini mencakup jalur aman dari penerapan DeepSeek MoE satu node ke vLLM expert parallel multinode, termasuk pilihan backend, penyeimbangan beban pakar, pengujian penerimaan, dan isolasi kegagalan. Ini ditulis untuk engineer infrastruktur ML dan AI, bukan untuk demo satu perintah.
Catatan versi: Kernel MoE, dependensi, dan antarmuka CLI vLLM berkembang dengan cepat. Perilaku dan perintah yang didokumentasikan di bawah ini diperiksa terhadap dokumentasi resmi vLLM pada 16 Oktober 2026. Pin image vLLM dan verifikasi flag terhadap versi yang dipin tersebut sebelum peluncuran produksi.
Jawaban singkat
| Pertanyaan | Jawaban praktis |
|---|---|
| Apa yang mengaktifkan vLLM expert parallel? | Tambahkan --enable-expert-parallel ke penerapan MoE yang didukung. |
| Bagaimana ukuran EP dipilih? | Dalam dokumentasi vLLM expert parallel saat ini, ukuran tersebut dihitung sebagai TP × DP; tetapkan --tensor-parallel-size dan --data-parallel-size, bukan flag ukuran EP yang ditebak. |
| Apa yang berubah? | Lapisan pakar MoE di-shard di seluruh rank EP; lapisan perhatian tetap mengikuti perilaku TP/DP yang didokumentasikan. |
| Kapan Anda sebaiknya menggunakannya? | Saat model MoE, topologi GPU, fabric komunikasi, dan volume permintaan membenarkan distribusi pekerjaan pakar. Ini bukan sakelar percepatan generik untuk model dense. |
| Dari mana Anda harus memulai? | Satu node, revisi model tetap, jejak trafik tetap, dan baseline yang tidak menggunakan EP. |
Panduan penerapan vLLM expert parallel resmi adalah sumber kebenaran untuk fitur ini. Panduan tersebut menjelaskan paralelisme pakar sebagai distribusi pakar MoE di seluruh GPU, biasanya bersama dengan paralelisme data.
Apa yang sebenarnya diubah oleh vLLM expert parallel
Model MoE merutekan setiap token ke sebagian kecil dari banyak jaringan pakar. Tanpa paralelisme pakar, perilaku MoE vLLM yang didokumentasikan membentuk grup tensor-paralel di seluruh DP × TP. Dengan --enable-expert-parallel, lapisan pakar menggunakan paralelisme pakar, sementara lapisan perhatian mempertahankan perilaku TP/DP-nya sendiri.
Untuk topologi konkret, pertimbangkan TP=2 dan DP=4:
| Komponen | Perilaku paralel dengan EP diaktifkan |
|---|---|
| Lapisan pakar | Grup EP yang mencakup 8 rank; pakar didistribusikan di seluruh GPU tersebut. |
| Lapisan perhatian | Grup tensor-paralel berukuran 2 dalam masing-masing dari 4 grup DP. |
| Ukuran EP efektif | 2 × 4 = 8. |
Inilah alasan vLLM expert parallel bukan pengganti untuk menentukan bagaimana lapisan perhatian, kapasitas cache KV, konkurensi permintaan, dan topologi jaringan saling sesuai. Ini adalah salah satu bagian dari desain serving terdistribusi.
Untuk pengantar yang lebih luas mengenai pola multi-GPU yang sesuai untuk sebuah beban kerja, lihat inferensi multi-GPU vLLM: pengaturan tensor dan pipeline parallel.
Flag vLLM expert parallel dan pertanyaan “flag ukuran”
Dokumentasi publik saat ini memberikan flag aktivasi kanonis:
--enable-expert-parallel
Dokumentasi tersebut juga menyatakan bahwa ukuran expert-parallel dihitung dari ukuran tensor dan data parallel:
EP_SIZE = TP_SIZE × DP_SIZE
Jadi, pola dokumentasi penerapan vLLM expert parallel adalah:
vllm serve <MODEL> --tensor-parallel-size <TP> --data-parallel-size <DP> --enable-expert-parallel
Jangan menyalin opsi --expert-parallel-size terpisah dari issue lama, wrapper internal, atau stack serving lain lalu menganggapnya berlaku untuk build vLLM Anda. Perlakukan pertanyaan “berapa ukuran EP saya?” sebagai pertanyaan topologi:
- Pilih jumlah GPU dan node yang tersedia untuk satu grup serving.
- Pilih TP untuk sharding lapisan perhatian dan perilaku model lokal.
- Pilih DP untuk kapasitas engine independen dan distribusi permintaan.
- Aktifkan EP untuk lapisan MoE.
- Konfirmasikan topologi proses yang dihitung dalam log startup dan jalankan uji beban.
Referensi CLI serve vLLM adalah otoritas terakhir untuk flag dalam rilis tertentu.
Sebelum menerapkan: gerbang kesiapan
Lakukan pemeriksaan ini sebelum menyalahkan expert parallel atas masalah startup atau throughput.
| Gerbang | Yang harus diverifikasi | Mengapa ini penting |
|---|---|---|
| Versi | Kunci container vLLM, stack CUDA, dan revisi model di setiap worker. | Image campuran atau wheel yang tidak cocok dapat mengubah masalah topologi menjadi error kernel yang sulit dipahami. |
| Kecocokan model | Perhitungkan bobot model, cache KV, workspace runtime, dan expert redundan apa pun sebelum memilih jumlah GPU. | EP tidak menghilangkan kebutuhan perencanaan memori. |
| Dependensi | Ikuti prasyarat kernel EP vLLM terbaru, termasuk DeepEP dan DeepGEMM jika diwajibkan oleh dokumentasi. | Dokumentasi expert-parallel menyebutkan ini sebagai prasyarat. |
| Fabric | Verifikasi topologi GPU pada satu node dan verifikasi komunikasi GPU antar-node sebelum permintaan produksi pertama. | EP menambahkan komunikasi ke setiap forward pass MoE. |
| Jaringan kontrol | Tentukan secara eksplisit alamat node utama, keterjangkauan port, dan pemilihan NIC. | Data plane yang sehat tidak membantu ketika discovery control plane diarahkan ke antarmuka yang salah. |
| Baseline | Catat latensi, throughput, tingkat error, dan ruang sisa memori GPU tanpa EP. | Anda memerlukan jawaban yang dapat dibandingkan untuk “apakah EP membantu?” |
Untuk sisi memori dari gerbang ini, gunakan panduan kebutuhan memori GPU LLM untuk membuat lembar kerja kapasitas sebelum memesan cluster yang lebih besar.
Buat eksperimen pertama tetap sederhana
Gunakan satu revisi model, satu tokenizer yang sudah diketahui, satu campuran permintaan, satu rentang konkurensi, dan satu set flag peluncuran tetap. Hindari mengubah kuantisasi, pengaturan cache, perangkat keras, dan backend all-to-all dalam pengujian yang sama. Baseline yang bersih memungkinkan Anda mengetahui apakah vLLM expert parallel mengubah throughput yang berguna atau hanya memindahkan bottleneck.
Deployment DeepSeek MoE satu node
Panduan vLLM saat ini menggunakan DeepSeek-V3-0324 sebagai contoh satu node dengan TP satu arah, DP delapan arah, dan EP diaktifkan:
vllm serve deepseek-ai/DeepSeek-V3-0324 --tensor-parallel-size 1 --data-parallel-size 8 --enable-expert-parallel
Dokumentasi menjelaskan efek yang dimaksud: bobot attention direplikasi di seluruh rank DP, sementara bobot expert dibagi di antara GPU. Dokumentasi menggunakan node H200 atau H20 dengan delapan GPU sebagai contoh topologi dan menyarankan tim dengan perangkat keras berbeda untuk memvalidasi kecocokannya sendiri, alih-alih memperlakukan contoh tersebut sebagai janji ukuran yang berlaku universal.
Gunakan perintah tersebut sebagai titik awal topologi, bukan sebagai konfigurasi produksi yang cukup disalin-tempel. Sebelum mengekspos endpoint:
- Konfirmasikan server mencapai status siap yang sehat tanpa fallback tersembunyi ke jalur kernel yang berbeda.
- Jalankan pengujian kebenaran dengan prompt yang diketahui serta perilaku schema atau tool-call yang diharapkan.
- Jalankan beban stabil kecil, lalu burst dan sampel konteks panjang.
- Bandingkan waktu p50 dan p99 hingga token pertama, latensi antar-token, throughput output, ruang sisa memori, dan error dengan baseline non-EP.
- Simpan perintah peluncuran, digest image, revisi model, versi driver, dan snapshot metrik bersama hasil benchmark.
Jika Anda masih membangun lapisan API di sekitarnya, panduan deployment vLLM ini membahas jalur server yang kompatibel dengan OpenAI secara terpisah dari keputusan paralelisme MoE.
Pilih backend all-to-all berdasarkan workload, bukan kebiasaan
vLLM menyediakan --all2all-backend untuk komunikasi expert-parallel. Panduan resmi saat ini menjelaskan default serbaguna serta mode DeepEP khusus. Cocokkan backend dengan trafik yang benar-benar Anda ukur.
| Backend | Kecocokan yang didokumentasikan | Implikasi deployment |
|---|---|---|
allgather_reducescatter |
Deployment EP + DP serbaguna | Konfigurasi kontrol yang masuk akal sebelum tuning khusus. |
deepep_high_throughput |
Workload multi-node yang didominasi prefill | Evaluasi ketika prompt panjang dan throughput agregat mendominasi sasaran layanan. |
deepep_low_latency |
Workload multi-node yang didominasi decode | Evaluasi ketika latensi token yang dihasilkan lebih penting daripada throughput prefill maksimum. |
| Mode FlashInfer NVLink | Sistem khusus MNNVL / NVLink | Gunakan hanya ketika perangkat keras dan dokumentasi vLLM saat ini sesuai dengan persyaratan backend. |
Intinya bukan memilih label yang tampak paling cepat. Intinya adalah menguji satu backend pada satu waktu terhadap campuran panjang prompt, konkurensi, fabric, dan SLO Anda. Ukur dampaknya terhadap latensi tail serta token per detik.
vLLM expert parallel multi-node: pola dua node
Untuk deployment multi-node, dokumentasi vLLM menggunakan node utama yang menangani trafik API dan node worker sekunder --headless. Berikut adalah bentuk berparameter dari pola terdokumentasi tersebut. Ganti alamat dan jumlah dengan nilai yang sesuai dengan cluster yang benar-benar Anda uji.
Pada node utama:
export GLOO_SOCKET_IFNAME=eth0
vllm serve deepseek-ai/DeepSeek-V3-0324 --all2all-backend deepep_low_latency --tensor-parallel-size 1 --enable-expert-parallel --data-parallel-size 16 --data-parallel-size-local 8 --data-parallel-address <PRIMARY_NODE_IP> --data-parallel-rpc-port 13345 --api-server-count 8
Pada node kedua:
export GLOO_SOCKET_IFNAME=eth0
vllm serve deepseek-ai/DeepSeek-V3-0324 --all2all-backend deepep_low_latency --tensor-parallel-size 1 --enable-expert-parallel --data-parallel-size 16 --data-parallel-size-local 8 --data-parallel-start-rank 8 --data-parallel-address <PRIMARY_NODE_IP> --data-parallel-rpc-port 13345 --headless
Angka-angka ini penting:
--data-parallel-sizeadalah ukuran DP total di seluruh grup penyajian.--data-parallel-size-localadalah jumlah rank DP yang diluncurkan pada node tersebut.--data-parallel-start-rankadalah ukuran DP lokal kumulatif dari node-node sebelumnya.- Node sekunder bersifat headless karena node primer menangani permintaan klien.
Untuk klaster InfiniBand, panduan vLLM saat ini secara khusus menyebut GLOO_SOCKET_IFNAME=eth0 untuk menjaga penemuan grup terdistribusi pada antarmuka kontrol Ethernet yang dipilih. Ini bukan pengganti untuk memvalidasi komunikasi NCCL dan GPU-ke-GPU antarnode.
Daftar periksa penerimaan multi-node
Sebelum mengirimkan trafik pelanggan ke grup expert parallel vLLM multi-node, buktikan semua hal berikut:
- Setiap worker me-resolve revisi model yang sama dan memulai dengan rank yang dimaksudkan.
- Node primer dapat menjangkau alamat dan port RPC yang dikonfigurasi dari setiap peer.
- Grup terdistribusi berhasil diinisialisasi berulang kali setelah restart bersih.
- Permintaan selesai pada konkurensi rendah, lalu di bawah trace berkelanjutan.
- Campuran permintaan yang sengaja dibuat tidak seimbang tidak menyebabkan hang senyap atau lonjakan tajam latensi ekor.
- Memulai ulang satu worker uji menghasilkan sinyal kegagalan yang dapat diamati dan ditindaklanjuti, alih-alih permintaan yang mengantre tanpa batas.
panduan pemecahan masalah terdistribusi vLLM merekomendasikan verifikasi komunikasi GPU antarnode dan memastikan variabel lingkungan komunikasi tersedia bagi setiap node. Jika Anda menggunakan Ray, panduan tersebut juga mendokumentasikan agar konfigurasi IP host vLLM dan Ray tetap selaras.
Tambahkan Penyeimbangan Beban Expert Parallel hanya setelah Anda mengamati ketidakseimbangan
Perutean MoE tidak selalu terdistribusi secara merata di produksi. Expert Parallel Load Balancer (EPLB) vLLM mengumpulkan data beban dan secara berkala mendistribusikan ulang pemetaan expert di seluruh rank EP. Fitur ini diaktifkan dengan --enable-eplb.
vllm serve Qwen/Qwen3-30B-A3B --enable-expert-parallel --enable-eplb --eplb-config '{"window_size":1000,"step_interval":3000,"num_redundant_experts":2,"log_balancedness":true}'
Mulailah tanpa EPLB kecuali Anda memiliki bukti adanya expert panas, pekerjaan per-rank yang tidak merata, atau latensi ekor persisten yang mengikuti ketimpangan perutean. EPLB dapat menggunakan expert redundan, dan salinan expert tambahan tersebut mengonsumsi memori GPU. Perlakukan fitur ini sebagai optimasi dengan biaya kapasitas, bukan sebagai flag expert parallel vLLM yang wajib.
Untuk eksperimen awal:
- Catat utilisasi per-rank dan latensi permintaan tanpa EPLB.
- Aktifkan pencatatan balancedness untuk jendela yang terkontrol.
- Tambahkan pengaturan redundansi terkecil yang sesuai dengan anggaran memori.
- Bandingkan latensi ekor, throughput, ruang memori tersisa, dan gangguan penyeimbangan ulang di bawah trace yang sama.
- Siapkan perintah rollback dan konfigurasi deployment tanpa EPLB.
Rencana benchmark yang menjawab pertanyaan yang tepat
Jangan menyebut rollout EP berhasil hanya karena prosesnya berjalan. Gunakan revisi model, prompt, batas output, konkurensi, kuantisasi, pengaturan cache, dan reservasi perangkat keras yang sama untuk setiap perbandingan.
| Pengujian | Yang diungkap | Sinyal keputusan |
|---|---|---|
| Decode prompt pendek dengan konkurensi tinggi | Perilaku kolektif dan antrean pada sisi decode | Latensi antartoken p99 dan throughput token yang dihasilkan |
| Prefill prompt panjang | Overhead prefill dan all-to-all | Waktu p99 hingga token pertama dan throughput prefill agregat |
| Trace ketimpangan expert | Apakah sejumlah kecil expert menciptakan rank panas | Ketimpangan rank, pertumbuhan antrean, dan alasan untuk EPLB |
| Uji kapasitas konteks panjang | Ruang memori tersisa di bawah tekanan cache yang realistis | Tingkat OOM, kegagalan admission, dan konkurensi aman |
| Simulasi restart / partisi | Perilaku operasional saat peer gagal atau port terblokir | Waktu hingga deteksi, visibilitas error, dan jalur pemulihan |
Catat lebih dari sekadar throughput rata-rata. Deployment yang meningkatkan rata-rata tetapi merusak latensi p99 atau membuat pemulihan tidak transparan bukanlah kemenangan produksi yang jelas.
Pemecahan masalah deployment expert parallel vLLM
| Gejala | Kelas penyebab yang mungkin | Langkah pertama |
|---|---|---|
Argumen --expert-parallel-size tidak dikenal |
Runbook dan vLLM yang terinstal tidak cocok | Jalankan vllm serve --help, pin build, dan gunakan ukuran TP/DP yang didokumentasikan untuk build tersebut. |
| Startup gagal di sekitar kernel EP atau backend all-to-all | Dependensi EP / stack kontainer tidak ada atau tidak kompatibel | Periksa kembali prasyarat EP dan image kontainer saat ini, alih-alih mengubah beberapa flag peluncuran sekaligus. |
| Worker multi-node macet selama inisialisasi | Konfigurasi alamat control plane, port, NIC, atau process group | Verifikasi keterjangkauan, antarmuka yang dipilih, perhitungan rank, dan komunikasi terdistribusi sebelum menyesuaikan kernel. |
| Permintaan pertama macet setelah worker tampak siap | Komunikasi GPU antar-node tidak sehat | Jalankan pemeriksaan komunikasi vendor/vLLM, lalu periksa konfigurasi NCCL dan antarmuka. |
| Throughput tidak meningkat | Campuran trafik, fabric, perilaku batch, atau konfigurasi sisi attention masih menjadi bottleneck | Bandingkan dengan baseline berdasarkan panjang prompt dan konkurensi; ubah satu variabel topologi pada satu waktu. |
| Kehabisan memori setelah mengaktifkan EPLB | Memori expert redundan menghabiskan margin keamanan | Kurangi redundansi atau sediakan headroom memori yang lebih besar; ulangi uji kapasitas. |
| Satu rank secara konsisten lebih lambat | Ketimpangan routing expert atau performa host/fabric yang tidak merata | Ukur beban pada level rank terlebih dahulu; pertimbangkan EPLB hanya jika bukti mendukungnya. |
Kebiasaan pentingnya adalah diagnosis yang terfokus. Pertahankan model, image, jejak trafik, dan topologi tetap sama saat Anda mengubah satu faktor. Hal itu mengubah laporan samar “EP lambat” menjadi observasi yang dapat ditindaklanjuti.
Urutan penerapan produksi
- Tetapkan baseline. Jalankan model MoE target tanpa EP dan simpan metrik, log, serta manifes peluncuran.
- Aktifkan EP pada satu node. Gunakan
--enable-expert-paralleldengan topologi TP/DP yang dipilih secara eksplisit. - Verifikasi kualitas dan kapasitas. Periksa perilaku output, headroom memori, latensi p50/p99, dan throughput berkelanjutan.
- Pilih backend berdasarkan bentuk trafik. Bandingkan backend umum dengan backend khusus yang relevan hanya menggunakan jejak yang sama.
- Tambahkan EPLB hanya berdasarkan bukti. Gunakan data keseimbangan dan headroom memori untuk membenarkan expert redundan.
- Perluas ke multi-node. Verifikasi alokasi rank, jaringan kontrol, dan komunikasi GPU antar-node sebelum meningkatkan trafik.
- Jalankan simulasi kegagalan. Uji restart, kehilangan port, dan worker yang tidak sehat sebelum trafik produksi menemukan celah tersebut untuk Anda.
- Pin dan dokumentasikan. Simpan versi, flag peluncuran, topologi, metrik, dan langkah rollback bersama deployment.
Kapan tidak melakukan self-hosting pada lapisan serving MoE
Expert parallel vLLM adalah investasi yang tepat ketika kontrol atas penempatan model, jalur data, reservasi hardware, dan perilaku serving merupakan bagian dari persyaratan produk. Ini kurang cocok ketika tim terutama membutuhkan akses model dan tidak dapat mengelola utilisasi GPU, jaringan terdistribusi, pengujian upgrade, serta pemulihan on-call.
Sebelum mereservasi cluster yang lebih besar, bandingkan model operasional dengan jalur API terkelola dalam GPU cloud vs. model API: kapan self-hosting benar-benar menghemat biaya. Jawaban yang tepat bisa berupa hybrid: lakukan self-hosting untuk workload yang memerlukan kontrol infrastruktur dan gunakan lapisan API untuk sisanya.
FAQ
Apakah --enable-expert-parallel mengaktifkan expert parallel vLLM?
Ya. CLI vLLM saat ini mendokumentasikan --enable-expert-parallel sebagai penggunaan expert parallelism alih-alih tensor parallelism untuk layer MoE.
Apa flag ukuran expert parallel vLLM?
Untuk alur deployment yang saat ini didokumentasikan, ukuran EP diturunkan dari --tensor-parallel-size dan --data-parallel-size: EP_SIZE = TP × DP. Verifikasi antarmuka CLI yang tepat pada rilis vLLM yang Anda pin, alih-alih mengasumsikan adanya flag ukuran terpisah.
Apakah expert parallel menggantikan tensor parallelism di semua tempat?
Tidak. EP mengubah strategi layer expert MoE. Perilaku layer attention tetap bergantung pada nilai TP dan DP yang Anda pilih.
Apakah setiap deployment DeepSeek harus mengaktifkan EPLB?
Tidak. Pertama, tunjukkan ketidakseimbangan beban expert pada trafik yang representatif dan konfirmasikan bahwa biaya memori expert redundan sesuai dengan cluster. EPLB adalah optimasi, bukan persyaratan default.
Backend all-to-all mana yang harus saya gunakan?
Mulailah dari panduan vLLM saat ini, lalu uji backend yang sesuai dengan bentuk workload Anda: opsi tujuan umum untuk kompatibilitas luas, mode DeepEP ber-throughput tinggi untuk trafik yang berat pada prefill, atau mode DeepEP berlatensi rendah untuk trafik yang berat pada decode.
Referensi
- Dokumentasi Penerapan vLLM Expert Parallel
- Dokumentasi Penerapan vLLM Data Parallel
- Referensi CLI vLLM serve
- Pemecahan masalah penerapan terdistribusi vLLM
Langkah berikutnya: gunakan perintah single-node sebagai lingkungan validasi yang terkontrol, buat baseline, dan terapkan hanya topologi yang meningkatkan SLO yang benar-benar Anda prioritaskan. Dengan demikian, vLLM expert parallel menjadi keputusan produksi, bukan sekadar flag yang Anda harapkan lebih cepat.