
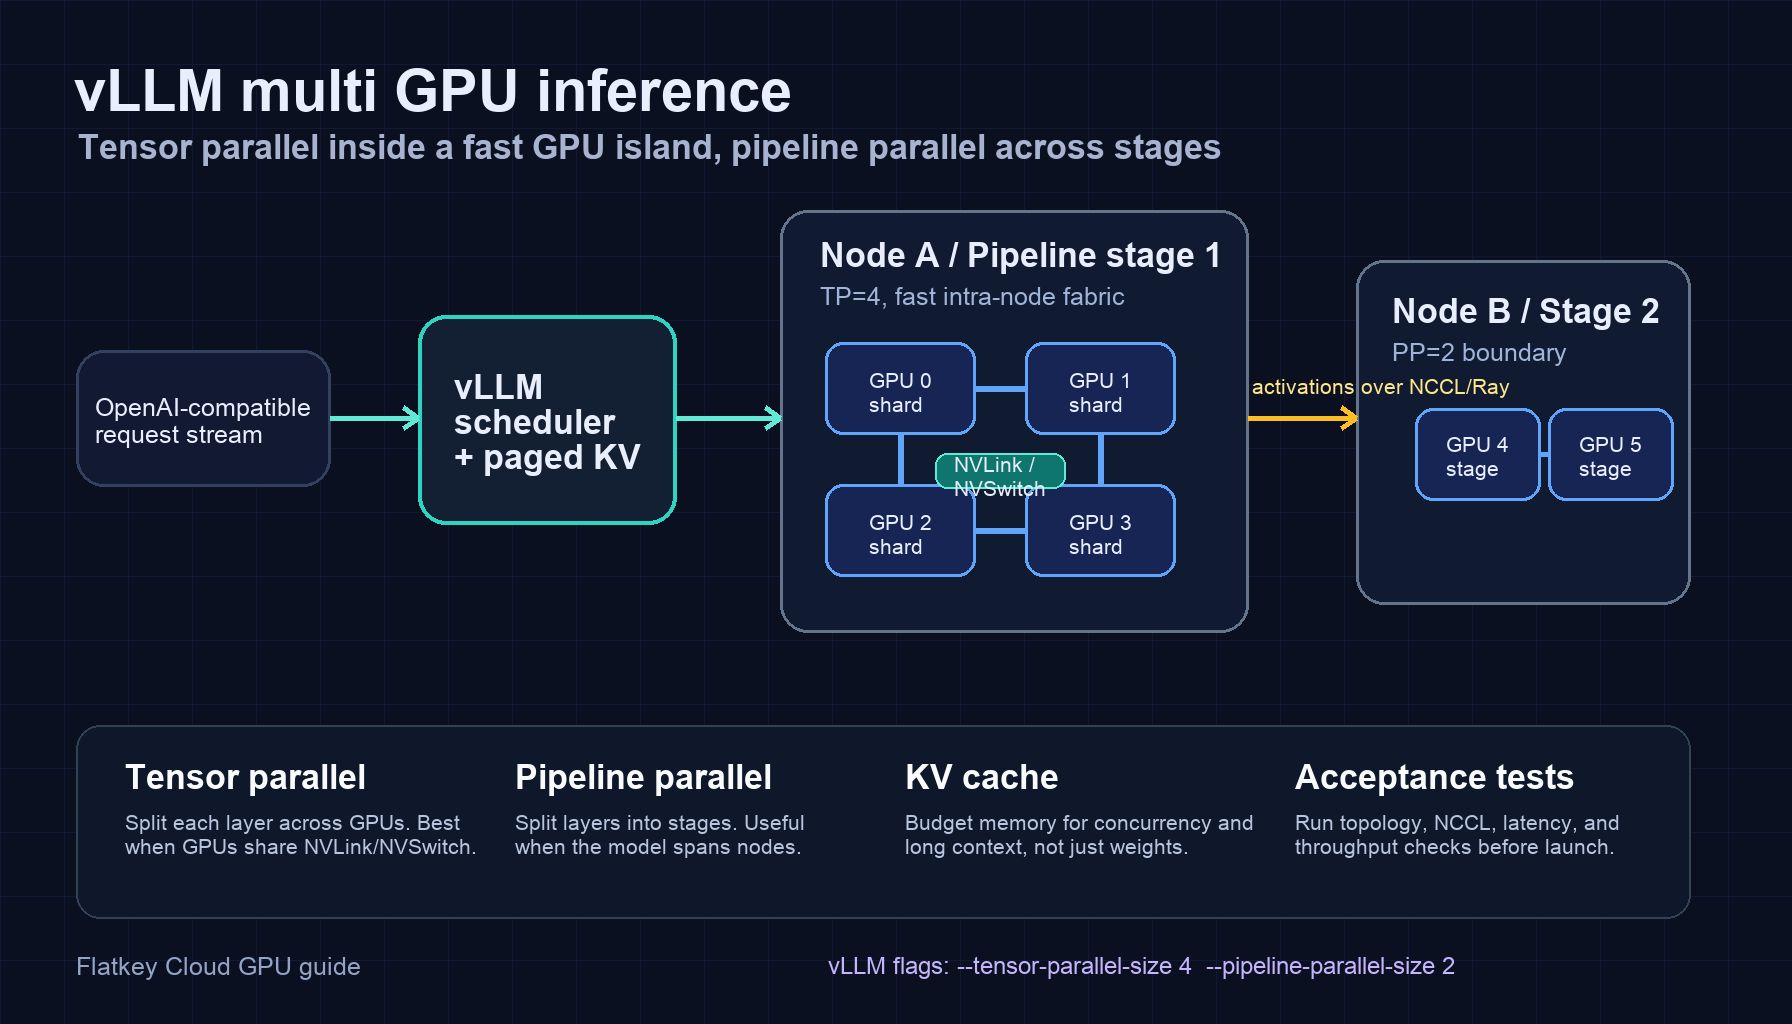
L'inférence vLLM multi-GPU démarre généralement pour l'une de trois raisons : les poids du modèle ne tiennent pas sur une seule GPU, le cache KV pour le contexte et la concurrence requis ne tient pas sur une seule GPU, ou une seule GPU ne peut pas fournir le débit en tokens par seconde et le temps jusqu'au premier token dont vous avez besoin. La configuration ne se résume pas à une décision sur --tensor-parallel-size. Vous devez aussi faire correspondre le parallélisme tensoriel, le parallélisme pipeline, le backend d'exécution et la topologie physique des GPU.
La version courte :
- Utilisez d'abord le parallélisme tensoriel lorsque le modèle tient sur plusieurs GPU dans la même île GPU rapide, en particulier un nœud H100/H200/B200 à 8 GPU avec NVLink ou NVSwitch.
- Ajoutez du parallélisme pipeline lorsque le modèle doit s'étendre sur plusieurs nœuds ou lorsque le parallélisme tensoriel seul crée trop de communication inter-nœuds.
- Considérez
tp * ppcomme le nombre de workers GPU utilisés par une réplique vLLM. - Effectuez des benchmarks avec votre longueur de prompt réelle, votre longueur de sortie, la forme du batch et la quantification du modèle avant de considérer la configuration comme prête pour la production.
- Si votre équipe a seulement besoin d'un endpoint compatible OpenAI et non d'un contrôle direct du matériel, comparez le chemin GPU à une base de référence de modèle/API managé telle que Flatkey avant de louer et d'exploiter un cluster.
Ce guide fournit un exemple pratique d'inférence vLLM multi-GPU, un schéma d'architecture, des commandes de lancement et les vérifications qui détectent généralement les mauvaises configurations multi-GPU avant les utilisateurs.
Architecture d'inférence vLLM multi-GPU
Dans vLLM, le parallélisme tensoriel répartit le travail de chaque couche de transformeur sur plusieurs workers GPU. Le parallélisme pipeline répartit les couches du modèle en étapes, de sorte que différents groupes de GPU exécutent différentes parties du modèle. Pour un service en production, ces choix influencent plus que la mémoire : ils modifient les communications collectives, la planification des requêtes, le rayon d'impact des pannes et le fait que l'échelle réseau devienne ou non le goulot d'étranglement.
Une architecture de départ courante est la suivante :
| Couche | Choix pratique | Pourquoi c'est important |
|---|---|---|
| Surface API | vllm serve avec le serveur compatible OpenAI |
Permet aux équipes applicatives de conserver des clients de style OpenAI tout en changeant le backend de service. |
| Groupe de parallélisme tensoriel | Un nœud ou une île NVLink/NVSwitch | Les couches en parallélisme tensoriel communiquent fréquemment, donc des liaisons inter-nœuds lentes pénalisent rapidement. |
| Étapes pipeline | Découpage au niveau du nœud ou du rack lorsque le modèle ne peut pas tenir dans un seul nœud | Le parallélisme pipeline peut réduire la quantité de communication inter-nœuds par rapport au fait de placer un groupe tensoriel sur chaque GPU. |
| Backend distribué | Multiprocessing pour un seul nœud, Ray lorsque vous avez besoin d'une orchestration multi-nœuds | Gardez le service sur un seul nœud simple ; utilisez Ray lorsque les workers doivent s'étendre sur plusieurs machines. |
| Plan de cache KV | Budgétisez la longueur du prompt, la longueur de sortie et la concurrence | Les poids ne sont que le point de départ ; le service sur long contexte peut être limité par le cache KV. |
| Test d'acceptation | Topologie, NCCL, chargement à froid, TTFT, débit et redémarrage après panne | La plupart des déploiements problématiques semblent corrects jusqu'à l'arrivée d'un trafic réaliste. |
Pour une vue d'infrastructure adjacente, consultez le guide d'architecture de cluster GPU. Pour le dimensionnement mémoire, utilisez le tableau de calcul des besoins mémoire GPU pour les LLM une fois qu'il sera disponible.
Parallélisme tensoriel vs parallélisme pipeline dans vLLM
La règle de décision la plus utile est simple :
Utilisez le parallélisme tensoriel à l'intérieur d'une île GPU rapide. Utilisez le parallélisme pipeline pour franchir des frontières plus lentes.
Le parallélisme tensoriel est un bon premier choix lorsque :
- le modèle est trop grand pour une seule GPU, mais tient sur 2, 4 ou 8 GPU dans un même nœud ;
- votre nœud GPU dispose de liaisons GPU-à-GPU à large bande passante ;
- la latence compte et vous voulez que chaque requête traverse une seule réplique logique du modèle sans longue bulle de pipeline ;
- la famille de modèles est bien prise en charge par l'exécution en parallélisme tensoriel de vLLM.
Le parallélisme pipeline devient utile lorsque :
- le modèle ne peut pas tenir dans un seul nœud même après quantification ou en précision réduite ;
- un groupe en parallélisme tensoriel devrait autrement traverser Ethernet ou InfiniBand trop souvent ;
- vous voulez que chaque nœud possède une étape du modèle plutôt que de faire participer chaque couche à des collectives inter-nœuds ;
- vous pouvez tolérer la surcharge de planification et de bulle liée aux étapes pipeline.
N'assumez pas que tp=8 est toujours meilleur que tp=4, ni que pp=2 améliore automatiquement le débit. Pour l'inférence vLLM multi-GPU, la bonne configuration dépend de la taille du modèle, de la pression mémoire, de l'interconnexion, des longueurs de séquence et de la concurrence par lots que votre charge de travail peut soutenir.
Exemple d'inférence vLLM multi-GPU sur un seul nœud
Commencez par un seul nœud lorsque c'est possible. C'est plus facile à déboguer, moins coûteux à benchmarker et cela évite le réseau multi-nœuds comme premier domaine de panne.
Exemple : un serveur à 4 GPU, une réplique vLLM, taille de parallélisme tensoriel 4.
CUDA_VISIBLE_DEVICES=0,1,2,3 \
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4
Utilisez cette configuration lorsqu'un modèle tient proprement sur quatre GPU et que le nœud dispose d'une communication GPU-à-GPU rapide. Pour un nœud à 8 GPU, testez à la fois --tensor-parallel-size 4 et --tensor-parallel-size 8 ; le groupe plus grand peut améliorer la marge mémoire mais peut ajouter une surcharge de communication.
Test de fumée de base :
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-70B-Instruct",
    "messages": [{"role": "user", "content": "Donnez-moi un contrôle de santé du GPU en une phrase."}],
    "max_tokens": 64
  }'
Si cela échoue, ne passez pas encore au multi-nœud. Corrigez d’abord le téléchargement du modèle, la visibilité CUDA, la visibilité NCCL, la compatibilité pilote/runtime et la pression mémoire GPU.
Exemple multi-nœuds avec parallélisme tensoriel et pipeline
Lorsque vous avez besoin de plus de GPU qu’un seul nœud ne peut en fournir, gardez si possible le groupe de parallélisme tensoriel à l’intérieur de chaque nœud, puis utilisez le parallélisme pipeline entre les nœuds.
Forme cible d’exemple :
- deux nœuds ;
- quatre GPU par nœud ;
- taille de parallélisme tensoriel 4 ;
- taille de parallélisme pipeline 2 ;
- travailleurs totaux :
4 * 2 = 8.
Lancement conceptuel :
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
Dans un cluster réel, démarrez Ray sur le nœud maître, rejoignez le cluster Ray avec les nœuds travailleurs, rendez le stockage du modèle accessible à tous les nœuds, et vérifiez que tous les travailleurs voient le nombre de GPU prévu avant de lancer le serveur vLLM. Épinglez votre version exacte de vLLM, l’image CUDA, la branche du pilote et la révision du modèle dans le guide d’exploitation afin qu’une reconstruction ultérieure ne modifie pas silencieusement le comportement.
C’est à ce stade que la qualité de l’infrastructure devient la qualité du produit. Si le second nœud est connecté via un réseau faible, si NCCL choisit la mauvaise interface, ou si le chemin du cache du modèle est lent, les utilisateurs le perçoivent comme une variance de latence, des démarrages à froid longs ou des échecs de requêtes.
Choix du backend : multiprocessing ou Ray
Pour la prise en charge de l’inférence multi-GPU vLLM, utilisez le backend d’exécuteur le plus simple qui convient au déploiement :
| Déploiement | Backend suggéré | Remarques |
|---|---|---|
| Une machine, plusieurs GPU | Multiprocessing ou le backend par défaut de vLLM pour votre version | Plus simple à exploiter ; moins d’éléments mobiles. |
| Plusieurs machines | Ray | Nécessaire lorsque les travailleurs s’étendent sur plusieurs nœuds et ont besoin d’une coordination au niveau du cluster. |
| Service multi-nœuds sur Kubernetes | Ray plus une planification explicite des pods/réseau/stockage | Rendez visibles la planification, le placement et les contrôles de santé au lieu d’espérer que le processus de service trouve les bons GPU. |
Le choix du backend ne doit pas être isolé de la topologie. Si vous n’avez besoin de Ray que parce que le modèle est trop volumineux pour un seul serveur, la question suivante est de savoir si le parallélisme pipeline peut conserver la majeure partie des communications fréquentes à l’intérieur de chaque nœud.
Dimensionnement mémoire avant de choisir TP et PP
Un plan d’inférence multi GPU vLLM doit budgéter la mémoire dans cet ordre :
- Poids : paramètres du modèle après dtype ou quantification.
- Cache KV : longueur du prompt, longueur de sortie, concurrence des lots et dtype du cache.
- Surcharge d’exécution : CUDA graphs, comportement de l’allocateur, tampons de communication, surcharge du tokenizer/serveur et marge de sécurité.
- Marge opérationnelle : redémarrages progressifs, rechargements de modèle, télémétrie et pics de prompt occasionnels.
Le parallélisme tensoriel répartit les poids du modèle et une partie du travail de calcul sur plusieurs GPU, mais il ne rend pas le trafic gratuit. Le parallélisme pipeline peut réduire la pression mémoire par étape, mais il introduit des questions d’équilibrage des étapes. Une étape de pipeline avec plus de pression mémoire ou des noyaux plus lents devient le goulet d’étranglement du débit pour toute la réplique.
Premiers choix pratiques :
| Situation du modèle/runtime | Première forme TP/PP à tester |
|---|---|
| Modèle 7B ou 8B, contexte ordinaire | tp=1, un GPU, mise à l’échelle horizontale des répliques |
| Modèle 32B, forte concurrence | tp=2 ou tp=4 sur un seul nœud |
| Modèle de classe 70B, BF16/FP16 | tp=4 ou tp=8 sur un seul nœud à grande mémoire |
| Très grand modèle dense s’étendant sur plusieurs nœuds | tp=4, pp=2 ou tp=8, pp=2, selon la taille du nœud |
| Modèle MoE | Consultez séparément les recommandations vLLM sur le parallélisme des experts ; ne traitez pas MoE comme un modèle dense par défaut |
Le tableau est un point de départ, pas un résultat de benchmark. Le coût accepté de votre sortie dépend des prompts réels, des sorties réelles, du taux de reprise, du comportement de mise en file d’attente et de l’acceptation qualité.
Vérifications de topologie qui comptent
Avant de publier un endpoint multi-GPU, recueillez ces informations auprès du fournisseur ou de la machine :
- sortie de
nvidia-smi topo -mpour chaque nœud ; - si les GPU partagent NVLink ou NVSwitch à l’intérieur du nœud ;
- la structure réseau entre les nœuds, y compris InfiniBand, RoCE, EFA ou Ethernet ;
- les interfaces visibles par NCCL et si le trafic utilise le chemin prévu ;
- le chemin de stockage des poids du modèle et si plusieurs nœuds chargent depuis un disque partagé lent ;
- la mémoire GPU, l’état MIG, les limites de puissance et les versions du pilote/CUDA.
Les systèmes NVIDIA DGX H100/H200, par exemple, sont documentés comme des systèmes à huit GPU avec connectivité GPU-à-GPU NVSwitch/NVLink et des options réseau 400 Gb/s. Les nœuds PCIe classiques peuvent toujours servir vLLM correctement, mais vous devez vous attendre à un profil de communication différent et effectuer des benchmarks en conséquence.
Pour le contexte sur l’interconnexion, voir NVLink vs NVSwitch. Pour le vocabulaire d’achat de cluster et de topologie, le guide de location de cluster GPU est un complément utile.
Test d’acceptation en production
Exécutez un test par étapes au lieu d’une seule requête de parcours heureux.
- Test de topologie : enregistrez
nvidia-smi topo -m, l’inventaire NIC et l’environnement NCCL. - Test de chargement à froid : mesurez le temps écoulé entre le démarrage du conteneur et le premier jeton réussi.
- Test de requête courte : faible longueur d’invite, longueur de sortie modérée, charge de travail de type chat attendue.
- Test de requête longue : longueur de contexte réaliste proche de l’exigence de votre produit.
- Test de concurrence : augmentez le nombre de requêtes simultanées jusqu’à ce que le p95 du délai d’obtention du premier jeton ou le p95 de la latence inter-jetons dépasse votre limite.
- Test à forte sortie : utilisez des charges de travail qui génèrent de longues complétions, pas seulement des invites de classification.
- Test d’échec : arrêtez un processus worker ou un nœud et vérifiez que le load balancer supprime la réplique.
- Test de redémarrage : redéployez le processus vLLM et confirmez que le cache du modèle, l’état Ray et les vérifications de santé se rétablissent correctement.
Suivez au moins ces métriques :
| Métrique | Pourquoi c’est important |
|---|---|
| Temps jusqu’au premier jeton | Les utilisateurs le ressentent immédiatement dans les workflows de chat et d’agent. |
| Latence inter-jetons | Montre la stabilité du décodage une fois la génération commencée. |
| Jetons par seconde et par réplique | Aide à comparer les configurations TP/PP. |
| Marge mémoire GPU | Prédit si les pics de contexte long provoqueront un OOM. |
| Temps en file d’attente | Permet de distinguer la capacité de service de la latence applicative. |
| Taux d’erreur et de relance | Convertit l’instabilité de l’infrastructure en coût réel. |
| Taux de sortie acceptée | Évite d’optimiser des jetons peu coûteux que les utilisateurs rejettent. |
Schémas de dépannage
Le modèle se charge, mais le débit est pire avec davantage de GPU.
Le groupe TP est peut-être trop grand pour la topologie, ou la charge de travail n’a peut-être pas assez de concurrence pour amortir la communication. Testez un TP plus petit, davantage de réplicas, ou une forme de batch/concurrence différente.
Le lancement multi-nœuds se bloque.
Vérifiez l’appartenance Ray, les règles de pare-feu, la sélection de l’interface NCCL, le réseau des conteneurs, et si chaque nœud peut atteindre le même chemin de modèle. Ne déboguez pas cela d’abord depuis la couche API.
Un GPU atteint l’OOM alors que les autres ont de la marge.
Recherchez des étapes de pipeline inégales, différents SKU de GPU, la fragmentation de la mémoire ou un problème d’assignation des ranks. Confirmez que chaque worker utilise le GPU visible prévu.
Des pics de latence surviennent avec de longues invites.
La pression sur le cache KV, le coût du préremplissage et la mise en file d’attente du planificateur sont probablement en cause. Testez des groupes distincts de longueurs d’invite avant de modifier le matériel.
L’endpoint fonctionne dans un terminal mais échoue derrière un load balancer.
Vérifiez le timeout de streaming, le timeout d’inactivité, le chemin de health check, les limites de taille du corps de requête, et si le load balancer envoie du trafic à un réplica avant que le modèle soit prêt.
Quand ne pas exécuter vous-même l’inférence multi-GPU vLLM
Exécuter vLLM est le bon choix lorsque vous avez besoin d’un contrôle au niveau du modèle, de poids privés, de noyaux personnalisés, de quantification personnalisée ou d’expériences au niveau matériel. Ce n’est pas automatiquement le bon choix lorsque l’exigence métier est simplement « donner à notre application une API fiable compatible OpenAI ».
Avant de louer un cluster GPU multi-nœuds, comparez l’approche auto-hébergée à une approche de modèle/API gérée :
| Exigence | Auto-héberger vLLM sur GPU | Référence modèle/API gérée |
|---|---|---|
| Poids personnalisés/privés | Très adapté | Généralement insuffisant |
| Expériences matérielles | Très adapté | Ce n’est pas le but |
| Intégration produit rapide | Plus de travail opérationnel | Très adapté |
| Basculement entre plusieurs modèles | Vous gérez chaque pile | Un seul gateway peut simplifier l’accès |
| Facturation et visibilité d’utilisation | À construire ou à intégrer | Souvent inclus |
| Gestion des erreurs | C’est votre responsabilité | Le fournisseur/gateway en gère davantage |
Flatkey est le point de comparaison lorsque vous voulez une seule clé compatible OpenAI, un seul solde et un accès aux endpoints officiels de modèles sans exploiter vous-même la couche de service GPU. Si le contrôle matériel direct n’est pas l’exigence produit, benchmarkez-vous par rapport à une référence modèle/API avant de vous engager dans l’exploitation du cluster.
Questions fréquentes
vLLM prend-il en charge l’inférence multi-GPU ?
Oui. vLLM prend en charge l’inférence multi-GPU via le parallélisme tensoriel et le parallélisme pipeline, avec des choix d’exécuteur qui couvrent le service sur un seul nœud et sur plusieurs nœuds. Le chemin de support exact dépend de votre version de vLLM, de l’architecture du modèle, de la topologie GPU et du backend de déploiement.
Quelle est la meilleure taille de parallélisme tensoriel pour vLLM ?
La meilleure taille de parallélisme tensoriel est la plus petite valeur de TP qui offre suffisamment de marge mémoire et de débit pour votre charge de travail. Commencez avec les GPU d’un seul nœud rapide, puis benchmarkez tp=2, tp=4 ou tp=8 avec des longueurs réelles d’invite et de sortie.
Quand dois-je utiliser le parallélisme pipeline dans vLLM ?
Utilisez le parallélisme pipeline lorsque le modèle ou l’exigence de cache KV vous oblige à dépasser un seul nœud, ou lorsque maintenir la communication tensorielle à l’intérieur de chaque nœud est préférable à la construction d’un groupe TP sur plusieurs nœuds.
Ray est-il requis pour le service multi-GPU vLLM ?
Ray est généralement le choix pratique pour le service multi-nœuds de vLLM. Pour un seul nœud, un backend multiprocessing ou le backend par défaut de votre version de vLLM peut être plus simple.
Comment savoir si une configuration d’inférence multi-GPU vLLM est prête pour la production ?
Elle n’est prête pour la production qu’après des vérifications de topologie, des tests de chargement à froid, des benchmarks réalistes d’invite/concurrence, des health checks, des tests de redémarrage et une documentation du comportement en cas d’échec. Une seule requête curl réussie ne suffit pas.


