Qu'est-ce qu'une LLM gateway ? Fonctionnement, fonctionnalités clés et 7 options comparées (2026)
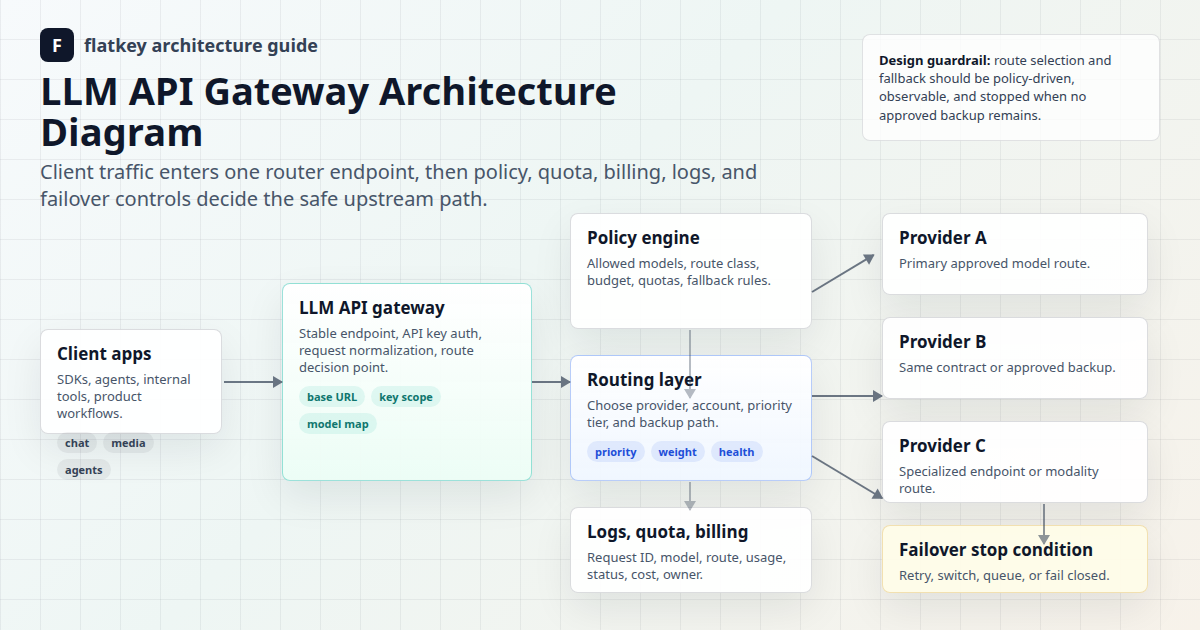
Une LLM gateway est une couche d'API unique placée entre votre application et un ou plusieurs fournisseurs de modèles. Elle gère l'authentification, le routage, le fallback, les limites de débit, le suivi des coûts et la journalisation, afin que votre code appelle un seul endpoint au lieu de s'intégrer séparément à chaque fournisseur. La plupart des gateways exposent une API compatible OpenAI. Passer de GPT à Claude, Gemini ou Qwen revient alors à modifier une chaîne model, et non à livrer une nouvelle intégration de SDK.
Ce guide explique pas à pas le fonctionnement d'une LLM gateway, les neuf fonctionnalités qui comptent, ce qui la distingue d'une API gateway, d'un routeur de modèles et d'une MCP gateway, quand vous en avez besoin (ou non), et compare sept gateways populaires. Les informations produit ont été vérifiées dans la documentation officielle de chaque éditeur le 20 octobre 2026.
Définition d'une LLM gateway
Une LLM gateway (aussi appelée AI gateway ou LLM API gateway) reçoit les requêtes de modèles des applications, applique des contrôles communs, transmet chaque requête au endpoint de modèle approprié et renvoie la réponse dans un format homogène.
Your apps ──► LLM gateway ──┬──► OpenAI
                            ├──► Anthropic
  one key                   ├──► Google
  one API shape             ├──► Alibaba (Qwen)
  one usage ledger          └──► fallback provider
La gateway n'héberge pas les modèles. Elle en contrôle l'accès.
Pourquoi les équipes adoptent une LLM gateway
Sans gateway, chaque service stocke ses propres clés fournisseur, implémente ses propres retries et journalise l'usage dans son propre format. Les problèmes s'accumulent à chaque nouveau fournisseur :
| Sans gateway | Avec gateway |
|---|---|
| Une clé par fournisseur et par service | Une clé de gateway par service, avec rotation centralisée (guide de rotation des clés) |
| SDK et formats d'erreur différents | Un seul format d'API, généralement compatible OpenAI |
| Une panne impose une modification du code | Le fallback est de la configuration |
| Dépenses éparpillées sur plusieurs factures | Un registre unique par équipe, clé et modèle |
| Pas de limites partagées | Quotas et budgets par clé |
Les écarts de prix entre fournisseurs sont en outre assez importants pour que le routage ait de la valeur. Le 20 octobre 2026, les prix catalogue en sortie sur les pages modèles de Flatkey allaient de 0,47 $ par million de tokens (qwen3.8-flash) à 10,00 $ (gpt-6-sol, claude-sonnet-5-5) et 15,00 $ (kimi-k3). Une gateway vous permet d'exploiter cet écart sans réécrire votre code.
Fonctionnement d'une LLM gateway, étape par étape
- L'application envoie une requête à la base URL de la gateway avec une clé de gateway.
- Authentification : la gateway valide la clé et charge sa politique (modèles autorisés, budget, limite de débit).
- Politique pré-requête : elle vérifie les quotas, peut masquer ou bloquer du contenu et ajoute des métadonnées comme l'équipe, l'environnement ou la fonctionnalité.
- Routage : elle choisit le endpoint fournisseur du modèle demandé, ou la prochaine route saine d'une chaîne de fallback.
- Appel au fournisseur : elle traduit la requête au format du fournisseur si nécessaire et renvoie la réponse en streaming.
- Enregistrement : elle journalise modèle, latence, tokens, coût, statut et ID de requête pour l'observabilité et la facturation.
Les 9 fonctionnalités d'une LLM gateway qui comptent
| Fonctionnalité | À vérifier |
|---|---|
| API unifiée | /v1/chat/completions compatible OpenAI, plus Responses ou Messages si vous les utilisez |
| Catalogue de modèles | Quels modèles sont disponibles et à quelle vitesse arrivent les nouveautés |
| Fallback et failover | Chaînes ordonnées et ce qui les déclenche (429, 5xx, timeout) |
| Répartition de charge | Entre clés, régions ou fournisseurs |
| Limites et budgets | Par clé, équipe et modèle, avec plafonds stricts |
| Observabilité | Logs de requêtes, consommation de tokens, latence et erreurs, idéalement exportables via les conventions GenAI d'OpenTelemetry |
| Suivi des coûts | Par clé, équipe et environnement (guide d'attribution des coûts) |
| Cache | Cache de réponses exact ou sémantique, et transmission du prompt caching du fournisseur |
| Sécurité et politiques | Portée des clés, masquage des données personnelles, conditions de rétention, preuves SOC 2 ou DPA |
LLM gateway, API gateway, routeur de modèles et MCP gateway
| Couche | Contrôle | Comprend les tokens et les modèles ? | Exemple |
|---|---|---|---|
| API gateway | API HTTP génériques | Non | Kong, AWS API Gateway |
| LLM gateway | Trafic de modèles entre fournisseurs | Oui | LiteLLM, Portkey, Flatkey |
| Routeur de modèles | Quel modèle répond à chaque prompt | Oui | RouteLLM, un moteur de règles |
| MCP gateway | Appels d'outils des agents via le Model Context Protocol | Au niveau des outils | Proxys et registres MCP |
Quelle différence entre une MCP gateway et une LLM gateway ? Une LLM gateway encadre les appels vers les modèles. Une MCP gateway encadre les appels des agents vers les outils et sources de données via le Model Context Protocol. Les plateformes d'agents ont souvent besoin des deux : une LLM gateway pour les dépenses de modèles et une MCP gateway pour les permissions d'outils. Voir contrôles de gateway pour agents IA et AI API gateway vs gestion d'API.
7 LLM gateways comparées (2026)
| Gateway | Déploiement | Open source | Point fort | Point de vigilance |
|---|---|---|---|---|
| LiteLLM | Proxy auto-hébergé ou SDK | Oui | Plus de 100 fournisseurs, routage, budgets | À vous de l'exploiter, de le dimensionner et de le patcher |
| Portkey | Hébergé ou auto-hébergé | Cœur de la gateway open source | Guardrails, observabilité | Fonctions avancées sur les offres payantes |
| Cloudflare AI Gateway | Hébergé en edge | Non | Cache, analytique, limitation de débit | Vous gérez toujours les clés fournisseur |
| Kong AI Gateway | Auto-hébergé ou Konnect | Cœur open source | S'intègre à une gestion d'API Kong existante | Configuration des plugins lourde |
| Vercel AI Gateway | Hébergé | Non | Intégration étroite avec Vercel et l'AI SDK | Optimal dans l'écosystème Vercel |
| OpenRouter | Hébergé | Non | Catalogue de modèles très large, crédits | Routage partagé de type marketplace |
| Flatkey | Hébergé | Non | Une clé et un solde pour GPT, Claude, Gemini, Qwen, DeepSeek, Kimi, GLM, plus image et vidéo | Vérifiez le catalogue pour les modèles de niche |
Comparatifs détaillés : guide pour choisir une LLM gateway, alternatives à OpenRouter, alternatives à Portkey, alternatives à Vercel AI Gateway et gateway managée vs proxy auto-hébergé.
À quoi ressemble une LLM gateway dans le code
Avec une gateway compatible OpenAI, votre application garde le SDK OpenAI et ne change que deux valeurs : la base URL et la clé. Changer de fournisseur se résume ensuite à changer une chaîne.
curl
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "claude-sonnet-5-5", "messages": [{"role": "user", "content": "What is an LLM gateway?"}]}'
Python : un client, plusieurs fournisseurs, fallback automatique
import os
from openai import OpenAI, APIError

gw = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

def complete(prompt, chain=("gpt-6-sol", "claude-sonnet-5-5", "gemini-3.5-flash")):
    for model in chain:
        try:
            r = gw.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
            return model, r.choices[0].message.content, r.usage.total_tokens
        except APIError as err:
            print(f"{model} -> {err.__class__.__name__}, trying next")
    raise RuntimeError("no route available")

print(complete("Give me one sentence on why gateways log token usage."))
Node.js
import OpenAI from "openai";
const gw = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

const models = ["qwen3.8-max", "gpt-6-luna"];
const results = await Promise.all(models.map((model) =>
  gw.chat.completions.create({ model, messages: [{ role: "user", content: "Define 'fallback' in 8 words." }] })
));
results.forEach((r, i) => console.log(models[i], r.usage.total_tokens, r.choices[0].message.content));
Sans gateway, il faudrait trois SDK, trois clés et trois formats d'erreur. Pour un premier appel, suivez le guide de démarrage Flatkey.
Compatibilité OpenAI : ce qu'elle garantit et ce qu'elle ne garantit pas
« Compatible OpenAI » signifie que le format des requêtes et des réponses correspond à la Chat Completions API d'OpenAI. Cela ne garantit pas que chaque modèle prenne en charge chaque fonctionnalité. Avant de migrer, testez pour chaque modèle :
- Les chunks de streaming et les valeurs de
finish_reason - L'appel d'outils ou de fonctions et les appels d'outils parallèles
- La sortie structurée ou le mode JSON
- Les entrées image et fichier
- Les champs
usage, y compris les tokens en cache - Les codes d'erreur de limite de débit et de dépassement de contexte (taxonomie des erreurs)
Quand avez-vous besoin d'une LLM gateway (et quand non) ?
Vous en avez probablement besoin si : - Vous appelez deux fournisseurs de modèles ou plus, ou prévoyez de le faire. - Plusieurs équipes ou services partagent les dépenses IA et ont besoin de budgets par équipe. - Vous avez besoin d'un failover pendant les pannes de fournisseurs. - La finance veut un seul registre au lieu de cinq factures.
Vous n'en avez peut-être pas encore besoin si : - Vous avez un seul prototype sur un seul modèle, avec peu de trafic. - Votre contrat fournisseur impose un accès direct, sans intermédiaire.
Évaluer une LLM gateway en un après-midi
- Test de contrat : faites passer vos 20 requêtes les plus fréquentes (streaming, outils, JSON).
- Test de panne : forcez un mauvais ID de modèle et un timeout. Le fallback se déclenche-t-il et l'erreur est-elle claire ?
- Test de surcoût : comparez la latence P50 et P95 à un appel direct au fournisseur.
- Test du registre : les tokens journalisés correspondent-ils au
usagedu fournisseur ? Le coût est-il visible par clé ? - Revue de sécurité : vérifiez la portée des clés, la rétention des logs et les conditions de traitement des données (checklist DPA).
- Test de sortie : pouvez-vous la quitter en remettant simplement l'ancienne base URL ?
FAQ
Qu'est-ce qu'une LLM gateway ?
Une LLM gateway est une API intermédiaire placée entre les applications et les fournisseurs de modèles. Elle centralise l'authentification, le routage, le fallback, les limites de débit, la journalisation et le suivi des coûts derrière un endpoint unique, généralement compatible OpenAI.
Quelles sont les LLM gateways les plus populaires ?
Parmi les options les plus utilisées en 2026 : LiteLLM (open source, auto-hébergé), Portkey, Cloudflare AI Gateway, Kong AI Gateway, Vercel AI Gateway, OpenRouter et des routeurs hébergés comme Flatkey.
Une LLM gateway est-elle gratuite ?
Les gateways open source comme LiteLLM sont gratuites à exécuter, mais vous payez l'hébergement et l'exploitation. Les gateways hébergées facturent soit des frais de plateforme, soit l'usage des modèles selon leur propre grille. Dans tous les cas, les tokens des modèles restent payants.
Quelle différence entre une MCP gateway et une LLM gateway ?
Une LLM gateway gère les requêtes vers les modèles de langage. Une MCP gateway gère les requêtes des agents vers les outils et sources de données via le Model Context Protocol. Elles résolvent des problèmes différents et sont souvent déployées ensemble.
Une LLM gateway est-elle la même chose qu'une AI gateway ?
En général, oui. « AI gateway » est le terme marketing plus large, qui couvre souvent aussi les modèles d'image, de vidéo et d'audio. « LLM gateway » met l'accent sur les modèles de texte.
Une LLM gateway ajoute-t-elle de la latence ?
Un peu : un saut réseau supplémentaire plus les contrôles de politique. Mesurez le surcoût P95 dans votre propre région. Lors d'une panne, le failover fait généralement gagner bien plus de temps que ce saut n'en coûte.
Une LLM gateway peut-elle réduire les coûts ?
Oui, indirectement. Elle facilite l'application cohérente du routage vers des modèles moins chers, du cache et des plafonds budgétaires. Elle ne rend pas moins chers les tokens d'un modèle donné, sauf si la gateway propose elle-même des tarifs réduits.
Conclusion
Une LLM gateway transforme de nombreuses intégrations fournisseurs en un seul endpoint contrôlé : une clé, un format d'API, un registre, et le fallback comme configuration. Optez pour l'auto-hébergé (LiteLLM, Kong) si vous voulez un contrôle total et pouvez l'exploiter. Optez pour l'hébergé (Portkey, Cloudflare, Vercel, OpenRouter, Flatkey) si vous préférez ne pas gérer d'infrastructure. Pour tester la voie hébergée, consultez l'annuaire des modèles Flatkey et la page des tarifs.
Dernière mise à jour : 20 octobre 2026 · Flatkey Team. Les informations produit résument la documentation officielle citée dans le texte.