
Guia de Seleção de GPU para IA: Combine Cargas de Trabalho de Treinamento e Inferência com a GPU Certa
Um guia de seleção de GPU para IA deve começar pela carga de trabalho, não pelo nome do acelerador mais recente. Treinamento, ajuste fino, inferência em lote, inferência em tempo real, pipelines de recuperação, geração de mídia e tarefas de avaliação exercem pressão sobre as GPUs de maneiras diferentes. A GPU errada pode parecer atraente em uma tabela de preços e ainda assim perder quando você considera adequação de memória, topologia de rede, tempo ocioso, enfileiramento, trabalho da stack de serving e a qualidade do resultado aceito.
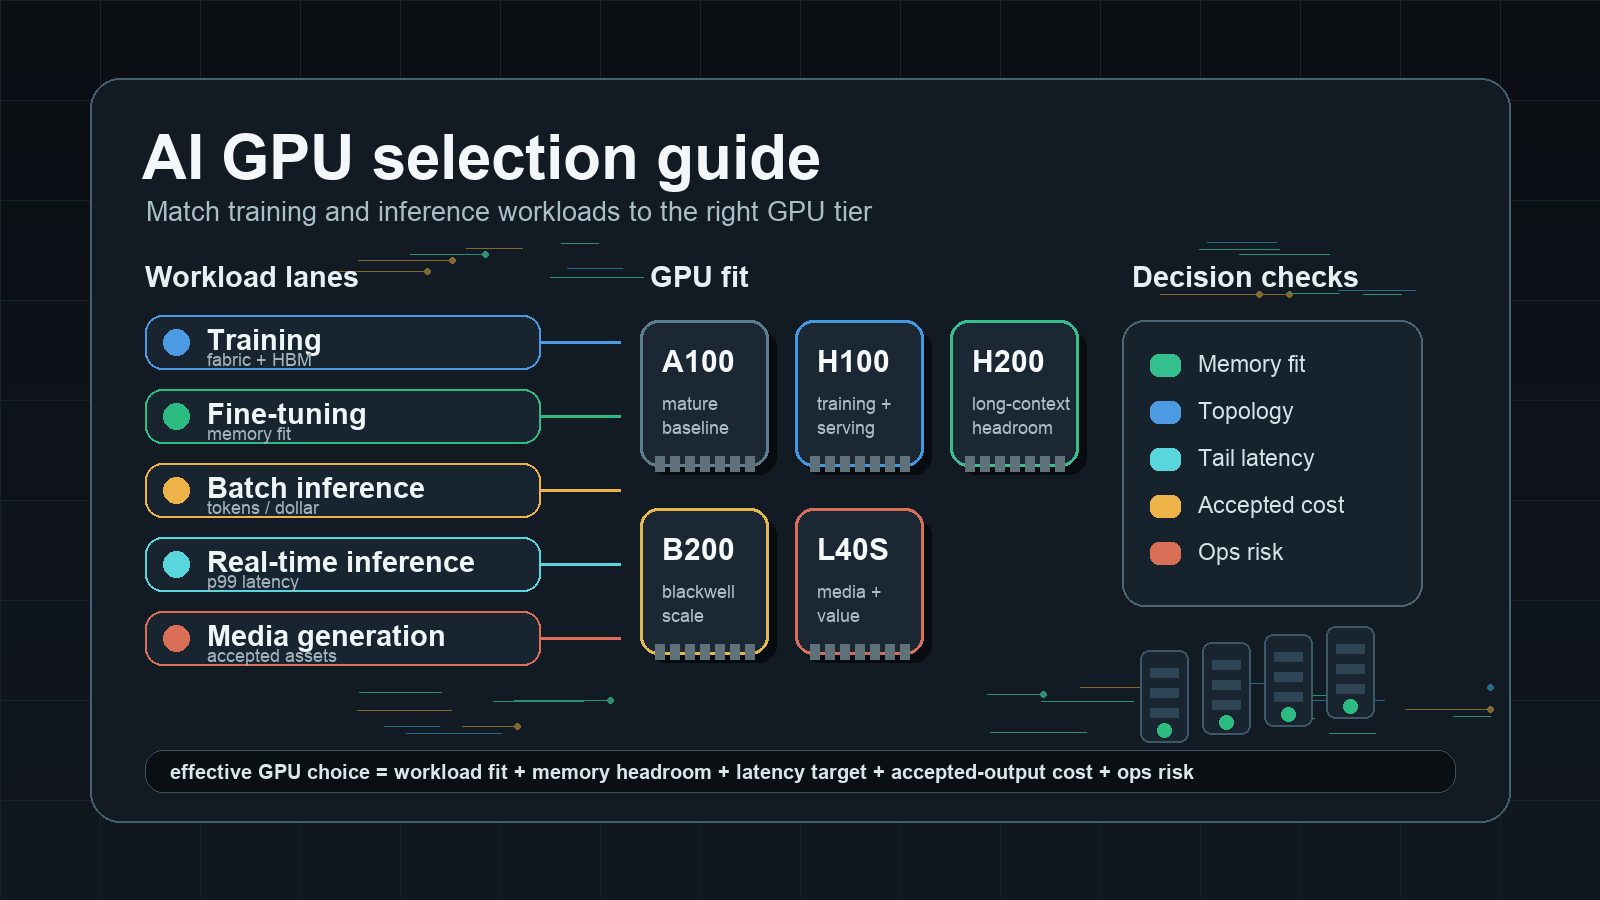
Use este guia de seleção de GPU para IA como uma lista de verificação de compras e arquitetura. Ele mapeia cargas de trabalho comuns de IA para os atributos de GPU que importam, explica quando H100, H200, B200, A100, L40S, sistemas da classe GB200 e GPUs locais da classe RTX fazem sentido, e fornece um plano de benchmark que mantém a decisão de compra vinculada ao trabalho concluído em vez de números sintéticos de pico.
A regra prática da Flatkey: escolha GPUs pelo custo por execução de treinamento concluída, custo por token aceito, custo por imagem ou vídeo aceito e pelo risco operacional que você está disposto a assumir. Se você só precisa de acesso ao modelo, governança, fallback e um único ledger de uso, compare aluguel de GPU com rotas de modelo/API antes de se comprometer com hardware.
Resposta Rápida do Guia de Seleção de GPU para IA
Comece com esta matriz antes de comparar propostas de provedores.
| Carga de trabalho | Normalmente priorize | Direção de GPU | Pontos de atenção |
|---|---|---|---|
| Pré-treinamento ou treinamento em larga escala | Fabric multi-node, capacidade de HBM, largura de banda de memória, throughput BF16/FP8, I/O de checkpoint | H100/H200, sistemas da classe B200/GB200, clusters de treinamento gerenciados | O preço por hora é secundário em relação ao tempo de execução concluída e ao risco de reinício |
| Ajuste fino completo | Folga de memória, adequação do estado do otimizador, paralelismo de tensor, localidade de armazenamento | H100, H200, B200, A100 para modelos menores | Falta de VRAM pode forçar sharding mais lento ou tamanhos de lote menores |
| Ajuste fino LoRA/QLoRA | Adequação de VRAM, compatibilidade CUDA, throughput por dólar | A100, L40S, H100, H200, GPUs locais de ponta para trabalhos pequenos | O dataset e o comprimento do contexto podem mudar a resposta de memória |
| Inferência LLM em lote | Adequação de memória, eficiência de batching, tokens por dólar, tolerância à fila | L40S, A100, H100, H200, B200 dependendo do tamanho do modelo | Baixa utilização pode anular tarifas mais baratas de GPU |
| Inferência LLM em tempo real | Latência p95/p99, capacidade de cache KV, estabilidade de streaming, suporte ao framework de serving | H100/H200/B200 para modelos grandes ou de contexto longo; L40S/A100 para modelos menores | Latência de cauda e retries importam mais do que tokens/segundo de pico |
| Embeddings e reranking | Throughput por dólar, equilíbrio CPU/GPU, tamanho de lote, simplicidade do serviço | L40S, A100, GPUs menores em nuvem, às vezes CPU para baixo volume | Excesso de GPU é comum com tráfego baixo |
| Geração de imagens e vídeo | VRAM, kernels de mídia, throughput de armazenamento, tolerância à fila | L40S, H100/H200/B200 para pipelines mais pesados, workstations locais classe RTX para criadores | O custo de imagem/clipe aceito de ponta a ponta supera a velocidade bruta de renderização |
| Avaliação e dados sintéticos | Capacidade de pico, controles de custo, variedade de modelos | GPUs spot/marketplace, APIs em lote ou rotas de modelo/API | Evite manter capacidade ociosa para picos ocasionais |
A resposta rápida não é intencionalmente "compre a GPU mais rápida". Para equipes corporativas de IA, a melhor GPU é aquela que se encaixa no modelo, no comprimento do contexto, no alvo de latência, na concorrência, na fronteira de dados e no modelo operacional da equipe.
Passo 1: Classifique a Carga de Trabalho
O primeiro passo em qualquer guia de seleção de GPU para IA é a classificação da carga de trabalho. Sem isso, toda comparação posterior se transforma em um debate genérico sobre aceleradores.
Toda discussão sobre GPU deve começar com um resumo da carga de trabalho. Escreva-o antes de pedir cotações aos provedores.
| Campo | O que registrar |
|---|---|
| Tipo de carga de trabalho | Treinamento, ajuste fino, inferência em lote, inferência online, geração de mídia, embeddings, avaliação ou notebooks |
| Formato do modelo | Número de parâmetros, arquitetura, precisão, quantização, janela de contexto, modalidade e comportamento do tokenizador |
| Formato da requisição | Média e p95 de tokens de entrada, tokens de saída, tamanho de imagem, duração de vídeo, tamanho do lote, sessões concorrentes ou registros por tarefa |
| Unidade de sucesso | Execução de treinamento concluída, patch aceito, resposta aceita, token aceito, imagem aceita, clipe aceito ou registro aceito |
| Meta de latência | Offline, minutos, segundos, subsegundo, requisito p95/p99 ou requisito de streaming |
| Ciclo de operação | Sempre ativo, lote agendado, pico sazonal, experimental ou notebook de desenvolvedor |
| Fronteira operacional | Nuvem pública, rede privada, cluster dedicado, on-prem, residência de dados ou API gerenciada |
| Ferramentas | vLLM, SGLang, TensorRT-LLM, Triton, Ray, Slurm, Kubernetes, ComfyUI ou endpoints gerenciados pelo provedor |
Se você não conseguir preencher esta tabela, pause a seleção da GPU. Você ainda está comprando possibilidade, não capacidade.
Passo 2: Escolha a Métrica de Decisão Certa
O segundo passo em um guia de seleção de GPU para IA é escolher o denominador. Um bom denominador vincula a decisão da GPU ao trabalho concluído, e não a uma ficha técnica do fornecedor.
FLOPS de pico, números de Tensor Core e preço horário da GPU são entradas úteis, mas não são a métrica de decisão. Use um denominador ligado ao resultado de negócio.
| Carga de trabalho | Métrica melhor |
|---|---|
| Treinamento | Custo por execução de treinamento concluída que atinge a pontuação de avaliação-alvo |
| Ajuste fino | Custo por checkpoint ajustado e aceito |
| Inferência online | Custo por resposta aceita no alvo de latência p95/p99 |
| Inferência em lote | Custo por registro aceito ou token de saída aceito |
| Agentes de código | Custo por tarefa aceita, patch aceito ou issue resolvida |
| Geração de imagem | Custo por imagem aceita após filtros de qualidade |
| Geração de vídeo | Custo por segundo aceito ou clipe aceito |
| Avaliação | Custo por suíte de avaliação concluída e tempo para responder |
Use esta fórmula base:
effective_unit_cost =
  all_in_workload_cost
  / accepted_outputs_after_retries_failures_and_quality_filters
Para treinamento:
training_run_cost =
  gpu_hours
  + storage
  + network
  + checkpointing
  + failed_run_waste
  + platform_labor
Para inferência:
inference_cost_per_accepted_output =
  gpu_compute
  + storage
  + serving_stack
  + idle_capacity
  + retry_waste
  + observability
  + platform_labor
  / accepted_outputs
É aqui que as escolhas de GPU mudam. Uma GPU que vence um benchmark de throughput pode perder se exigir topologia cara, operar com baixa utilização, não atingir a meta de latência ou forçar trabalho operacional adicional.
Seleção de GPU para Treinamento
Para treinamento, um guia de seleção de GPU para IA deve se comportar como um guia de cluster. A GPU individual importa, mas o posicionamento, a interconexão, o armazenamento e o comportamento de reinício muitas vezes determinam o custo da execução concluída.
Treinamento exige grande memória, alta largura de banda de memória, rede GPU a GPU de alta velocidade, posicionamento estável em múltiplos nós e confiabilidade de checkpoints. Ele é menos tolerante do que a inferência porque um nó com falha pode desperdiçar horas ou dias de computação.
O que mais importa para treinamento
- Capacidade de HBM: parâmetros do modelo, gradientes, estados do otimizador, ativações, comprimento de sequência e tamanho do lote competem por memória.
- Largura de banda da memória: operações matriciais grandes e etapas do otimizador podem ficar limitadas por largura de banda.
- Interconexão: NVLink, NVSwitch, InfiniBand, RoCE, EFA ou uma malha de IA específica do provedor podem decidir se o escalonamento é eficiente.
- Suporte a precisão: BF16, FP8 e caminhos mais novos de baixa precisão só importam se sua framework e o recipe do modelo os usarem com segurança.
- Armazenamento e I/O de checkpoint: o tempo de gravação do checkpoint e o tempo de recuperação fazem parte do custo da execução concluída.
- Confiabilidade de posicionamento: as GPUs certas espalhadas por uma malha fraca não são o mesmo que um cluster de treinamento coerente.
Direção de GPU para treinamento
Use H100 ou H200 quando precisar de suporte de treinamento comprovado da classe Hopper e ampla maturidade de frameworks. O H200 adiciona mais capacidade e largura de banda de HBM do que o H100, o que é útil para treinamento e ajuste fino com alta demanda de memória. Use sistemas da classe B200 ou GB200 quando a carga de trabalho puder se beneficiar de throughput da classe Blackwell, caminhos de menor precisão e quando um provedor puder realmente entregar a topologia, o suporte de framework e os testes de aceitação de que você precisa. Use A100 quando o modelo for menor, o recipe de treinamento for maduro, o orçamento for restrito ou a disponibilidade importar mais do que o desempenho de pico.
Não escolha uma GPU de treinamento com base em um único benchmark. Execute o seu recipe exato ou um proxy próximo. Meça o tempo até a pontuação de avaliação-alvo, o comportamento de reinício, o tempo de checkpoint e o custo total. As decisões H100 vs A100 e H200 vs H100 geralmente são decisões de execução concluída, não de tarifa horária.
Leituras complementares úteis: H100 vs A100, H200 vs H100, B200 vs H200 e B300 vs B200.
Seleção de GPU para Ajuste Fino
O ajuste fino fica entre treinamento e inferência. O ajuste fino completo se comporta como treinamento, enquanto LoRA e QLoRA podem caber em hardware menor se o tamanho do modelo, o comprimento do contexto, o tamanho do lote e a precisão forem controlados.
Ajuste fino completo
Para ajuste fino completo, priorize primeiro memória e topologia. A GPU deve comportar o estado de treinamento ou fragmentá-lo com eficiência. H100, H200, B200 e clusters multi-GPU A100 são direções comuns, dependendo do tamanho do modelo e do orçamento. GPUs da classe H200 e B200 podem reduzir a pressão de sharding para jobs com muita necessidade de memória, mas apenas se a stack do provedor e a versão do framework estiverem prontas.
Perguntas a fazer:
- Qual é o maior modelo e comprimento de contexto que você precisa ajustar fino?
- Os estados do otimizador estão totalmente carregados, fragmentados, descarregados ou quantizados?
- O job precisa de paralelismo tensorial, paralelismo de pipeline, FSDP, DeepSpeed ou outra abordagem distribuída?
- O conjunto de dados está local à região da GPU?
- Quão caro é um checkpoint com falha?
Ajuste fino com adaptadores
Para LoRA, QLoRA, instruction tuning e adaptação de domínio menor, a resposta pode ser mais flexível. A100, L40S, H100, H200 e GPUs locais da classe RTX podem se encaixar em diferentes partes do fluxo de trabalho. O risco é assumir que uma pequena demonstração significa que o job de produção caberá. Contextos mais longos, tamanhos de lote maiores, mais exemplos e execuções de validação podem levar o job para uma classe diferente.
Este é um bom lugar para executar um benchmark em duas etapas: primeiro provar o encaixe de memória, depois provar o tempo até o checkpoint e o custo por modelo ajustado fino aceito.
Seleção de GPU para Inferência de LLM
Para inferência, um guia de seleção de GPU para IA deve separar o encaixe de memória do encaixe de latência. Uma GPU pode carregar o modelo e ainda assim não atingir a meta de p99 em produção.
Inferência não é uma única carga de trabalho. A GPU certa muda dependendo do tamanho do modelo, do comprimento do contexto, da concorrência, da meta de latência e de os pedidos serem em lote ou em tempo real.
O encaixe de memória vem primeiro
Para inferência de LLM, a memória da GPU deve acomodar os pesos do modelo e o cache KV com espaço suficiente para a estrutura de serving. Contexto longo e alta concorrência podem fazer do cache KV a principal pressão sobre a memória. Uma GPU que comporta um modelo para um único usuário pode falhar na concorrência de produção.
Use esta lista de verificação:
- Tamanho dos pesos na sua precisão: FP16, BF16, FP8, INT8, INT4 ou outro formato quantizado.
- Janela de contexto e comprimento de entrada esperado no p95.
- Comprimento de saída e comportamento de streaming.
- Sessões concorrentes e tamanho do lote.
- Estratégia de cache KV, cache de prefixo e comportamento de evacuação.
- Overhead da estrutura de serving.
- Margem de segurança para picos e fragmentação.
Se a memória estiver apertada, uma GPU com mais memória pode superar uma GPU teoricamente mais rápida, porém com menos memória, porque evita sharding, offload ou quantização de menor qualidade.
Inferência em tempo real
A inferência em tempo real se importa com a latência p95 e p99, não apenas com a vazão média. GPUs da classe H100, H200 e B200 geralmente são a opção mais forte para modelos grandes, contexto longo e cargas de trabalho sensíveis à latência. L40S e A100 podem ser mais econômicas para modelos menores, menor concorrência ou cargas de trabalho em que as metas de p99 são menos rigorosas.
Meça:
- Tempo até o primeiro token.
- Latência entre tokens.
- Latência ponta a ponta p95/p99.
- Tokens por segundo por GPU.
- Tokens aceitos por dólar.
- Taxa de erro sob tráfego em rajada.
- Amplificação de retries sob limites de taxa, OOMs ou implantações.
Para a escolha da pilha de serving, use vLLM vs SGLang e o guia de implantação do vLLM.
Inferência em lote
A inferência em lote pode trocar latência por vazão. Isso abre mais opções de GPU. L40S, A100, H100, H200 e B200 podem fazer sentido se o modelo couber e a utilização for alta. A métrica decisiva normalmente é a saída aceita por dólar ao longo da janela do lote.
Cargas de trabalho em lote também são uma boa opção para spot, janelas reservadas ou capacidade de GPU serverless quando o comportamento de retry é controlado. Se o mesmo lote puder ser enviado para uma API de modelo com menos carga operacional, compare ambos os caminhos com a planilha de GPU cloud vs model API.
Seleção de GPU para Geração de Mídia
Geração de imagens e vídeo muitas vezes se comporta de forma diferente da inferência de texto. VRAM, complexidade do pipeline do modelo, E/S de armazenamento e tolerância à fila importam mais do que a latência conversacional.
A L40S costuma ser atraente para cargas de trabalho de imagem e mídia menores porque tem fortes características de inferência e voltadas a gráficos, em um patamar de aquisição mais baixo do que GPUs da classe H100. H100, H200 e B200 tornam-se mais relevantes quando as cargas são mais pesadas, maiores, multimodais ou fortemente limitadas por latência. Workstations locais da classe RTX podem ser úteis para criadores, prototipagem e pipelines de baixo volume, mas as equipes de produção ainda precisam de enfileiramento, armazenamento, retries e observabilidade.
Use custo por imagem aceita ou clipe aceito, não o tempo bruto de renderização:
media_accepted_cost =
  gpu_cost
  + storage
  + failed_renders
  + moderation_or_quality_filtering
  + queue_overhead
  + operator_review
  / accepted_assets
Se sua equipe só precisa de acesso a vários modelos de imagem ou vídeo, uma rota por modelo/API pode ser mais simples do que executar pipelines de mídia em GPU. Use a mesma disciplina de aquisição que usaria para texto: custo por resultado aceito, não apenas o preço de tabela.
Resumo Rápido de Modelos de GPU
Use esta tabela como ponto de partida e, em seguida, verifique as especificações e a disponibilidade atuais nas páginas oficiais dos fornecedores. Não a trate como uma tabela de preços.
| Família de GPU | Papel prático | Sinais de melhor ajuste | Observações comuns |
|---|---|---|---|
| NVIDIA A100 | Base consolidada para treinamento e inferência | Receitas existentes, variantes de 40GB/80GB, ampla disponibilidade na nuvem, cargas de trabalho sensíveis ao orçamento | Geração mais antiga; menor largura de banda de memória e caminhos de precisão mais novos do que H100/H200/B200 |
| NVIDIA H100 | Ferramenta de trabalho de treinamento e inferência da classe Hopper | Grande maturidade de frameworks, suporte ao Transformer Engine em FP8, alta largura de banda de memória, opções NVLink/NVSwitch | Oferta e preço ainda podem ser limitados; a memória pode ficar apertada para inferência com contexto muito longo/alta concorrência |
| NVIDIA H200 | Opção Hopper com mais memória | Maior capacidade e largura de banda de HBM do que a H100; útil para inferência com contexto longo e jobs intensivos em memória | Disponibilidade e preço variam; compare com a H100 para sua carga de trabalho exata |
| NVIDIA B200 | Acelerador da classe Blackwell | Treinamento e inferência pesados, caminhos de menor precisão mais novos, grande memória e largura de banda | Requer prontidão da stack, disponibilidade do provedor e validação de topologia |
| NVIDIA GB200 / sistemas em escala de rack | Treinamento em grande escala e inferência de alta densidade | Jobs em escala de cluster nos quais a arquitetura do sistema importa tanto quanto o silício da GPU | Compras e operações são decisões de sistema, não decisões de GPU individual |
| NVIDIA L40S | Inferência e mídia sensíveis a custo | Memória da classe 48GB, pipelines de imagem/vídeo, inferência de LLMs menores, jobs em lote | Não é substituto universal para H100/H200 em treinamento grande ou inferência de LLM com p99 rigoroso |
| GPUs locais da classe RTX | Experimentação local e fluxos de trabalho de criadores | Prototipação, modelos pequenos, iteração em workstation privada | Memória limitada, história operacional de datacenter mais fraca, não é um cluster de produção por si só |
A tabela esconde uma verdade importante de compras: o modelo de GPU é apenas uma parte da resposta. Formato do nó, armazenamento, agendador, interconexão, modelo de quota e qualidade do suporte podem determinar se a GPU será útil.
A Lista de Verificação de Compras
Antes de comprar ou alugar, peça aos provedores estes detalhes.
Hardware e topologia
- Modelo exato da GPU, capacidade de memória, formato do nó e GPUs por nó.
- Interconexão dentro do nó e entre nós.
- CPU, RAM, NVMe local, largura de banda de armazenamento e largura de banda de rede.
- Região, zona, grupo de posicionamento, rack ou suposições de cluster dedicado.
- Processo de substituição para GPUs, nós, armazenamento e dispositivos de rede com falha.
Stack de software
- Versões suportadas de driver, CUDA, cuDNN, NCCL, runtime de contêiner e frameworks.
- Modelo de acesso via Kubernetes, Slurm, endpoint gerenciado ou bare metal.
- Suporte a vLLM, SGLang, TensorRT-LLM, Triton, Ray ou pipelines de mídia.
- Campos de observabilidade para utilização da GPU, memória, tempo de espera na fila, latência, erros e gasto.
- Processo de atualização e rollback.
Modelo comercial
- On-demand, spot, reservado, marketplace, cluster dedicado, nuvem privada ou endpoint gerenciado.
- Compromisso mínimo, direitos de cancelamento, tarifas por excedente e níveis de suporte.
- Custos de armazenamento, egress, snapshots, IP público, balanceador de carga e rede privada.
- Formato de exportação de uso e granularidade da fatura.
- Se a capacidade ociosa é cobrada e como funciona a automação de desligamento.
Segurança e governança
- Limite de rede, modelo VPC/VNet, suporte a endpoint privado e política de egress.
- IAM, tratamento de segredos, logs de auditoria, acesso do suporte e notificação de incidentes.
- Armazenamento de dados, retenção de checkpoints, backup, exclusão e retenção legal.
- Evidências de conformidade e suporte à revisão do fornecedor.
- Orçamentos por equipe, quotas, tags e suporte a chargeback/showback.
Esta lista de verificação se aplica à nuvem pública de GPU, à nuvem privada de GPU e ao aluguel de cluster de GPU. Quanto maior o compromisso, mais evidências você deve exigir.
Plano de Benchmark: Como Testar Antes de se Comprometer
Esta é a parte do guia de seleção de GPU para IA que deve se tornar sua evidência de compras. Salve as entradas, saídas e critérios de aceitação para que as equipes de finanças e de plataforma possam revisar a decisão mais tarde.
Execute um benchmark que se pareça com sua carga de trabalho. Não dependa apenas de tabelas públicas de benchmark.
Fase 1: teste de adequação de memória
- Carregue o modelo exato ou o proxy mais próximo.
- Use a precisão e a quantização pretendidas.
- Defina o comprimento de contexto e o tamanho do lote-alvo.
- Execute prompts ou registros representativos.
- Registre pico de memória, fragmentação, taxa de OOM e margem segura.
Fase 2: teste de throughput e latência
- Teste tráfego contínuo e tráfego em rajada.
- Meça latência p50, p95 e p99.
- Meça o tempo até o primeiro token para cargas de trabalho de LLM em streaming.
- Meça tokens/seg, imagens/hora, clipes/hora ou registros/hora.
- Registre saídas aceitas, não apenas saídas geradas.
Fase 3: teste de falhas e operações
- Mate um worker, drene um nó, reinicie a stack de serving e simule um deploy ruim.
- Verifique a recuperação de checkpoints para treinamento e fine-tuning.
- Confira o tempo de cold start e o tempo de carregamento do modelo.
- Confirme que logs e métricas estão disponíveis para as equipes de plataforma, segurança e finanças.
- Valide que a atribuição de custos sobrevive a novas tentativas e falhas.
Fase 4: normalização financeira
Crie uma linha para cada candidato:
| Candidato | Custo da GPU | Armazenamento/rede | Mão de obra da plataforma | Desperdício por falhas | Saídas aceitas | Custo unitário efetivo | Observações |
|---|---|---|---|---|---|---|---|
| Provedor A H100 | Entrada da cotação | Adicionar extras verificados na fonte | Estimativa | Medido | Medido | Calculado | Incluir latência p95 |
| Provedor B H200 | Entrada da cotação | Adicionar extras verificados na fonte | Estimativa | Medido | Medido | Calculado | Incluir margem de memória |
| Rota de modelo/API | Custo da API verificado na fonte | Custo de gateway/operações | Estimativa de operações menor | Retries medidos | Medido | Calculado | Incluir aceitação de qualidade |
Isso transforma o guia de seleção de GPU para IA em um registro de decisão que finanças, plataforma e produto podem inspecionar.
Alugar, Reservar, Comprar ou Usar uma API de Modelo?
O passo final neste guia de seleção de GPU para IA é decidir se a capacidade deve ser alugada, reservada, comprada ou evitada por meio de uma API de modelo.
A seleção do modelo de GPU e a seleção do modelo de capacidade são decisões separadas.
| Situação | Melhor ponto de partida |
|---|---|
| Demanda incerta, modelos em mudança ou protótipos | API de modelo ou aluguel de curto prazo |
| Experimentos em picos e trabalhos de avaliação | GPU spot/marketplace ou API de modelo em lote |
| Inferência estável de alto volume em um único modelo | GPU reservada, endpoint dedicado ou cluster comprometido |
| Treinamento multi-node com requisitos de topologia | Cluster de treinamento dedicado ou fabric de alta velocidade reservado |
| Rede privada rigorosa ou isolamento de hardware | Nuvem de GPU privada ou cluster dedicado |
| Precisa de muitos modelos oficiais, uma fatura e fallback | Rotas de modelo/API governadas pelo Flatkey |
Se o argumento para GPUs for principalmente "precisamos de acesso a modelos de IA", comece com roteamento de modelo/API. Se o argumento for "precisamos controlar topologia, runtime, pesos, fronteira de dados ou kernels personalizados", mantenha a rota de GPU aberta. A diferença importa porque a infraestrutura de GPU traz responsabilidade por scheduler, runtime, segurança, FinOps e incidentes.
O Flatkey ajuda no lado da API dessa decisão: uma chave, um saldo, uma fatura, controles de registro de uso e rotas oficiais de modelo/ferramenta. Não é um substituto para controle de hardware quando o controle de hardware é o requisito. É a alternativa mais simples quando o requisito real é acesso governado a modelos e visibilidade de custos.
Erros Comuns na Seleção de GPU
Erro 1: escolher pela tarifa horária
A tarifa horária ignora utilização, retries, tempo ocioso, armazenamento, rede, suporte e tempo de engenharia. Use o custo da carga de trabalho concluída. O guia de preços de aluguel de GPU cobre as linhas de custo ocultas.
Erro 2: tratar adequação de memória como uma pergunta de sim/não
A adequação de memória em um comprimento de prompt ou tamanho de lote não prova adequação em produção. Contexto longo, alta concorrência, trocas de modelo e overhead do framework de serving podem mudar a resposta.
Erro 3: ignorar a interconexão
Para trabalhos multi-GPU e multi-node, a topologia faz parte da GPU. Um pool de GPUs mais barato com posicionamento fraco pode perder para um cluster mais caro, mas coerente.
Erro 4: fazer benchmark de saídas geradas em vez de saídas aceitas
Cargas de trabalho de IA têm filtros de qualidade, filtros de segurança, retries, gerações com falha, patches com falha e avaliações com falha. Meça o custo das saídas aceitas.
Erro 5: esquecer a responsabilidade da plataforma
Alguém precisa operar drivers, CUDA, containers, servidores de modelos, autoscaling, quota, logging, alertas, incidentes e relatórios de gastos. Se essa equipe não existir, contabilize isso.
Erro 6: comprar apenas para o modelo de hoje
A escolha do modelo muda. As janelas de contexto crescem. A quantização melhora. A disponibilidade do provedor muda. Mantenha o registro de decisão flexível e evite compromissos que assumam que um único modelo continuará dominante.
Fontes Oficiais para Consultar
Use páginas oficiais para detalhes voláteis ou específicos de fornecedores:
- Visão geral do NVIDIA H100 para contexto de GPU da classe Hopper: NVIDIA H100 Tensor Core GPU.
- Visão geral do NVIDIA H200 para contexto de memória HBM3e maior e maior largura de banda: NVIDIA H200 Tensor Core GPU.
- Materiais do NVIDIA Blackwell/DGX B200 e GB200 para contexto de sistema Blackwell: NVIDIA DGX B200 e NVIDIA GB200 NVL72.
- Visão geral do NVIDIA A100 para contexto de base madura da Ampere: NVIDIA A100 Tensor Core GPU.
- Página do NVIDIA L40S para contexto de cargas de trabalho de inferência e gráficos/mídia: NVIDIA L40S.
- Documentação do NVIDIA MIG ao particionar GPUs compatíveis: NVIDIA Multi-Instance GPU User Guide.
- Documentação de frameworks de serving para adequação em runtime: servidor compatível com OpenAI do vLLM, documentação do SGLang e NVIDIA TensorRT-LLM.
- Cotações de provedores e páginas de preços para disponibilidade e custo atuais. Registre com timestamp cada preço que você copiar para uma planilha de compras.
Perguntas Frequentes
Qual é a melhor GPU para treinamento de IA?
A melhor GPU para treinamento de IA depende do tamanho do modelo, da receita de treinamento, da necessidade de memória, da interconexão, do comportamento de checkpoint e do tempo até atingir a pontuação-alvo de avaliação. Sistemas da classe H100, H200, B200 e GB200 são fortes candidatos para grandes trabalhos de treinamento, enquanto a A100 ainda pode ser viável para cargas de trabalho menores ou mais sensíveis a orçamento. Compare o custo do run concluído antes de escolher.
Qual é a melhor GPU para inferência de LLM?
A melhor GPU para inferência de LLM é aquela que comporta os pesos do modelo e o cache KV enquanto atende aos alvos de latência p95/p99 e ao custo por token aceito. H100, H200 e B200 são fortes para cargas de trabalho grandes ou de contexto longo. L40S e A100 podem ser eficientes para modelos menores, inferência em lote e metas de latência menos rigorosas. Use o guia mais aprofundado sobre melhor GPU para inferência de LLM para a matemática específica de inferência.
A H200 é sempre melhor que a H100?
Não. A H200 oferece mais margem de memória e largura de banda do que a H100, o que pode ajudar em inferência e treinamento intensivos em memória. Mas a melhor escolha depende de preço, disponibilidade, maturidade da framework, tamanho do lote, latência e se a carga de trabalho realmente é limitada por memória. Se a H100 atender ao alvo com menor custo efetivo, ela ainda pode vencer.
Quando devo escolher a L40S em vez da H100?
Escolha a L40S quando o modelo couber, as metas de latência forem moderadas, a taxa de transferência por dólar para mídia/inferência importar e a capacidade da classe H100 ficaria subutilizada. Escolha a H100 quando modelos maiores, latência p99 mais rigorosa, treinamento ou inferência com alta concorrência exigirem desempenho mais forte de acelerador para datacenter.
Devo alugar GPUs ou usar uma API de modelo?
Alugue GPUs quando precisar de controle de hardware, runtimes personalizados, topologia privada ou utilização sustentada em um modelo estável. Use uma API de modelo quando a demanda for incerta, os modelos mudarem com frequência, o acesso a modelos de fronteira importar, ou sua equipe precisar mais de governança, fallback, registros e uma única fatura do que de controle de hardware. Compare com GPU cloud vs model API.
Como evito comprar GPUs em excesso?
Evite comprar em excesso benchmarkando a carga de trabalho exata, medindo as saídas aceitas, incluindo tempo ocioso e operações, e testando primeiro alternativas menores ou gerenciadas. Reserve ou compre somente depois que tráfego, escolha do modelo e utilização estiverem comprovados.
Conclusão
Este guia de seleção de GPU para IA não é um ranking de aceleradores. É uma forma de tornar as decisões sobre GPUs defensáveis. Comece pela carga de trabalho, escolha uma métrica alinhada ao negócio, comprove a compatibilidade de memória, teste throughput e latência de cauda, inclua operações e desperdício por falhas e compare com rotas de modelo/API antes de assinar um compromisso.
Para muitas equipes, a resposta certa é híbrida: GPUs para cargas de trabalho que realmente precisam de controle de hardware e acesso a modelo/API governado pela Flatkey para overflow, modelos de fronteira, fallback, registros de uso e equipes que não deveriam operar uma stack de serving. A escolha vencedora de GPU é aquela que entrega trabalho aceito ao custo certo sem obrigar sua equipe a assumir infraestrutura da qual ela não precisa.


