Цены на API Qwen (2026): все модели, регионы и скидки
Цены на API Qwen в Alibaba Cloud Model Studio (Сингапур, международная версия) начинаются от $0.03 за 1 млн входных токенов для qwen3.7-flash на коротких промптах. Флагман qwen3.8-max стоит $2.00 за вход и $6.00 за выход на 1 млн токенов, а прайсовая цена qwen3.7-plus — $0.40 / $1.60 (сейчас со скидкой 20%). Тарифы зависят от региона, размера запроса и режима: тот же qwen3.8-max в развертывании Global стоит $1.65 / $4.951. Пакетные (batch) вызовы на поддерживаемых моделях стоят 50% от цены в реальном времени. Данные взяты с официальной страницы цен Model Studio (обновлена 19 октября 2026 г.) и проверены 20 октября 2026 г.
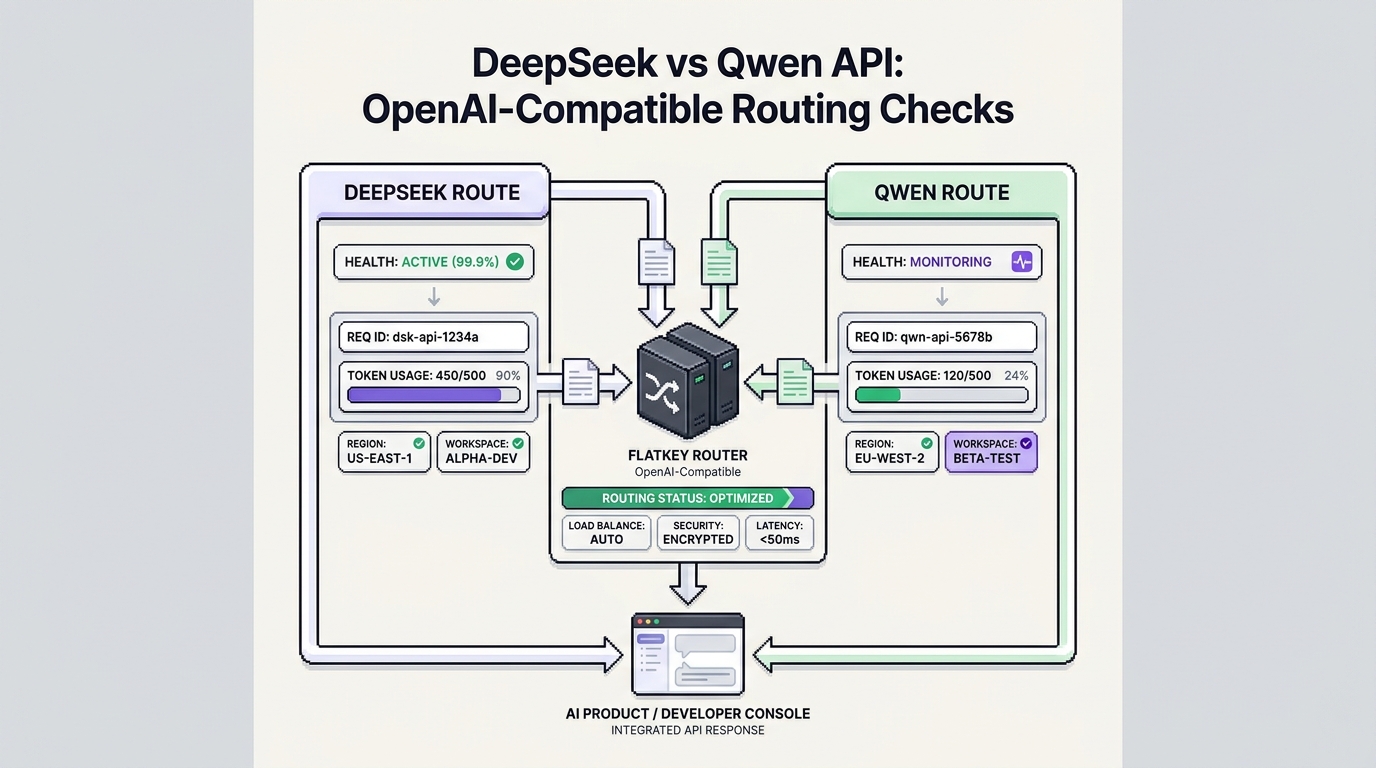
В этом руководстве — актуальные цены на Max, Plus, Flash, Coder, модели с открытыми весами (QwenLM на GitHub) и VL, принципы ступенчатой тарификации и кэширования, подробный пример расчета, сравнение с другими провайдерами и OpenAI-совместимый код для вызова Qwen напрямую или через один ключ Flatkey.
Цены на API Qwen кратко (за 1 млн токенов)
Регион Сингапур, развертывание International, стандартные тарифы реального времени, 20 октября 2026 г. (источник):
| Модель | Размер промпта в запросе | Вход | Выход | Примечания |
|---|---|---|---|---|
qwen3.8-max |
до 1M | $2.00 | $6.00 | Флагман; с рассуждением и без |
qwen3.7-max |
до 1M | $2.50 | $7.50 | Предыдущий флагман |
qwen-max |
единый тариф | $1.60 | $6.40 | Устаревшая; скидка 50% на batch |
qwen3.7-plus |
до 256K | $0.40 | $1.60 | Прайсовая цена; временная скидка 20% |
qwen3.7-plus |
256K–1M | $1.20 | $4.80 | Прайсовая цена; временная скидка 20% |
qwen3.6-plus |
до 256K | $0.50 | $3.00 | |
qwen3.5-plus |
до 256K | $0.40 | $2.40 | |
qwen3.8-flash |
до 1M | $0.15 | $0.47 | Новейшая Flash |
qwen3.7-flash |
до 32K | $0.03 | $0.13 | Самый дешевый вариант для коротких промптов |
qwen3.7-flash |
32K–256K | $0.10 | $0.40 | |
qwen3.7-flash |
256K–1M | $0.20 | $0.80 | |
qwen3.5-flash |
до 1M | $0.10 | $0.40 | |
qwen3-coder-flash |
до 32K | $0.30 | $1.50 | Свыше 256K — $1.60 / $9.60 |
qwen3.8-27b (открытые веса) |
до 1M | $0.50 | $3.00 | |
qwen3-vl-plus |
до 32K | $0.20 | $1.60 | Мультимодальная (зрение и текст) |
Новые аккаунты в Сингапуре получают 1 млн бесплатных токенов на каждую модель сроком на 90 дней с момента активации или выхода модели (по более поздней дате). Alibaba Cloud указывает, что бесплатная квота доступна только в Сингапуре.
Развертывание Global, International и US: почему у одной модели две цены
Model Studio продает одну и ту же модель в разных областях развертывания, и цена зависит от того, где выполняется инференс:
| Модель | Сингапур (International) | Область Global (регионы США, ЕС, Япония, Гонконг) | Область US (Вирджиния) |
|---|---|---|---|
qwen3.8-max |
$2.00 / $6.00 | $1.65 / $4.951 | $2.00 / $6.00 |
qwen3.7-plus (≤256K, прайс) |
$0.40 / $1.60 | $0.276 / $1.101 | $0.40 / $1.60 |
qwen3.8-flash |
$0.15 / $0.47 | $0.113 / $0.382 | $0.15 / $0.47 |
qwen3.7-flash (≤32K) |
$0.030 / $0.130 | $0.028 / $0.110 | $0.030 / $0.130 |
Источник: цены Model Studio, 20 октября 2026 г. Цены вход / выход за 1 млн токенов.
Цены в области Global примерно на 7–31% ниже, чем в International или US, в зависимости от модели (7% для qwen3.7-flash, 17,5% для qwen3.8-max, 31% для входа qwen3.7-plus). Компромисс — резидентность данных: в области Global инференс может выполняться за пределами выбранного региона. Если нужна обработка только в США, используйте область US с более высоким тарифом. Кроме того, qwen3.7-plus в области Global в регионах Гонконг, Франкфурт, Вирджиния и Токио временно получает ночную скидку 60% (22:00–08:00 UTC+8) и 20% днем.
Ступенчатая тарификация: один длинный промпт меняет цену всего запроса
Правило Model Studio: «Все токены запроса тарифицируются по цене соответствующей ступени». Запрос к qwen3.7-flash с 33K входных токенов целиком оплачивается по ступени 32K–256K ($0.10), а не по $0.03 за первые 32K. Поскольку вторая ступень в 3,3 раза дороже первой, сокращение промпта с 33K до 31K токенов снижает стоимость входа примерно на 70%.
Скидки на кэш и batch
| Скидка | Правило (Model Studio, окт. 2026) |
|---|---|
| Попадание в контекстный кэш | 10% от стандартной цены входа (документация по контекстному кэшу) |
| Явное создание кэша | 125% от стандартной цены входа |
| Пакетный инференс | 50% от цен реального времени на вход и выход для поддерживаемых моделей (документация Batch API) |
| Суммирование | Скидки на кэш и batch нельзя совмещать в одном запросе |
Явный кэш окупается после первого же попадания: вы один раз платите 125% за создание, а затем 10% за каждое чтение вместо 100%. Для повторяющегося системного промпта на 20K токенов в qwen3.8-max первый вызов стоит $0.05 за вход, а каждое следующее попадание в кэш — $0.004 вместо $0.04.
Пример расчета затрат
RAG-ассистент на qwen3.8-max (Сингапур): 200 000 запросов в месяц, в каждом 12K входных токенов (из них 8K — кэшированный префикс) и 600 выходных.
| Статья | Расчет | Стоимость |
|---|---|---|
| Некэшированный вход | 800M токенов × $2.00 | $1,600 |
| Кэшированный вход (10%) | 1 600M токенов × $0.20 | $320 |
| Выход | 120M токенов × $6.00 | $720 |
| Итого | $2,640 |
Тот же трафик на qwen3.8-max в области Global обойдется примерно в $2,178. На qwen3.8-flash (Сингапур) — около $200 ($120 + $24 + $56.40), то есть примерно в 13 раз дешевле, если качество Flash вас устраивает.
QWEN = {  # Singapore International list prices per 1M tokens, Oct 20, 2026
    "qwen3.8-max":   (2.00, 6.00),
    "qwen3.7-plus":  (0.40, 1.60),   # <=256K tier
    "qwen3.8-flash": (0.15, 0.47),
}

def qwen_cost(model, uncached, cached, output, batch=False):
    inp, out = QWEN[model]
    if batch:  # batch and cache discounts don't stack
        return (uncached + cached) / 1e6 * inp * 0.5 + output / 1e6 * out * 0.5
    return uncached / 1e6 * inp + cached / 1e6 * inp * 0.10 + output / 1e6 * out

print(qwen_cost("qwen3.8-max", 800e6, 1600e6, 120e6))   # 2640.0
Qwen в сравнении с другими API моделей
Прайсовые цены за 1 млн токенов, 20 октября 2026 г. Тарифы Qwen — из Model Studio (Сингапур), остальные — со страниц моделей Flatkey по ссылкам.
| Модель | Вход | Выход |
|---|---|---|
qwen3.8-max |
$2.00 | $6.00 |
gpt-6-sol |
$2.00 | $10.00 |
claude-sonnet-5-5 |
$2.00 | $10.00 |
kimi-k3 |
$3.00 | $15.00 |
glm-5.3 |
$1.40 | $4.40 |
qwen3.8-flash |
$0.15 | $0.47 |
gpt-6-luna |
$0.10 | $0.50 |
claude-haiku-5-5 |
$0.10 | $0.50 |
qwen3.8-max стоит столько же, сколько GPT-6 Sol и Claude Sonnet 5.5, на входе, но на 40% дешевле на выходе. Для более широкой картины см. руководство по затратам DeepSeek и Qwen и сравнение цен на AI API.
Qwen через Flatkey: цены и доступ по одному ключу
В каталоге Flatkey есть несколько моделей Qwen за тем же OpenAI-совместимым эндпоинтом, что и GPT, Claude, Gemini, DeepSeek и Kimi. Цены на страницах моделей Flatkey на 20 октября 2026 г.:
| Модель | Вход Flatkey | Кэш Flatkey | Выход Flatkey | Указанная прайсовая цена |
|---|---|---|---|---|
qwen3.8-max |
$1.60 | $0.20 | $4.80 | $2 / $0.25 / $6 (−20%) |
qwen3.7-plus |
$0.32 | $0.064 | $1.28 | $0.40 / $0.08 / $1.60 (−20%) |
qwen3.8-flash |
$0.12 | $0.0128 | $0.376 | $0.15 / $0.016 / $0.47 (−20%) |
qwen3.5-flash |
$0.08 | н/д | $0.32 | $0.10 / $0.40 (−20%) |
На странице qwen3.8-max также указаны средняя доступность провайдеров 98,9% и средняя задержка 1,78 с за последние 30 дней. Цены и акции Flatkey меняются, поэтому перед планированием бюджета проверьте страницу цен.
Как вызвать API Qwen (OpenAI-совместимо)
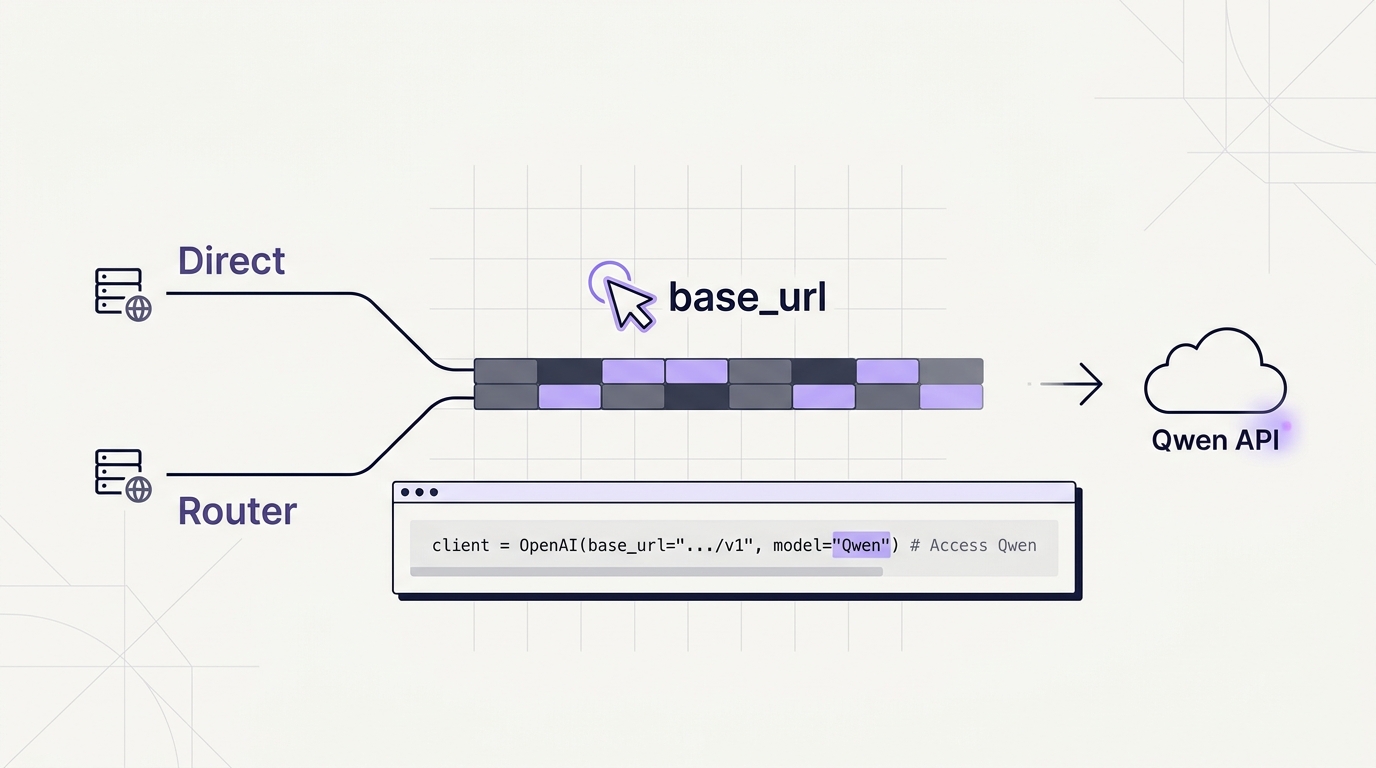
Вариант A: напрямую через Model Studio
Создайте API-ключ в консоли Model Studio в том же регионе, что и эндпоинт, который будете вызывать. Ключ из другого региона отклоняется, и ошибка выглядит как обычный сбой аутентификации. Базовый URL зависит от региона и рабочего пространства (документация по базовым URL). Например, эндпоинт для США (Вирджиния): https://dashscope-us.aliyuncs.com/compatible-mode/v1.
curl https://dashscope-us.aliyuncs.com/compatible-mode/v1/chat/completions \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-flash", "messages": [{"role": "user", "content": "Hello"}]}'
Вариант B: Flatkey (один ключ для Qwen и всех остальных моделей)
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-max", "messages": [{"role": "user", "content": "Write a haiku about caching."}]}'
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

# Same client, same key: switch Qwen tiers or providers by changing one string.
for model in ["qwen3.8-flash", "qwen3.8-max", "claude-sonnet-5-5"]:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Classify: 'refund not received' -> billing|tech|other"}],
    )
    print(model, r.usage.prompt_tokens, r.usage.completion_tokens, r.choices[0].message.content)
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

async function withFallback(prompt) {
  for (const model of ["qwen3.8-max", "gpt-6-sol"]) {
    try {
      const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: prompt }] });
      return `${model}: ${r.choices[0].message.content}`;
    } catch (err) {
      console.warn(model, "failed:", err.status);
    }
  }
  throw new Error("all routes failed");
}
console.log(await withFallback("Name three Qwen model tiers."));
Как создать ключ, описано в кратком руководстве Flatkey, а настройка SDK — в руководстве по базовому URL OpenAI API.
Model Studio напрямую или роутер?
| Вопрос | Model Studio напрямую | Роутер Flatkey |
|---|---|---|
| Минимально возможная цена Qwen | Область Global плюс ночные скидки | Фиксированная цена со скидкой, без выбора региона |
| Контроль резидентности данных | Выбор региона и области | Уточните регион маршрутизации |
| Количество ключей | По одному на регион | Один для всех поддерживаемых моделей |
| Другие провайдеры | Отдельные аккаунты | Тот же ключ и баланс |
| Резервирование (fallback) | Строите сами | Меняете строку model |
Частые вопросы
Сколько стоит API Qwen?
На 20 октября 2026 г. (Сингапур, International) qwen3.8-max стоит $2.00 за вход и $6.00 за выход на 1 млн токенов, прайсовая цена qwen3.7-plus — $0.40 / $1.60, qwen3.8-flash — $0.15 / $0.47, а qwen3.7-flash — от $0.03 / $0.13 для промптов до 32K токенов.
Есть ли бесплатный тариф API Qwen?
Да, только в регионе Сингапур: 1 млн бесплатных токенов на модель сроком на 90 дней. В других регионах бесплатной квоты нет.
Почему у одной модели Qwen разные цены?
Цена зависит от региона и области развертывания. Global дешевле, но может обрабатывать запросы вне выбранного региона. International и US дороже, зато обработка остается в пределах их географии.
Есть ли у Qwen цены на batch?
Да. Модели с поддержкой batch стоят 50% от цены реального времени и на вход, и на выход. Скидку на batch нельзя совмещать со скидками на кэш.
Совместим ли API Qwen с OpenAI?
Да. Model Studio предоставляет эндпоинты compatible-mode/v1 (документация по совместимости с OpenAI), поэтому можно использовать OpenAI SDK, сменив базовый URL, ключ и имя модели. Модели Qwen также можно вызывать через https://router.flatkey.ai/v1 от Flatkey.
Какая модель Qwen самая дешевая?
qwen3.7-flash: $0.03 за вход и $0.13 за выход на 1 млн токенов (Сингапур) для промптов до 32K токенов. В области Global — $0.028 / $0.110.
Итог
Закладывайте $2 / $6 за 1 млн токенов для qwen3.8-max и $0.15 / $0.47 для qwen3.8-flash по прайсовым ценам Сингапура. Область Global дешевле примерно на 7–31%, если позволяет резидентность данных, а batch снижает цену вдвое. Перед окончательным решением перепроверьте официальную страницу цен. Чтобы использовать Qwen вместе с GPT, Claude и Gemini по одному ключу, подключите маршруты Qwen во Flatkey.
Последнее обновление: 20 октября 2026 г. · Flatkey Team. Цены указаны в USD по официальным источникам, ссылки на которые приведены в тексте.