Qwen API 价格(2026):所有模型、地域与折扣详解
阿里云百炼(Model Studio,新加坡国际站)上的 Qwen API,短提示词下 qwen3.7-flash 最低每百万输入 Token 仅 $0.03。旗舰模型 qwen3.8-max 输入 $2.00、输出 $6.00(每百万 Token),qwen3.7-plus 标价 $0.40 / $1.60(目前八折)。 价格会随地域、单次请求长度和调用模式变化:同一个 qwen3.8-max 在 Global 部署下标价为 $1.65 / $4.951。支持批量调用的模型,批量价格为实时价格的 50%。以上数据来自官方 Model Studio 价格页(最近更新于 2026 年 10 月 19 日),核对日期为 2026 年 10 月 20 日。
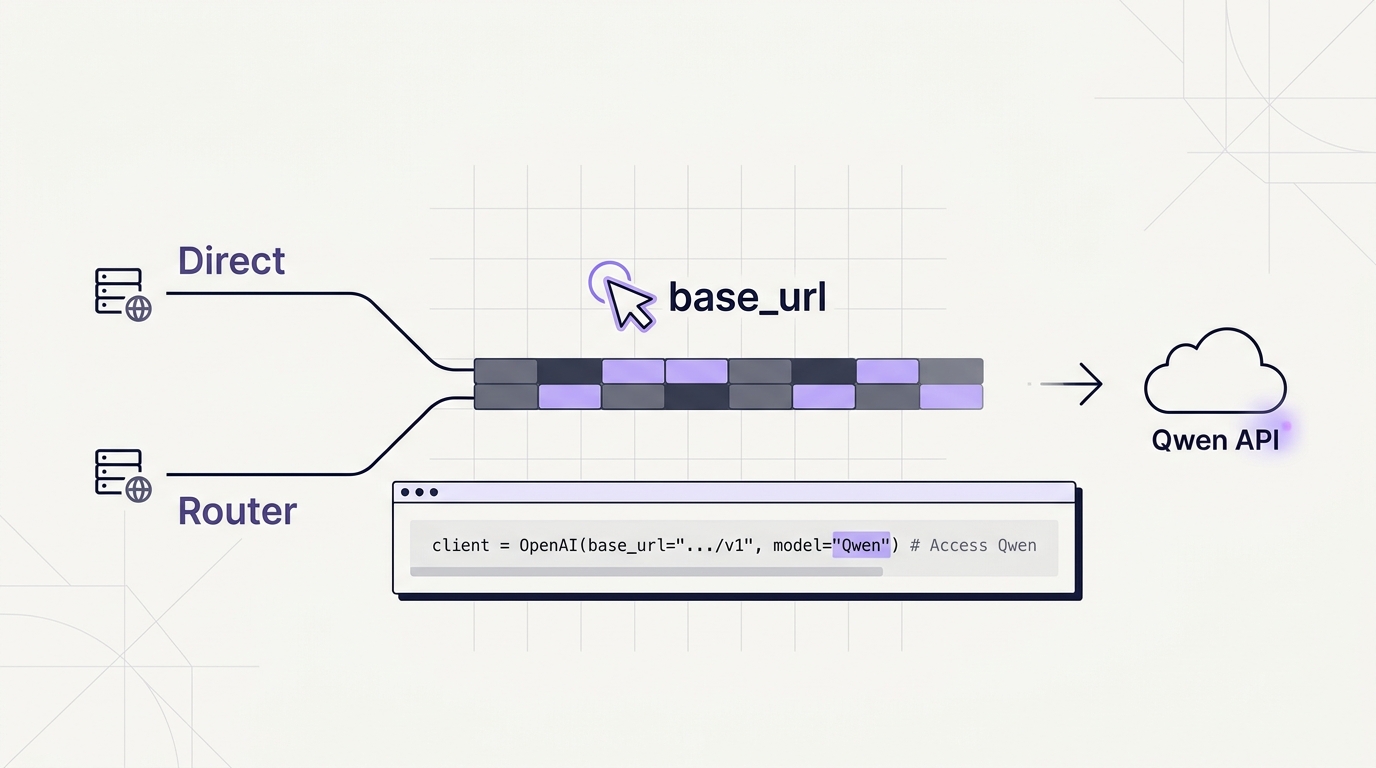
本文涵盖 Max、Plus、Flash、Coder、开源权重(GitHub 上的 QwenLM)和 VL 系列的当前价格,阶梯计费与缓存的规则,一个完整的成本测算示例,与其他厂商的对比,以及直接调用 Qwen 或通过一个 Flatkey key 调用的 OpenAI 兼容代码。
Qwen API 价格一览(每百万 Token)
新加坡地域、国际部署、标准实时价格,2026 年 10 月 20 日(来源):
| 模型 | 单次请求提示词长度 | 输入 | 输出 | 备注 |
|---|---|---|---|---|
qwen3.8-max |
最多 1M | $2.00 | $6.00 | 旗舰;支持思考与非思考模式 |
qwen3.7-max |
最多 1M | $2.50 | $7.50 | 上一代旗舰 |
qwen-max |
统一价 | $1.60 | $6.40 | 旧版;批量五折 |
qwen3.7-plus |
最多 256K | $0.40 | $1.60 | 标价;限时八折 |
qwen3.7-plus |
256K–1M | $1.20 | $4.80 | 标价;限时八折 |
qwen3.6-plus |
最多 256K | $0.50 | $3.00 | |
qwen3.5-plus |
最多 256K | $0.40 | $2.40 | |
qwen3.8-flash |
最多 1M | $0.15 | $0.47 | 最新 Flash |
qwen3.7-flash |
最多 32K | $0.03 | $0.13 | 短提示词最便宜的选择 |
qwen3.7-flash |
32K–256K | $0.10 | $0.40 | |
qwen3.7-flash |
256K–1M | $0.20 | $0.80 | |
qwen3.5-flash |
最多 1M | $0.10 | $0.40 | |
qwen3-coder-flash |
最多 32K | $0.30 | $1.50 | 超过 256K 升至 $1.60 / $9.60 |
qwen3.8-27b(开源权重) |
最多 1M | $0.50 | $3.00 | |
qwen3-vl-plus |
最多 32K | $0.20 | $1.60 | 视觉语言模型 |
新加坡的新账号每个模型可获得 100 万免费 Token,有效期 90 天,从开通或模型发布之日起算,以较晚者为准。阿里云说明免费额度仅在新加坡地域提供。
Global、国际与美国部署:同一模型为何有两种价格
Model Studio 以不同的部署范围售卖同一模型,价格取决于推理在哪里运行:
| 模型 | 新加坡(国际) | Global 范围(美国、欧洲、日本、香港地域) | 美国范围(弗吉尼亚) |
|---|---|---|---|
qwen3.8-max |
$2.00 / $6.00 | $1.65 / $4.951 | $2.00 / $6.00 |
qwen3.7-plus(≤256K,标价) |
$0.40 / $1.60 | $0.276 / $1.101 | $0.40 / $1.60 |
qwen3.8-flash |
$0.15 / $0.47 | $0.113 / $0.382 | $0.15 / $0.47 |
qwen3.7-flash(≤32K) |
$0.030 / $0.130 | $0.028 / $0.110 | $0.030 / $0.130 |
来源:Model Studio 价格,2026 年 10 月 20 日。价格为每百万 Token 的输入 / 输出。
Global 范围的价格比国际或美国范围低约 7%–31%,视模型而定(qwen3.7-flash 低 7%,qwen3.8-max 低 17.5%,qwen3.7-plus 输入低 31%)。代价是数据驻留:Global 范围可能把推理调度到你所选地域之外。如果必须在美国境内处理,请使用美国范围及其更高的价格。在香港、法兰克福、弗吉尼亚和东京地域,Global 范围的 qwen3.7-plus 还有限时夜间四折优惠(UTC+8 22:00–08:00),白天八折。
阶梯计费:一个长提示词会让整个请求按高档计价
Model Studio 的规则是:"请求中的所有 Token 均按对应档位的单价计费。" 一个输入 33K Token 的 qwen3.7-flash 请求,会全部按 32K–256K 档($0.10)计费,而不是前 32K 按 $0.03 计。由于第二档是第一档的 3.3 倍,把提示词从 33K 压缩到 31K Token,输入成本可降低约 70%。
缓存与批量折扣
| 折扣 | 规则(Model Studio,2026 年 10 月) |
|---|---|
| 上下文缓存命中 | 按标准输入价格的 10% 计费(上下文缓存文档) |
| 显式创建缓存 | 按标准输入价格的 125% 计费 |
| 批量推理 | 支持批量的模型,输入和输出均为实时价格的 50%(批量 API 文档) |
| 叠加 | 同一请求不能同时享受缓存折扣和批量折扣 |
显式缓存只要命中一次就回本:创建缓存时付一次 125%,之后每次读取只付 10%,而不是 100%。在 qwen3.8-max 上重复使用一个 20K Token 的系统提示词,首次调用输入费用为 $0.05,之后每次缓存命中只要 $0.004,而不是 $0.04。
成本测算示例
一个基于 qwen3.8-max(新加坡)的 RAG 助手: 每月 20 万次请求,每次输入 12K Token(其中 8K 为缓存前缀),输出 600 Token。
| 项目 | 计算 | 费用 |
|---|---|---|
| 未缓存输入 | 800M Token × $2.00 | $1,600 |
| 缓存输入(10%) | 1,600M Token × $0.20 | $320 |
| 输出 | 120M Token × $6.00 | $720 |
| 合计 | $2,640 |
同样的流量放在 Global 范围的 qwen3.8-max 上约为 $2,178。如果 Flash 的效果能满足要求,放在 qwen3.8-flash(新加坡)上约为 $200($120 + $24 + $56.40),便宜约 13 倍。
QWEN = {  # Singapore International list prices per 1M tokens, Oct 20, 2026
    "qwen3.8-max":   (2.00, 6.00),
    "qwen3.7-plus":  (0.40, 1.60),   # <=256K tier
    "qwen3.8-flash": (0.15, 0.47),
}

def qwen_cost(model, uncached, cached, output, batch=False):
    inp, out = QWEN[model]
    if batch:  # batch and cache discounts don't stack
        return (uncached + cached) / 1e6 * inp * 0.5 + output / 1e6 * out * 0.5
    return uncached / 1e6 * inp + cached / 1e6 * inp * 0.10 + output / 1e6 * out

print(qwen_cost("qwen3.8-max", 800e6, 1600e6, 120e6))   # 2640.0
Qwen 与其他模型 API 对比
每百万 Token 标价,2026 年 10 月 20 日。Qwen 价格来自 Model Studio(新加坡),其他价格来自对应的 Flatkey 模型页。
| 模型 | 输入 | 输出 |
|---|---|---|
qwen3.8-max |
$2.00 | $6.00 |
gpt-6-sol |
$2.00 | $10.00 |
claude-sonnet-5-5 |
$2.00 | $10.00 |
kimi-k3 |
$3.00 | $15.00 |
glm-5.3 |
$1.40 | $4.40 |
qwen3.8-flash |
$0.15 | $0.47 |
gpt-6-luna |
$0.10 | $0.50 |
claude-haiku-5-5 |
$0.10 | $0.50 |
qwen3.8-max 的输入价与 GPT-6 Sol 和 Claude Sonnet 5.5 持平,但输出便宜 40%。更全面的对比可参阅 DeepSeek 与 Qwen 成本指南 和 AI API 价格对比。
通过 Flatkey 调用 Qwen:价格与一个 key 通用
Flatkey 的模型目录中有多个 Qwen 模型,与 GPT、Claude、Gemini、DeepSeek 和 Kimi 共用同一个 OpenAI 兼容端点。截至 2026 年 10 月 20 日 Flatkey 模型页上的价格:
| 模型 | Flatkey 输入 | Flatkey 缓存 | Flatkey 输出 | 页面标价 |
|---|---|---|---|---|
qwen3.8-max |
$1.60 | $0.20 | $4.80 | $2 / $0.25 / $6(−20%) |
qwen3.7-plus |
$0.32 | $0.064 | $1.28 | $0.40 / $0.08 / $1.60(−20%) |
qwen3.8-flash |
$0.12 | $0.0128 | $0.376 | $0.15 / $0.016 / $0.47(−20%) |
qwen3.5-flash |
$0.08 | 无 | $0.32 | $0.10 / $0.40(−20%) |
qwen3.8-max 页面还显示,过去 30 天平均供应商可用率为 98.9%,平均延迟 1.78 秒。Flatkey 的价格和优惠会调整,确定预算前请查看价格页。
如何调用 Qwen API(兼容 OpenAI)
方案 A:直接调用 Model Studio
在 Model Studio 控制台创建 API Key,地域必须与你要调用的端点一致。其他地域的 key 会被拒绝,而且报错看起来就像普通的鉴权失败。Base URL 取决于地域和工作空间(Base URL 文档),例如美国(弗吉尼亚)端点为 https://dashscope-us.aliyuncs.com/compatible-mode/v1。
curl https://dashscope-us.aliyuncs.com/compatible-mode/v1/chat/completions \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-flash", "messages": [{"role": "user", "content": "Hello"}]}'
方案 B:Flatkey(一个 key 调用 Qwen 和其他所有模型)
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-max", "messages": [{"role": "user", "content": "Write a haiku about caching."}]}'
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

# Same client, same key: switch Qwen tiers or providers by changing one string.
for model in ["qwen3.8-flash", "qwen3.8-max", "claude-sonnet-5-5"]:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Classify: 'refund not received' -> billing|tech|other"}],
    )
    print(model, r.usage.prompt_tokens, r.usage.completion_tokens, r.choices[0].message.content)
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

async function withFallback(prompt) {
  for (const model of ["qwen3.8-max", "gpt-6-sol"]) {
    try {
      const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: prompt }] });
      return `${model}: ${r.choices[0].message.content}`;
    } catch (err) {
      console.warn(model, "failed:", err.status);
    }
  }
  throw new Error("all routes failed");
}
console.log(await withFallback("Name three Qwen model tiers."));
创建 key 请参阅 Flatkey 快速入门,SDK 配置请参阅 OpenAI API Base URL 指南。
直接用 Model Studio 还是用路由?
| 问题 | 直接用 Model Studio | Flatkey 路由 |
|---|---|---|
| Qwen 的最低价格 | Global 范围加夜间折扣 | 统一折扣价,无需选地域 |
| 数据驻留控制 | 自选地域和范围 | 可咨询路由地域 |
| key 的数量 | 每个地域一个 | 所有支持的模型共用一个 |
| 其他厂商 | 分别开账号 | 同一个 key 和余额 |
| 故障切换 | 自己搭建 | 改一下 model 字符串 |
常见问题
Qwen API 多少钱?
截至 2026 年 10 月 20 日(新加坡,国际),qwen3.8-max 每百万 Token 输入 $2.00、输出 $6.00,qwen3.7-plus 标价 $0.40 / $1.60,qwen3.8-flash 为 $0.15 / $0.47,qwen3.7-flash 在 32K Token 以内的提示词起价 $0.03 / $0.13。
Qwen API 有免费额度吗?
有,但仅限新加坡地域:每个模型 100 万免费 Token,有效期 90 天。其他地域没有免费额度。
为什么同一个 Qwen 模型有不同价格?
价格取决于地域和部署范围。Global 范围更便宜,但请求可能在你所选地域之外处理;国际和美国范围更贵,但处理会留在对应的地理范围内。
Qwen 有批量价格吗?
有。支持批量的模型,输入和输出均为实时价格的 50%。批量折扣不能与缓存折扣叠加。
Qwen API 兼容 OpenAI 吗?
兼容。Model Studio 提供 compatible-mode/v1 端点(OpenAI 兼容文档),只需修改 Base URL、key 和模型名即可使用 OpenAI SDK。你也可以通过 Flatkey 的 https://router.flatkey.ai/v1 调用 Qwen 模型。
最便宜的 Qwen 模型是哪个?
qwen3.7-flash,32K Token 以内的提示词每百万 Token 输入 $0.03、输出 $0.13(新加坡)。Global 范围下为 $0.028 / $0.110。
总结
按新加坡标价,qwen3.8-max 预算为每百万 Token $2 / $6,qwen3.8-flash 为 $0.15 / $0.47。如果数据驻留允许,Global 范围便宜约 7%–31%,批量调用再减半。确定预算前请再次核对官方价格页。想用一个 key 同时调用 Qwen、GPT、Claude 和 Gemini,可以使用 Flatkey 的 Qwen 路由。
最后更新:2026 年 10 月 20 日 · Flatkey Team。价格单位为美元,引自文中链接的官方来源。