Qwen API 料金(2026年):全モデル・リージョン・割引を徹底解説
Alibaba Cloud Model Studio(シンガポール、国際版)の Qwen API は、短いプロンプトなら qwen3.7-flash で入力100万トークンあたり $0.03 から利用できます。フラッグシップの qwen3.8-max は100万トークンあたり入力 $2.00・出力 $6.00、qwen3.7-plus の定価は $0.40 / $1.60(現在20%オフ)です。 料金はリージョン、リクエストのサイズ、モードによって変わり、同じ qwen3.8-max でも Global デプロイでは $1.65 / $4.951 です。対応モデルではバッチ呼び出しがリアルタイム料金の50%になります。数値は公式の Model Studio 料金ページ(2026年10月19日更新)に基づき、2026年10月20日に確認しました。
本ガイドでは、Max、Plus、Flash、Coder、オープンウェイト(GitHub の QwenLM)、VL の最新料金、段階料金とキャッシュの仕組み、具体的なコスト試算、他社との比較、そして Qwen を直接、または Flatkey の1つのキーで呼び出す OpenAI 互換コードを紹介します。
Qwen API 料金一覧(100万トークンあたり)
シンガポールリージョン、International デプロイ、標準リアルタイム料金、2026年10月20日時点(出典):
| モデル | 1リクエストのプロンプト長 | 入力 | 出力 | 備考 |
|---|---|---|---|---|
qwen3.8-max |
1Mまで | $2.00 | $6.00 | フラッグシップ。思考モード・非思考モード対応 |
qwen3.7-max |
1Mまで | $2.50 | $7.50 | 前世代フラッグシップ |
qwen-max |
一律 | $1.60 | $6.40 | 旧モデル。バッチ50%オフ |
qwen3.7-plus |
256Kまで | $0.40 | $1.60 | 定価。期間限定20%オフ |
qwen3.7-plus |
256K–1M | $1.20 | $4.80 | 定価。期間限定20%オフ |
qwen3.6-plus |
256Kまで | $0.50 | $3.00 | |
qwen3.5-plus |
256Kまで | $0.40 | $2.40 | |
qwen3.8-flash |
1Mまで | $0.15 | $0.47 | 最新の Flash |
qwen3.7-flash |
32Kまで | $0.03 | $0.13 | 短いプロンプトで最安 |
qwen3.7-flash |
32K–256K | $0.10 | $0.40 | |
qwen3.7-flash |
256K–1M | $0.20 | $0.80 | |
qwen3.5-flash |
1Mまで | $0.10 | $0.40 | |
qwen3-coder-flash |
32Kまで | $0.30 | $1.50 | 256K超では $1.60 / $9.60 |
qwen3.8-27b(オープンウェイト) |
1Mまで | $0.50 | $3.00 | |
qwen3-vl-plus |
32Kまで | $0.20 | $1.60 | 視覚言語モデル |
シンガポールの新規アカウントには モデルごとに100万トークンの無料枠 が付与されます。有効期間は、アクティベーション日またはモデルのリリース日のうち遅いほうから90日間です。Alibaba Cloud によると、無料枠はシンガポールでのみ提供されています。
Global・International・US デプロイ:同じモデルに2つの価格がある理由
Model Studio は同じモデルを異なる デプロイ範囲 で提供しており、料金は推論がどこで実行されるかによって決まります。
| モデル | シンガポール(International) | Global 範囲(米国・EU・日本・香港リージョン) | US 範囲(バージニア) |
|---|---|---|---|
qwen3.8-max |
$2.00 / $6.00 | $1.65 / $4.951 | $2.00 / $6.00 |
qwen3.7-plus(≤256K、定価) |
$0.40 / $1.60 | $0.276 / $1.101 | $0.40 / $1.60 |
qwen3.8-flash |
$0.15 / $0.47 | $0.113 / $0.382 | $0.15 / $0.47 |
qwen3.7-flash(≤32K) |
$0.030 / $0.130 | $0.028 / $0.110 | $0.030 / $0.130 |
出典:Model Studio 料金、2026年10月20日。料金は100万トークンあたりの入力 / 出力です。
Global 範囲の料金は、モデルによって International や US 範囲より約7〜31%安くなります(qwen3.7-flash は7%、qwen3.8-max は17.5%、qwen3.7-plus の入力は31%)。その代わり、データ所在地の制約があります。Global 範囲では、選択したリージョン外で推論が実行される場合があります。米国内での処理が必須なら、料金の高い US 範囲を使ってください。さらに、香港・フランクフルト・バージニア・東京リージョンの Global 範囲の qwen3.7-plus には、期間限定で 夜間60%割引(UTC+8 の 22:00〜08:00)と日中20%割引があります。
段階料金:長いプロンプト1つでリクエスト全体の単価が変わる
Model Studio のルールは「リクエスト内のすべてのトークンは、該当する段階の単価で課金される」というものです。入力33Kトークンの qwen3.7-flash リクエストは、最初の32Kが $0.03 になるのではなく、全体が 32K–256K 段階($0.10)で課金されます。第2段階は第1段階の3.3倍なので、プロンプトを33Kから31Kトークンに削るだけで入力コストを約70%減らせます。
キャッシュとバッチの割引
| 割引 | ルール(Model Studio、2026年10月) |
|---|---|
| コンテキストキャッシュのヒット | 標準入力料金の 10% で課金(コンテキストキャッシュのドキュメント) |
| 明示的キャッシュの作成 | 標準入力料金の 125% で課金 |
| バッチ推論 | バッチ対応モデルで、入力・出力ともリアルタイム料金の 50%(バッチ API のドキュメント) |
| 併用 | 同一リクエストでキャッシュ割引とバッチ割引は 併用できません |
明示的キャッシュは1回ヒットすれば元が取れます。作成時に一度だけ125%を支払い、その後の読み取りは100%ではなく10%で済みます。qwen3.8-max で20Kトークンのシステムプロンプトを繰り返し使う場合、初回呼び出しの入力は $0.05、以降のキャッシュヒットは $0.04 ではなく $0.004 です。
コスト試算の例
qwen3.8-max(シンガポール)を使った RAG アシスタント: 月20万リクエスト、各リクエストの入力は12Kトークン(うち8Kはキャッシュされたプレフィックス)、出力は600トークン。
| 項目 | 計算 | コスト |
|---|---|---|
| キャッシュなし入力 | 800M トークン × $2.00 | $1,600 |
| キャッシュ入力(10%) | 1,600M トークン × $0.20 | $320 |
| 出力 | 120M トークン × $6.00 | $720 |
| 合計 | $2,640 |
同じトラフィックを Global 範囲の qwen3.8-max で処理すると約 $2,178 です。Flash の品質で十分なら、qwen3.8-flash(シンガポール)では約 $200($120 + $24 + $56.40)となり、約13分の1になります。
QWEN = {  # Singapore International list prices per 1M tokens, Oct 20, 2026
    "qwen3.8-max":   (2.00, 6.00),
    "qwen3.7-plus":  (0.40, 1.60),   # <=256K tier
    "qwen3.8-flash": (0.15, 0.47),
}

def qwen_cost(model, uncached, cached, output, batch=False):
    inp, out = QWEN[model]
    if batch:  # batch and cache discounts don't stack
        return (uncached + cached) / 1e6 * inp * 0.5 + output / 1e6 * out * 0.5
    return uncached / 1e6 * inp + cached / 1e6 * inp * 0.10 + output / 1e6 * out

print(qwen_cost("qwen3.8-max", 800e6, 1600e6, 120e6))   # 2640.0
Qwen と他のモデル API の比較
100万トークンあたりの定価、2026年10月20日時点。Qwen の料金は Model Studio(シンガポール)、その他はリンク先の Flatkey モデルページ によるものです。
| モデル | 入力 | 出力 |
|---|---|---|
qwen3.8-max |
$2.00 | $6.00 |
gpt-6-sol |
$2.00 | $10.00 |
claude-sonnet-5-5 |
$2.00 | $10.00 |
kimi-k3 |
$3.00 | $15.00 |
glm-5.3 |
$1.40 | $4.40 |
qwen3.8-flash |
$0.15 | $0.47 |
gpt-6-luna |
$0.10 | $0.50 |
claude-haiku-5-5 |
$0.10 | $0.50 |
qwen3.8-max は入力料金では GPT-6 Sol や Claude Sonnet 5.5 と同じですが、出力は40%安くなっています。より幅広い比較は、DeepSeek と Qwen のコストガイド と AI API 料金比較 をご覧ください。
Flatkey 経由の Qwen:料金と1つのキーでのアクセス
Flatkey のカタログには、GPT、Claude、Gemini、DeepSeek、Kimi と同じ OpenAI 互換エンドポイントの背後に複数の Qwen モデルがあります。2026年10月20日時点の Flatkey モデルページの料金:
| モデル | Flatkey 入力 | Flatkey キャッシュ | Flatkey 出力 | 表示されている定価 |
|---|---|---|---|---|
qwen3.8-max |
$1.60 | $0.20 | $4.80 | $2 / $0.25 / $6(−20%) |
qwen3.7-plus |
$0.32 | $0.064 | $1.28 | $0.40 / $0.08 / $1.60(−20%) |
qwen3.8-flash |
$0.12 | $0.0128 | $0.376 | $0.15 / $0.016 / $0.47(−20%) |
qwen3.5-flash |
$0.08 | なし | $0.32 | $0.10 / $0.40(−20%) |
qwen3.8-max のページには、過去30日間のプロバイダー平均稼働率98.9%、平均レイテンシ1.78秒も掲載されています。Flatkey の料金やキャンペーンは変わることがあるため、予算を確定する前に 料金ページ を確認してください。
Qwen API の呼び出し方(OpenAI 互換)
方法 A:Model Studio を直接使う
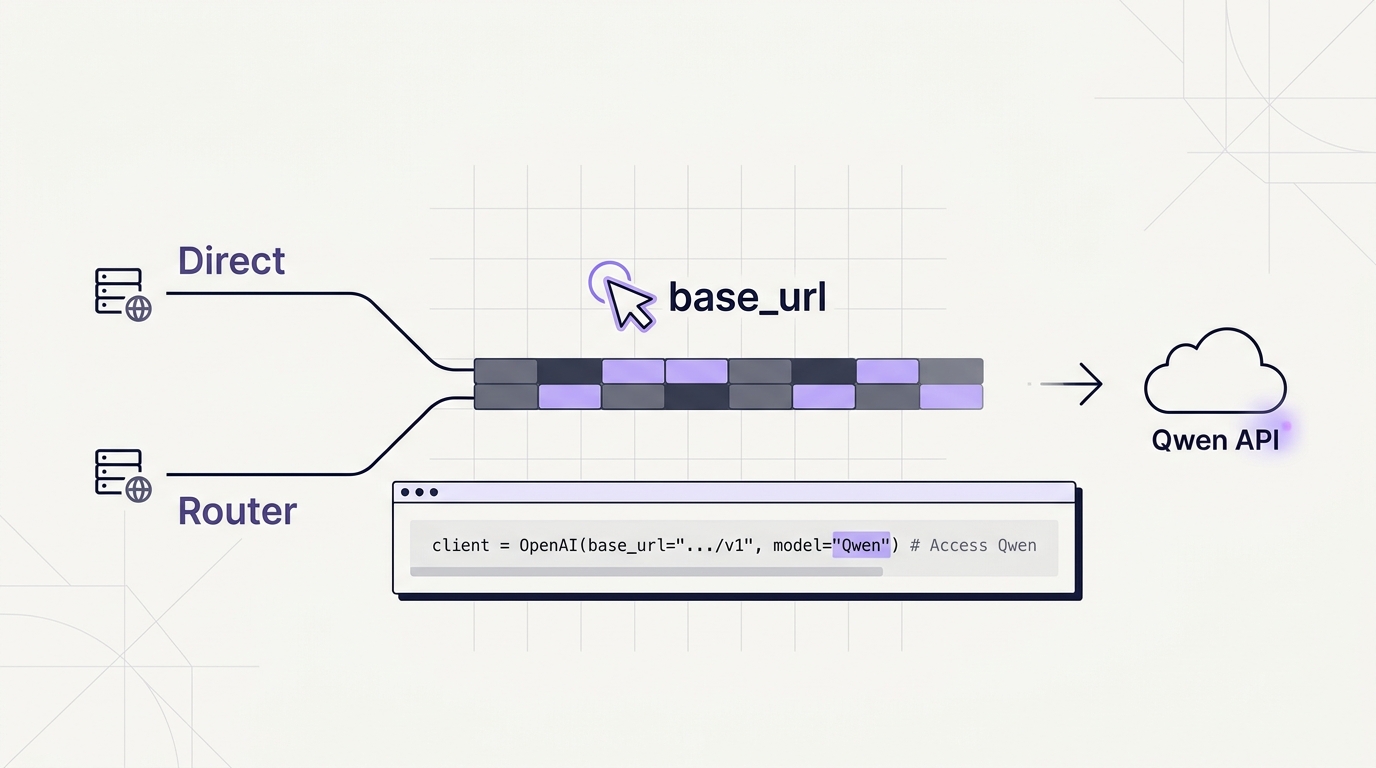
Model Studio コンソール で、呼び出すエンドポイントと 同じリージョン の API キーを作成します。別リージョンのキーは拒否され、そのエラーは通常の認証エラーのように見えます。ベース URL はリージョンとワークスペースによって異なります(ベース URL のドキュメント)。たとえば米国(バージニア)のエンドポイントは https://dashscope-us.aliyuncs.com/compatible-mode/v1 です。
curl https://dashscope-us.aliyuncs.com/compatible-mode/v1/chat/completions \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-flash", "messages": [{"role": "user", "content": "Hello"}]}'
方法 B:Flatkey(Qwen も他のモデルも1つのキーで)
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-max", "messages": [{"role": "user", "content": "Write a haiku about caching."}]}'
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

# Same client, same key: switch Qwen tiers or providers by changing one string.
for model in ["qwen3.8-flash", "qwen3.8-max", "claude-sonnet-5-5"]:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Classify: 'refund not received' -> billing|tech|other"}],
    )
    print(model, r.usage.prompt_tokens, r.usage.completion_tokens, r.choices[0].message.content)
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

async function withFallback(prompt) {
  for (const model of ["qwen3.8-max", "gpt-6-sol"]) {
    try {
      const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: prompt }] });
      return `${model}: ${r.choices[0].message.content}`;
    } catch (err) {
      console.warn(model, "failed:", err.status);
    }
  }
  throw new Error("all routes failed");
}
console.log(await withFallback("Name three Qwen model tiers."));
キーの作成は Flatkey クイックスタート、SDK の設定は OpenAI API ベース URL ガイド を参照してください。
Model Studio を直接使うか、ルーターを使うか
| 観点 | Model Studio を直接 | Flatkey ルーター |
|---|---|---|
| Qwen の最安価格 | Global 範囲+夜間割引 | 一律の割引料金、リージョン選択不要 |
| データ所在地の管理 | リージョンと範囲を選択 | ルーティングリージョンは要問い合わせ |
| キーの数 | リージョンごとに1つ | 対応する全モデルで1つ |
| 他のプロバイダー | 個別にアカウント作成 | 同じキーと残高 |
| フォールバック | 自前で構築 | model 文字列を変えるだけ |
よくある質問
Qwen API の料金はいくらですか?
2026年10月20日時点(シンガポール、International)で、qwen3.8-max は100万トークンあたり入力 $2.00・出力 $6.00、qwen3.7-plus の定価は $0.40 / $1.60、qwen3.8-flash は $0.15 / $0.47、qwen3.7-flash は32Kトークンまでのプロンプトで $0.03 / $0.13 からです。
Qwen API に無料枠はありますか?
はい。ただしシンガポールリージョンのみで、モデルごとに100万トークン、有効期間は90日です。他のリージョンには無料枠はありません。
同じ Qwen モデルなのに料金が違うのはなぜですか?
料金はリージョンとデプロイ範囲によって決まります。Global 範囲は安い代わりに、選択したリージョン外でリクエストが処理される可能性があります。International と US 範囲は高めですが、処理はそれぞれの地域内にとどまります。
Qwen にバッチ料金はありますか?
あります。バッチ対応モデルは、入力・出力ともリアルタイム料金の50%です。バッチ割引はキャッシュ割引と併用できません。
Qwen API は OpenAI 互換ですか?
はい。Model Studio は compatible-mode/v1 エンドポイントを提供しているため(OpenAI 互換性のドキュメント)、ベース URL、キー、モデル名を変えるだけで OpenAI SDK を使えます。Flatkey の https://router.flatkey.ai/v1 経由でも Qwen モデルを呼び出せます。
最も安い Qwen モデルはどれですか?
qwen3.7-flash です。32Kトークンまでのプロンプトなら100万トークンあたり入力 $0.03・出力 $0.13(シンガポール)、Global 範囲では $0.028 / $0.110 です。
まとめ
シンガポールの定価で、qwen3.8-max は100万トークンあたり $2 / $6、qwen3.8-flash は $0.15 / $0.47 を目安に予算を組みましょう。データ所在地の要件が許せば Global 範囲で約7〜31%安くなり、バッチならさらに半額です。確定前には 公式料金ページ を再確認してください。1つのキーで Qwen を GPT、Claude、Gemini と並べて使うなら、Flatkey の Qwen ルート をご利用ください。
最終更新:2026年10月20日 · Flatkey Team。料金は米ドル表記で、本文中にリンクした公式情報源から引用しています。