Precios de la API de Qwen (2026): todos los modelos, regiones y descuentos
Los precios de la API de Qwen en Alibaba Cloud Model Studio (Singapur, internacional) empiezan en $0.03 por 1M de tokens de entrada con qwen3.7-flash en prompts cortos. El modelo insignia qwen3.8-max cuesta $2.00 de entrada y $6.00 de salida por 1M de tokens, y qwen3.7-plus tiene un precio de lista de $0.40 / $1.60 (ahora con un 20% de descuento). Las tarifas cambian según la región, el tamaño de la solicitud y el modo: el mismo qwen3.8-max cuesta $1.65 / $4.951 con despliegue Global. Las llamadas batch cuestan el 50% del precio en tiempo real en los modelos compatibles. Las cifras proceden de la página oficial de precios de Model Studio (actualizada el 19 de octubre de 2026), revisada el 20 de octubre de 2026.
Esta guía cubre los precios actuales de Max, Plus, Flash, Coder, los modelos de pesos abiertos (QwenLM en GitHub) y VL; cómo funcionan los tramos y la caché; un ejemplo de coste completo; una comparación con otros proveedores; y código compatible con OpenAI para llamar a Qwen directamente o con una sola clave de Flatkey.
Precios de la API de Qwen de un vistazo (por 1M de tokens)
Región de Singapur, despliegue Internacional, tarifas estándar en tiempo real, 20 de octubre de 2026 (fuente):
| Modelo | Tamaño del prompt por solicitud | Entrada | Salida | Notas |
|---|---|---|---|---|
qwen3.8-max |
hasta 1M | $2.00 | $6.00 | Insignia; con y sin razonamiento |
qwen3.7-max |
hasta 1M | $2.50 | $7.50 | Insignia anterior |
qwen-max |
tarifa única | $1.60 | $6.40 | Heredado; 50% de descuento en batch |
qwen3.7-plus |
hasta 256K | $0.40 | $1.60 | Precio de lista; 20% de descuento temporal |
qwen3.7-plus |
256K–1M | $1.20 | $4.80 | Precio de lista; 20% de descuento temporal |
qwen3.6-plus |
hasta 256K | $0.50 | $3.00 | |
qwen3.5-plus |
hasta 256K | $0.40 | $2.40 | |
qwen3.8-flash |
hasta 1M | $0.15 | $0.47 | Flash más reciente |
qwen3.7-flash |
hasta 32K | $0.03 | $0.13 | La opción más barata para prompts cortos |
qwen3.7-flash |
32K–256K | $0.10 | $0.40 | |
qwen3.7-flash |
256K–1M | $0.20 | $0.80 | |
qwen3.5-flash |
hasta 1M | $0.10 | $0.40 | |
qwen3-coder-flash |
hasta 32K | $0.30 | $1.50 | Sube a $1.60 / $9.60 por encima de 256K |
qwen3.8-27b (pesos abiertos) |
hasta 1M | $0.50 | $3.00 | |
qwen3-vl-plus |
hasta 32K | $0.20 | $1.60 | Visión y lenguaje |
Las cuentas nuevas en Singapur reciben 1 millón de tokens gratis por modelo, válidos durante 90 días desde la activación o el lanzamiento del modelo, lo que ocurra más tarde. Alibaba Cloud indica que la cuota gratuita solo se ofrece en Singapur.
Despliegue Global vs Internacional vs EE. UU.: por qué el mismo modelo tiene dos precios
Model Studio vende el mismo modelo con distintos ámbitos de despliegue, y el precio depende de dónde se ejecuta la inferencia:
| Modelo | Singapur (Internacional) | Ámbito Global (regiones de EE. UU., UE, JP, HK) | Ámbito EE. UU. (Virginia) |
|---|---|---|---|
qwen3.8-max |
$2.00 / $6.00 | $1.65 / $4.951 | $2.00 / $6.00 |
qwen3.7-plus (≤256K, lista) |
$0.40 / $1.60 | $0.276 / $1.101 | $0.40 / $1.60 |
qwen3.8-flash |
$0.15 / $0.47 | $0.113 / $0.382 | $0.15 / $0.47 |
qwen3.7-flash (≤32K) |
$0.030 / $0.130 | $0.028 / $0.110 | $0.030 / $0.130 |
Fuente: precios de Model Studio, 20 de octubre de 2026. Precios de entrada / salida por 1M de tokens.
Los precios del ámbito Global son entre un 7% y un 31% más bajos que los del ámbito Internacional o EE. UU., según el modelo (7% en qwen3.7-flash, 17.5% en qwen3.8-max, 31% en la entrada de qwen3.7-plus). La contrapartida es la residencia de datos: el ámbito Global puede ejecutar la inferencia fuera de la región elegida. Si necesitas procesamiento solo en EE. UU., usa el ámbito EE. UU. y su tarifa más alta. qwen3.7-plus en ámbito Global en las regiones de Hong Kong, Fráncfort, Virginia y Tokio tiene además un descuento nocturno del 60% por tiempo limitado (22:00–08:00 UTC+8) y un 20% durante el día.
Precios por tramos: un prompt largo cambia el precio de toda la solicitud
La regla de Model Studio: "Todos los tokens de la solicitud se facturan al precio unitario del tramo correspondiente." Una solicitud a qwen3.7-flash con 33K tokens de entrada se factura entera al precio del tramo 32K–256K ($0.10), no a $0.03 los primeros 32K. Como el segundo tramo cuesta 3.3 veces el primero, recortar un prompt de 33K a 31K tokens reduce el coste de entrada en torno a un 70%.
Descuentos por caché y batch
| Descuento | Regla (Model Studio, oct. 2026) |
|---|---|
| Acierto de caché de contexto | Se factura al 10% del precio estándar de entrada (documentación de caché de contexto) |
| Creación de caché explícita | Se factura al 125% del precio estándar de entrada |
| Inferencia batch | 50% de los precios en tiempo real de entrada y salida, en modelos compatibles con batch (documentación de la API batch) |
| Acumulación | Los descuentos de caché y batch no se pueden combinar en la misma solicitud |
La caché explícita se amortiza con un solo acierto: pagas el 125% una vez para crearla y después el 10% en cada lectura en lugar del 100%. Con un prompt de sistema de 20K tokens repetido en qwen3.8-max, la primera llamada cuesta $0.05 de entrada y cada acierto de caché posterior cuesta $0.004 en vez de $0.04.
Ejemplo de coste
Un asistente RAG con qwen3.8-max (Singapur): 200,000 solicitudes al mes, cada una con 12K tokens de entrada (8K de ellos como prefijo en caché) y 600 tokens de salida.
| Concepto | Cálculo | Coste |
|---|---|---|
| Entrada sin caché | 800M tokens × $2.00 | $1,600 |
| Entrada en caché (10%) | 1,600M tokens × $0.20 | $320 |
| Salida | 120M tokens × $6.00 | $720 |
| Total | $2,640 |
El mismo tráfico en qwen3.8-max con ámbito Global sale por unos $2,178. Con qwen3.8-flash (Singapur) sale por unos $200 ($120 + $24 + $56.40), unas 13 veces más barato, si Flash cumple tu nivel de calidad.
QWEN = {  # Singapore International list prices per 1M tokens, Oct 20, 2026
    "qwen3.8-max":   (2.00, 6.00),
    "qwen3.7-plus":  (0.40, 1.60),   # <=256K tier
    "qwen3.8-flash": (0.15, 0.47),
}

def qwen_cost(model, uncached, cached, output, batch=False):
    inp, out = QWEN[model]
    if batch:  # batch and cache discounts don't stack
        return (uncached + cached) / 1e6 * inp * 0.5 + output / 1e6 * out * 0.5
    return uncached / 1e6 * inp + cached / 1e6 * inp * 0.10 + output / 1e6 * out

print(qwen_cost("qwen3.8-max", 800e6, 1600e6, 120e6))   # 2640.0
Qwen frente a otras API de modelos
Precios de lista por 1M de tokens, 20 de octubre de 2026. Las tarifas de Qwen son de Model Studio (Singapur); las demás, de las páginas de modelos de Flatkey enlazadas.
| Modelo | Entrada | Salida |
|---|---|---|
qwen3.8-max |
$2.00 | $6.00 |
gpt-6-sol |
$2.00 | $10.00 |
claude-sonnet-5-5 |
$2.00 | $10.00 |
kimi-k3 |
$3.00 | $15.00 |
glm-5.3 |
$1.40 | $4.40 |
qwen3.8-flash |
$0.15 | $0.47 |
gpt-6-luna |
$0.10 | $0.50 |
claude-haiku-5-5 |
$0.10 | $0.50 |
qwen3.8-max iguala a GPT-6 Sol y Claude Sonnet 5.5 en entrada, pero cobra un 40% menos por la salida. Para una visión más amplia, consulta la guía de costes DeepSeek vs Qwen y la comparativa de precios de API de IA.
Qwen a través de Flatkey: precio y acceso con una sola clave
El catálogo de Flatkey incluye varios modelos Qwen detrás del mismo endpoint compatible con OpenAI que GPT, Claude, Gemini, DeepSeek y Kimi. Precios en las páginas de modelos de Flatkey a 20 de octubre de 2026:
| Modelo | Entrada Flatkey | Caché Flatkey | Salida Flatkey | Precio de lista mostrado |
|---|---|---|---|---|
qwen3.8-max |
$1.60 | $0.20 | $4.80 | $2 / $0.25 / $6 (−20%) |
qwen3.7-plus |
$0.32 | $0.064 | $1.28 | $0.40 / $0.08 / $1.60 (−20%) |
qwen3.8-flash |
$0.12 | $0.0128 | $0.376 | $0.15 / $0.016 / $0.47 (−20%) |
qwen3.5-flash |
$0.08 | n/d | $0.32 | $0.10 / $0.40 (−20%) |
La página de qwen3.8-max también indica una disponibilidad media del proveedor del 98.9% y una latencia media de 1.78 s en los últimos 30 días. Los precios y promociones de Flatkey cambian, así que revisa la página de precios antes de fijar un presupuesto.
Cómo llamar a la API de Qwen (compatible con OpenAI)
Opción A: Model Studio directo
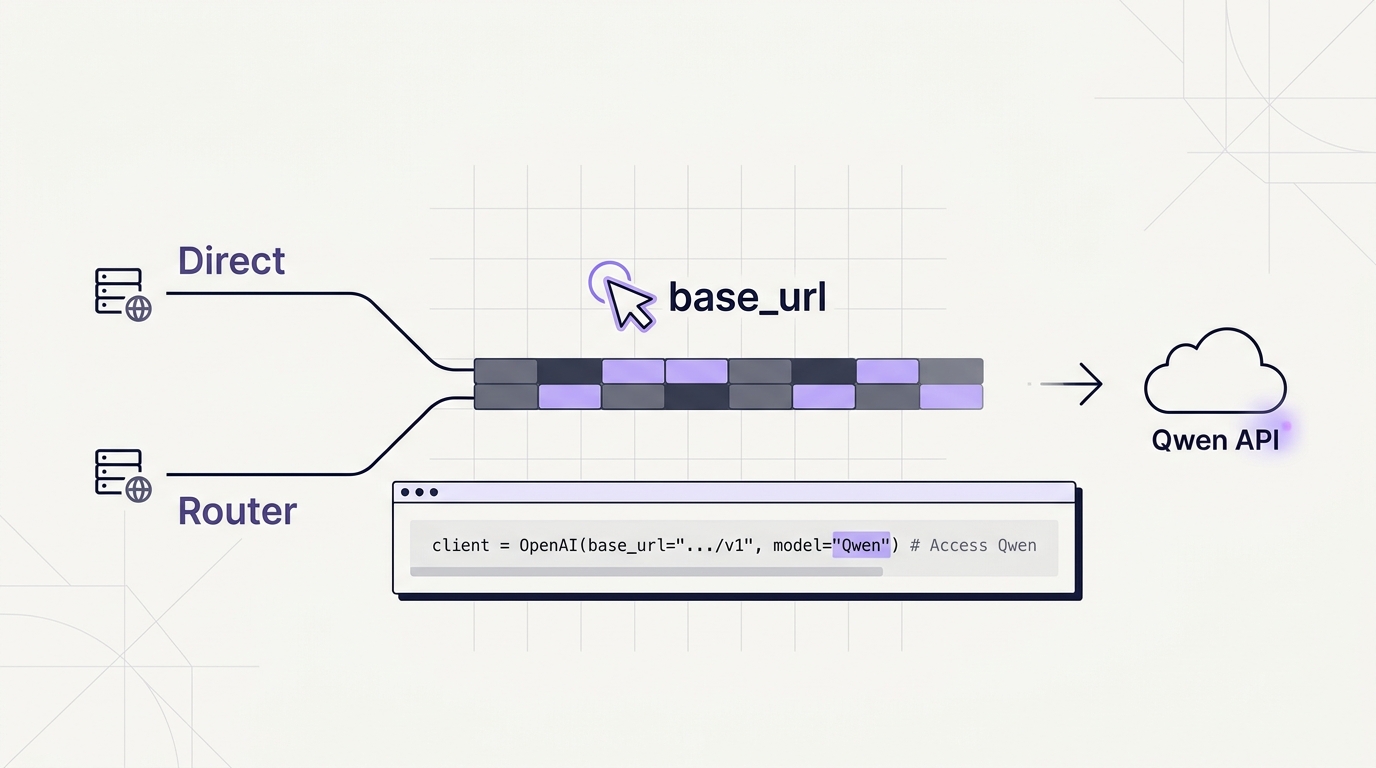
Crea una clave de API en la consola de Model Studio en la misma región que el endpoint al que vas a llamar. Una clave de otra región se rechaza, y el error parece un fallo de autenticación normal. La URL base depende de la región y del espacio de trabajo (documentación de URL base). Por ejemplo, el endpoint de EE. UU. (Virginia) es https://dashscope-us.aliyuncs.com/compatible-mode/v1.
curl https://dashscope-us.aliyuncs.com/compatible-mode/v1/chat/completions \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-flash", "messages": [{"role": "user", "content": "Hello"}]}'
Opción B: Flatkey (una clave para Qwen y todos los demás modelos)
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-max", "messages": [{"role": "user", "content": "Write a haiku about caching."}]}'
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

# Same client, same key: switch Qwen tiers or providers by changing one string.
for model in ["qwen3.8-flash", "qwen3.8-max", "claude-sonnet-5-5"]:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Classify: 'refund not received' -> billing|tech|other"}],
    )
    print(model, r.usage.prompt_tokens, r.usage.completion_tokens, r.choices[0].message.content)
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

async function withFallback(prompt) {
  for (const model of ["qwen3.8-max", "gpt-6-sol"]) {
    try {
      const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: prompt }] });
      return `${model}: ${r.choices[0].message.content}`;
    } catch (err) {
      console.warn(model, "failed:", err.status);
    }
  }
  throw new Error("all routes failed");
}
console.log(await withFallback("Name three Qwen model tiers."));
Consulta la guía rápida de Flatkey para crear la clave y la guía de la URL base de la API de OpenAI para configurar el SDK.
¿Model Studio directo o un router?
| Pregunta | Model Studio directo | Router de Flatkey |
|---|---|---|
| Precio de Qwen más bajo posible | Ámbito Global más descuentos nocturnos | Tarifa con descuento fijo, sin elegir región |
| Control de residencia de datos | Eliges región y ámbito | Consulta la región de enrutamiento |
| Número de claves | Una por región | Una para todos los modelos compatibles |
| Otros proveedores | Cuentas separadas | Misma clave y saldo |
| Fallback | Lo construyes tú | Cambias el string model |
Preguntas frecuentes
¿Cuánto cuesta la API de Qwen?
A 20 de octubre de 2026 (Singapur, Internacional), qwen3.8-max cuesta $2.00 de entrada y $6.00 de salida por 1M de tokens, qwen3.7-plus tiene un precio de lista de $0.40 / $1.60, qwen3.8-flash cuesta $0.15 / $0.47 y qwen3.7-flash empieza en $0.03 / $0.13 para prompts de hasta 32K tokens.
¿Hay un nivel gratuito de la API de Qwen?
Sí, solo en la región de Singapur: 1 millón de tokens gratis por modelo, válidos durante 90 días. Las demás regiones no tienen cuota gratuita.
¿Por qué Qwen tiene precios distintos para el mismo modelo?
Los precios dependen de la región y del ámbito de despliegue. El ámbito Global es más barato, pero puede procesar solicitudes fuera de la región elegida. Los ámbitos Internacional y EE. UU. cuestan más y mantienen el procesamiento dentro de su geografía.
¿Qwen ofrece precios batch?
Sí. Los modelos compatibles con batch cuestan el 50% del precio en tiempo real, tanto en entrada como en salida. El descuento batch no se puede combinar con los descuentos de caché.
¿La API de Qwen es compatible con OpenAI?
Sí. Model Studio expone endpoints compatible-mode/v1 (documentación de compatibilidad con OpenAI), así que puedes usar el SDK de OpenAI cambiando la URL base, la clave y el nombre del modelo. También puedes llamar a los modelos Qwen a través de https://router.flatkey.ai/v1 de Flatkey.
¿Cuál es el modelo Qwen más barato?
qwen3.7-flash, a $0.03 de entrada y $0.13 de salida por 1M de tokens (Singapur) para prompts de hasta 32K tokens. En ámbito Global cuesta $0.028 / $0.110.
En resumen
Presupuesta $2 / $6 por 1M de tokens para qwen3.8-max y $0.15 / $0.47 para qwen3.8-flash con los precios de lista de Singapur. El ámbito Global es entre un 7% y un 31% más barato si la residencia de datos lo permite, y batch reduce el precio a la mitad. Vuelve a comprobar la página oficial de precios antes de comprometerte. Para usar Qwen junto a GPT, Claude y Gemini con una sola clave, usa las rutas Qwen de Flatkey.
Última actualización: 20 de octubre de 2026 · Flatkey Team. Precios en USD, citados de las fuentes oficiales enlazadas en el texto.