
Blog da flatkey.ai
Insights, notas de produto e guias de implementação para equipes que criam com APIs de IA.
Arquitetura de gateways de IA
Artigos mais recentes em Arquitetura de gateways de IA.
Ler maisMigração de URL base e SDK
Artigos mais recentes em Migração de URL base e SDK.
Ler maisCustos, cobrança e operações
Artigos mais recentes em Custos, cobrança e operações.
Ler maisControles empresariais e confiança
Artigos mais recentes em Controles empresariais e confiança.
Ler maisComparações de gateways
Artigos mais recentes em Comparações de gateways.
Ler maisGuias de modelos e modalidades
Artigos mais recentes em Guias de modelos e modalidades.
Ler maisConfiabilidade e roteamento
Artigos mais recentes em Confiabilidade e roteamento.
Ler maisIntegrações de ferramentas
Artigos mais recentes em Integrações de ferramentas.
Ler mais
Estratégia de Queueing para API de IA: Proteja Workflows Voltados para o Usuário Durante Interrupções do Provedor
Um manual de confiabilidade de produção para proteger workflows de IA voltados para o usuário com filas de processamento, contrapressão, contratos de fallback, regras de dead-letter e evidência de rota.

Taxonomia de Erros de Gateway de LLM: Separe Falhas de Autenticação, Cota, Provedor e Segurança
Um manual de confiabilidade de produção para classificar falhas de gateway de LLM em caminhos de autenticação, cota, provedor, requisição, segurança e cancelamento antes de tentar novamente ou usar um fallback.

Limite de requisições da API excedido: o que significa e como resolver (2026)
O que significa o erro de limite de requisições da API excedido, como as principais APIs aplicam limites em 2026 e soluções passo a passo: Retry-After, código de backoff exponencial em Python e Node, limitadores de requisições, cache, filas e níveis superiores.

Estratégia de Timeout para API de IA: Orçamentos de Conexão, Leitura, Stream e Fila
Defina orçamentos de timeout para API de IA em produção para conexão, leitura, stream, fila, repetição, fallback e observabilidade antes que os incidentes se tornem caros.

Controles de Gateway de Agente de IA: Uso de Ferramentas, Orçamentos, Logs e Condições de Parada
Use os controles de gateway de agente de IA para governar o acesso a ferramentas, orçamentos, logs de requisição, comportamento de fallback e condições de parada antes que os agentes cheguem à produção.

Roteamento por Janela de Contexto: Escolha Modelos pelo Tamanho do Prompt sem Perder o Controle de Custos
Use o roteamento por janela de contexto para escolher modelos de recuperação, compactação, cache ou de contexto longo pelo tamanho do prompt, mantendo os custos do gateway de IA revisáveis.

Roteamento de modelos: estratégias, modelo de política e código para aplicações de IA em produção (2026)
O roteamento de modelos direciona cada solicitação de IA ao modelo mais adequado conforme a tarefa, a dificuldade, o custo, a latência, o contexto e a política de dados. Compare estratégias de roteamento, copie um modelo de política e implemente roteadores baseados em regras e em cascata com Python e Node.js.

OpenRouter vs LiteLLM vs Flatkey: Roteador Hospedado, Proxy Auto-Hospedado ou Gateway de Chave Única
Compare OpenRouter, LiteLLM e Flatkey por propriedade da conta, faturamento, BYOK, logs, cotas, comportamento de fallback, esforço de migração e verificações de prova.

Comparação de Roteadores LLM de Múltiplos Provedores: Faturamento, Logs, Cotas e Fallbacks
Compare as opções de roteadores LLM de múltiplos provedores por propriedade da conta, faturamento, logs de requisição, cotas, comportamento de fallback, facilidade de migração e adequação ao Flatkey.

Gateway de API de IA vs. Gerenciamento de API: O que muda para o tráfego de modelos
Compare gateway de API de IA vs. gerenciamento de API para tráfego de modelos em roteamento, logs, cotas, faturamento, migração, propriedade da conta e adequação do Flatkey.

Contas Diretas de Provedores vs AI API Gateway: Proliferação de Contas, Chaves e Faturas
Compare contas diretas de provedores vs um gateway de API de IA em termos de propriedade da conta, chaves de API, faturas, roteamento, registros de uso, cotas e adequação do Flatkey.

Gateway de API de IA Gerenciado vs. Proxy LLM Auto-hospedado: Compromissos de Custo, Controle e Operações
Compare os compromissos entre um gateway de API de IA gerenciado e um proxy LLM auto-hospedado por custo, controle, roteamento, faturamento, logs, cotas e operações.

Alternativa ao Vercel AI Gateway: Critérios de Avaliação para Equipes que Precisam de uma Chave Única
Compare os critérios de alternativas ao Vercel AI Gateway por propriedade da conta, faturamento, roteamento, logs, orçamentos, BYOK, esforço de migração e adequação ao Flatkey.

Alternativa ao APIPark para Gateways de API de IA: Roteador Hospedado vs Gerenciamento de API
Compare as opções de alternativa ao APIPark por acesso ao provedor, chaves de API, roteamento, logs, faturamento, cotas, esforço de migração e adequação ao Flatkey.

Alternativa ao Kong AI Gateway: Quando o Roteamento Também Precisa de Faturamento e Cotas
Compare as opções de alternativas ao Kong AI Gateway por roteamento de modelo, faturamento, cotas, logs, medição, esforço de migração e adequação ao Flatkey.
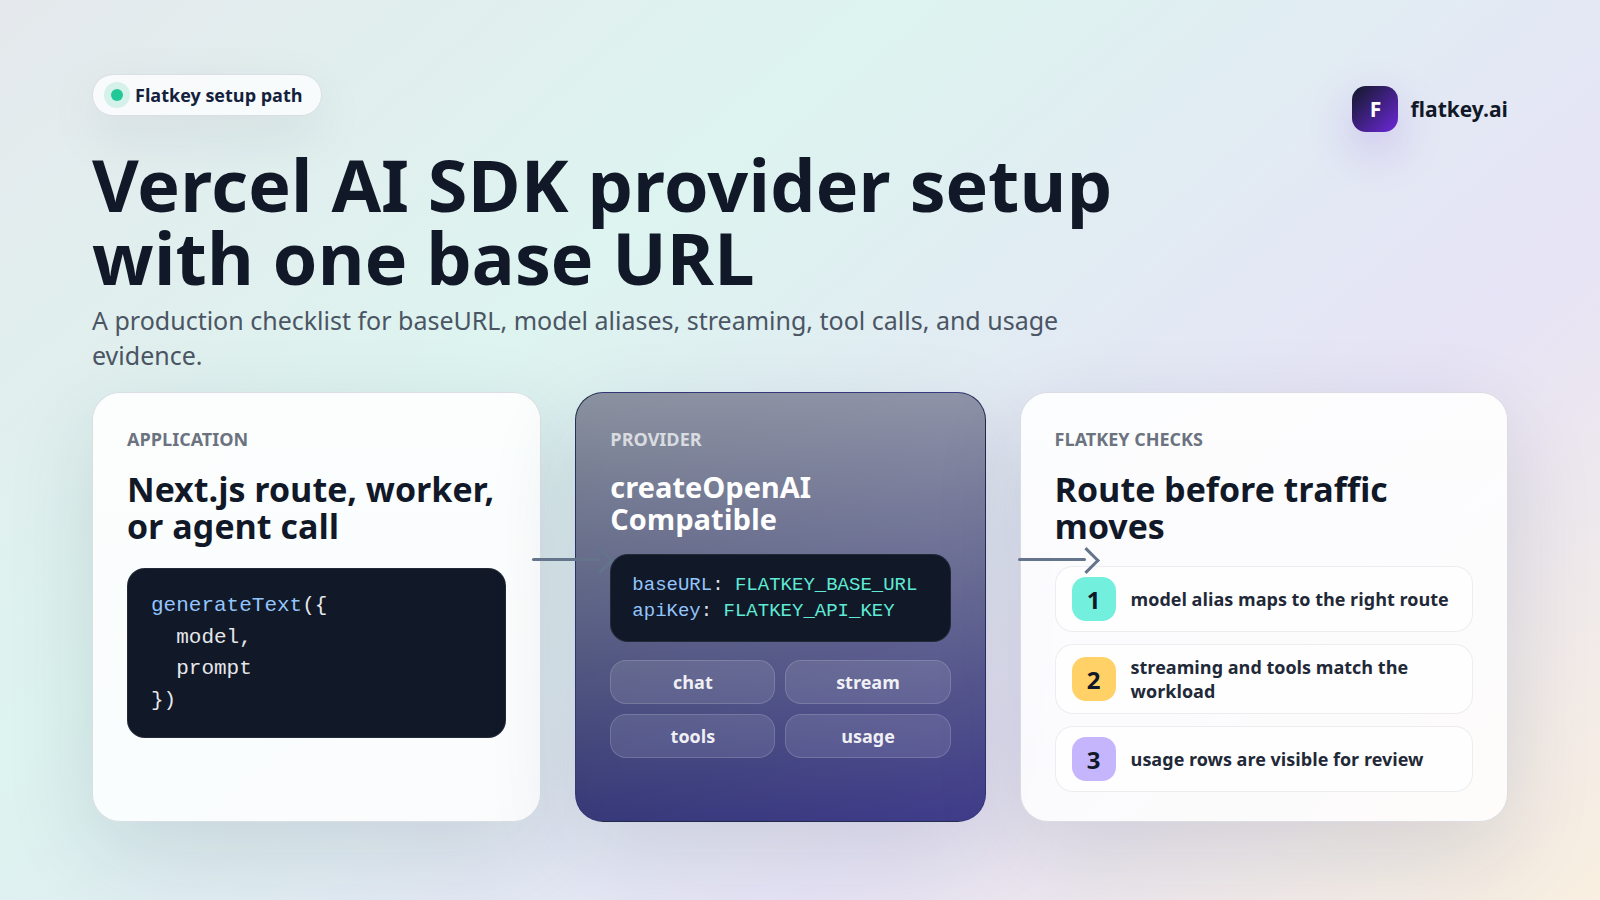
URL base do provedor personalizado do Vercel AI SDK: Notas de Configuração do Flatkey
Defina uma URL base de provedor personalizado do Vercel AI SDK para o Flatkey com configuração do provedor, aliases de modelo, verificações de streaming, verificações de ferramentas, prova de uso e rollback.
Alternativa ao Portkey para Compradores de Gateway de API de IA: O que Comparar
Compare as opções de alternativas ao Portkey pelo modelo operacional: propriedade da conta, faturamento, comprovação de roteamento, logs, cotas, esforço de migração, evidência de aquisição e adequação ao Flatkey.
URL base da API OpenAI do Open WebUI: Guia de Configuração do Flatkey
Configure o Open WebUI com o Flatkey como um roteador compatível com OpenAI: URL base, chave de API, filtros de modelo, verificações prévias com curl, testes de streaming e revisão de uso.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar