
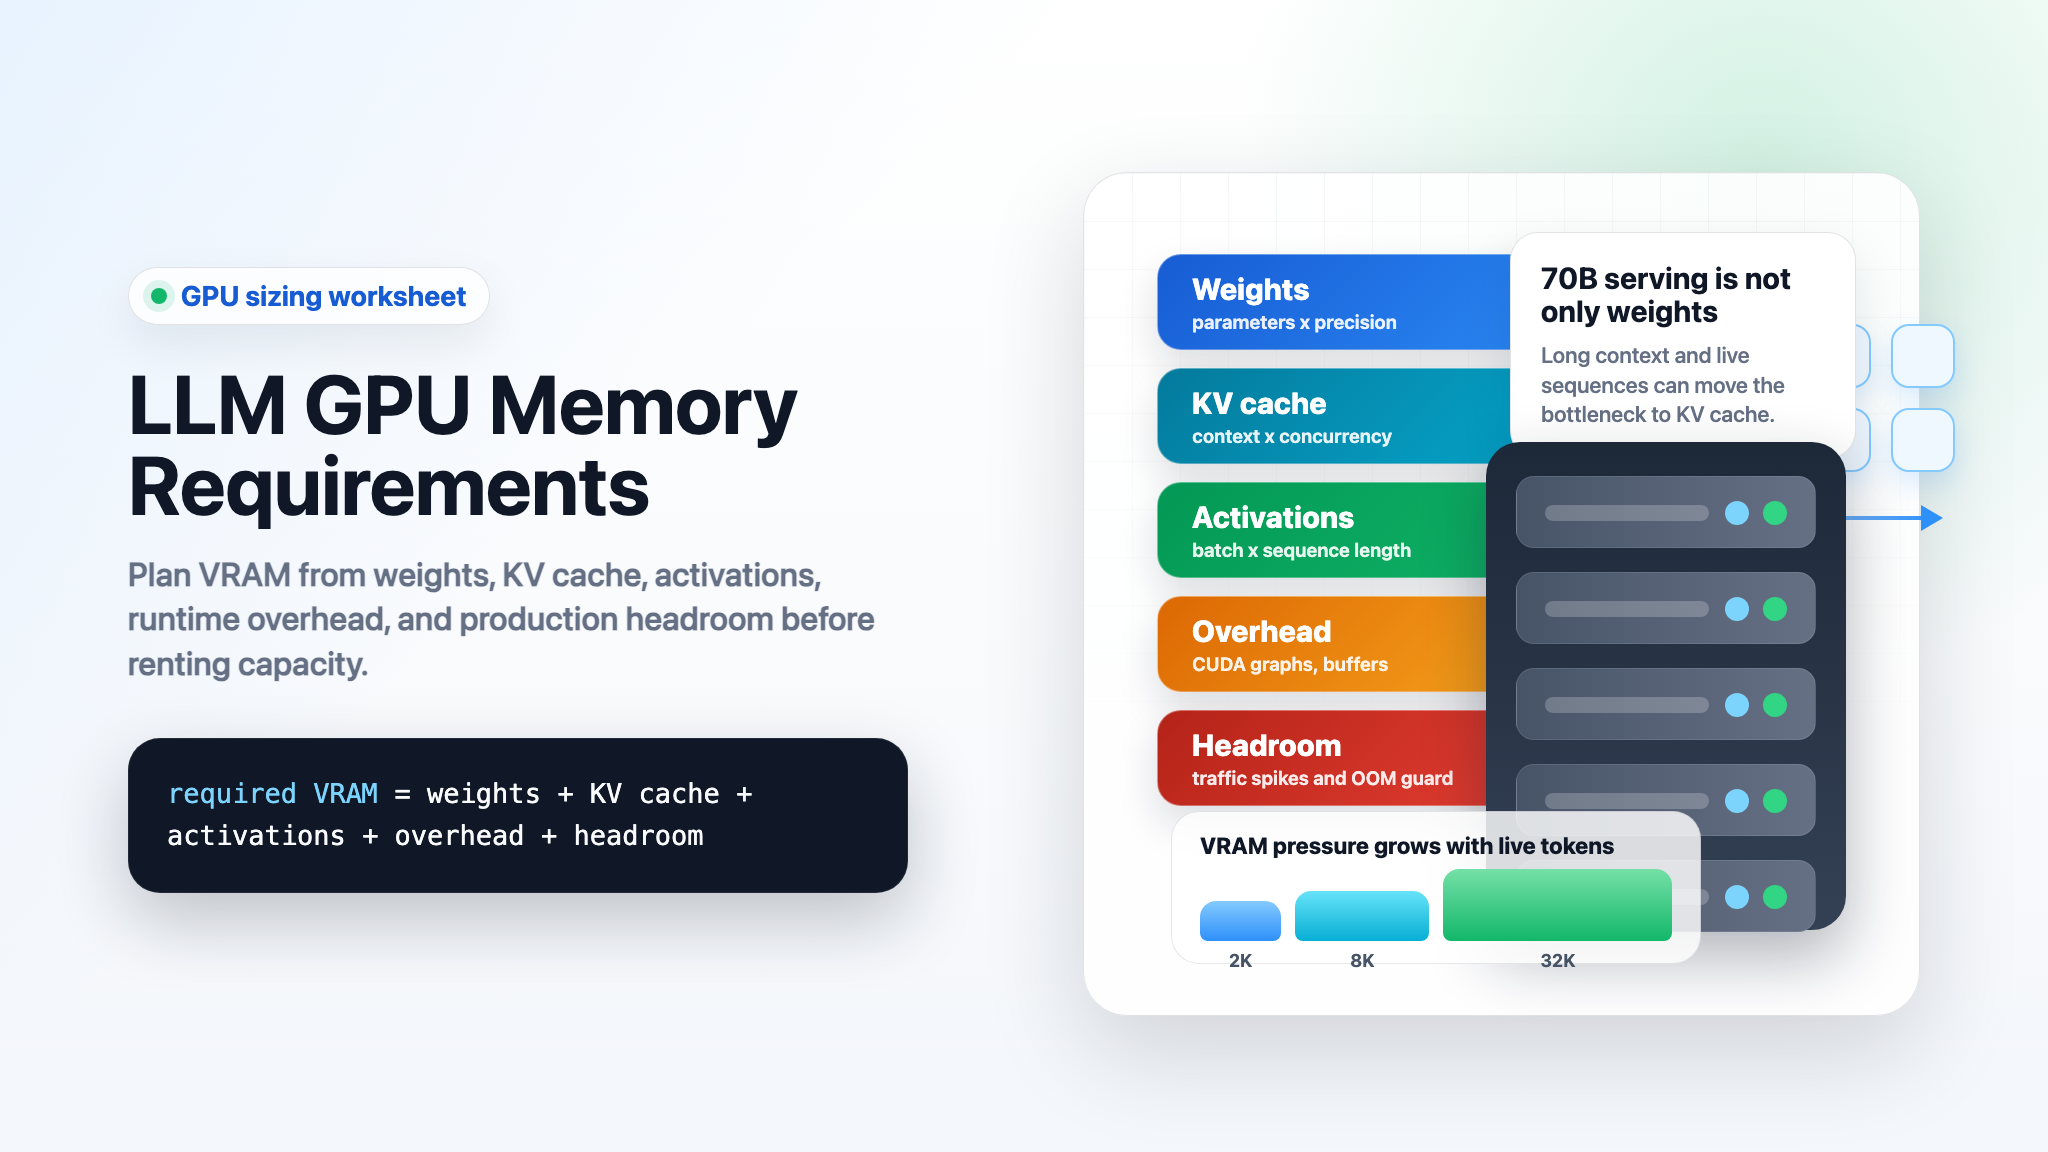
Yêu cầu bộ nhớ GPU cho LLM không chỉ là "kích thước mô hình cộng thêm một chút chỗ trống." Một tác vụ serving hoặc training có nhiều vùng nhớ riêng biệt: model weights, KV cache, activations, workspace của framework, CUDA graphs, các bộ đệm tạm thời, và phần dự phòng vận hành.
Quy tắc lập kế hoạch nhanh là:
VRAM cần thiết =
  model weights
+ KV cache cho các token đang hoạt động
+ bộ nhớ activation và workspace
+ training state, nếu training hoặc fine-tuning đầy đủ
+ phần dự phòng cho allocator và an toàn
Đó là lý do vì sao hai nhóm có thể chạy cùng một mô hình 70B trên cùng một họ GPU nhưng cho ra kết quả khác nhau. Một bên dùng prompt ngắn, một luồng, FP8 KV cache, và batching thận trọng. Bên kia dùng ngữ cảnh dài, nhiều yêu cầu đồng thời, CUDA graph capture, và thiết lập gpu_memory_utilization cao. Tác vụ đầu tiên chạy được. Tác vụ thứ hai thất bại với lỗi out-of-memory hoặc làm tăng độ trễ vì phải đẩy việc sang nơi khác.
Hướng dẫn này cung cấp một bảng tính thực tế cho llm gpu memory requirements trên inference, phục vụ vLLM, fine-tuning, và training. Hãy dùng nó trước khi thuê GPU, chọn dung lượng H100 so với H200 so với B200, hoặc quyết định liệu một model API có đơn giản hơn việc vận hành endpoint GPU của riêng bạn hay không.
Cau tra loi nhanh ve yeu cau bo nho GPU cho LLM
Đối với inference, hãy bắt đầu với weights, rồi tính KV cache từ độ dài ngữ cảnh và mức độ đồng thời. Đối với training, weights mới chỉ là phần khởi đầu; optimizer states, gradients, và các activations đã lưu mới là phần chiếm ưu thế trong kế hoạch bộ nhớ.
| Khối lượng công việc | Thường chiếm ưu thế VRAM | Quy tắc lập kế hoạch nhanh |
|---|---|---|
| Inference một yêu cầu | Weights | parameters x bytes_per_weight, sau đó cộng KV cache cho prompt và các token được sinh ra. |
| Inference thông lượng cao | KV cache và phần dự phòng cho scheduler | Tính theo concurrent sequences x tokens per sequence, không chỉ theo số lượng tham số của mô hình. |
| Phục vụ ngữ cảnh dài | KV cache | Tăng gấp đôi độ dài ngữ cảnh thì bộ nhớ KV cache cũng gần như tăng gấp đôi cho cùng một mô hình và batch. |
| Fine-tuning đầy đủ | Optimizer states, gradients, activations | AdamW mixed-precision có thể cần nhiều lần bộ nhớ model-weight trước cả khi tính đến activations. |
| Tuning LoRA hoặc adapter | Base weights cộng activations và trạng thái adapter | Nhỏ hơn nhiều so với full fine-tuning, nhưng ngữ cảnh dài và kích thước batch vẫn rất quan trọng. |
| Pretraining | Training state cộng activations cộng overhead phân tán | Lập kế hoạch từ một lần chạy framework đã đo đạc; công thức chỉ là bước ước lượng ban đầu. |
Nếu bạn chỉ cần đầu ra của mô hình, hãy so sánh direct GPU serving với một baseline model API trước. Direct GPUs phù hợp khi bạn cần weights tùy chỉnh, kiểm soát placement, chính sách runtime riêng tư, hoặc một workload rẻ hơn sau khi đã đo được mức sử dụng. Nếu bạn chủ yếu cần phản hồi API đáng tin cậy, một đường đi model được quản lý có thể giúp tránh hàng tuần sizing GPU, xếp hàng, và công việc vận hành.
Bang tinh yeu cau bo nho GPU cho LLM
Hãy dùng bảng tính này trước khi chọn instance.
| Vùng nhớ | Công thức hoặc kiểm tra | Ghi chú |
|---|---|---|
| Weights | parameter_count x weight_bytes |
BF16/FP16 dùng khoảng 2 byte cho mỗi tham số. INT8 dùng khoảng 1 byte. 4-bit dùng khoảng 0.5 byte trước metadata của lượng tử hóa. |
| KV cache | active_tokens x layers x kv_heads x head_dim x 2 x kv_bytes |
Số 2 là cho keys và values. Grouped-query attention làm giảm kv_heads so với full multi-head attention. |
| Activations | Inference: thường ở mức vừa phải. Training: phụ thuộc batch, sequence length, hidden size, layers, và lựa chọn checkpointing. | Hugging Face's model memory anatomy nêu rõ weights, optimizer states, gradients, saved activations, temporary buffers, và bộ nhớ dành riêng cho chức năng trong training. |
| Dự phòng cho serving framework | vLLM, TensorRT-LLM, SGLang, PyTorch, CUDA graphs, attention kernels, hàng đợi lập lịch | vLLM cung cấp các điều khiển bộ nhớ như gpu_memory_utilization, kv_cache_memory_bytes, kv_cache_dtype, max_model_len, và max_num_seqs. |
| Phần dự phòng an toàn | 10-20% cho production, nhiều hơn trong các lần benchmark đầu tiên | Chừa chỗ cho phân mảnh allocator, các đợt tăng lưu lượng, prompt dài hơn, tải lại mô hình, và các agent quan sát hệ thống. |
Sai lầm phổ biến nhất là vừa khít weights rồi quên các token đang hoạt động. Với ước tính yêu cầu bộ nhớ GPU cho inference của LLM, KV cache có thể là yếu tố quyết định giữa một endpoint ổn định và một vòng lặp OOM.
Buoc 1: tinh bo nho trong so mo hinh
Weights là phần đơn giản nhất trong yêu cầu bộ nhớ GPU cho workload LLM.
weight_memory_gib = parameters x bytes_per_parameter / 1024^3
| Kích thước mô hình | BF16 / FP16 weights | INT8 weights | 4-bit weights before metadata |
|---|---|---|---|
| 7B | ~13.0 GiB | ~6.5 GiB | ~3.3 GiB |
| 13B | ~24.2 GiB | ~12.1 GiB | ~6.1 GiB |
| 34B | ~63.3 GiB | ~31.7 GiB | ~15.8 GiB |
| 70B | ~130.4 GiB | ~65.2 GiB | ~32.6 GiB |
| 405B | ~754.4 GiB | ~377.2 GiB | ~188.6 GiB |
Bảng này là một cận dưới. Các triển khai thực tế sẽ bổ sung scale lượng tử hóa, buffer không phải tham số, trạng thái tokenizer/runtime, workspace tạm thời và overhead phục vụ.
Đối với ước tính vLLM GPU memory requirements 70B model VRAM, riêng weights BF16/FP16 đã vượt quá một H100 80 GB đơn lẻ. Một H200 đơn lẻ có 141 GB HBM3e theo trang H200 của NVIDIA, nên về nguyên tắc weights có thể vừa, nhưng KV cache còn lại và dung lượng dự phòng runtime vẫn có thể buộc phải dùng context nhỏ hơn, concurrency thấp hơn, lượng tử hóa KV-cache hoặc tensor parallelism. NVIDIA liệt kê H100 SXM là 80 GB, H200 là 141 GB, và DGX B200 là tám GPU Blackwell với tổng 1.440 GB HBM3e, tương đương hiệu dụng 180 GB cho mỗi GPU B200 trong hệ thống đó.
Bước 2: tính bộ nhớ KV cache cho yêu cầu bộ nhớ GPU của LLM
KV cache là bộ nhớ dùng để lưu các key và value của attention cho những token đã được xử lý. Nó cho phép mô hình sinh mà không cần tính lại toàn bộ prefix mỗi lần.
Đối với suy luận transformer chỉ decoder:
kv_cache_bytes =
  active_tokens
x num_layers
x num_kv_heads
x head_dim
x 2
x bytes_per_kv_element
Trong đó:
| Biến | Ý nghĩa |
|---|---|
active_tokens |
Tổng số token của prompt và token đã sinh hiện đang nằm trong cache trên các yêu cầu đang chạy. |
num_layers |
Số lớp transformer. |
num_kv_heads |
Số KV heads, không phải lúc nào cũng là số attention heads. Grouped-query attention có thể làm con số này nhỏ hơn nhiều. |
head_dim |
Kích thước mỗi head. |
2 |
Key cộng với value tensors. |
bytes_per_kv_element |
2 cho BF16/FP16, 1 cho FP8, thấp hơn nữa cho các chế độ cache bit thấp được hỗ trợ. |
Ví dụ, một cấu hình kiểu Llama 70B với 80 lớp, 8 KV heads và head dimension 128 sử dụng:
80 x 8 x 128 x 2 x 2 bytes = 327,680 bytes per token
Tức là khoảng 0,3125 MiB cho mỗi token đang hoạt động trong KV cache BF16/FP16.
| Ngữ cảnh đang hoạt động mỗi sequence | KV cache xấp xỉ cho một sequence | KV cache xấp xỉ cho 16 sequence đang chạy |
|---|---|---|
| 2,048 tokens | ~0.6 GiB | ~10.0 GiB |
| 4,096 tokens | ~1.3 GiB | ~20.0 GiB |
| 8,192 tokens | ~2.5 GiB | ~40.0 GiB |
| 16,384 tokens | ~5.0 GiB | ~80.0 GiB |
| 32,768 tokens | ~10.0 GiB | ~160.0 GiB |
Con số chính xác thay đổi theo kiến trúc mô hình. Một mô hình có nhiều KV heads hơn sẽ dùng nhiều bộ nhớ KV hơn. Một mô hình dùng multi-query hoặc grouped-query attention có thể dùng ít bộ nhớ KV hơn rất nhiều so với thiết kế full multi-head attention.
vLLM tài liệu hóa một số tham số quan trọng ở đây: --gpu-memory-utilization điều khiển tỷ lệ bộ nhớ GPU được model executor sử dụng, --kv-cache-memory-bytes có thể đặt kích thước KV cache một cách tường minh, --kv-cache-dtype có thể chọn độ chính xác của cache, và hướng dẫn tiết kiệm bộ nhớ khuyến nghị giảm max_model_len và max_num_seqs khi bộ nhớ eo hẹp. vLLM cũng tài liệu hóa FP8 KV cache như một cách giảm footprint của KV cache và hỗ trợ context dài hơn hoặc throughput cao hơn, nhưng vẫn cần xác thực độ chính xác.
Bước 3: cộng activations và overhead runtime
Đối với suy luận, bộ nhớ activation thường nhỏ hơn weights và KV cache, nhưng không phải bằng không. Prefill, CUDA graphs, attention kernels, buffer tạm thời, bộ xử lý multimodal, speculative decoding và batch scheduling có thể chiếm thêm bộ nhớ.
Đối với training, bộ nhớ activation trở thành một thành phần hàng đầu. Phân tích anatomy bộ nhớ mô hình của Hugging Face liệt kê các thành phần bộ nhớ training gồm weights mô hình, optimizer states, gradients, forward activations được lưu để tính gradient, các buffer tạm thời và bộ nhớ dành riêng cho chức năng. Tài liệu này cũng lưu ý rằng bộ nhớ activation phụ thuộc vào độ dài sequence, hidden size và batch size.
Một cách chia để lập kế hoạch hữu ích là:
| Kịch bản | Đặc điểm về activation và overhead |
|---|---|
| Suy luận đơn giản, batch 1 | Giữ ít nhất 10% dung lượng dự phòng sau weights và KV cache. |
| Phục vụ vLLM với CUDA graphs và batching | Bắt đầu với 15-20% dung lượng dự phòng, sau đó tinh chỉnh gpu_memory_utilization, max_model_len và max_num_seqs. |
| Phục vụ context dài | Xem KV cache là biến chính và dành nhiều dung lượng dự phòng hơn cho các đỉnh prefill. |
| Fine-tuning | Đo một lần chạy nhỏ ở độ dài sequence mục tiêu trước khi mở rộng; activations có thể chiếm ưu thế khi batch và context tăng. |
| Mô hình multimodal | Cộng thêm cache của processor và bộ nhớ input media; hướng dẫn tiết kiệm bộ nhớ của vLLM lưu ý các điều khiển cho multimodal cache và giới hạn input. |
Đừng chạy production ở mức 99% bộ nhớ chỉ vì một request thử nghiệm vừa khít. Điều đó không để lại chỗ cho prompt dài hơn, hot reloads, CUDA graph capture, hành vi của allocator, hay một mix lưu lượng khác với benchmark.
Bước 4: ước tính bộ nhớ training và fine-tuning
Bộ nhớ training lớn hơn vì GPU phải giữ nhiều hơn các weights của forward pass.
Đối với full fine-tuning với mixed precision và AdamW, phần giải thích bộ nhớ của Hugging Face đưa ra một phân tích thực tế: huấn luyện mixed-precision có thể giữ các bản sao trọng số FP32 và FP16/BF16, trạng thái bộ tối ưu AdamW, gradients, activations đã lưu, các buffer tạm thời và bộ nhớ dành riêng cho chức năng. Cùng trang đó tóm tắt một cấu hình AdamW mixed-precision điển hình là 18 byte cho mỗi tham số mô hình, cộng thêm bộ nhớ activation.
Điều đó có nghĩa là:
| Kích thước mô hình | 18 byte cho mỗi tham số trước activations |
|---|---|
| 7B | ~117 GiB |
| 13B | ~218 GiB |
| 34B | ~570 GiB |
| 70B | ~1,173 GiB |
Đó là lý do các truy vấn về gpu memory requirements LLM training cần một câu trả lời khác với các truy vấn inference. Một mô hình 70B có thể được phục vụ với tensor parallelism và KV cache được lượng tử hóa không đồng nghĩa với việc full fine-tuning trên một số ít GPU là khả thi về mặt thực tế.
Các cách giảm bộ nhớ khi training bao gồm:
| Kỹ thuật | Giảm cái gì | Đánh đổi |
|---|---|---|
| LoRA / QLoRA | Bộ nhớ tham số có thể train và bộ nhớ optimizer | Không giống full fine-tuning; vẫn cần bộ nhớ mô hình gốc và activations. |
| Activation checkpointing | Bộ nhớ activation đã lưu | Nhiều phép tính lại hơn và thông lượng training thấp hơn. |
| ZeRO / FSDP / tensor parallelism | Bộ nhớ optimizer, gradient, tham số hoặc compute trên mỗi GPU | Phức tạp hơn về phân tán và nhạy cảm hơn với giao tiếp. |
| Chuỗi dài ngắn hơn | Bộ nhớ activation và attention | Có thể làm giảm chất lượng tác vụ nếu workload cần ngữ cảnh dài. |
| Micro-batch nhỏ hơn | Bộ nhớ activation | Có thể cần gradient accumulation để giữ nguyên kích thước batch hiệu dụng. |
Đối với full training, các công thức sẽ đưa bạn đến một hình dạng cụm ban đầu. Chúng không thay thế cho một lần chạy framework được đo đạc thực tế.
Bước 5: ánh xạ yêu cầu bộ nhớ GPU của LLM sang các mức bộ nhớ GPU phổ biến
Hãy xem dung lượng bộ nhớ GPU như một ràng buộc, không phải tiêu chí mua duy nhất. Băng thông bộ nhớ, topology NVLink, networking, lưu trữ, scheduling và mức độ sử dụng có thể quan trọng không kém VRAM thô.
| Phân khúc GPU | Mốc bộ nhớ công khai | Điều đó thường có nghĩa gì đối với yêu cầu bộ nhớ GPU của LLM |
|---|---|---|
| H100 SXM | 80 GB HBM3 | Lựa chọn mặc định mạnh cho phục vụ 7B-34B và nhiều job fine-tuning. BF16 cho 70B thường cần tensor parallelism hoặc lượng tử hóa. |
| H100 NVL | 94 GB mỗi GPU, 188 GB mỗi cặp trong trang H100 của NVIDIA | Được thiết kế cho inference LLM lớn trong các rack doanh nghiệp bị giới hạn điện năng; vẫn cần kiểm tra topology và SKU của nhà cung cấp. |
| H200 | 141 GB HBM3e | Thoải mái hơn cho weights mô hình lớn và context dài hơn so với H100, nhưng phục vụ 70B với concurrency cao vẫn có thể bị giới hạn bởi KV cache. |
| B200 trong DGX B200 | Tổng 1,440 GB trên 8 GPU | Pool bộ nhớ lớn cho các hệ thống training và inference doanh nghiệp, với các yêu cầu vận hành vượt ra ngoài thông số của một GPU. |
Nếu bảng tính của bạn cho thấy một H200 đơn lẻ "vừa khít" với mô hình 70B, đó không phải là một kế hoạch triển khai. Nó là tín hiệu để benchmark các thiết lập sau:
| Thiết lập | Vì sao nó quan trọng |
|---|---|
max_model_len |
Đặt ngưỡng trên cho context và do đó là KV cache. |
max_num_seqs |
Đặt ngưỡng trên cho số sequence đồng thời và áp lực lên scheduler. |
kv_cache_dtype |
Có thể cắt giảm bộ nhớ KV cache, nhưng cần kiểm tra chất lượng. |
| Tensor parallel size | Chia công việc của mô hình trên nhiều GPU; đồng thời làm thay đổi nhu cầu giao tiếp. |
| Định dạng lượng tử hóa | Thu nhỏ weights và đôi khi cả KV cache; có thể ảnh hưởng đến chất lượng và hỗ trợ kernel. |
| Mục tiêu p95 latency | Các thiết lập throughput cao hơn có thể làm tăng latency ngay cả khi bộ nhớ đủ. |
Để biết chi tiết chọn phần cứng, hãy dùng bảng tính này cùng với các hướng dẫn của Flatkey: GPU tốt nhất cho LLM inference, H200 so với H100, và B200 so với H200.
Ví dụ: xác định kích thước inference 70B trong vLLM
Đây là một cách thận trọng để suy luận về vllm gpu memory requirements 70b model vram trước khi bạn thuê dung lượng.
Giả sử:
| Đầu vào | Giá trị |
|---|---|
| Weights của mô hình | 70B tham số |
| Độ chính xác weights | BF16 / FP16 |
| Bộ nhớ weights | ~130.4 GiB |
| Hình dạng KV cache | 80 lớp, 8 KV heads, 128 chiều head |
| Độ chính xác KV | BF16 / FP16 |
| KV trên mỗi token đang hoạt động | ~0.3125 MiB |
Sau đó so sánh một vài hình dạng phục vụ:
| Mục tiêu phục vụ | KV cache xấp xỉ | Vì sao điều này quan trọng |
|---|---|---|
| 1 chuỗi đang hoạt động, 4K token | ~1.3 GiB | Weights chiếm ưu thế. Một GPU bộ nhớ lớn đơn lẻ có thể chỉ vừa đủ với biên an toàn thấp. |
| 8 chuỗi đang hoạt động, 4K token | ~10.0 GiB | Cần biên an toàn thực sự ngoài weights. |
| 16 chuỗi đang hoạt động, 8K token | ~40.0 GiB | Kế hoạch dùng một GPU thường khá mong manh trừ khi weights hoặc KV cache được lượng tử hóa. |
| 16 chuỗi đang hoạt động, 16K token | ~80.0 GiB | Riêng KV cache đã xấp xỉ lượng bộ nhớ của một H100 SXM. |
Về mặt vận hành, một kế hoạch vLLM 70B thường rơi vào một trong các hướng sau:
| Hướng | Phù hợp |
|---|---|
| Weights BF16, độ đồng thời thấp, ngữ cảnh ngắn hơn | Bộ nhớ hạng H200 có thể đáp ứng sau khi kiểm tra overhead. |
| Weights BF16, độ đồng thời production | Dùng tensor parallelism và kiểm tra network/topology. |
| Weights đã lượng tử hóa, KV cache BF16/FP16 | Là benchmark đầu tiên tốt khi chất lượng cho phép lượng tử hóa weights. |
| Weights đã lượng tử hóa cộng KV cache FP8 | Có thể mở khóa ngữ cảnh dài hơn hoặc nhiều độ đồng thời hơn, nhưng cần xác thực độ chính xác và độ trễ. |
| Không có yêu cầu kiểm soát phần cứng | So sánh một tuyến model API trước khi cam kết vận hành trên GPU. |
Đây là câu trả lời thực tế cho gpu memory requirements for LLM khi phục vụ: số lượng tham số cho biết model có thể nạp được hay không; KV cache và phần dự trữ runtime cho biết nó có thể phục vụ lưu lượng hữu ích hay không.
Vì sao độ dài ngữ cảnh làm thay đổi câu trả lời
Ngữ cảnh dài tốn kém vì cache tăng theo số token đang hoạt động. Nếu bạn tăng ngữ cảnh từ 8K lên 16K, KV cache về cơ bản sẽ tăng gấp đôi đối với cùng model, độ chính xác và độ đồng thời. Nếu bạn tăng độ đồng thời lên gấp đôi ở cùng ngữ cảnh, KV cache cũng sẽ tăng gần như gấp đôi một lần nữa.
Với các đội đang so sánh các kế hoạch llm hardware requirements gpu memory, điều này tạo ra một mẫu sizing đơn giản:
nhiều người dùng x prompt dài hơn x nhiều token đầu ra hơn = nhiều KV cache hơn
Trước khi thuê một GPU lớn hơn, hãy tự hỏi liệu sản phẩm có thực sự cần ngữ cảnh tối đa cho mọi yêu cầu hay không. Nhiều hệ thống có thể định tuyến:
| Loại yêu cầu | Chính sách tiết kiệm bộ nhớ |
|---|---|
| Chat ngắn hoặc trích xuất | Giới hạn ngữ cảnh nhỏ hơn, độ đồng thời cao hơn. |
| Phân tích tài liệu dài | Giới hạn ngữ cảnh lớn hơn, pool có độ đồng thời thấp hơn. |
| Batch jobs | Xếp hàng theo ngân sách token, không chỉ theo số lượng yêu cầu. |
| Tải công việc cao cấp | Pool chuyên dụng với max context rõ ràng và mục tiêu p95. |
Cách này thường rẻ hơn và ổn định hơn so với việc chạy một endpoint khổng lồ với một thiết lập bộ nhớ toàn cục.
Cần đo gì trong benchmark đầu tiên
Hãy chạy một benchmark giống lưu lượng production, chứ không phải chỉ một prompt thuận lợi duy nhất.
| Chỉ số | Vì sao nó nên có trong benchmark đầu tiên |
|---|---|
| VRAM được cấp phát và dự trữ ở đỉnh | Bắt được headroom của allocator và framework, không chỉ phép toán tensor. |
| Độ trễ prefill | Prompt dài gây áp lực lên băng thông bộ nhớ và các kernel attention. |
| Số token decode mỗi giây | Cho thấy thông lượng sinh ở trạng thái ổn định. |
| Độ trễ p95 và p99 | Ngăn cấu hình chỉ tối ưu thông lượng làm ảnh hưởng người dùng. |
| Tỷ lệ OOM | Theo dõi lỗi bộ nhớ dưới hỗn hợp lưu lượng thực tế. |
| Mức sử dụng KV cache | Cho biết ngữ cảnh/độ đồng thời hay weights đang là nút thắt. |
| Chi phí cho output được chấp nhận | Kết nối chi phí thuê GPU với các lượt hoàn tất hữu dụng, không chỉ token thô. |
Đối với triển khai nhiều node, hãy kết hợp điều này với các checklist GPU cluster architecture và GPU cluster TCO. Một model vừa khít bộ nhớ vẫn có thể rất đắt nếu networking, storage, queueing, hoặc utilization kém.
Các sai lầm phổ biến
| Sai lầm | Cách tiếp cận tốt hơn |
|---|---|
| Chỉ sizing từ số lượng tham số | Thêm KV cache, activations, phần dự trữ của framework, và headroom. |
| Coi việc "vừa một lần" là sẵn sàng cho production | Kiểm tra ngữ cảnh mục tiêu, độ đồng thời, độ dài đầu ra, và hành vi retry. |
| Bỏ qua độ chính xác của KV cache | Xác thực FP8 hoặc các định dạng cache khác khi bộ nhớ là nút thắt. |
| Dùng tên GPU của nhà cung cấp mà không có SKU chính xác | Xác nhận dung lượng bộ nhớ, interconnect, chính sách MIG, bộ driver, và liệu GPU có bị chia sẻ hay không. |
| Giả định bộ nhớ khi training bằng bộ nhớ khi inference là như nhau | Training bổ sung optimizer states, gradients, activations được lưu, và overhead phân tán. |
Chạy gpu_memory_utilization quá агрессивly |
Để lại đủ phần dự trữ cho CUDA graphs, buffers, các đợt tăng đột biến lưu lượng, và hành vi của allocator. |
Hướng dẫn quyết định: thuê GPU hay dùng model API?
Khả năng GPU trực tiếp là hướng đúng khi bạn cần một hoặc nhiều điều sau:
| Chọn GPU trực tiếp khi... | Chọn baseline API của mô hình khi... |
|---|---|
| Bạn phục vụ các weights tùy chỉnh hoặc fine-tune riêng tư. | Bạn dùng các mô hình được lưu trữ phổ biến và chủ yếu cần đầu ra đáng tin cậy. |
| Bạn cần vị trí đặt, cách ly hoặc kiểm soát thời gian chạy. | Bạn không muốn vận hành hàng đợi, autoscaling, image, driver và các lỗi GPU. |
| Mức sử dụng đo được của bạn đủ cao để vượt qua kinh tế của API. | Lưu lượng truy cập theo từng đợt, còn sớm hoặc khó dự báo. |
| Bạn có thể tự đảm nhận benchmarking và xử lý sự cố. | Đội ngũ của bạn muốn dành thời gian kỹ thuật cho logic sản phẩm hơn. |
Flatkey hữu ích như một đường baseline khi việc kiểm soát phần cứng không phải là yêu cầu của sản phẩm. Nó cung cấp cho các đội một mức cân bằng giữa các mô hình và công cụ chính thức, để bạn có thể so sánh chi phí thuê GPU với chi phí đầu ra của model API trước khi cam kết với một cụm chạy dài hạn. Nếu benchmark chứng minh GPU trực tiếp có lợi hơn, hãy dùng bảng tính bộ nhớ ở trên để thuê dạng máy nhỏ nhất nhưng đáng tin cậy thay vì dạng lớn nhất cho ấn tượng nhất.
Câu hỏi thường gặp
Một LLM 70B cần bao nhiêu bộ nhớ GPU?
Weights BF16 hoặc FP16 cho mô hình 70B cần khoảng 130 GiB trước KV cache và overhead thời gian chạy. Weights INT8 khoảng 65 GiB trước metadata. Weights 4-bit khoảng 33 GiB trước metadata lượng tử hóa. Với suy luận production, hãy cộng thêm KV cache cho ngữ cảnh và đồng thời, phần dự trữ của framework phục vụ, và biên an toàn.
Tại sao mô hình tải được nhưng lại lỗi khi có lưu lượng?
Bài kiểm tra tải có thể chỉ vừa với weights. Lưu lượng thực tế cộng thêm KV cache cho prompt đang hoạt động và token được sinh ra, overhead batching, bộ đệm tạm, và phần dự trữ của framework. Prompt dài hơn và nhiều chuỗi đồng thời hơn có thể đẩy cùng một mô hình vào OOM.
Điều gì ảnh hưởng nhiều nhất đến yêu cầu bộ nhớ GPU cho suy luận LLM?
Các biến số lớn nhất là kích thước mô hình, độ chính xác của weights, độ dài ngữ cảnh, số chuỗi đồng thời, độ chính xác KV cache, và cài đặt của framework phục vụ. Với phục vụ ngữ cảnh dài, KV cache thường trở thành nút thắt cổ chai.
Điều gì ảnh hưởng đến yêu cầu phần cứng LLM về bộ nhớ GPU cho huấn luyện?
Huấn luyện bổ sung trạng thái optimizer, gradients, activations đã lưu, bộ đệm tạm, và overhead của framework phân tán. Kích thước batch, độ dài chuỗi, activation checkpointing, lựa chọn optimizer, và chiến lược sharding có thể làm thay đổi số GPU một cách đáng kể.
vLLM có giảm yêu cầu bộ nhớ GPU không?
vLLM cung cấp các điều khiển bộ nhớ hữu ích và quản lý KV cache hiệu quả, nhưng không loại bỏ ngân sách bộ nhớ nền tảng. Bạn vẫn cần đủ VRAM cho weights, KV cache, activations, phần dự trữ thời gian chạy, và headroom. Các điều khiển bộ nhớ của nó giúp bạn chọn đánh đổi giữa độ dài ngữ cảnh, đồng thời, độ chính xác và throughput.
FP8 KV cache có thể giải quyết áp lực bộ nhớ của ngữ cảnh dài không?
Nó có thể giảm dung lượng KV cache, và vLLM có tài liệu hỗ trợ FP8 KV cache. Hãy xem đây là một thiết lập benchmarking, không phải một công tắc miễn phí: hãy kiểm chứng chất lượng đầu ra, độ trễ, các đường phần cứng/phần mềm được hỗ trợ, và hành vi lỗi trước khi dùng nó trong production.
Danh sách kiểm tra cuối cùng
Trước khi thuê năng lực, hãy trả lời các câu hỏi này:
- Bạn đang phục vụ kích thước mô hình và độ chính xác weights nào?
- Độ dài ngữ cảnh tối đa mà người dùng có thể thực sự gửi là bao nhiêu?
- Cần bao nhiêu chuỗi đồng thời để đáp ứng tải p95?
- Bạn dự trữ độ dài đầu ra nào cho quá trình sinh?
- KV cache là BF16/FP16, FP8, hay một định dạng được hỗ trợ khác?
- Sau weights và KV cache thì còn lại bao nhiêu headroom?
- Bạn có đang dùng tensor parallelism, quantization, LoRA, FSDP, hay ZeRO không?
- Nhà cung cấp sẽ cấp phát chính xác SKU GPU, dung lượng bộ nhớ, và topology nào?
- Ngưỡng OOM, độ trễ, và chi phí trên mỗi output được chấp nhận nào định nghĩa thành công?
- Nếu bạn không cần kiểm soát phần cứng, baseline chi phí của model API là bao nhiêu?
Ước tính llm gpu memory requirements tốt nhất là ước tính vượt qua được một benchmark giống production. Hãy dùng bảng tính để loại nhanh các dạng GPU không khả thi, rồi xác thực danh sách rút gọn với độ dài ngữ cảnh thực, mức đồng thời thực, và đủ headroom để duy trì hoạt động.
Nguồn
- Tham số engine của vLLM:
gpu_memory_utilization,kv_cache_memory_bytes,kv_cache_dtype, và các điều khiển cache liên quan: https://docs.vllm.ai/en/latest/configuration/engine_args.html - Hướng dẫn tiết kiệm bộ nhớ của vLLM: tensor parallelism, quantization, độ dài ngữ cảnh, kích thước batch, bộ nhớ CUDA graph, và các điều khiển bộ nhớ đa phương thức: https://docs.vllm.ai/en/latest/configuration/conserving_memory/
- Hướng dẫn KV cache lượng tử hóa của vLLM: các tùy chọn và đánh đổi của FP8 KV cache: https://docs.vllm.ai/en/latest/features/quantization/quantized_kvcache.html
- Kiến trúc bộ nhớ mô hình của Hugging Face Transformers: các nhóm bộ nhớ huấn luyện, trạng thái optimizer, gradients, activations, và ghi chú bộ nhớ mixed-precision: https://huggingface.co/docs/transformers/v4.57.1/en/model_memory_anatomy
- Trang sản phẩm NVIDIA H100: bộ nhớ H100, băng thông, H100 NVL, và định vị cho LLM: https://www.nvidia.com/en-us/data-center/h100/
- Trang sản phẩm NVIDIA H200: 141 GB HBM3e và băng thông bộ nhớ: https://www.nvidia.com/en-us/data-center/h200/
- Trang sản phẩm NVIDIA DGX B200: tám GPU B200 và tổng 1.440 GB HBM3e: https://www.nvidia.com/en-us/data-center/dgx-b200/


